EndoChat:开创性多模态医学大模型,革新内窥镜手术智能培训
摘要
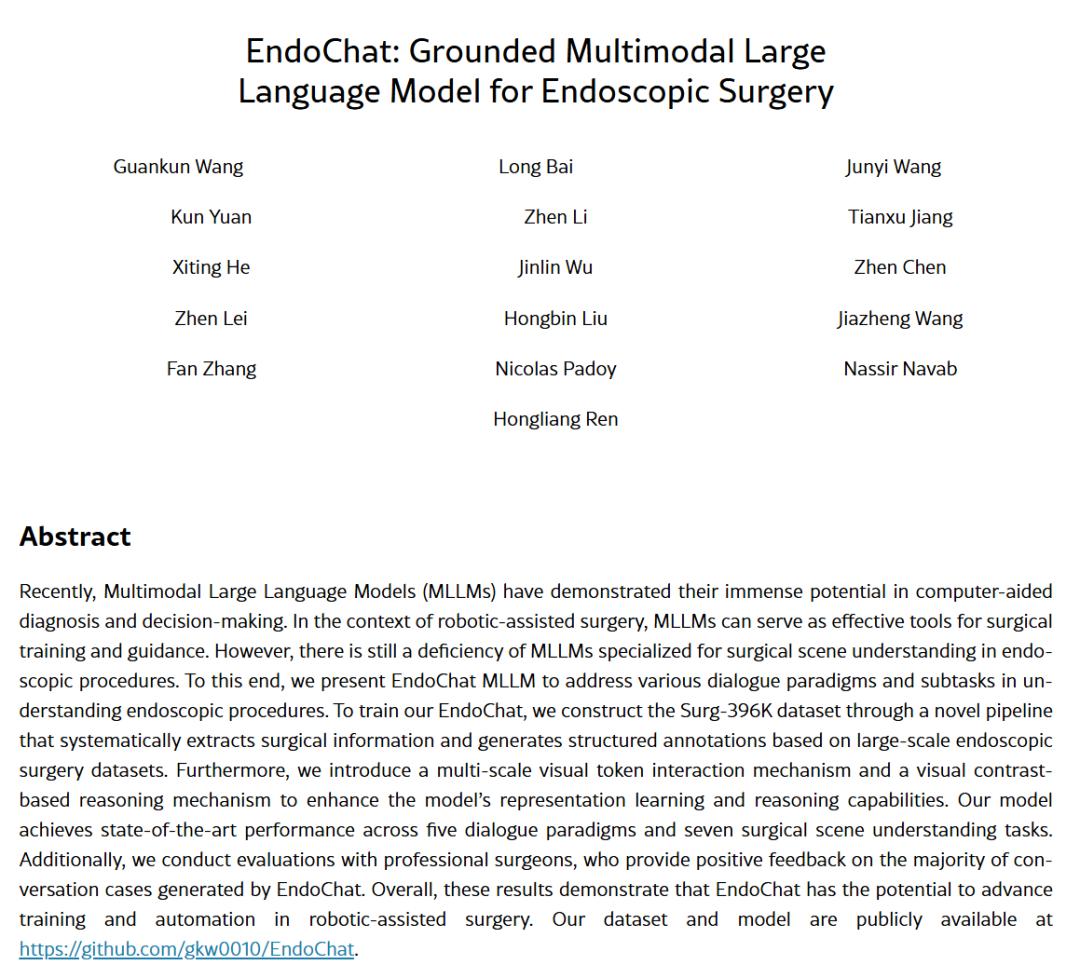
EndoChat是一种创新的多模态大语言模型(MLLM),专为内窥镜手术场景设计,支持五种对话范式和七种手术场景理解任务。通过构建Surg-396K数据集,EndoChat在手术培训中展现出卓越性能,获得专业外科医生的积极反馈。本文将详细介绍EndoChat的技术创新与应用潜力 。https://github.com/gkw0010/EndoChat
正文
一、引言:内窥镜手术培训的挑战与机遇
机器人辅助手术(RAS)以其高精度、低创伤和快速恢复的优势,正在改变现代医疗格局。然而,外科医生在操作机器人系统时面临巨大挑战,尤其是在技能培训方面。传统培训依赖专业外科医生的实时指导,但由于后者时间有限,培训效率常常受限 。为此,人工智能(AI)对话系统被引入手术培训领域,试图通过视觉问答(VQA)技术解决这一问题。然而,现有系统局限于结构化问答,无法适应多样化的培训需求 。
EndoChat的诞生正是为了填补这一空白。作为一款专为内窥镜手术设计的多模态大语言模型(MLLM),EndoChat通过整合视觉与语言信息,提供灵活、实时的培训支持,极大地提升了手术培训的质量与效率 。本文将从技术架构、数据集构建、实验结果等多个维度,全面剖析EndoChat的创新之处。
二、EndoChat的核心创新:多模态大语言模型在手术中的应用
1. 多模态大语言模型(MLLM)的潜力
近年来,多模态大语言模型在医疗辅助诊断与决策中展现出强大潜力。MLLM能够处理图像、文本等多种模态数据,进行复杂推理和理解,尤其适用于手术场景。与传统VQA系统不同,MLLM支持开放式问答和多轮对话,能够根据上下文动态调整回答,模拟专业外科医生的指导过程 。
2. EndoChat的功能与目标
EndoChat是一款交互式多模态聊天工具,专为内窥镜手术培训与教育设计。用户可以通过上传图像并提出问题,与EndoChat互动,从而实现对手术场景的全面理解 。EndoChat支持五种对话范式,包括单短语问答、详细描述、视觉问答、基于区域的问答以及定位问答,确保覆盖大多数自然语言对话场景 。此外,它还定义了七个与手术相关的子任务,涵盖从基本观察到高级分析的全面手术场景理解 。
3. 技术架构:混合视觉标记引擎与视觉对比机制
EndoChat在模型架构上进行了多项创新。其核心组件之一是混合视觉标记引擎(MVTE),通过多尺度视觉信息提取与融合,增强了模型在高分辨率图像中的视觉-语言对齐能力。MVTE采用多视觉塔结构,提取并交互视觉标记,显著提升了手术场景中的信息处理能力 。
此外,为了减少模型在复杂内窥镜手术场景中的“对象幻觉”现象,EndoChat引入了视觉对比机制。通过对比原始图像与畸变图像的输出分布,模型能够纠正统计偏差与语言先验带来的误判,确保视觉信息与语言输出的高度一致性 。
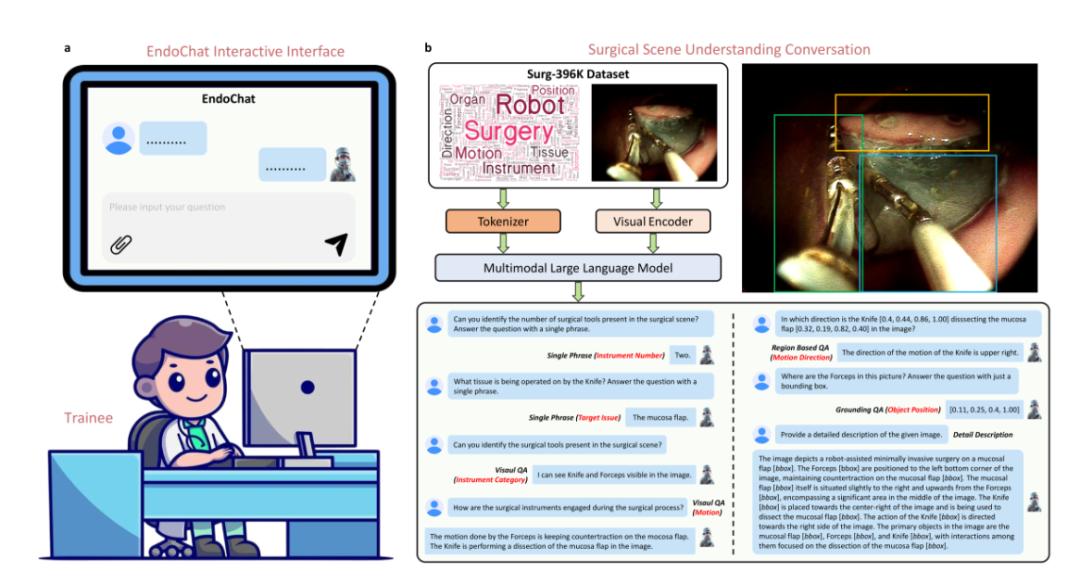
(Figure 1展示了EndoChat的概览,包括交互界面与Surg-396K数据集的训练示例,和EndoChat的工作流程)
三、Surg-396K数据集:EndoChat的基石
1. 数据集构建的必要性
当前手术MLLM面临两大挑战:一是培训中的多样化查询难以通过预定义格式或通用描述覆盖;二是通用视觉编码器在手术场景中的领域差异导致理解不足。为此,EndoChat团队构建了Surg-396K数据集,专门针对手术场景设计,支持开放式、知识驱动的视觉-语言交互 。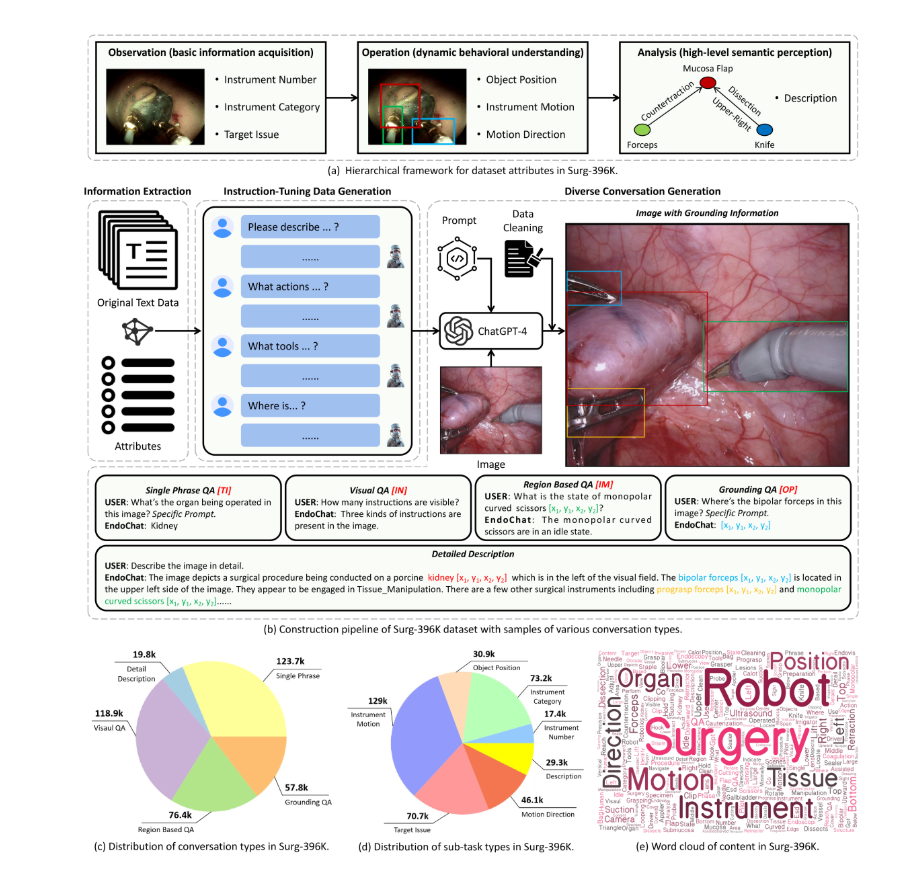
2. 数据集构成与特点
Surg-396K包含41.4K张图像和396K个图像-指令对,涵盖多种内窥镜手术类型,如腹腔镜胆囊切除术、肾切除术和粘膜下层剥离术。数据集通过五个关键步骤构建:属性分析、信息提取、指令调整数据生成、多样化对话生成和数据清洗,确保数据的全面性与可靠性 。
数据集整合了三个公共数据集:EndoVis-VQLA、CoPESD和Cholec80-VQA,并利用GPT-4V扩展了多模态指令数据,形成五种对话类型和七个属性相关的子任务 。
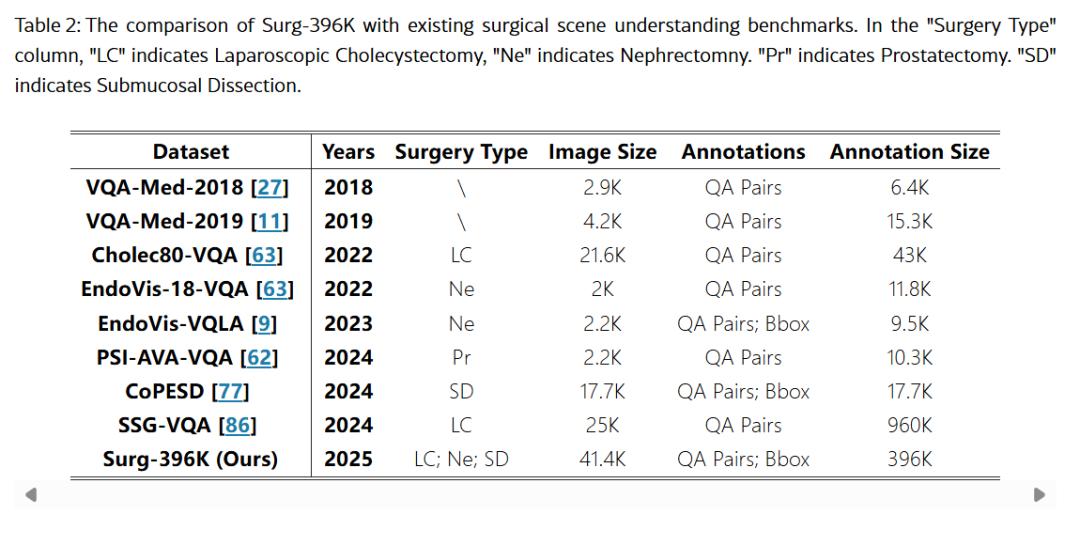
(Table 2比较了Surg-396K与其他手术场景理解数据集的规模与多样性。展示了Surg-396K在图像数量、标注规模及手术类型上的优势)
3. 对话范式与子任务设计
Surg-396K设计了五种对话范式,以模拟真实手术培训中的交互需求。例如,“单短语问答”提供简洁直接的回答,适用于快速查询;“详细描述”则覆盖手术场景的所有属性,模拟实时观察的全面解释 。七个子任务则从仪器数量、类别到运动方向、目标组织等多个维度,评估模型对手术场景的理解深度 。
四、实验结果与专家评价
1. 性能对比:超越现有模型
EndoChat在多种对话范式和手术场景理解任务中表现出色。通过与商业及开源MLLM的对比实验,EndoChat在手术理解准确性和对话能力上均显著优于现有通用及医疗MLLM 。其在七个属性相关子任务上的表现达到最先进水平,进一步验证了模型架构设计的有效性 。
2. 专业外科医生的反馈
EndoChat还邀请了经验丰富的内窥镜外科医生进行独立评估。结果显示,医生对EndoChat在手术培训中的辅助作用持积极态度,认为其有潜力成为有效的培训工具 。这一反馈表明,EndoChat不仅在技术层面领先,也在实际应用中展现出巨大价值。
五、EndoChat的未来潜力与应用前景
EndoChat的问世标志着MLLM在手术培训领域的重大进展。其灵活的对话框架和上下文感知能力,能够为培训者提供智能化支持,部分替代专业外科医生的指导角色,从而减轻医生负担,提升培训效率 。未来,EndoChat有望进一步扩展至其他手术领域,推动机器人辅助手术的自动化与智能化发展 。
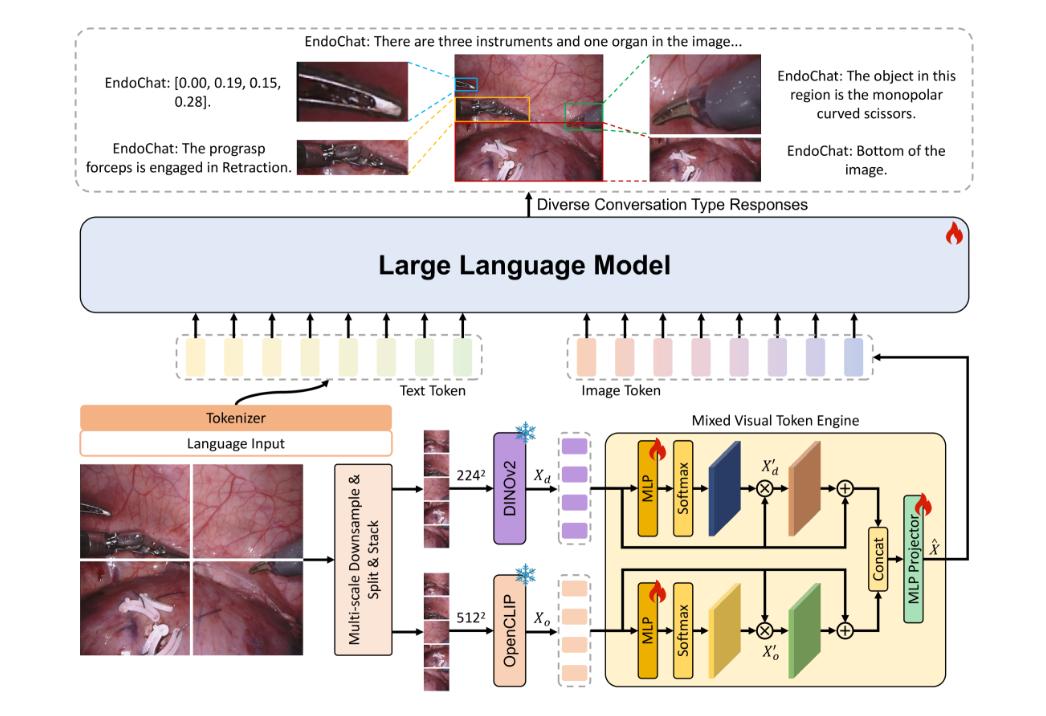
(Figure 3展示了EndoChat的详细架构,包括多尺度图像处理与混合视觉编码器的设计)
优点与创新
- 高质量的多模态数据集:构建了Surg-396K数据集,包含41K图像和396K指令跟随注释,涵盖多种手术类型和对话范式。
- 多尺度视觉令牌引擎:提出了Mixed Visual Token Engine(MVTE),增强了多尺度视觉信息的提取和融合,提高了模型在复杂内窥镜手术场景中的理解能力。
- 基于视觉对比的幻觉缓解机制:引入了视觉对比方法,通过比较原始和扭曲的视觉输入来减少对象幻觉,提高了生成响应的一致性。
- 灵活的多模态对话框架:EndoChat支持五种对话范式和七种与手术相关的子任务,能够适应不同的交互需求,支持广泛的手术任务。
- 专家评估:通过经验丰富的内窥镜医师进行评估,结果显示EndoChat在提高手术训练和教育方面的潜力得到了认可。
- 开源模型和数据:计划开源模型权重、训练代码和数据,促进多模态AI系统在手术领域的发展。
不足与反思
- 独特手术案例数量有限:尽管拥有大量手术图像数据库,但包含的独特手术案例相对较少,可能影响模型的泛化能力。
- 计算资源依赖:多模态大型语言模型通常依赖于大量计算资源,这在资源受限的边缘环境中部署是一个挑战。
- 隐私和伦理问题:随着更多样化数据的引入,需要仔细研究和审查临床数据的隐私和伦理使用,以确保应用过程中的合规性。
- 七: 关键问题及回答
八、总结
EndoChat通过创新的多模态大语言模型架构和Surg-396K数据集,为内窥镜手术培训提供了全新解决方案。其在对话能力、场景理解及实际应用中的优异表现,得到了专业领域的认可。作为一款开源工具,EndoChat的数据集与模型已公开发布,欢迎广大研究者与从业者共同探索其潜力 。
标签
#MLLM #EndoscopicSurgery #多模态大语言模型 #内窥镜手术 #手术培训 #人工智能医疗
欢迎加入「知识图谱增强大模型产学研」知识星球,获取最新产学研相关"知识图谱+大模型"相关论文、政府企业落地案例、避坑指南、电子书、文章等,行业重点是医疗护理、医药大健康、工业能源制造领域,也会跟踪AI4S科学研究相关内容,以及Palantir、OpenAI、微软、Writer、Glean、OpenEvidence等相关公司进展。
往期推荐
[300页电子书]Palantir 股票的大数据,大利润:为什么Palantir是未来企业级AI的潜力股
[555页电子书]从LLM Agent到RAG与知识图谱全攻略实战指南重磅发布——构建具备推理、检索与行动能力的智能体
250页电子书-医学领域的人工智能革命:GPT-4及医学大模型未来展望。OpenAI CEO作序
[100页电子书]知识图谱&大模型双轮驱动的工业 AI 数智化转型权威指南 - Cognite
[73页]OpenAI联合哈佛等重磅发布全球首份ChatGPT使用报告,分析用户增长、使用模式及其经济价值
[140页]Neo4j GraphRAG白皮书
[72页]谷歌推出个性化实时监测主动健康管理大模型PH-LLM
[180页电子书]GraphRAG全面解析及实践-Neo4j:构建准确、可解释、具有上下文意识的生成式人工智能应用
[30页电子书]GraphRAG开发者指南
[550页电子书]2025年10月最新出版-知识图谱与大语言模型融合的实战指南:KG&LLM in Action
[230页电子书]谷歌AI产品负责人撰写《AI产品经理经理指南- 构建人工智能驱动的产品战略、工具和Agent设计》
往期推荐
智能守护银发族:Palantir×SOMPO共塑日本医疗与护理新时代
药械营养保健企业的Agentic AI应用(罕见病诊断、患者护理、生产检测等)全解析
生成式人工智能在护理中被忽视的阴暗面:国际智库的视角
Precina Health 如何使用GraphRAG 通过实时洞察彻底改变 2 型糖尿病护理
利用生成式人工智能增强重症监护室护理实践:一项基于模拟临床案例的诊断协同效应形成性研究
多模态生成式人工智能辅助医疗护理培训 - DFKI、南安普顿大学等
大模型在失智患者护理的研究 - Cardiff&剑桥大学
CancerKG.ORG - “知识图谱 +大模型”双轮驱动的人机协同癌症诊疗与护理智能体
利用大模型提升护理与老年照护:一个AI驱动的框架 - 复旦、上交等
[最新论文]探索大模型在乳腺癌肿瘤学护理领域中的应用潜力 - 谷歌DeepMind等
厦门·护理信息大会|首都医科大学与柯基数据合作的NursGPT项目顺利启动!
从“小白”到“专家”:大模型在肿瘤护理中的潜力探索
使用大模型指导患者创建高效全面的临床护理信息
Nature - 基于护理大模型的医院门诊接待机器人和护士的人机协同新范式
2024CHMIA中国护理信息大会&NursGPT启动仪式
护理临床智能决策的新颖方法:大语言模型与本地知识库的整合
护理国自然近一半竟然是这个?
Abridge:一位医生的非典型创业路,用AI重塑医患沟通流程
知识图谱:让智能体理解世界的关键上下文
AI大模型模拟患者+自动反馈深度分析:医学教育新范式
AI模拟病人系统革新:知识图谱+大模型驱动,94.15%问答准确率,医学教育新突破
喜讯|我司中标国内大型创新药企基于"知识图谱+大模型"的医学数字化图书馆项目
Palantir AIP 驱动医疗行业变革,HCA的AI医院管理实践启示
医疗行业的AI革命:从科研到临床的全面变革
知识图谱+大语言模型:中医病例信息检索与分析的新突破