基于Mamba架构的跨模态融合,从冗余中提纯关键,WSIs 生存分析新方法登顶TCGA!
点击下方卡片,关注「AI视界引擎」公众号
生存分析是临床预后研究和癌症结果评估中的核心任务,旨在从特定起始点预测至事件(如死亡或疾病复发)发生的时间,并准确评估患者的死亡风险。它在临床决策过程中对增强诊断和指导治疗规划起着至关重要的作用[1, 2]。对于癌症患者,病理图像和基因组数据等多模态数据提供了相互关联的关键信息,构成了患者分层和生存分析的基础[3]。然而,传统的生存分析方法通常依赖于短期临床指标和长期随访报告[4, 5, 6, 7],这些方法不仅耗时而且在临床应用上存在局限性。同时,癌症的复杂性要求对多样化和个性化的数据进行全面评估,这对模型有效捕获关键判别特征和整合数据异质性提出了重大挑战。因此,开发高效的特征提取和多模态融合方法对于构建稳健且准确的生存分析模型已成为必要但具有挑战性的任务。
最近,随着深度学习技术的快速发展,医学图像分析领域取得了显著进展。作为癌症诊断的金标准,病理图像正越来越多地应用于生存分析。病理图像直接提供了肿瘤细胞的微观形态特征以及肿瘤微环境的信息。这些视觉特征与肿瘤进展、侵袭性和患者预后密切相关,为评估生存风险提供了形态学基础。然而,单独使用病理图像无法捕捉分子水平的生物学信息。许多预后因素并未直接反映在形态特征中,这使得仅通过图像分析难以揭示它们与生存结果之间的深层关联。这可能导致对肿瘤异质性的解释不完整。因此,整合病理图像和基因组数据的多模态生存分析方法具有相当大的研究前景。为了准确使用这两种模态进行生存分析,大多数现有方法采用基于Transformer的架构来实现跨模态交互并获取多模态表示。例如,一些方法使用基于Transformer的多实例学习来捕获全局信息[14],或应用协同注意力机制进行模态融合[19],从而从不同角度获取互补信息。尽管这些方法在特征建模和跨模态交互方面表现出色,但高维多模态特征很容易掩盖单模态数据中原本存在的关键生存相关信息。这增加了对与任务无关特征过拟合的风险。此外,注意力机制的二次计算复杂度导致在处理长序列或大规模多模态数据时效率低下,常常导致忽略关键的实例级特征。
为应对上述挑战,作者的目标是利用病理图像和基因组数据的单模态特征,以及它们交互的多模态表示。这能够有效捕获每种模态中固有的关键信息,同时通过整合的多模态特征促进全面的生存分析。此外,为降低计算复杂度,作者探索了一种更高效的序列建模框架——Mamba,它在保持线性计算复杂度的同时维持了强大的建模能力。通过将选择机制和硬件感知并行算法集成到结构化状态空间模型(SSMs)中,Mamba能够有效捕获长距离依赖关系,而无需承担注意力机制的计算负担。
Mamba已被广泛应用于WSIs分类[20, 21, 22]和多模态融合[23, 24, 25, 26, 27]等任务。然而,现有的基于Mamba的多实例学习方法通常依赖多个扫描方向来捕获实例之间的上下文关系,这可能无法充分识别最具判别性的实例级特征,如图1(a)所示。此外,当前基于Mamba的多模态融合方法通常只是简单地按顺序交错不同模态的特征,缺乏能够全面捕获跨模态关系的更深层次交互机制。这种限制最终损害了学习到的跨模态表示的质量。
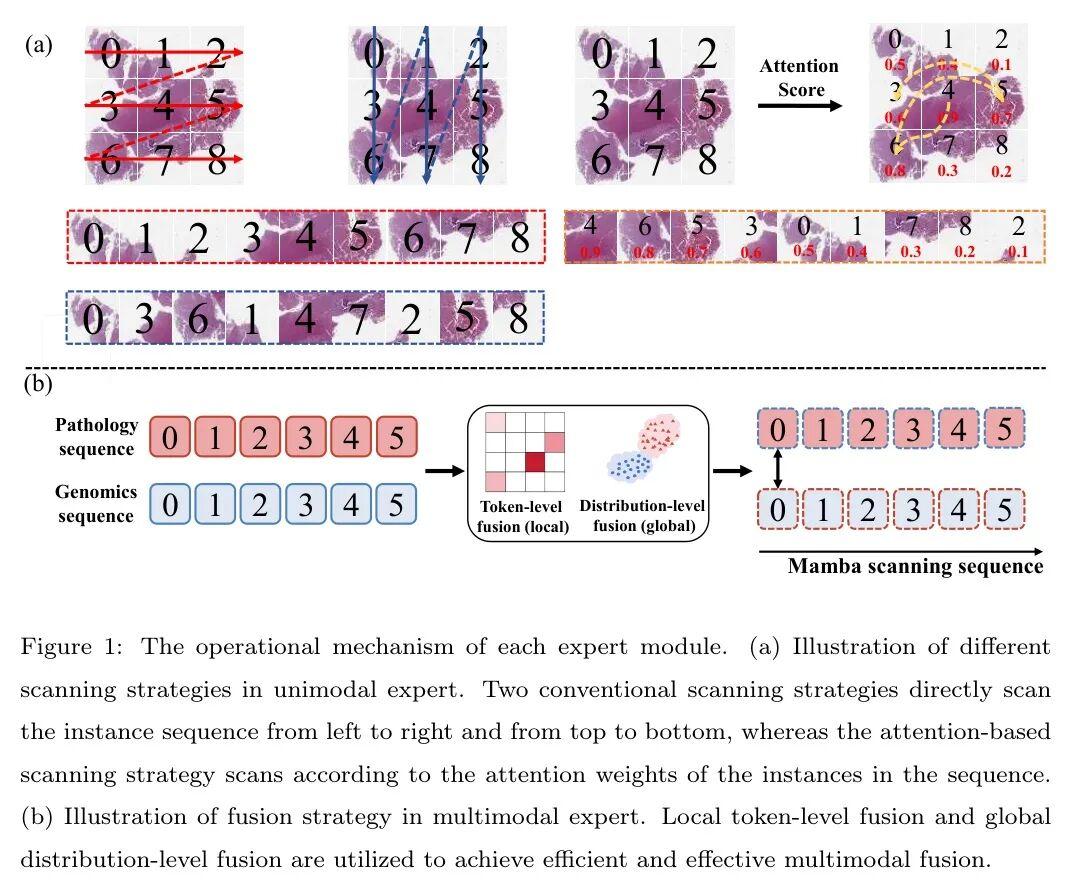
在本文中,作者提出了一种名为多专家Mamba(ME-Mamba)的多专家系统,该系统整合了病理图像和基因组数据进行生存分析。该系统并行处理包括病理学和基因组学在内的单模态数据及其多模态融合。这种并行架构有助于深入理解在单模态和多模态表示中影响生存结果的潜在因素。它在实现模态互补整合的同时不丢失关键的单模态信息,而基于Mamba的结构显著提高了计算效率。更具体地说,该系统由两个单模态专家(一个病理学专家和一个基因组学专家)以及一个用于多模态融合的协同专家组成。单模态专家被设计为基于注意力的mamba多实例学习模块。每个专家采用三种扫描策略。具体而言,注意力模型首先对序列中的每个实例进行评分,然后按注意力分数降序重新排序,以明确捕获具有判别性的关键实例。两种常规扫描方向作为补充,用于捕获实例之间的全局上下文关系,如图1(a)所示。协同专家负责跨模态交互。作者首先使用Optimal Transport来显式学习两种模态之间的token级局部对应关系。应用基于Maximum Mean Discrepancy的全局跨模态融合损失来隐式增强分布一致性。然后将融合的表示传递给mamba Backbone 网络进行进一步整合。这种多阶段融合策略确保模型学习全面的多模态表示,如图1(b)所示。通过病理学专家、基因组学专家和协同专家的协作,yinqing-ME-Mamba_2509有效地捕获每个模态内的判别性信息,同时实现全面的多模态融合。
本文的主要贡献可总结如下:
- 作者提出了一个Multi-Expert Mamba (ME-Mamba)系统,该系统首次实现了病理图像、基因组数据及其多模态融合的并行处理,有效克服了基于transformer架构的固有局限性。
- 作者引入了一种注意力引导的Mamba架构(包含一个Pathology Expert和一个Genomics Expert),用于建模病理和基因组模态。这种设计明确地捕捉了每种单模态表示中的判别性关键特征和全局上下文信息。
- 作者开发了一种多模态mamba架构(the Synergistic Expert),该架构结合了局部token级对齐和全局分布一致性,实现了全面的跨模态交互。
- 作者在五个公共TCGA数据集上评估了ME-Mamba的性能,包括BLCA、BRCA、UCEC、GBMLGG、LUAD。ME-Mamba在生存预测任务中取得了卓越的性能,显著优于所有比较方法(平均高出 )。
状态空间模型(SSMs)是一类通过潜在状态转换来捕获时间或序列依赖关系的序列建模框架,这使它们特别适合处理长序列。与具有二次计算复杂度的Transformers中的自注意力机制不同,SSMs通过一系列潜在状态更新来对序列建模,实现了线性复杂度。S4[28]通过稳定状态矩阵的对角化并利用Cauchy核简化计算,解决了早期SSMs的高计算和内存成本问题。S5[29]通过用多输入多输出(MIMO)SSM替代多个独立的单输入单输出(SISO)SSM,进一步提高了效率,消除了对复杂卷积核计算的需求。Mamba[30](S6)通过引入依赖输入的选择机制和硬件感知算法,增强了S4的性能。与具有二次复杂度注意力的Transformers相比,Mamba在以线性复杂度处理长序列方面表现出色。
利用SSMs的进展,对将其应用于计算机视觉任务的研究兴趣激增。Vim[31]首次将Mamba引入计算机视觉任务,并提出了一种双向扫描策略来捕获上下文依赖关系。然而,由于其扫描方向受限,这种扫描策略无法捕获广泛的空间交互。后来,VMamba[32]设计了一个2D选择性扫描(SS2D)模块,该模块沿着四条扫描路径遍历图像块,以扩大感受野。EfficientVMamba[33]进一步引入了一种轻量级交错扫描机制来近似SS2D,从而降低计算成本。
在WSI分析的背景下,基于Mamba的方法也显示出显著优势。MambaMIL[20]首次将Mamba框架与多实例学习相结合用于WSI分析,通过在原始扫描方向之外增加从上到下重新排列序列的方式,增强了空间交互。为了进一步改善空间交互,MSMMIL[22]引入了网格扫描和层扫描策略,能够在单一序列长度内实现四向建模,并实现了高效的长序列建模。
2DMamba[21]设计了一种新颖的2D扫描方法来直接处理2D特征图,更好地保留了图像的空间连续性。然而,所有这些方法主要关注捕获全局序列信息和改善空间交互,而没有明确强调长序列中的判别性关键信息。相比之下,yinqing-ME-Mamba_2509引入了一种注意力引导的扫描机制,通过按照注意力分数降序扫描tokens,明确地优先处理判别性信息。
结合传统的从左到右和从上到下的扫描方向,yinqing-ME-Mamba_2509能够高效地从长实例序列中同时捕获全局上下文关系和判别性特征。
单模态
生存分析是一种用于评估事件发生时间及相关影响因素的统计和建模方法,它可以为医生评估疾病进展和治疗疗效的临床结果提供有价值的信息。传统的生存分析方法主要是单模态的。在早期研究中,生存分析主要依赖于Cox比例风险模型[34],利用短期临床指标和长期随访报告[4, 5, 6, 7, 35]。例如,Lai等人[5]将系统生物学和深度学习与十五种生物标志物和临床数据相结合,以预测非小细胞肺癌(NSCLC)患者的生存结果。Yu等人[35]将 Baseline 预后参数与临床指标的动态趋势相结合,为慢性肝衰竭急性发作(ACLF)患者开发了一种动态生存预测模型。病理图像直接揭示了肿瘤的形态特征,并提供了关于肿瘤侵袭性、治疗反应和疾病复发可能性的有价值信息。早期专注于病理图像分析的研究主要解决了分类等任务,尽管一些工作也将病理图像用于生存分析。例如,WSISA[8]通过聚类和深度卷积网络使用病理图像实现了端到端的生存预测。DeepAttnMISL[10]采用基于注意力的多实例学习(MIL)机制来聚合患者级表示,有效地在数据集上执行生存分析。然而,仅基于单模态病理图像的生存分析模型在临床应用中仍然不足。随着高通量测序技术的快速发展,基因组数据作为疾病建模和预后的指标已显示出高度相关性,从而为生存分析开辟了新的途径。
多模态。近年来,多模态数据融合在生存分析任务中获得了越来越多的关注。多模态数据从宏观、微观和分子水平为患者状况提供了多维度的洞察。通过整合来自不同模态的信息,可以实现对疾病更全面的理解,从而带来更准确的诊断、优化的治疗策略和更可靠的预后预测。病理图像和基因组数据的整合使得能够同时捕获肿瘤的形态特征和分子谱,从而增强生存模型的预测能力。例如,MCAT[19]提出了一种可解释的、密集的共注意力映射,该映射在嵌入空间中表述了WSI和基因组特征之间的关系。CMTA[14]采用了两个并行的编码器-解码器结构分别处理病理和基因组数据,同时使用一个跨模态注意力模块作为桥梁,以探索模态间关系并转移互补信息。CCL[13]设计了四个并行的Transformer编码器,将知识明确分解为四个组成部分,以实现更有效的多模态整合。现有方法通常依赖于交叉注意力或自注意力机制来实现跨模态交互和融合,旨在学习全面且有效的多模态表示。然而,高维多模态特征往往会模糊原始单模态数据中存在的关键生存相关信息。
此外,Transformers的二次时间复杂度限制了它们在处理大规模或长序列数据时的效率。这些局限性强调了开发平衡有效性和效率的新型多模态融合方法的必要性。为应对这些挑战,作者设计了一个基于Mamba的多专家系统,该系统并行处理单模态特征,并通过局部token级融合和全局分布对齐获得多模态表示,同时显著提高计算效率。
在本节中,作者首先描述多实例学习(MIL)和状态空间模型(SSM)的预备知识,然后概述所提出的多专家Mamba系统及其核心组件。
多实例学习(Multiple Instance Learning, MIL)是一种弱监督学习方法,它将训练数据建模为包(bags),其中每个包包含多个实例(instances)。如果一个包中至少包含一个正实例,则该包被 Token 为正。相反,只有当包中的所有实例都是负实例时,该包才被 Token 为负。例如,令 表示第 个包,其中 是实例的数量。该包的标签则定义为,
在典型的MIL流程中,首先提取实例级特征。然后,这些特征通过特定的池化或注意力机制被聚合成包级表示。最后,应用包级分类器基于聚合后的特征来预测包的标签。
受SSMs启发,结构化状态空间序列(S4)模型已成为长序列建模的一种有效架构。作为一种线性时不变系统,S4模型由四个组件参数化,通过隐藏状态将一维输入序列映射到输出。这个过程可以通过以下连续系统来描述,
其中是状态转移矩阵。和是投影参数。S4模型使用时间尺度参数将连续参数、转换为离散的对应参数、,通过
离散化后,该模型可以循环计算以实现高效的自回归推理,
在实际训练场景中,模型也可以通过卷积方法进行高效的并行计算,
Mamba通过融入选择机制和硬件感知并行算法,进一步增强了S4模型。这使得模型能够克服S4中静态参数的局限性,通过依赖于输入的选择性传播或沿序列遗忘信息,实现了高效的长序列建模。
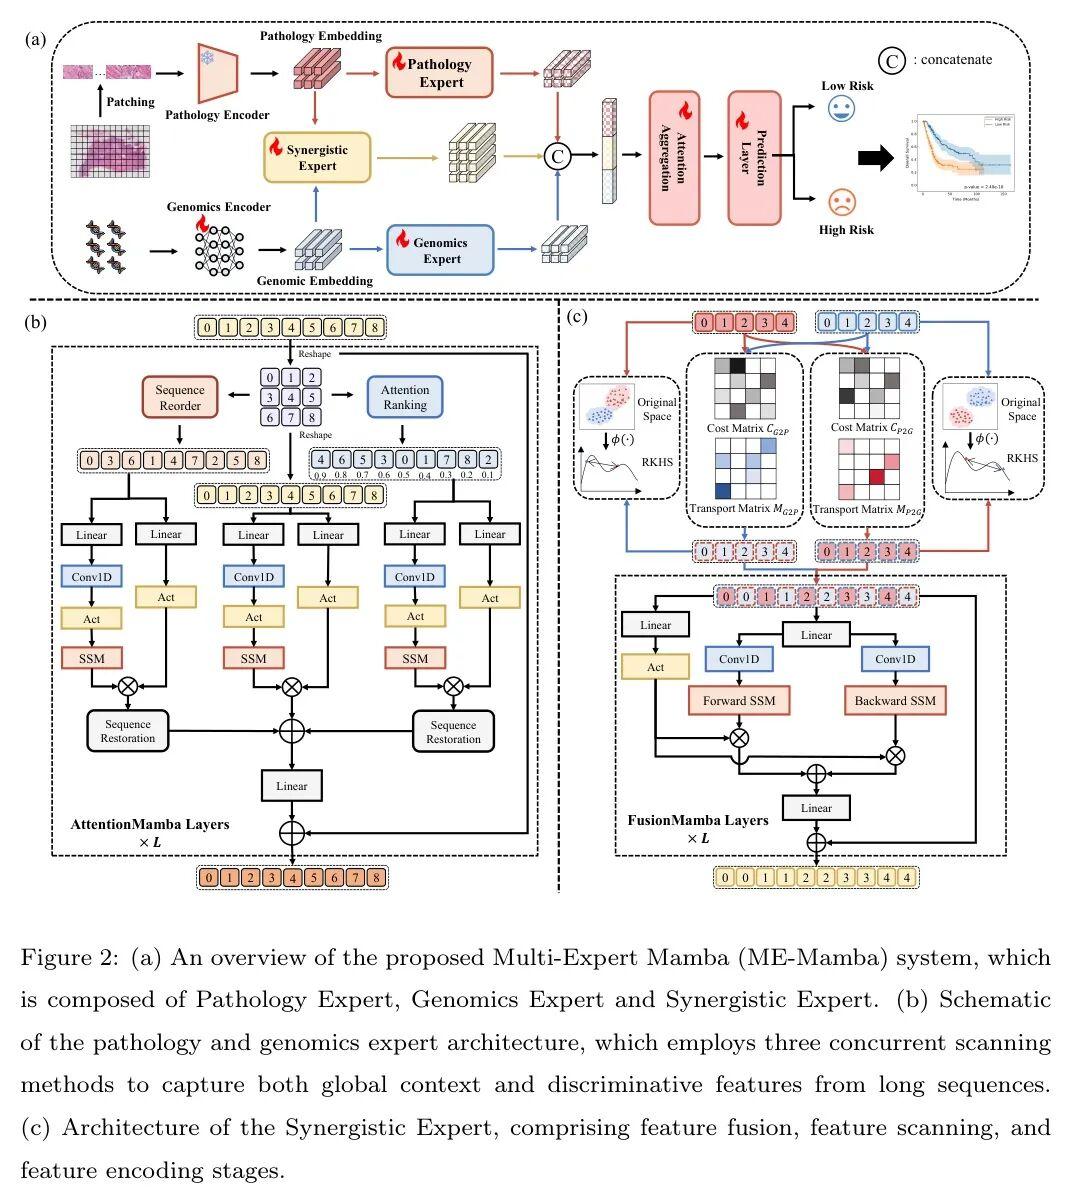
如图2(a)所示,所提出的多专家Mamba(ME-Mamba)系统包含三个主要步骤:实例级特征提取、基于专家的特征处理和结果预测。在第一步中,每个病理学全幻灯片图像(WSI)被划分为数千个不重叠的图像块,而基因组数据则按功能类别进行分组。然后,针对每种模态应用特定的特征提取方法,如第3.2.2节详述。在第二步中,利用病理学专家和基因组学专家分别从高度冗余的病理图像和基因组数据中提取判别性特征。进一步采用协同专家来有效整合病理学和基因组学特征。这些模块在第3.3节和第3.4节中详细阐述。最后,将提取的单模态特征和融合的多模态特征结合起来进行最终的生存预测,如第3.5节所述。
病理学
病理学图像,即全幻灯片图像(WSIs),提供关于肿瘤免疫微环境的形态学信息。然而,由于其极高的分辨率,WSIs无法被卷积神经网络直接处理,必须首先被分割。作者首先分割组织区域,然后在20 放大倍率下提取大小为256 256的不重叠图像块。遵循先前的工作[13, 14, 18],作者采用一个预训练的ResNet50[50]模型,该模型最初在ImageNet上训练,为每个图像块提取1024维嵌入。同一WSI的所有图像块嵌入被收集为一个嵌入集合。为了减少特征冗余和计算开销,作者采用一个多层感知器(MLP)将特征维度从1024减少到256。得到的特征向量然后被传递到病理学专家Mamba模块进行特征聚合。
基因组学。基因组图谱可以识别与癌症预后相关的特定基因改变或生物标志物。某些基因突变、基因表达模式和DNA拷贝数变异可作为预后指标,有助于预测患者的生存结果。作者将RNA测序(RNA-seq)、拷贝数变异(CNV)和简单核苷酸变异(SNV)序列按照先前方法[13, 14, 18]划分为六个子序列。每个子序列使用双层自归一化神经网络(SNN)[51]转换为特征向量,然后应用多层感知机(MLP)获得256维表示。这些特征向量随后被传递到基因组学专家Mamba模块进行特征聚合。
病理专家(Pathology Expert)旨在从病理图像中聚合实例级特征。它由多个堆叠的基于注意力的Mamba层组成,这些层从包含大量冗余或不相关数据的长实例序列中提取判别性特征并捕获全局信息,如图2(b)所示。通过将Mamba结构与多实例学习相结合,每个实例可以通过压缩的隐藏状态与先前扫描的实例进行交互,从而在降低计算复杂度的同时实现对长序列的有效建模。作者将传统扫描策略与注意力引导的扫描机制相结合,形成了一个三分支并行Mamba架构。传统扫描包括两种策略:原始扫描和转置扫描。基于注意力的扫描机制根据注意力分数对实例进行排序,使模型能够明确关注最具判别性的特征。
详细来说,给定实例特征 ,其中是序列长度,是特征维度,作者首先将序列输入到三个并行分支中。在第一个分支中,保留了原始序列顺序,并传递给后续的Casual Convolution和State Space Model (SSM)层进行序列建模。在第二个分支中,遵循MambaMIL[20],实例序列被转置并按顺序扫描,然后由相同的网络层处理。在第三个分支中,作者使用来自ABMIL[52]的注意力机制为每个实例分配一个注意力分数。然后实例按照注意力分数的降序重新排序,使模型能够在后续处理中优先处理高注意力特征。整体过程表述如下,
其中 表示转置扫描排序,而 代表序列恢复。 表示通过注意力分数进行重排序,而 表示序列恢复。
基因组学专家遵循与病理学专家相同的计算过程,但使用独立参数。通过这种方法,模型保留了原始序列顺序和分布,从全局视角重构特征,并通过基于注意力的重新排序强调区分性实例。这使得模型能够同时捕获全局上下文信息和关键实例级特征。
Synergistic Expert旨在有效整合病理图像和基因组数据的特征。它包含两种互补的融合机制:基于Optimal Transport (OT)[53]的局部token级对齐,以及通过Maximum Mean Discrepancy (MMD)[54]实现的全局分布匹配。这些机制被双向应用,同时使用病理学和基因组学特征作为 Anchor 点。生成的跨模态感知特征随后通过多个堆叠的多模态Mamba层,以进一步增强融合,如图2(c)所示。
作者采用Optimal Transport来实现两种模态之间的细粒度、token Level 的对齐,依次将每种模态作为 Anchor 点。这种方法将特征序列视为离散分布,并学习一个传输计划,该计划最小化将一个分布映射到另一个分布的成本,从而建立token Level 的对应关系。
详细来说,给定病理学实例特征 和基因组学实例特征 ,其中 和 是序列长度, 是特征维度,作者的目标是学习一个传输矩阵 ,该矩阵捕获细粒度的跨模态关系。以从病理学到基因组学的映射(以基因组学为 Anchor 点)为例,目标函数表述为,
其中 是代价矩阵。作者使用余弦距离来强调特征向量之间的角度相似性,由于其有界范围,这也提供了数值稳定性,
由于解决这个最优传输问题的计算成本很高,作者遵循先前的方法[55, 56]采用了一个简化版本,
这种简化使得一个基因组实例能够与多个病理实例交互,同时保持捕捉有意义的跨模态相关性的能力,并显著降低计算复杂度。传输矩阵最终计算为,
类似地,作者计算用于基因组到病理学映射的传输矩阵 。然后,融合特征获得为,
虽然这种基于OT的融合有效捕获了局部token Level 的对应关系,但它本身并不能确保模态之间的全局一致性。为了解决这个问题,作者引入了一种额外的全局跨模态融合策略。
为了隐式地对齐局部融合特征和 Anchor 特征之间的全局分布,作者采用Maximum Mean Discrepancy (MMD)。MMD通过比较高维Reproducing Kernel Hilbert Space (RKHS)中的统计量来测量不同模态之间的统计差异。对于两个特征和,平方MMD距离定义为,
其中 表示从原始特征空间到RKHS 的映射。在实践中,作者使用核函数来计算这个映射,
具体而言,作者使用一个高斯核 k(x, y) = exp − ∥x−y∥222σ2 。
对于局部融合的病理特征 ,全局对齐损失被公式化为,
在训练过程中最小化这种损失确保了融合后模态之间的全局分布一致性。作者的策略结合了显式的局部token级对齐和隐式的全局分布匹配,实现了多粒度对齐,并促进了在后续Mamba Backbone 网络中更有效的特征编码。
在对病理和基因组实例特征执行token Level 显式局部融合和分布 Level 隐式全局对齐之后,作者采用双向Mamba (BiMamba)[31]主干网络来进一步整合这两种模态。与通过自注意力同时处理所有token的传统基于Transformer的方法不同,yinqing-ME-Mamba_2509采用有序扫描策略,既保留了Mamba的序列特性,又实现了有效的跨模态交互。给定局部和全局融合的特征序列,作者通过按顺序交错来自两种模态的特征来构建统一的多模态特征序列,
这种交错组织确保了来自不同模态的特征被顺序处理,使得Mamba的选择性扫描机制能够有效捕获模态内和模态间的依赖关系。多模态表示最终通过多个堆叠的BiMamba层获得。
经过各自专家模块处理后,获得了包含判别性信息的病理实例特征序列、基因组特征序列和多模态特征序列。作者将这三个特征序列连接起来,并将实例级特征聚合成袋级表示。聚合方法遵循ABMIL[52]。最后,使用多层感知器(MLP)来预测风险函数,
其中 、 和 分别表示由病理学专家、基因组学专家和协同专家处理的特征序列。 表示连接操作,AGG 表示特征聚合。
对于生存预测,遵循先前的研究[13, 14, 18, 19, 47, 48],作者将原始的事件时间回归问题简化为一个分类问题。患者的真实生存时间被离散化为个等长区间。事件发生的区间被用作患者的类别标签。模型预测事件在每个时间区间发生的概率,形成一个风险向量。每个患者样本表示为一个三元组,其中表示右删失状态。离散生存函数定义为。生存预测损失被表述为,
最后,yinqing-ME-Mamba_2509的整体损失函数公式化为,
其中是全局对齐损失的权重系数。
在本节中,作者在五个公共数据集上进行了广泛的实验,以评估作者提出的模型的有效性。作者首先介绍研究中使用的数据集和评估指标。然后,作者将实验结果与几种最先进的方法进行比较,以展示yinqing-ME-Mamba_2509的优越性,并进行了可解释性分析。最后,作者进行了消融实验以研究关键组件的影响。
数据集。为了验证所提出方法的性能,作者使用五个癌症数据集进行了一系列实验。这些数据集来源于癌症基因组图谱(TCGA)1,其中包含来自数千名癌症患者的配对诊断全幻灯片图像(WSIs)和基因组数据,以及临床信息。这些包括膀胱尿路上皮癌(BLCA, )、乳腺浸润性癌(BRCA, )、子宫体子宫内膜癌(UCEC, )、胶质母细胞瘤和低 Level 胶质瘤(GBMLGG, )以及肺腺癌(LUAD, )。对于WSIs,作者首先分割每个幻灯片的组织区域,然后在20倍放大率下将其切割成256 256的 Patch 。对于基因组数据,遵循先前的研究[13], [14], [19],作者使用RNA-seq、CNV和SNV序列,并进一步将它们分为六个子序列:1)肿瘤抑制,2)肿瘤发生,3)蛋白激酶,4)细胞分化,5)转录,以及6)细胞因子和生长。
评估指标
采用一致性指数(C-index)[57]来衡量生存预测性能。C-index衡量生存分析中模型准确排序个体生存时间的能力,评估预测风险分数与实际生存结果之间的一致性。Cindex可以表述如下,
其中是患者数量,和分别是第个和第个患者的生存时间。表示指示函数,当括号内的条件为真时其值为,否则为0。
实现细节
作者采用5折交叉验证来评估yinqing-ME-Mamba_2509和其他比较方法在五个癌症生存预测任务中的表现。具体来说,作者首先随机打乱数据集并将其分成五组,其中四组作为训练集,一组作为测试集。作者在训练集上训练模型,并在测试集上评估其性能,以报告相应的C-index分数(均值标准差)。作者采用了学习率为1e-3的SGD优化器,并将该框架训练了30个epochs。所有实验均使用Python 3.10和Pytorch工具包版本2.0在配备NVIDIA GeForce RTX 4090 GPU的平台上进行。
为了证明ME-Mamba的有效性,作者将其与单模态 Baseline 模型和多模态SOTA方法进行比较。对于基因组数据,作者实现了SNN[51]和SNNTrans。对于病理学数据,作者实现了ABMIL[52]、CLAM[58]、TransMIL[59]和DTFD[60]。对于多模态模型,作者选择了MCAT[19]、M3IF[61]、GPDBN[15]、Porpoise[62]、HFBSurv[63]、SurvPath[48]、MOTCat[18]、CMTA[14]和CCL[13]。这些模型被分为单模态和多模态两组,下面简要介绍几个代表性模型。
单模态模型
对于基因组数据,SNNTrans是SNN[51]的一个变体,它使用自归一化神经网络(SNN)来提取实例级的基因组特征,然后使用TransMIL将这些特征聚合成包级表示。对于病理学数据,ABMIL假设图像实例是独立同分布(i.i.d.)的,并采用注意力机制来聚合实例特征。TransMIL通过引入相关性建模和空间编码打破了i.i.d.假设,使用自注意力机制来聚合实例特征。
多模态模型。MCAT使用共注意力机制在嵌入空间中动态对齐病理图像特征和基因组特征,然后使用Transformer进行多模态融合。聚合的特征随后被连接用于生存预测。SurvPath将转录组数据分解为不同的生物通路特征,并使用Sparse注意力Transformer来建模通路之间、病理图像与通路之间以及跨通路的相互作用。MOTCat采用最优传输来计算病理图像特征和基因组特征之间的全局匹配流,比传统共注意力更有效地捕获肿瘤微环境中的空间相互作用和基因共表达中的结构一致性。CCL明确地从病理和基因组数据中分解交互知识,并在知识层面和患者层面都采用队列引导的监督。
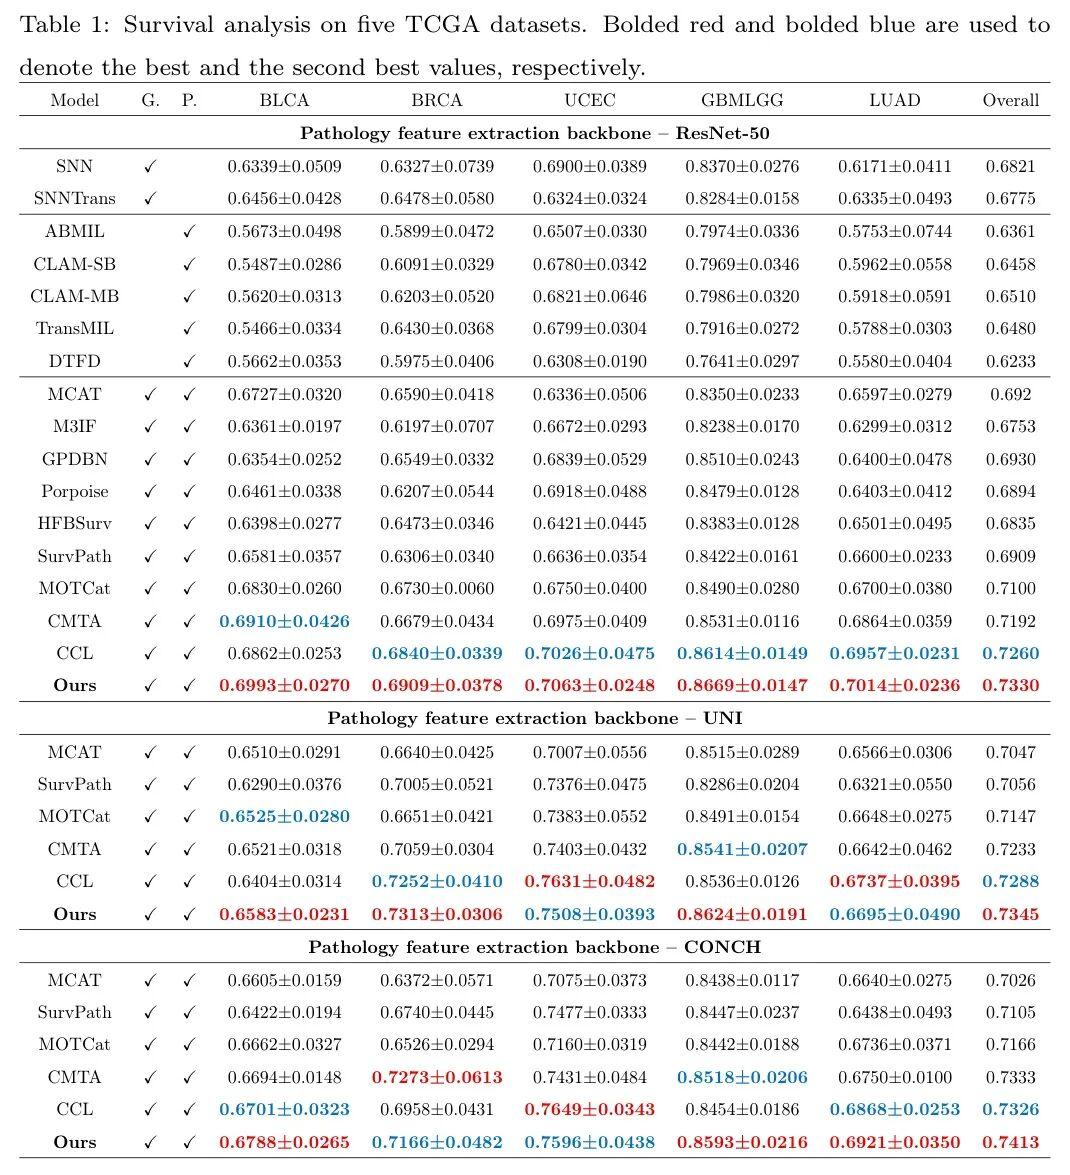
与单模态模型的比较。如表1所示,所yinqing-ME-Mamba_2509在所有五个数据集上都取得了优越的性能。具体而言,它在BLCA上达到了0.6993的C-index,优于最佳单模态模型;在BRCA上为0.6910,显示出6.7%的改进;在UCEC上为0.7063,有的提升;在GBMLGG上为0.8669,超过最佳单模态结果;在LUAD上为0.7014,代表了10.7%的改进。这些结果表明,yinqing-ME-Mamba_2509有效地整合了多模态数据,并强调了多模态学习对生存分析的好处。此外,作者观察到使用基因组数据的单模态方法通常优于使用病理图像的方法,这表明基因组特征可能与患者生存结果表现出更强的相关性。yinqing-ME-Mamba_2509成功地利用了两种模态的互补信息,进一步提高了生存预测的准确性。
与多模态模型的比较
如表1所示,与现有的最佳多模态方法相比,yinqing-ME-Mamba_2509也实现了优越的性能。具体而言,在BLCA上,它将C-index提高了,在BRCA上提高了1.1%,在UCEC上提高了,在GBMLGG上提高了,在LUAD上提高了,均优于最强的多模态 Baseline 。这种改进可以归因于作者的多专家架构,该架构在保留全局上下文和实现有效模态融合的同时,明确捕获了判别性信息。
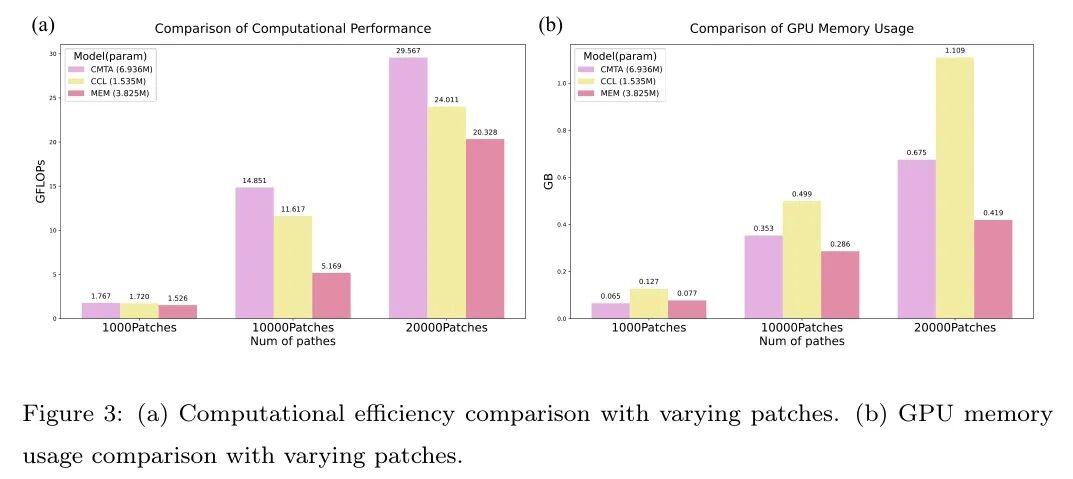
此外,与现有的基于Transformer的多模态方法不同,yinqing-ME-Mamba_2509利用了Mamba架构,从而实现了更高的计算效率和更低的内存消耗。作者在不同实例数量下将ME-Mamba与两种表现优异的基于Transformer的方法CMTA和CCL进行了比较,如图3所示。作者手动构建了维度为1024的实例向量,数量分别为1000、10,000和20,000,以模拟从WSIs中提取的不同数量的图像块,同时将基因组特征组的数量固定为六个。首先,作者比较了不同实例数量下的GPU内存使用情况(图3(a))。在所有设置中,ME-Mamba始终消耗最少的内存。在1000个实例的情况下,与CCL相比,ME-Mamba将GPU内存使用量减少了;在20,000个实例的情况下,减少幅度达到了,这证明了其在处理大型全幻灯片图像方面的卓越效率。其次,作者分析了每种方法所需的FLOPs来量化计算效率(图3(b))。在所有三种实例数量下,ME-Mamba都实现了最低的FLOPs,证实了其高效率。在10,000个实例的情况下,与CMTA相比,ME-Mamba将计算操作减少了65.2%,突显了Mamba架构在多模态融合任务中的优势,这与较低的内存占用是一致的。
为了进一步证明yinqing-ME-Mamba_2509的鲁棒性,作者还使用两个权威的基础模型UNI[64]和CONCH[65]提取了病理图像特征,并将结果与顶级多模态方法进行了比较。yinqing-ME-Mamba_2509保持了高度竞争力,并取得了最佳的整体性能。
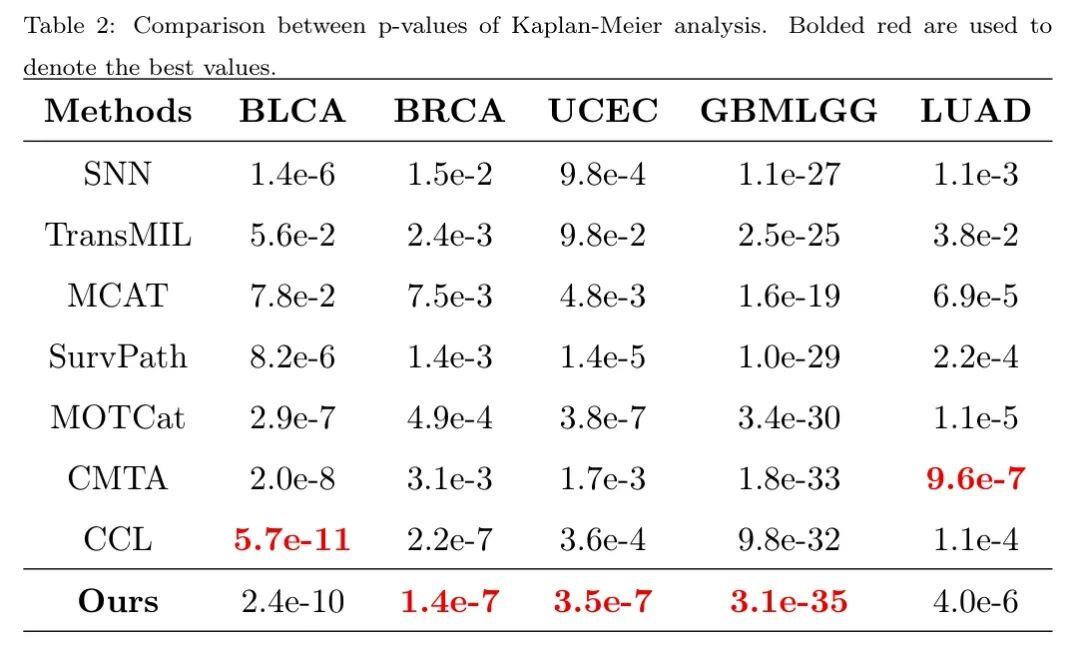
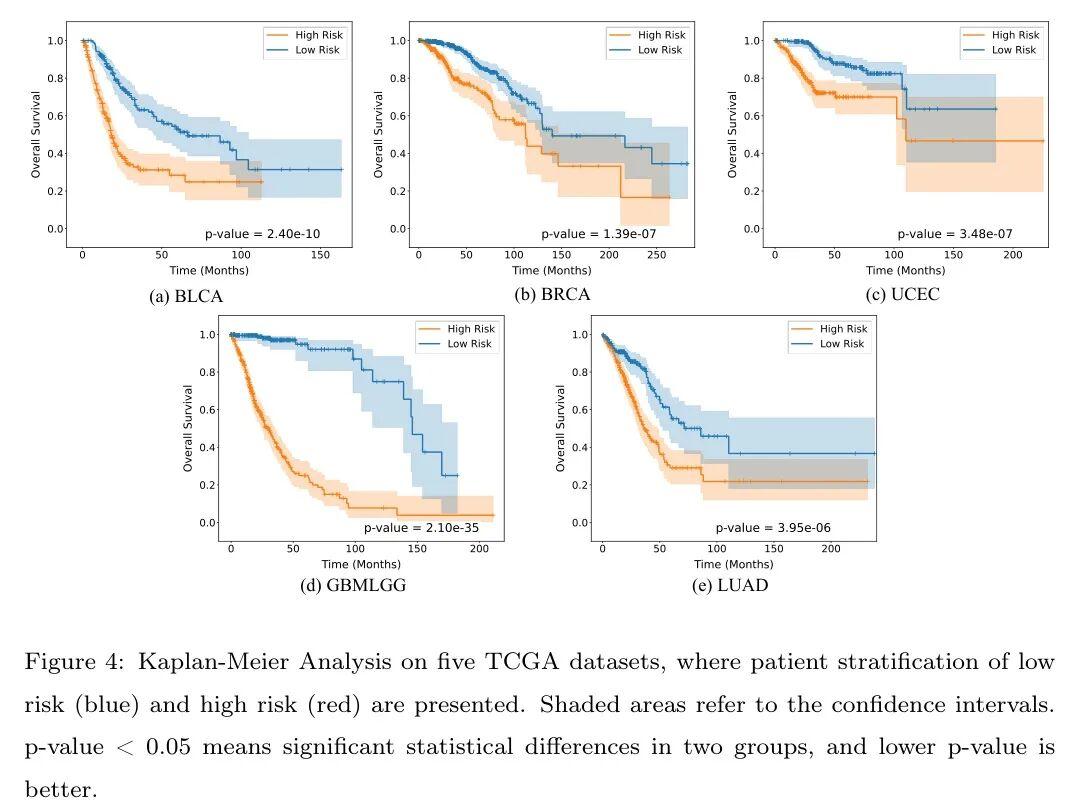
为了进一步验证ME-Mamba在生存分析中的有效性,作者采用Kaplan–Meier分析来可视化所有患者的时间-事件结果。Kaplan–Meier估计器是一种非参数统计方法,用于估计生存函数和分析时间-事件数据。具体来说,作者首先使用yinqing-ME-Mamba_2509为每个患者预测风险评分。然后,根据风险评分的中位数,将患者分为高风险组和低风险组。最后,作者使用Kaplan–Meier曲线可视化生存事件,如图4所示。作者应用log-rank检验来评估高风险组(红色曲线)和低风险组(蓝色曲线)之间差异的统计显著性。在所有五个数据集上得到的p值均显著低于0.05,表明yinqing-ME-Mamba_2509在生存分析中具有很强的区分能力。作者还将yinqing-ME-Mamba_2509获得的p值与其他最先进方法获得的p值进行了比较,如表2所总结。yinqing-ME-Mamba_2509在BRCA、UCEC和GBMLGG数据集上实现了最低的p值,同时在BLCA和LUAD上表现出极具竞争力的性能。这些结果说明了yinqing-ME-Mamba_2509在多种癌症类型上的泛化性和鲁棒性,表明其通过可靠的生存预测有潜力增强临床决策和癌症研究。
4.4.1. WSI Heatmap 的可视化
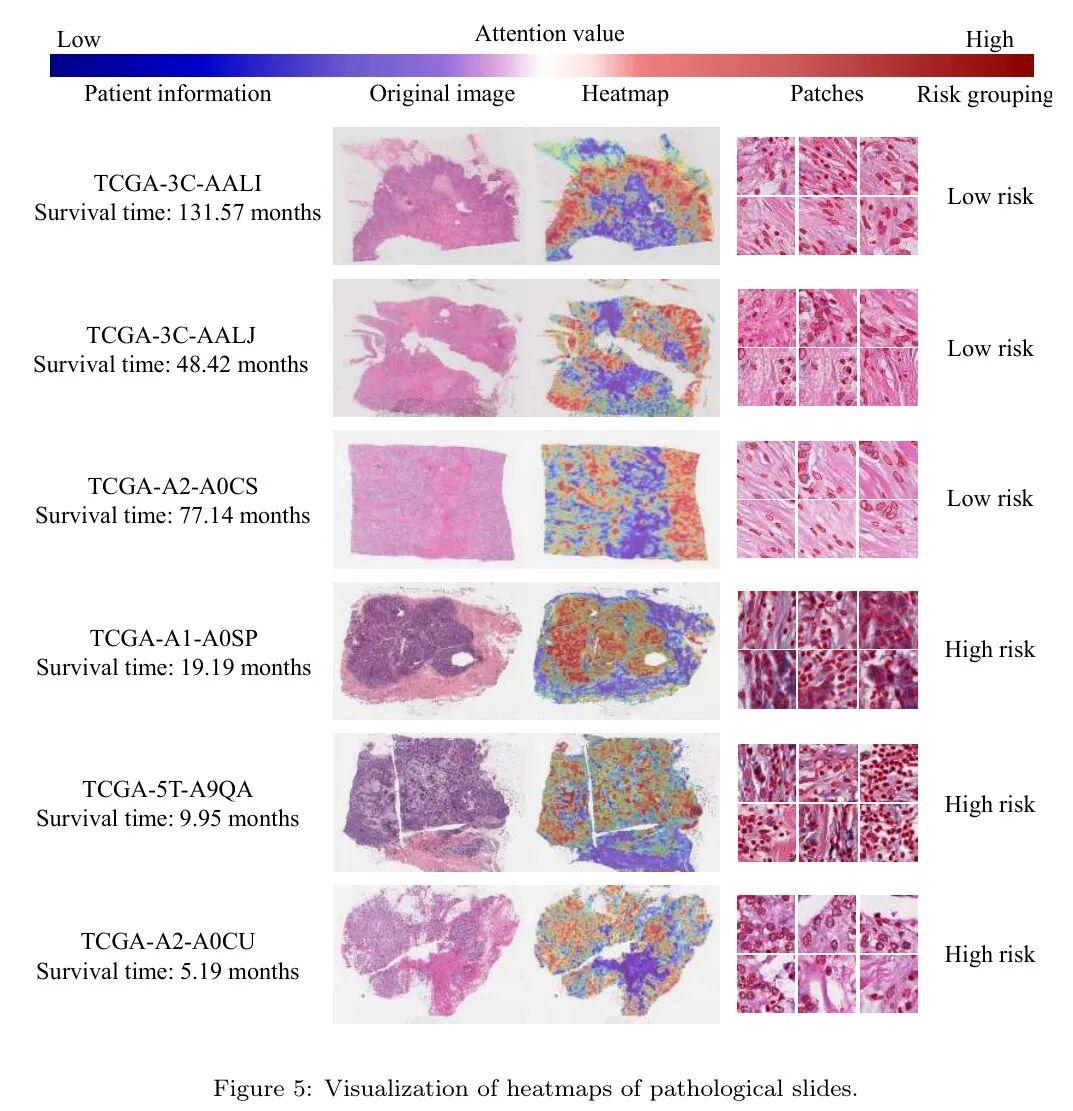
作者对多专家系统中的病理学专家进行了可解释性分析,以进一步展示其卓越性能,如图5所示。作者使用注意力权重在WSIs上创建 Heatmap ,以突出代表性的病理区域。具体而言,模型根据每个图像区域对最终预测的贡献为其分配分数——分数越高表示重要性越大。作者将权重在0到1之间进行归一化(即从蓝色到红色),选择得分最高的前六个区域进行详细可视化,并对细胞核进行分割。如图5所示,较高权重的区域表现出相似的视觉特征,如大小不一的细胞核、细胞核异型性以及异常的核质比,这表明模型能够自适应地聚焦于肿瘤区域,以协助病理学家进行诊断。此外,来自不同风险水平患者的高权重区域显示出不同的形态特征。例如,在低风险病例"TCGA-3C-AALI"(生存时间:131个月)中,区域显示出低 Level 多形性。相比之下,高风险病例"TCGA-5T-A9QA"(生存时间:9.95个月)表现出细胞核严重拥挤的区域。这些 Heatmap 可视化表明,yinqing-ME-Mamba_2509能够有效定位WSIs中的区分性区域,这对于准确的生存预测至关重要。
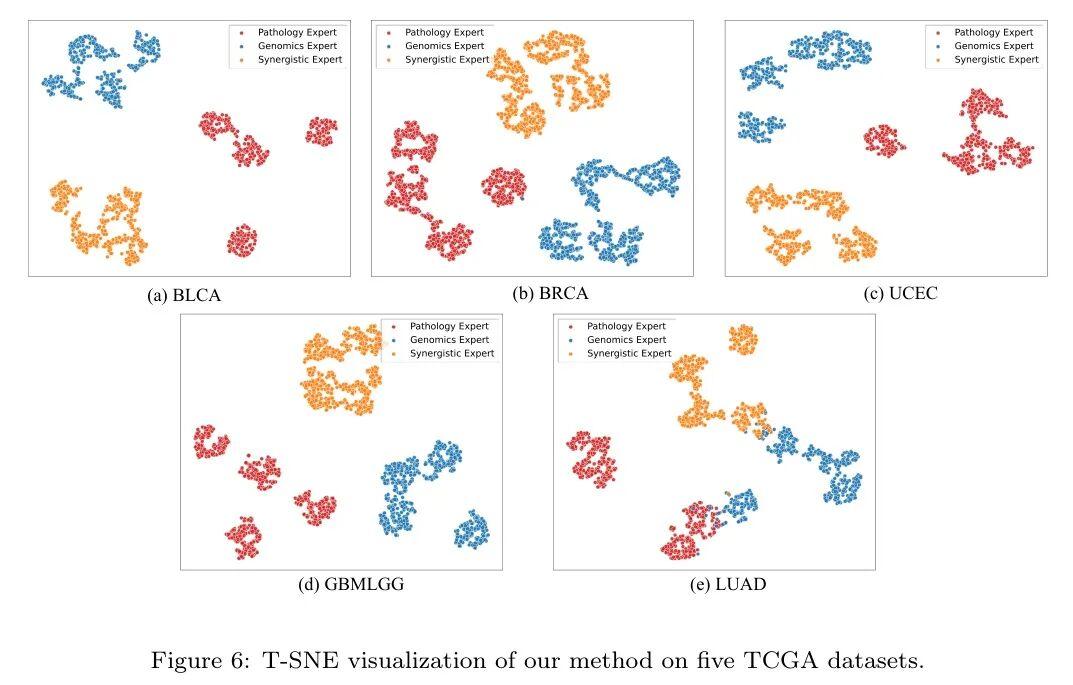
作者采用T-SNE[66]来可视化Pathology Expert、Genomics Expert和Synergistic Expert输出的特征分布。T-SNE在低维空间中最小化相似数据点之间的距离,同时最大化不相似点之间的距离。如图6所示,不同颜色的点代表了来自不同专家的特征分布。特征集合之间的清晰分离和最小重叠强烈表明每个专家模块在最终预测中起着互补作用。在每个专家内部,特征点进一步聚类成大约四个组,这与将真实生存时间划分为四个离散区间相一致。这种聚类行为证实了作者系统中的每个专家都能有效捕获与生存预测相关的判别性模式。
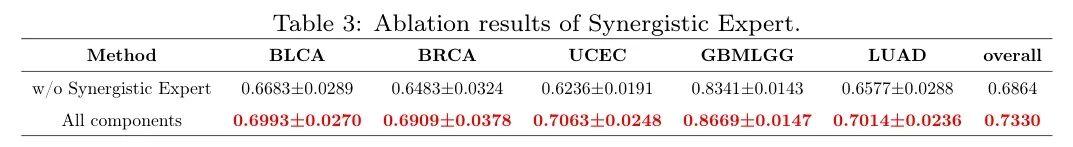
为了验证所提出的Synergistic Expert的有效性,作者进行了消融实验。首先,作者完全移除了Synergistic Expert并评估了模型的性能。如表3所示,在所有五个数据集上性能均显著下降:在BLCA上C-index降低了4.4%,在BRCA上降低了,在UCEC上降低了11.7%,在GBMLGG上降低了,在LUAD上降低了。这些结果有力地证明了Synergistic Expert在跨模态融合中的重要性。
接下来,作者保留了Synergistic Expert,并将其多模态特征处理分为三个阶段:特征融合、特征扫描和特征编码。
在特征融合阶段,作者评估了局部跨模态融合和全局跨模态融合的贡献。结果如图7(a)所示。移除任一组件都会导致性能下降。例如,在UCEC数据集上,移除局部融合使C-index降低了,而移除全局融合则导致的下降。值得注意的是,与相反的情况相比,保留局部融合而移除全局融合时,模型表现更好。这可以归因于局部融合通过Optimal Transport显式地对齐模态间的tokens,而全局融合则使用MMD隐式地匹配特征分布。
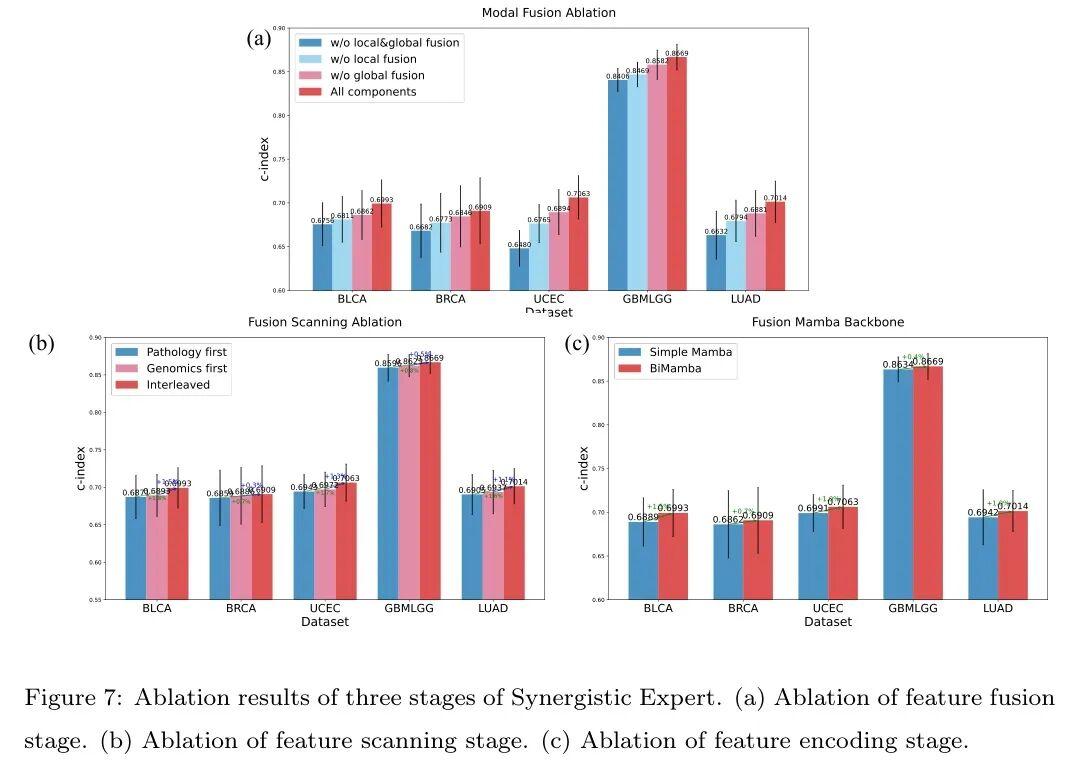
在特征扫描阶段,作者将提出的两种模态的交错扫描与两种替代扫描策略进行了比较:(1) 先扫描病理特征序列,然后扫描基因组序列。(2) 先扫描基因组特征序列,然后扫描病理序列。如图7(b)所示,在所有数据集上,两种替代策略的表现均不如交错扫描方法。这是因为顺序扫描导致模型一次主要关注一种模态,限制了有效融合。此外,先扫描基因组特征导致的性能下降小于先扫描病理特征,这与单模态基因组方法通常优于单模态病理方法的观察结果一致,可能是由于基因组数据与生存结果的相关性更强。
在特征编码阶段,作者将提出的BiMamba Backbone 网络与一个简单的mamba模型进行了比较。图7(c)中的结果显示,BiMamba实现了更高的c-index值,这归功于其双向建模能力,该能力能够处理前向和后向序列上下文,并提高密集预测任务中的性能。
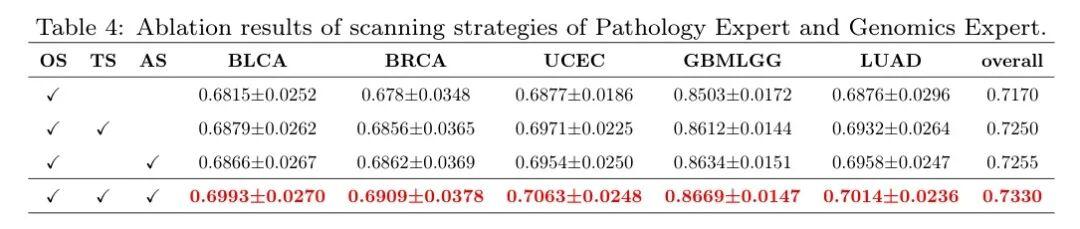
作者的病理学专家和基因组学专家Mamba模块整合了三种扫描策略:原始扫描、转置扫描(共同构成常规扫描策略)以及提出的注意力引导扫描。为了评估这些多重扫描机制的有效性,作者设计了三种实验设置进行比较:仅使用原始扫描,同时使用原始和转置扫描,以及同时使用原始和注意力引导扫描。结果总结在表4中。实验结果表明,与仅使用原始扫描相比,采用两种或更多扫描策略能持续提高性能。这种增强归因于多重扫描策略能够更全面地捕捉所有实例之间的关系。此外,作者观察到将原始扫描与提出的注意力引导扫描相结合,比将原始扫描与转置扫描相结合产生更高的性能。这是因为通过注意力分数对实例进行排序,使模型能够更多地关注与生存结果高度相关的判别性实例。然而,仅使用两种扫描策略仍未达到最佳性能。当所有三种策略结合使用时,获得了最佳结果。这种集成方法使模型能够同时捕捉与生存相关的判别性实例级信息和全局上下文关系,而原始扫描则补偿了其他两种策略可能忽略的特征细节。
在本文中,作者提出了多专家Mamba(ME-Mamba),这是一个用于多模态生存分析的开创性系统,通过三个专门专家协同病理图像和基因组数据。这代表了将Mamba架构应用于多模态生存分析任务的重要进展。
在作者的系统中,病理专家和基因组专家采用注意力引导的扫描机制,从千兆像素全幻灯片图像(WSIs)和高维基因组数据中提取判别性特征,在保留全局上下文的同时明确捕获关键实例级信息。协同专家结合了基于最优传输(OT)的局部 Token 融合和基于最大均值差异(MMD)的全局分布匹配,以全面建模跨模态交互。
得到的表示通过BiMamba Backbone 网络进一步细化,以产生丰富的多模态特征。在五个TCGA数据集上的大量实验验证了ME-Mamba的最先进性能、高计算效率和强大的临床可解释性。鉴于其强大且可推广的性能,所提出的模型未来可以扩展以整合更多数据模态,为其适应涉及多样化数据类型的更复杂任务铺平道路。
[1]. ME-Mamba: Multi-Expert Mamba with Efficient Knowledge Capture and Fusion for Multimodal Survival. Analysis
点击上方卡片,关注「AI视界引擎」公众号