南京科技大学、中南大学再论视觉压缩破解长上下文难题:像人类一样阅读
大语言模型正在学习一种古老而高效的技能:像人类一样阅读。
继DeepSeek-OCR,智谱Glyph之后,南京科技大学、中南大学再发论文,提出VIST(视觉中心化token压缩)的方法,用视觉压缩破解长上下文难题。
但VIST更像是让AI学会了看书划重点,实现更智能的token压缩。
我们读书时,眼睛会快速扫过那些平平无奇的词语,却在关键、信息量大的词汇上停留。
这是一种天生的慢-快阅读节奏。
现在,这种名为VIST的方法,正在教会AI这种能力,通过把一部分文本看成图片来处理,极大地提升了处理长文本的效率和效果。
大语言模型的上下文窗口正在飞速膨胀,从几千token到一百万token,模型参数也增长到万亿级别。这带来了巨大的计算和内存压力。
而且,模型并非总能有效利用这百万token的超长上下文,它们常常在信息的海洋中迷失,难以找到开头或中间的关键信息。
计算成本也随着输入长度指数级上升。这使得token压缩技术,从一个锦上添花的工具,变成了不可或缺的必需品。
心理学给了我们灵感。
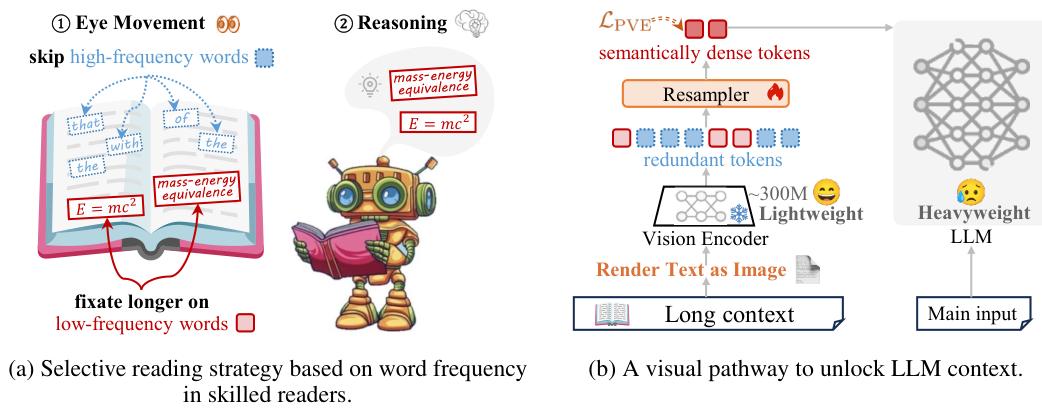
人类阅读时,眼睛会跳过近三分之一的高频功能词,比如“的”、“是”、“在”,而凝视那些罕见、内容丰富的词。
这形成了一个自然的慢-快回路:快速的视觉通道(余光)扫视远距离、不太重要的上下文,维持全局感知;慢速的认知通道(正眼)则聚焦于附近的重要句子,进行深度理解。
VIST正是模仿了这种策略。
LLMs学会了看图识字
VIST的核心思想是搭建一个慢-快处理框架。
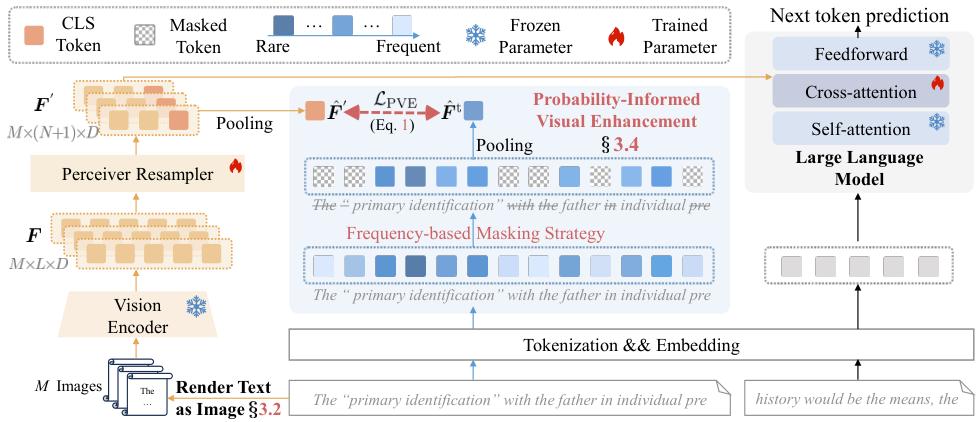
它把遥远且相关性较低的上下文,直接渲染成一张张图片。这些图片交给一个轻量级的视觉编码器处理,就像我们的眼睛用余光快速扫描。这个过程会生成高度浓缩的视觉token。
同时,最核心、最邻近的文本内容,则以原始的文本token形式,直接交给大语言模型这个大脑进行精细的推理。
这种设计,让视觉编码器像眼睛一样,选择性地关注显著信息;让大语言模型像大脑一样,专注于信息量最大的内容进行深度思考。
实现这一点的关键,是使用了一个冻结的视觉编码器,比如来自CLIP(对比语言-图像预训练)的视觉变换器(Vision Transformer, ViT)。
CLIP在海量图文对上进行训练,天然具备了光学字符识别(OCR)的能力,这使它成为理解文本图像的强大工具。
文本被渲染成固定尺寸的RGB图像,然后输入ViT。ViT将其分割成小块,提取特征。这些特征随后被送入一个叫作感知重采样器(Perceiver Resampler)的组件,它能将数量不定的图像特征,压缩成固定数量的视觉token。
举个例子,在训练中,4096个文本token被渲染到28张图片上,最终被压缩成1792个视觉token。这个过程本身就是一种高效的压缩。
更重要的是,这种基于视觉的分词方式,相比传统的文本分词器,优势明显:
简化了分词流程,摆脱了小写化、去标点、去停用词等繁琐的规则。
缓解了词汇瓶颈。传统分词器受限于有限的词汇表,而视觉编码器将所有语言统一为图像,无需词汇表。
对拼写错误、字符级噪声的鲁棒性更强,因为它捕捉的是整体视觉模式,而非离散的字符匹配。
在处理多语言时效率更高。研究显示,视觉分词器能将日语token数量减少62%,韩语减少78%,中文减少27%。
让模型关注信息量最大的内容
只是把文本变成图片还不够。视觉编码器最初是在自然图像上预训练的,它并不知道一张文本图片里的哪些词更重要。
为了解决这个问题,VIST设计了一种名为概率信息视觉增强(Probability-Informed Visual Enhancement, PVE)的训练机制。
PVE的核心思想是,让视觉编码器压缩后产生的视觉token,在语义上与原始文本中最重要的信息保持一致。它通过一种对比学习的方式实现,鼓励视觉表示和文本表示在嵌入空间中相互靠近。
这里的秘密武器是基于token频率的遮蔽策略。
这个想法借鉴了香农信息理论:一个事件发生的概率越低,它所携带的信息量就越大。
应用到文本中,罕见的词(如专业术语、特定人名地名)通常携带关键信息,而频繁的词(如的、一个)则更多服务于语法结构,信息量较低。
所以,PVE在训练时,会故意遮蔽掉那些高频、低信息量的文本token。
然后,VIST会遮蔽掉50%重要性分数较低的token。这相当于给文本画出了重点,强迫视觉编码器在学习时,必须去关注那些未经遮蔽的、信息量更丰富的罕见词。
这种语义丰富的文本监督,极大地提升了重采样器捕捉关键信息的能力,弥合了视觉和文本之间的语义鸿沟,实现了更智能的token压缩。
效果远超预期
VIST的实际表现,通过一系列严格的实验得到了验证。
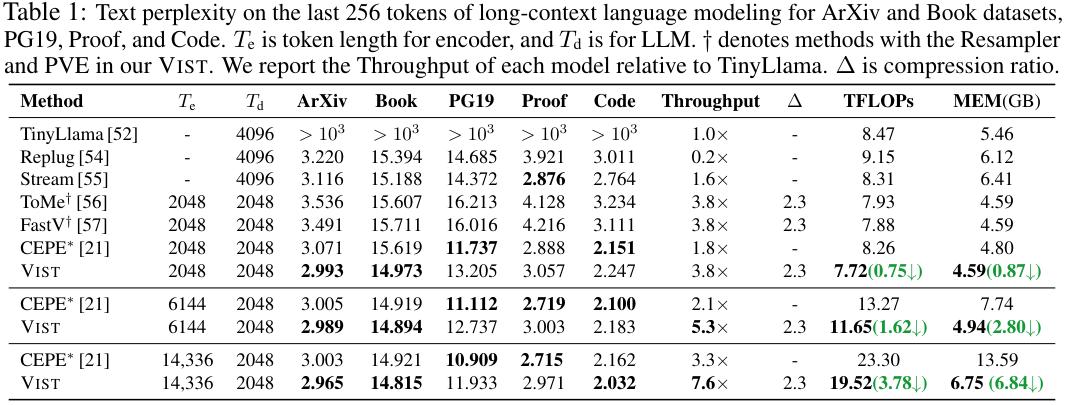
在长上下文语言建模任务中,普通的小模型(如TinyLlama)在处理超过其2048个token的上下文窗口后,性能会急剧下降,困惑度(Perplexity, PPL,一个衡量模型预测准确性的指标,越低越好)飙升。
VIST则不同,随着输入文本变长,它的困惑度持续降低,证明它能有效利用长上下文信息。
在推理成本上,VIST的优势更加明显。
它将1024个文本token渲染成7张图像,最终压缩为448个视觉token,压缩比达到2.3倍。
与目前最强的基于文本编码器的压缩模型CEPE相比,VIST在性能相当的情况下,计算量减少16%,内存使用减少50%。
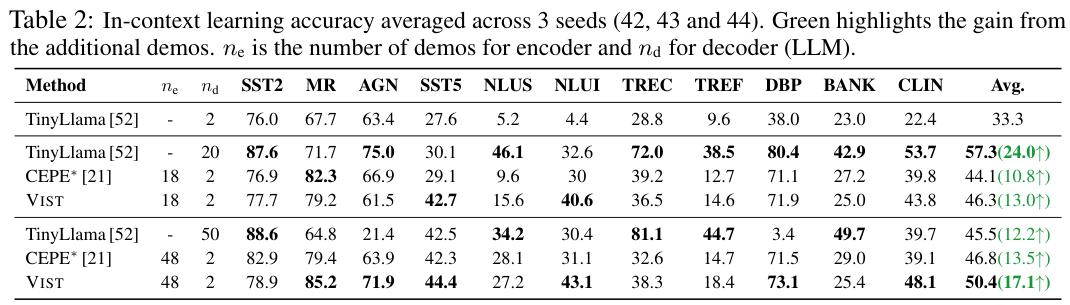
在上下文学习(In-Context Learning, ICL)任务中,模型需要根据提供的一些示例来完成新任务。
当给VIST的视觉编码器提供更多示例(从0增加到18个)时,它的平均准确率提升了13%。
这证明大模型确实学会了从视觉信号中理解文本。在11个数据集的综合评估中,VIST的平均准确率比CEPE高出7.6%。
在更具挑战性的开放域问答(Open-domain QA)任务中,模型需要从检索到的大量文本段落中找到答案。
TinyLlama一次最多处理10个段落,再多就会崩溃。
VIST则可以轻松处理更多段落,并且随着段落增多,性能持续提升。当处理30个段落(10个给解码器,20个给编码器)时,VIST在TriviaQA数据集上的精确匹配(Exact Match, EM)分数比CEPE高出9.11个百分点。
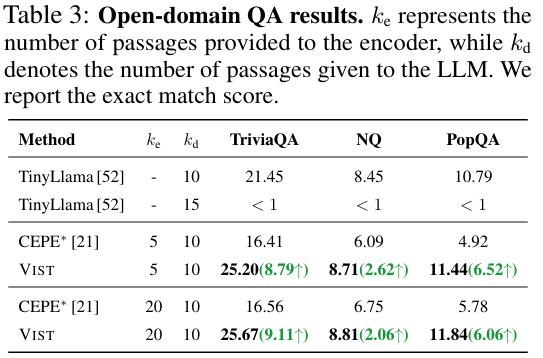
这背后的原因是,PVE机制帮助VIST过滤掉了冗长输入中的噪声,优先保留了与问题最相关的信息。相反,CEPE在面对更多段落时,性能反而下降,因为它引入了更多噪声和冗余,让模型更难找到答案。
重新审视文本的冗余与价值
VIST的成功,验证了token频率是语义重要性的一个简单而有效的代理。
为了证明这一点,研究人员做了一个实验。
他们分别遮蔽掉文本中最重要(最罕见)和最不重要(最频繁)的token,然后观察这两种操作对语义对齐的影响。
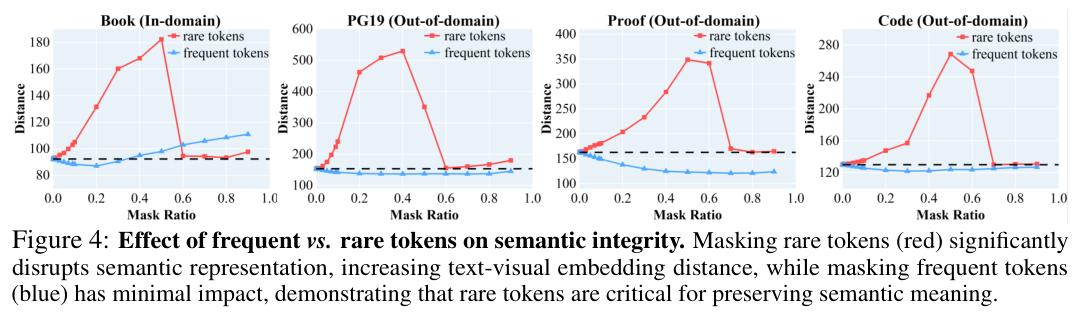
遮蔽掉哪怕只是一小部分罕见token(红线),文本的视觉表示和文本表示之间的语义距离就会急剧增加。这说明罕见词是维系全局语义的顶梁柱。
反之,遮蔽掉大量频繁token(蓝线),语义距离几乎不变,甚至有所减少,因为这清除了噪声。
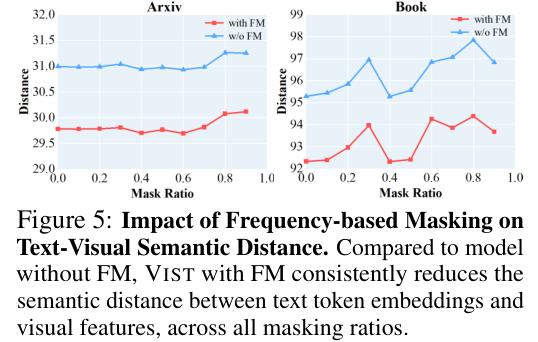
在所有遮蔽比例下,使用了基于频率遮蔽的VIST(蓝线)始终比不使用的版本(红线)具有更小的语义距离,证明了这种策略能有效增强语义一致性。
我们可以更直观地看到这一点。
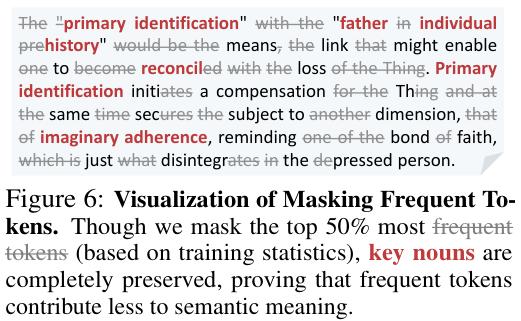
遮蔽掉50%最频繁的token后的文本。可以看到,所有关键的名词都得以保留,被去掉的几乎全是the、of、in这类功能词。
这有力地证明了VIST的策略可以在不损失核心语义的前提下,大幅过滤噪声。
VIST为大模型处理长上下文提供了一个全新的、优雅的解决方案。
它揭示了文本中普遍存在的冗余性,并证明了模仿人类阅读策略是解决这一问题的有效途径。
参考资料:
https://arxiv.org/abs/2502.00791
https://arxiv.org/abs/2402.16617
END