FIBO:首个开源JSON原生AI图像模型,精准控制与无限创意
人工智能领域,文本生成图像技术正快速发展,但大多数模型在可控性、可预测性和特征解耦方面存在不足。FIBO的出现改变了这一现状,它作为首个开源的原生支持JSON的文本生成图像模型,为专业工作流提供了强大的支持。
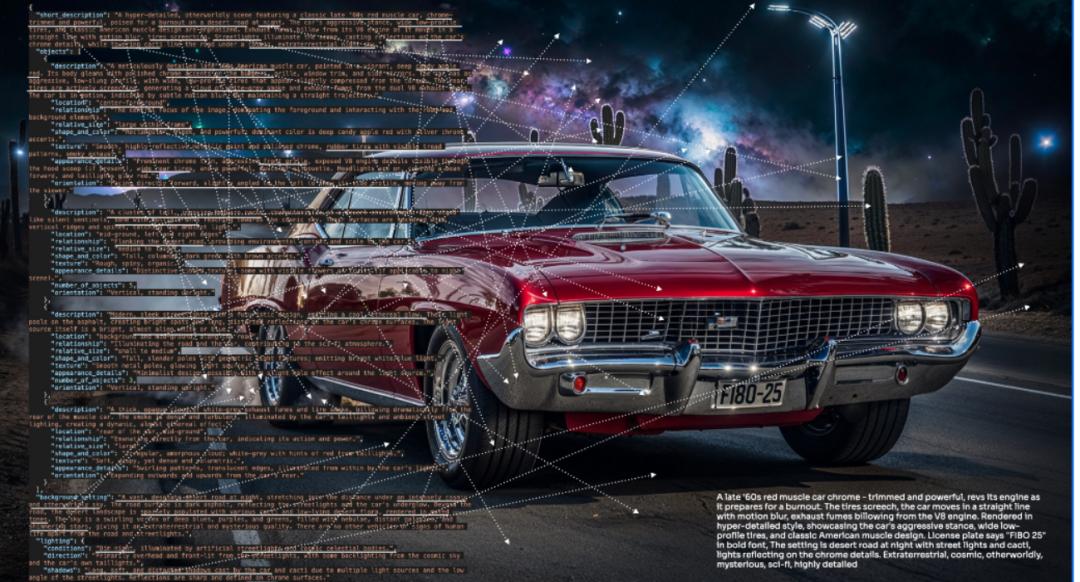
FIBO是一个开源的文本生成图像模型,专为长结构化描述训练而成。它在超过1亿条结构化JSON描述上训练,每条约1000字,能够精确、可重复地控制光线、构图、色彩与相机参数。FIBO支持生成、精修和灵感三种模式,具备特征解耦能力,可单独调整某个属性而不破坏整体场景。其使用100%授权数据,确保合规性和法律透明性,适合专业工作流。
(一)文本到图像生成
FIBO能够根据用户输入的文本描述快速生成高质量的图像。无论是简单的创意构思还是复杂的场景设计,FIBO都能精准地将文本中的细节转化为视觉图像,为用户提供直观的创作结果。
(二)结构化JSON提示
FIBO支持将简短的文本提示扩展为详细的结构化JSON描述。这种结构化描述包含光线、构图、色彩等细节,为图像生成提供更丰富的信息,确保生成结果更符合用户期望。
(三)迭代可控生成
FIBO支持从简短提示生成图像,也可基于已有JSON提示进行多轮细化。用户可以通过逐步调整描述,逐步完善图像效果,实现精准的迭代控制。
(四)特征解耦控制
FIBO具备特征解耦能力,用户可以单独调整某个属性(如相机角度),而不会破坏整体场景的协调性。这种能力使得图像生成更加灵活,满足专业用户的需求。
(五)灵感模式
FIBO可以通过输入图像提取结构化提示,生成相关图像,激发用户的创意。这种模式适用于从已有的图像中获取灵感,生成新的创意图像。
(六)企业级合规性
FIBO完全使用授权数据进行训练,确保了法律透明性和可重复性。这种合规性使得FIBO适用于企业级应用,避免了数据使用中的法律风险。
(七)生产级集成
FIBO支持API接口、ComfyUI节点及本地推理,方便在不同环境中使用。这种灵活性使得FIBO能够无缝集成到现有的生产环境中,提升工作效率。
(一)架构与训练方式
FIBO基于8B参数的DiT架构,采用流匹配训练方式,这种架构和训练方式使其在保持较小模型规模的同时,能够生成高质量的图像。
(二)文本编码器
使用SmolLM3-3B作为文本编码器,并搭配创新的DimFusion条件架构,能够高效地处理长描述文本,为图像生成提供更准确的语义信息。
(三)VAE
采用Wan 2.2作为VAE,负责图像的编码和解码,确保生成图像的细节和质量。
(四)VLM引导
通过视觉语言模型(VLM)将简短文本提示扩展为详细的结构化JSON提示,帮助用户更精准地表达生成需求。
(五)结构化监督
使用结构化JSON描述进行训练,促进特征解耦,避免提示词漂移,使生成结果更符合用户期望。
(六)数据合规性
在超过1亿条授权的长结构化JSON描述上训练,确保数据的合法性和合规性。
(一)专业设计与创意工作流
在广告、产品设计和平面设计领域,FIBO能够根据设计师的文本描述快速生成高质量的图像原型。设计师可以通过迭代调整描述,逐步完善图像细节,从而大幅缩短创意构思和设计迭代的时间,提升工作效率。
(二)影视与娱乐
FIBO为影视、游戏和动画制作提供了强大的概念艺术生成能力。创作者可以输入简短的场景描述,生成详细的视觉化图像,帮助快速将创意转化为可视化的概念设计,加速项目开发流程,节省时间和成本。
(三)教育与培训
在教育领域,FIBO可以生成教学图像和虚拟实验场景。教师可以根据教学内容输入描述,生成直观的图像或场景,帮助学生更好地理解和掌握知识,提升教学效果和学习体验。
(四)科学研究
FIBO能够将科学数据转化为直观的图像,帮助研究人员更好地展示研究成果和进行数据可视化。例如,输入科学实验的描述,生成对应的图像,便于在学术报告和论文中展示。
(五)医疗与健康
在医疗领域,FIBO可以生成医学示意图和虚拟手术场景。医学生可以通过输入手术步骤描述,生成相应的图像,辅助学习和培训。此外,FIBO还可以用于医学科普,帮助患者更好地理解病情和治疗方案。
(一)安装依赖
安装Diffusers及相关依赖。
pip install git+https://github.com/huggingface/diffusers torch torchvision google-genai boltons ujson sentencepiece accelerate transformers(二)生成模式
使用VLM将简短提示扩展为详细结构化提示,然后生成图像。
import jsonimport osimport torchfrom diffusers import BriaFiboPipelinefrom diffusers.modular_pipelines import ModularPipeline# Load the VLM pipelinetorch.set_grad_enabled(False)assert os.getenv("GOOGLE_API_KEY") is not None, "GOOGLE_API_KEY environment variable is not set"vlm_pipe = ModularPipeline.from_pretrained("briaai/FIBO-gemini-prompt-to-JSON", trust_remote_code=True)# Load the FIBO pipelinepipe = BriaFiboPipeline.from_pretrained("briaai/FIBO",torch_dtype=torch.bfloat16,)pipe.to("cuda")# Create a prompt to generate an initial imageoutput = vlm_pipe(prompt="A hyper-detailed, ultra-fluffy owl sitting in the trees at night, looking directly at the camera with wide, adorable, expressive eyes. Its feathers are soft and voluminous, catching the cool moonlight with subtle silver highlights. The owl's gaze is curious and full of charm, giving it a whimsical, storybook-like personality.")json_prompt_generate = output.values["json_prompt"]def get_default_negative_prompt(existing_json: dict) -> str:negative_prompt = ""style_medium = existing_json.get("style_medium", "").lower()if style_medium in ["photograph", "photography", "photo"]:negative_prompt = """{'style_medium':'digital illustration','artistic_style':'non-realistic'}"""return negative_promptnegative_prompt = get_default_negative_prompt(json.loads(json_prompt_generate))# Generate the image from the structured json promptresults_generate = pipe(prompt=json_prompt_generate, num_inference_steps=50, guidance_scale=5, negative_prompt=negative_prompt)results_generate.images[0].save("image_generate.png")with open("image_generate_json_prompt.json", "w") as f:f.write(json_prompt_generate)
(三)精修模式
基于已有的结构化提示和新的指令,FIBO可以对图像进行精修。
output = vlm_pipe(json_prompt=json_prompt_generate, prompt="make the owl brown")json_prompt_refine_from_image = output.values["json_prompt"]negative_prompt = get_default_negative_prompt(json.loads(json_prompt_refine_from_image))results_refine_from_image = pipe(prompt=json_prompt_refine_from_image, num_inference_steps=50, guidance_scale=5, negative_prompt=negative_prompt)results_refine_from_image.images[0].save("image_refine_from_image.png")with open("image_refine_from_image_json_prompt.json", "w") as f:f.write(json_prompt_refine_from_image)
(四)灵感模式
从输入图像提取结构化提示,生成相关图像,激发创意。
from PIL import Imageoriginal_astronaut_image = Image.open("<path to original astronaut image>")output = vlm_pipe(image=original_astronaut_image, prompt="")json_prompt_inspire = output.values["json_prompt"]negative_prompt = get_default_negative_prompt(json.loads(json_prompt_inspire))results_inspire = pipe(prompt=json_prompt_inspire, num_inference_steps=50, guidance_scale=5, negative_prompt=negative_prompt)results_inspire.images[0].save("image_inspire_no_prompt.png")with open("image_inspire_json_prompt_no_prompt.json", "w") as f:f.write(json_prompt_inspire)
FIBO作为首个开源的原生支持JSON的文本生成图像模型,凭借其强大的核心功能、先进的技术架构和广泛的应用场景,为文本生成图像领域带来了新的突破。它不仅满足了专业用户对图像生成的高要求,还通过企业级的合规性和生产级的集成能力,为企业的数字化创作提供了可靠的支持。希望本文能够帮助大家深入了解FIBO的技术细节和使用方法,激发更多的创意和应用。
GitHub仓库:https://github.com/Bria-AI/FIBO
HuggingFace模型库:https://huggingface.co/briaai/FIBO
在线体验Demo:https://huggingface.co/spaces/briaai/FIBO
点亮“关注”,设为“星标”,精彩不迷路!与你携手探索AI的无限可能,精彩内容持续更新!🚀