DeepSeek-OCR:开启OCR 2.0时代,智能文档处理新标杆
在数字化转型的浪潮中,文档处理一直是企业和研究者面临的重要挑战之一。传统OCR技术虽然能够识别文本,但在处理复杂文档、多语言内容以及大规模数据时存在诸多局限。最近DeepSeek团队开源了DeepSeek-OCR模型,这一创新的视觉语言模型通过“上下文光学压缩”技术,为文档处理带来了全新的解决方案。
DeepSeek-OCR是由DeepSeek团队开发的一款革命性的OCR模型,参数规模约30亿(3B),采用“上下文光学压缩”技术,将文本信息以视觉形式压缩,使模型通过“看图”来重建文本。该模型不仅继承了传统OCR的文本识别能力,更在文档理解层面进行了全方位升级,能够同时“看懂文字”“理解布局”“分析图表”,真正实现了从“看见文字”到“理解内容”的跨越。
(一)OCR纯文字提取
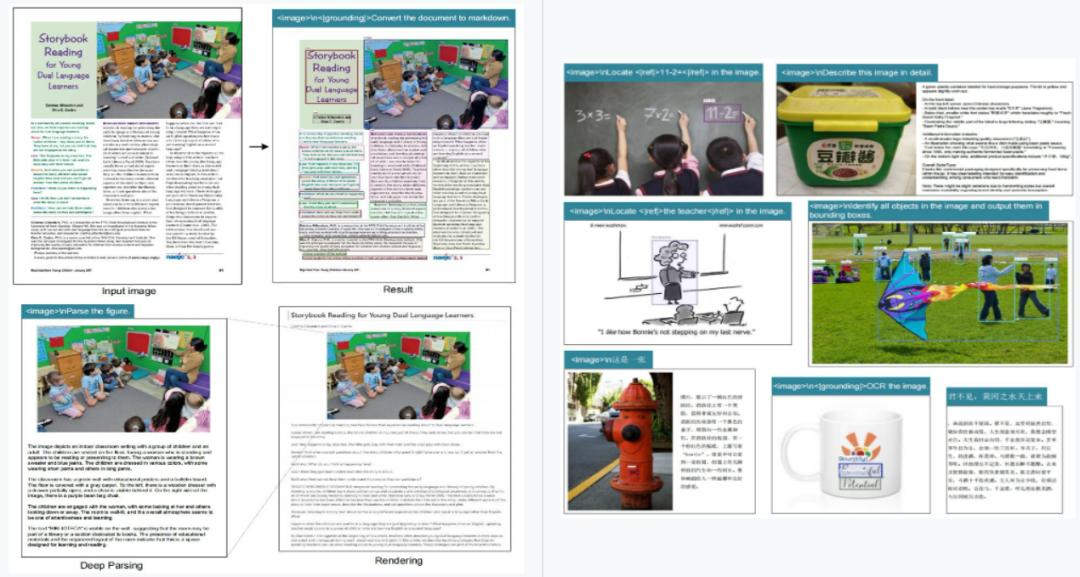
DeepSeek-OCR支持对任意图像进行自由式文字识别,能够快速提取图片中的全部文本信息,不依赖版面结构。这一功能适用于需要快速获取图像中文字内容的场景,如从广告图片、海报等提取文字,方便用户进行进一步处理或分析。
(二)保留版面格式的OCR提取
DeepSeek-OCR能够自动识别并重建文档中的排版结构,包括段落、标题、页眉页脚等,实现“结构化文字输出”。这一功能特别适合处理格式化的文档,如合同、报告等,确保提取后的文本保留原始文档的结构,便于后续编辑和处理。
(三)图表& 表格解析
DeepSeek-OCR可以解析图像中的结构化信息,如表格、流程图等,并支持生成可机读的表格或文本描述。这一功能在处理包含图表和表格的文档时非常实用,如学术论文、研究报告等,能够将复杂的图表信息转换为可操作的数据格式。
(四)图片信息描述
DeepSeek-OCR能够对整张图片进行语义级分析与详细描述,生成自然语言总结。这一功能适用于需要对图像内容进行整体理解的场景,如图像标注、内容审核等,帮助用户快速了解图像的核心信息。
(五)指定元素位置锁定
DeepSeek-OCR通过“视觉定位”功能,在图像中准确定位特定目标元素。这一功能在需要查找特定内容的场景中非常有用,如在长文档中快速定位关键词或特定图表,提高工作效率。
(六)Markdown文档转化
DeepSeek-OCR可以直接将完整的文档图像转换为结构化Markdown文本。这一功能特别适合需要将文档内容快速转换为Markdown格式的用户,如技术文档编写者、博客作者等,方便后续的编辑和发布。
(七)目标检测(Object Detection)
DeepSeek-OCR能够识别并定位图片中的多个物体,为每个目标生成带标签的边界框。这一功能在图像分析和内容理解方面具有广泛的应用,如安防监控、自动驾驶等领域,帮助用户快速识别和定位图像中的关键物体。
(一)DeepEncoder编码器
DeepEncoder是DeepSeek-OCR的关键组件,采用双塔结构,包括SAM-base和CLIP-large。SAM-base用于感知局部特征,处理高分辨率输入时内存占用低;CLIP-large用于提取全局语义信息,输入经过压缩后内存占用得到有效控制。此外,通过16×卷积压缩模块,将视觉令牌数量从4096减少到256,显著降低了内存占用。
(二)多分辨率支持
DeepEncoder支持多种分辨率模式,包括Tiny(512×512)、Small(640×640)、Base(1024×1024)、Large(1280×1280)和Gundam(动态分辨率)。每种模式对应不同的输入分辨率和视觉令牌数量,用户可以根据具体需求选择合适的模式。
(三)解码器:DeepSeek3B-MoE-A570M
解码器基于DeepSeek-3B-MoE架构,具有570M激活参数,负责将压缩后的视觉令牌解码为文本。通过非线性映射将视觉令牌转换为文本表示,确保视觉令牌能够准确转换为文本。
(四)技术创新点
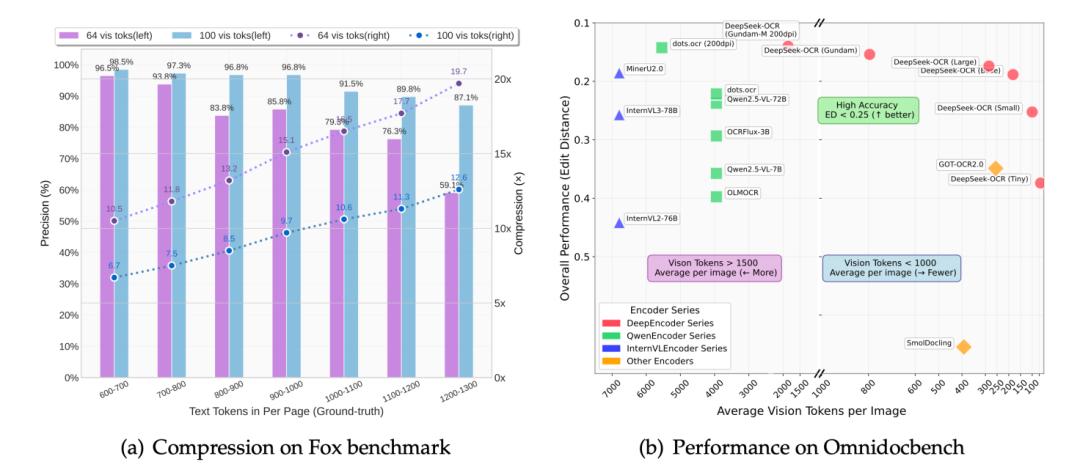
DeepSeek-OCR的创新之处在于其上下文光学压缩技术,通过视觉模态对长文本进行高效压缩,实现7-20倍的压缩比。这一技术显著降低了内存占用,提高了模型的推理速度。此外,DeepSeek-OCR支持近100种语言的文档识别,能够解析图表、化学公式等复杂内容,为大规模文档处理提供了高效解决方案。
(一)大规模训练数据生成
DeepSeek-OCR能够快速、准确地处理海量文档,每天可自动处理数十万页文档,为大型语言模型和视觉语言模型生成高质量的训练数据。这一功能极大地提高了数据准备的效率,降低了数据标注的成本,加速了模型训练的进程。
(二)企业级文档数字化
在企业环境中,DeepSeek-OCR可以将纸质合同、报告等各类文档快速转换为可搜索、可编辑的数字化格式。这不仅提高了文档管理的效率,还增强了企业内部信息的流通和共享,为企业的数字化转型提供了有力支持。
(三)学术研究与文献处理
对于学术研究者来说,DeepSeek-OCR能够精准解析学术论文中的复杂内容,如数学公式、化学式和图表,并将其转换为结构化的机器可读格式。这一功能极大地简化了文献处理流程,提高了学术研究的效率和准确性。
(四)多语言国际化文档处理
在全球化业务中,DeepSeek-OCR支持近100种语言的文档识别,能够轻松应对多语言文档处理需求。这使得跨国企业或组织能够高效地处理来自不同国家和地区的文档,促进了全球业务的顺利开展。
(五)金融与商业智能分析
在金融领域,DeepSeek-OCR能够深度解析研究报告中的图表,将其转换为结构化数据,为财务分析和投资决策提供自动化支持。这一功能不仅提高了数据处理的效率,还减少了人工操作的错误,增强了决策的科学性和准确性。
(一)环境准备
推荐使用CUDA 11.8和torch 2.6.0。以下是具体的环境搭建步骤:
# 安装CUDA和torchpip install torch==2.6.0 torchvision==0.21.0 torchaudio==2.6.0 --index-url https://download.pytorch.org/whl/cu118# 创建并激活conda环境conda create -n deepseek-ocr python=3.12.9 -yconda activate deepseek-ocr
(二)安装依赖
安装DeepSeek-OCR所需的依赖包:
# 安装vllm和transformerspip install vllm-0.8.5+cu118-cp38-abi3-manylinux1_x86_64.whlpip install -r requirements.txtpip install flash-attn==2.7.3 --no-build-isolation
(三)模型部署
1、使用vLLM进行推理
vLLM提供了高效的推理加速,适用于处理PDF等复杂文档。以下是使用vLLM的示例代码:
from vllm import LLM, SamplingParamsfrom vllm.model_executor.models.deepseek_ocr import NGramPerReqLogitsProcessorfrom PIL import Image# 创建模型实例llm = LLM(model="deepseek-ai/DeepSeek-OCR",enable_prefix_caching=False,mm_processor_cache_gb=0,logits_processors=[NGramPerReqLogitsProcessor])# 准备输入图像image_1 = Image.open("path/to/your/image_1.png").convert("RGB")image_2 = Image.open("path/to/your/image_2.png").convert("RGB")prompt = "<image>\nFree OCR."model_input = [{"prompt": prompt,"multi_modal_data": {"image": image_1}},{"prompt": prompt,"multi_modal_data": {"image": image_2}}]sampling_param = SamplingParams(temperature=0.0,max_tokens=8192,extra_args=dict(ngram_size=30,window_size=90,whitelist_token_ids={128821, 128822}, # whitelist: <td>, </td>),skip_special_tokens=False,)# 生成输出model_outputs = llm.generate(model_input, sampling_param)# 打印输出for output in model_outputs:print(output.outputs[0].text)
2、使用Hugging Face Transformers进行推理
Hugging Face Transformers提供了灵活的推理接口,适用于快速原型开发和小规模部署。以下是使用Hugging Face Transformers的示例代码:
from transformers import AutoModel, AutoTokenizerimport torchimport os# 设置环境变量os.environ["CUDA_VISIBLE_DEVICES"] = '0'model_name = 'deepseek-ai/DeepSeek-OCR'# 加载模型和分词器tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)model = AutoModel.from_pretrained(model_name, _attn_implementation='flash_attention_2', trust_remote_code=True, use_safetensors=True)model = model.eval().cuda().to(torch.bfloat16)# 准备输入prompt = "<image>\n<|grounding|>Convert the document to markdown. "image_file = 'your_image.jpg'output_path = 'your/output/dir'# 进行推理res = model.infer(tokenizer, prompt=prompt, image_file=image_file, output_path=output_path, base_size=1024, image_size=640, crop_mode=True, save_results=True, test_compress=True)# 打印结果print(res)
3、运行示例
在项目仓库中,提供了多个运行示例,方便用户快速上手:
# 克隆项目仓库git clone https://github.com/deepseek-ai/DeepSeek-OCR.gitcd DeepSeek-OCR-master# 运行vLLM推理示例cd DeepSeek-OCR-vllmpython run_dpsk_ocr_image.py # 图像推理python run_dpsk_ocr_pdf.py # PDF推理# 运行Hugging Face Transformers推理示例cd ../DeepSeek-OCR-hfpython run_dpsk_ocr.py
通过以上步骤,你可以快速部署和使用DeepSeek-OCR,无论是处理图像还是PDF文档,都能轻松实现高效的OCR功能。
DeepSeek-OCR作为OCR 2.0时代的典型代表模型,通过其创新的“上下文光学压缩”技术,为文档处理带来了全新的视角和解决方案。无论是在大规模数据处理、多语言支持还是复杂文档解析方面,DeepSeek-OCR都展现出了强大的性能和广泛的应用前景。随着技术的不断发展和优化,DeepSeek-OCR有望在更多领域发挥重要作用,推动文档处理技术的进一步发展。
GitHub仓库:https://github.com/deepseek-ai/DeepSeek-OCR
Hugging Face模型库:https://huggingface.co/deepseek-ai/DeepSeek-OCR
技术论文:https://github.com/deepseek-ai/DeepSeek-OCR/blob/main/DeepSeek_OCR_paper.pdf
点亮“关注”,设为“星标”,精彩不迷路!与你携手探索AI的无限可能,精彩内容持续更新!🚀