1B超过80B模型!中科院、北大、字节等联合发布多模态精准上下文理解技术
现在的多模态模型,包括顶尖模型,对局部理解较好,但容易忽略全局关联性。
这种缺乏全局上下文的管中窥豹,限制了它们在真实世界中的应用。
为了解决这个问题,中科院,北大,字节,武汉大学等提出了一个名为Grasp Any Region(GAR)的新模型框架。一个简单而巧妙的技术,就让AI学会了在观察细节时,同时保留对全局环境的感知。
这让GAR不仅能准确理解单个区域,还能理解多个区域之间的复杂关系,甚至在一些关键测试上,小尺寸的GAR模型表现超过了参数量是它几十倍的庞然大物。
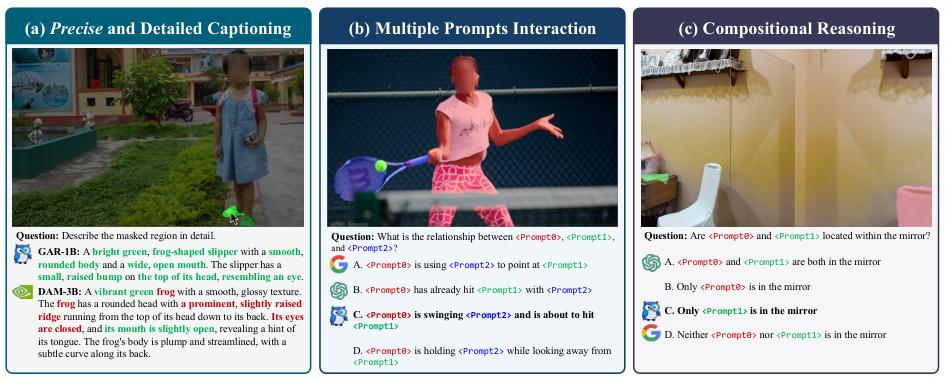
GAR能同时看到细节和全局
传统区域级模型处理图像的方式,很像用剪刀把感兴趣的区域剪下来单独分析。这种做法虽然能聚焦细节,但也粗暴地切断了这块区域与周围环境的一切联系。
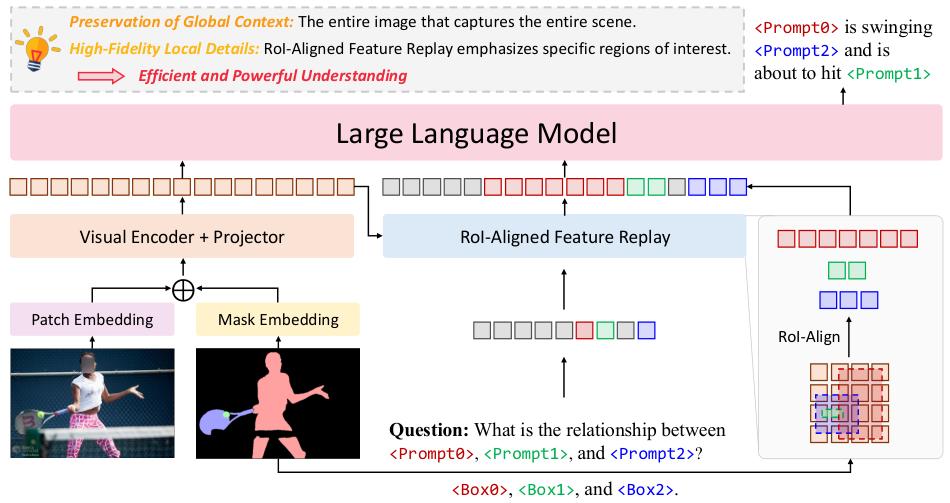
GAR的核心创新,在于一种名为RoI对齐特征重放(RoI Align Feature Replay)的技术。
原理十分优雅。
GAR不像其他模型那样先裁剪再分析。它反其道而行之,首先完整地看一遍整张未被裁剪的图像,并生成一张包含所有背景信息的全局特征图。这张图就像一幅信息丰富的地图,记录了图像中每个角落的上下文信息。
然后,当用户通过掩码(mask)指定一个感兴趣的区域时,GAR会根据这个掩码的位置,从那张早已准备好的全局特征图中,精确地提取出对应区域的特征向量。
由于这些特征向量本身就是从全局视角下计算出来的,它们天然就携带了周围环境的上下文信息。
这个过程,好比一位侦探勘察现场。他不会只盯着证物本身,而是会先环顾整个案发现场,了解证物与其他物品的位置关系,然后再俯身细看证物的细节。
这种先全局,后局部的策略,让GAR巧妙地避免了上下文丢失的问题。它既能放大查看区域内的精细纹理,又不会丢失对整体画面的感知。
为了将用户的空间指令(比如用掩码圈出的区域)有效传达给模型,GAR还设计了一个轻量级的提示编码机制。
它将用户输入的二进制掩码,通过一个简单的卷积网络转换成掩码嵌入,再叠加到视觉模型ViT(Vision Transformer)的图像块嵌入上。
这个设计让模型在分析图像之初,就知道应该重点关注哪些区域。
GAR学会了推理
一个强大的模型架构,需要高质量的数据来训练。GAR的训练过程,就像一个精心设计的教育流程,分阶段、有层次地提升模型的能力。
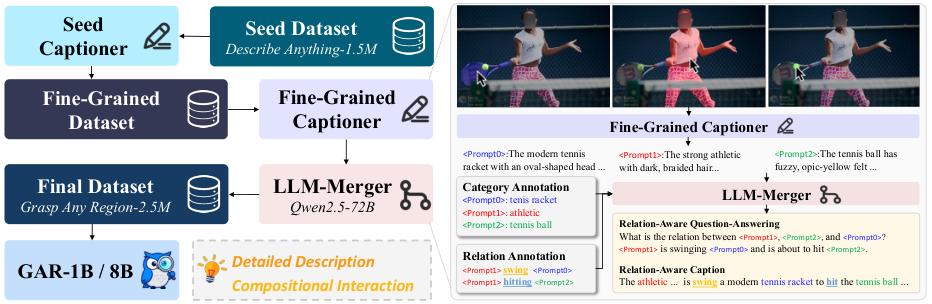
研究团队设计了一个两阶段的数据生成流程,让模型从基础的物体识别,逐步成长为能够进行复杂关系推理的思考者。
第一轮学习的目标,是增强模型的识别力,特别是细粒度的识别能力。
团队最初使用了Describe Anything-1.5M这个数据集,但发现它在描述物体的精细特征方面有所欠缺。
为了弥补这一点,他们引入了以类别极其丰富和细致著称的ImageNet-21K数据集。他们从ImageNet-21K中提取图像和对应的掩码,利用一个种子描述器生成初步描述,再让大语言模型去验证这些描述是否与真实的类别标签一致。
通过这种方式,他们筛选并精炼出了一个包含45.6万个样本的高质量细粒度数据集。用这些数据训练出的模型,就像一个学过生物分类学的学生,能准确分辨出不同种类动植物的细微差别。
第二轮学习的目标,是教会模型理解关系。
拥有了强大的识别能力后,模型需要学会理解物体与物体之间的互动和联系。为此,研究团队引入了Panoptic Scene Graph(PSG)数据集,这是一个包含了丰富场景关系信息的数据集。
他们首先用第一阶段训练出的细粒度描述器,为PSG数据集中每个区域生成详细的描述。然后,他们将强大的Qwen2.5-72B模型作为一个信息整合器(LLM-Merger),把这些区域描述和PSG数据集中原始的关系标注结合起来,生成了三种类型的训练数据:
明确包含关系上下文的丰富对象描述,共14.4万条。例如,不再是孤立地描述一个人和一辆自行车,而是生成一个人正在骑着一辆自行车。
用于探测复杂关系理解的问答对,共14.4万对。
多项选择题,共12.6万道。
通过这个阶段总计41.4万样本的关系课程,GAR学会了从静态的物体识别,跃升到动态的场景理解,能够构建出类似场景图的心理模型,去理解真实世界中复杂的物体组合与互动。
GAR-Bench为区域理解设定了新标准
如何科学地评估一个模型是否真正理解了图像区域?传统的基准测试往往只关注模型对单个孤立区域的描述能力,这远远不够。
为了更全面、更深入地衡量模型的区域理解水平,研究团队专门构建了一个全新的综合评估基准套件:GAR-Bench。
GAR-Bench不再满足于让模型看图说话,而是设计了一系列任务,去考察它在多区域交互和复杂推理方面的真实能力。它主要包含两个部分:多提示描述任务(GAR-Bench-Cap)和多方面视觉问答任务(GAR-Bench-VQA)。
GAR-Bench-Cap的核心是组合场景理解。
在这个任务中,模型会同时收到一张图和两个以上的视觉提示(比如两个被圈出的区域)。它需要完成两类子任务:
一是简单描述关系。直接提问:<区域1>和<区域2>之间是什么关系?模型需要给出简洁明了的答案。
二是生成包含关系的详细描述。例如,如果<区域1>是人,<区域2>是自行车,一个好的回答不是这是一个男人和一辆自行车,而是这个男人正在骑着这辆自行车。
这要求模型具备空间推理、动作识别和跨区域语义整合的能力,证明它能将场景看作一个连贯的整体,而不是一堆孤立物体的集合。
GAR-Bench-VQA则将评估形式从静态描述转向了动态的交互式问答。
这部分直接衡量模型的理解力,而非描述的流畅度。它被划分为感知和推理两个维度。
感知任务,评估模型识别单个对象基本视觉属性的能力,是其视觉能力的基石。问题会聚焦于颜色、形状、材料和纹理/图案等具体细节。
推理任务,则挑战模型更高阶的认知能力。它要求模型综合利用局部提示、全局上下文以及多个提示之间的关系信息,来得出合乎逻辑的结论。这部分包含了几个极具挑战性的子任务:
位置:给出一个复杂网格结构中的某个物体,要求模型准确说出它的位置(例如,第三行第二列)。这需要模型在识别物体的同时,理解整个场景的宏观结构。
非实体识别:这个任务非常巧妙,专门用来测试模型是否真正利用了全局上下文。提示区域可能是一个镜子里的反射、一个人的影子,或者电视屏幕里的图像。模型需要判断这个区域是否对应一个物理实体。如果模型能正确回答,说明它不是在进行简单的像素模式匹配,而是在进行复杂的上下文感知推理。
关系:这是对多提示组合推理能力的终极考验。模型会收到多个视觉提示,其中可能还包含一些无关的干扰项。它必须准确推断出核心提示之间的复杂空间或逻辑关系,忽略分散注意力的信息。这要求模型在头脑中构建一个场景图,这对于理解杂乱的真实世界至关重要。
GAR在各项测试中表现优异
通过GAR-Bench和其他多个行业标准基准的严格测试,GAR模型的性能得到了充分验证。研究团队评估了GAR-1B(10亿参数)和GAR-8B(80亿参数)两个版本,并与多个通用MLLMs和专门的区域级MLLMs进行了比较。
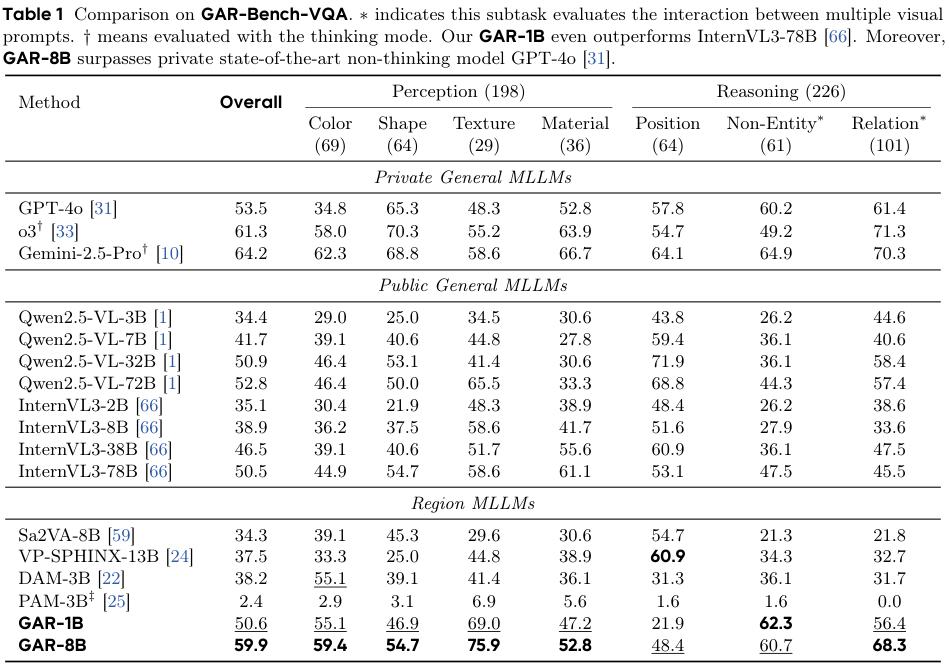
在最能体现其核心能力的GAR-Bench-VQA测试中,GAR-8B取得了54.5的综合得分,这个成绩甚至超过了强大的闭源模型GPT-4o(非思考模式)。
更令人印象深刻的是,参数量小得多的GAR-1B,也取得了50.6分,超过了像InternVL3-78B这样参数规模是其近80倍的开源模型。这充分证明了GAR架构的高效与先进性。特别是在细粒度的纹理感知任务上,GAR-1B和GAR-8B的表现尤为突出。
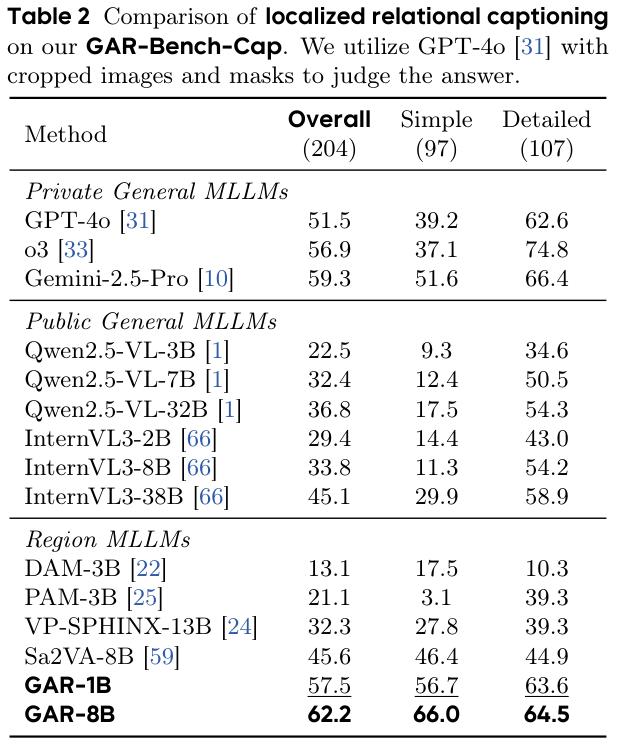
在考验关系理解的GAR-Bench-Cap测试中,GAR-1B和GAR-8B再次取得全场最高分,甚至优于Gemini-2.5-Pro这样的顶级闭源模型。
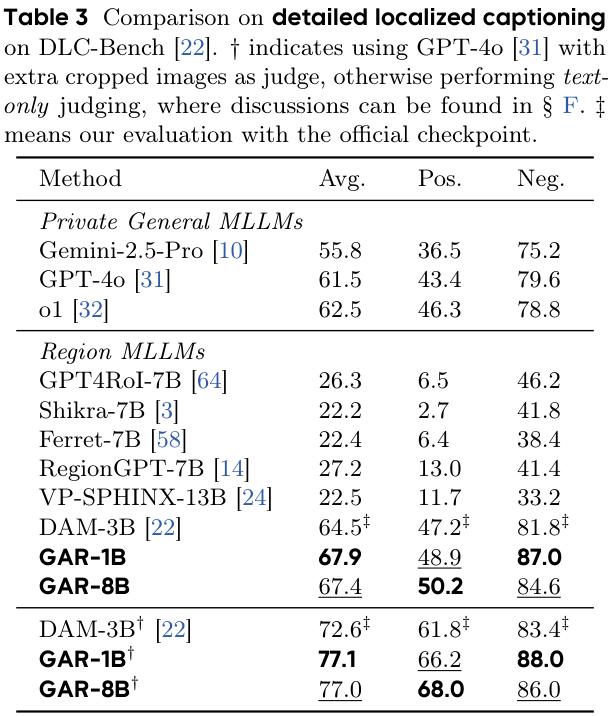
在DLC-Bench的详细本地化描述任务上,GAR的表现同样出色,超过了之前的最优模型DAM-3B。
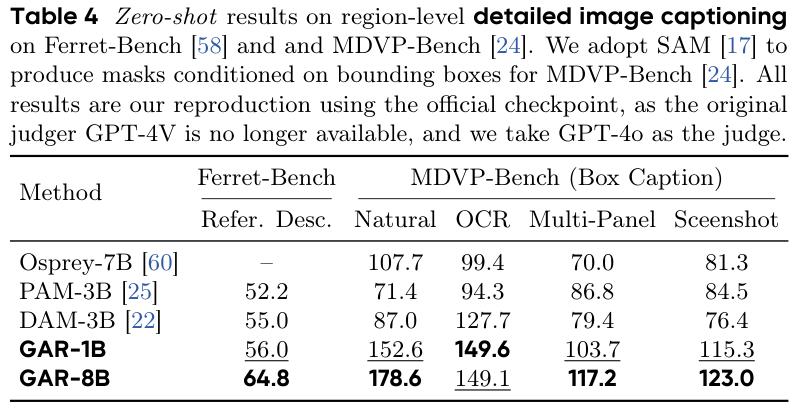
在零样本(zero-shot)测试中,即模型在没有经过特定训练的情况下直接应对新任务,GAR的优势更加明显。
在Ferret-Bench和MDVP-Bench上,GAR成为每个类别的最佳模型,尤其在MDVP-Bench的自然图像描述上,GAR-8B取得了178.6的惊人分数,远超所有对手。
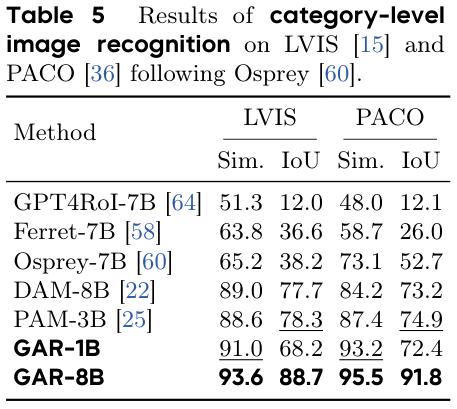
在更具挑战性的开放类别级别图像识别任务上,GAR-8B也刷新了纪录,在LVIS和PACO数据集的各项指标上全面超越了以往所有方法,展现了其在语义理解和精确定位上的强大能力。
GAR的能力还能直接扩展到视频领域。
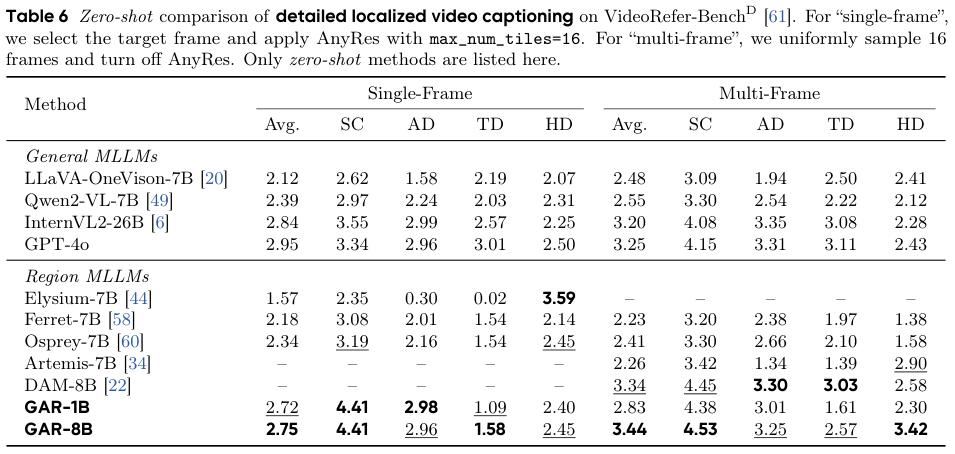
通过简单地将多帧图像输入模型,GAR在视频理解基准测试上的零样本表现同样出色。
在VideoRefer-BenchQ上,未经视频数据训练的GAR-8B,得分甚至超过了专门在该领域数据集上训练过的VideoRefer-7B模型。
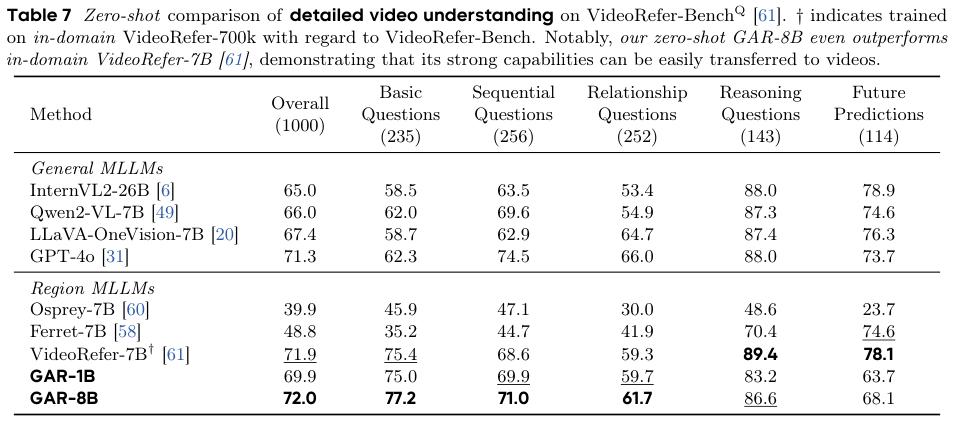
这表明GAR强大的理解能力具有很强的泛化性。当然,由于模型主要基于静态图像训练,它在需要理解时间动态的任务上(如时间描述和未来预测)表现稍弱,这也为未来的改进指明了方向。
下图的定性比较结果直观地展示了GAR的优势。当需要理解全局上下文才能确定被提示物体的类别时,GAR能够生成比其他模型更准确的描述。
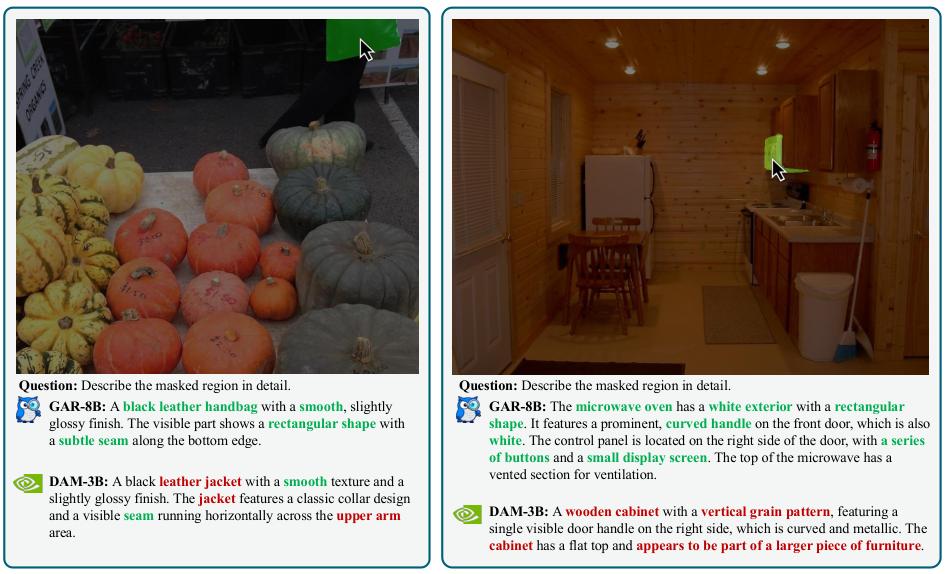
GAR模型通过其独特的架构设计、精心的训练流程和全面的评估体系,为多模态大语言模型的区域级理解能力树立了新的标杆。
它证明了同时保留局部细节和全局上下文是实现精确、鲁棒视觉理解的关键。
这项工作不仅推动了技术的发展,也为未来在机器人视觉、自动驾驶、智能辅助系统等领域的应用开辟了更广阔的空间。
免费试用:
https://huggingface.co/spaces/jbilcke-hf/SNIPED_grasp-any-region
参考资料:
https://arxiv.org/abs/2510.18876
https://github.com/Haochen-Wang409/Grasp-Any-Region
https://huggingface.co/HaochenWang/GAR-1B
END