0.9B参数的黑科技!PaddleOCR-VL如何秒杀传统文档解析?
在数字化时代,文档解析技术的重要性日益凸显。无论是学术研究、商业运营还是日常办公,高效准确地从文档中提取信息都是一项关键需求。然而,传统的文档解析方法往往存在诸多局限,如对复杂版面的处理能力不足、多语言支持有限、计算资源消耗大等。百度飞桨团队推出的PaddleOCR-VL,凭借其创新的架构和卓越的性能,为这一领域带来了全新的解决方案。
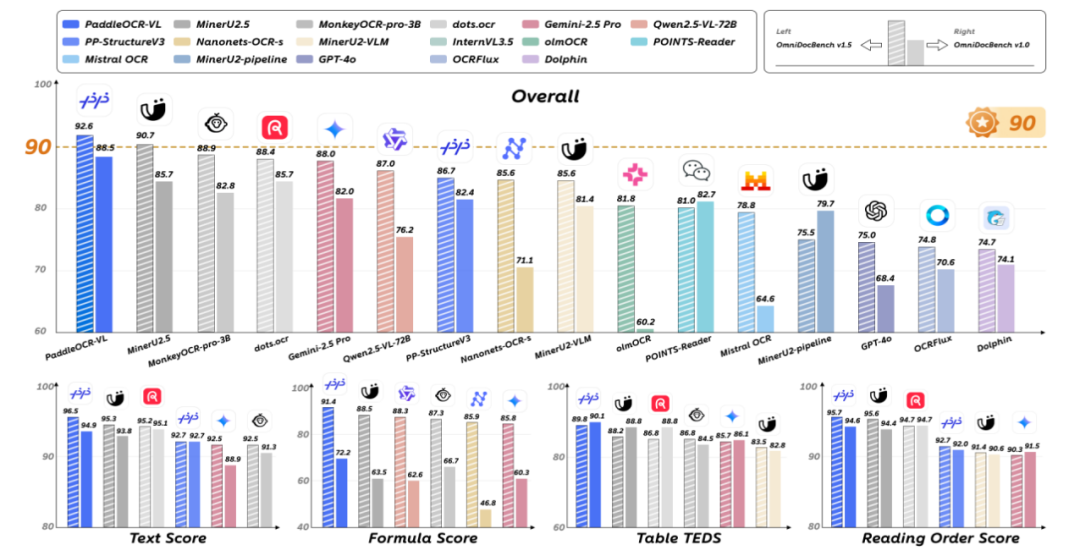
PaddleOCR-VL是一款面向文档解析的SOTA(State-of-the-Art)且资源高效的模型。其核心组件为PaddleOCR-VL-0.9B,这是一种紧凑而强大的视觉语言模型(VLM),由NaViT风格的动态分辨率视觉编码器与ERNIE-4.5-0.3B语言模型组成,以实现精准的元素识别。该模型不仅支持109种语言,还能在识别复杂元素(如文本、表格、公式和图表)方面表现出色,同时保持极低的资源消耗。
(一)智能文档结构解析
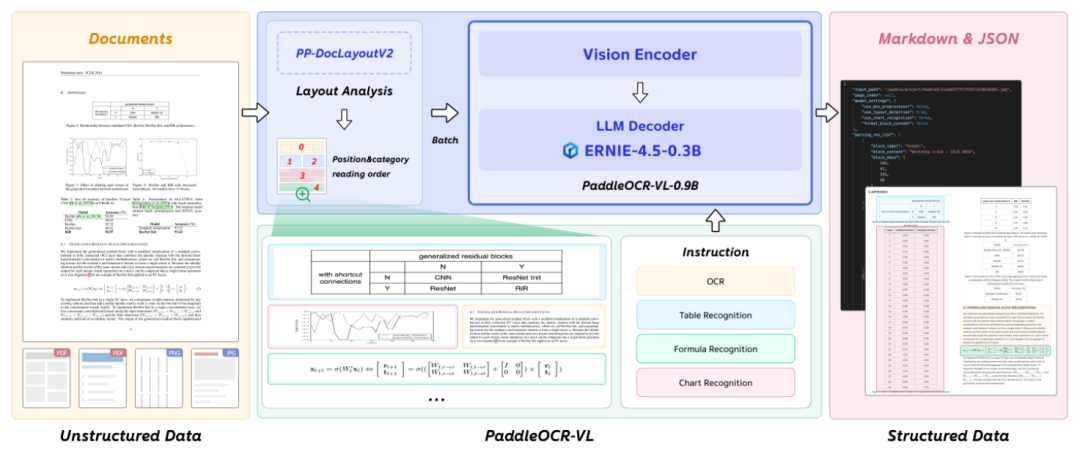
PaddleOCR-VL能够自动识别文档中的文本、表格、公式、图表等元素,并保持正确的阅读顺序。通过双阶段架构,先进行版面分析,再进行内容识别,确保复杂版面的精准处理。这种智能解析能力使其在处理医疗报告、古籍竖排文字等特殊场景时表现出色,能够输出结构化的Markdown或JSON格式数据。
(二)多语种支持
PaddleOCR-VL支持109种语言,包括中文、英文、日文、韩文等主流语言,以及阿拉伯语、俄语等特殊书写体系。这种广泛的语言支持使其能够处理全球范围内的多语言文档,适用于跨国企业、翻译平台及多语种档案管理等场景。无论是手写文本还是历史文献,都能精准识别。
(三)轻量高效部署
PaddleOCR-VL的模型参数量仅为0.9B,专为低算力设备优化。它可以在普通CPU上高效运行,推理速度较同类模型提升14.2%~253.01%。这种轻量化设计使其适合在手机、本地服务器等资源受限的设备上部署,尤其适合对数据隐私要求高的场景,如政府、医疗等领域的本地化部署。
(四)多模态理解
PaddleOCR-VL能够处理图文混合场景,精准识别手写文本、历史文献等复杂内容。它通过多模态融合核心架构,整合视觉编码器、语言模型和跨模态对齐机制,实现从图像到文本的高效转换。这种多模态理解能力使其在处理复杂的图文混合文档时表现出色,能够输出高质量的结构化数据。
(一)两阶段处理架构
PaddleOCR-VL采用两阶段处理架构,第一阶段由PP-DocLayoutV2模型进行版面分析,定位文本、表格、公式等语义区域,并预测人类阅读顺序,误差仅0.043。第二阶段由PaddleOCR-VL-0.9B对这些区域进行细粒度识别,输出结构化文本。这种分阶段处理避免了端到端模型常见的幻觉与错位问题,提升了复杂版面的处理稳定性。
(二)多模态融合核心架构
PaddleOCR-VL的核心模型整合了三大组件:视觉编码器、语言模型和跨模态对齐机制。视觉编码器采用NaViT动态分辨率编码器,能够自适应处理不同尺寸与分辨率的文档图像,保留细节信息。语言模型基于轻量级ERNIE-4.5-0.3B,提供强大的语言理解与生成能力。通过视觉-语言融合模块,将图像特征转换为结构化文本输出。
(三)动态分辨率与轻量化设计
NaViT编码器支持动态分辨率调整,根据文档复杂度自适应分配计算资源,兼顾效率与精度。整体模型仅0.9B参数,可在CPU上高效运行,推理速度较同类模型提升14.2%~253.01%。这种轻量化设计使其适合在资源受限的设备上部署,如手机、本地服务器等,尤其适合对数据隐私要求高的场景。
(四)多任务统一框架
PaddleOCR-VL通过指令驱动机制统一处理文本、表格、公式、图表等元素识别,无需针对不同任务切换模型。这种多任务统一框架显著降低了部署复杂度,提高了模型的通用性和适应性。无论是简单的文本识别还是复杂的公式和图表识别,PaddleOCR-VL都能高效完成任务,输出高质量的结构化数据。
(一)页级文档解析
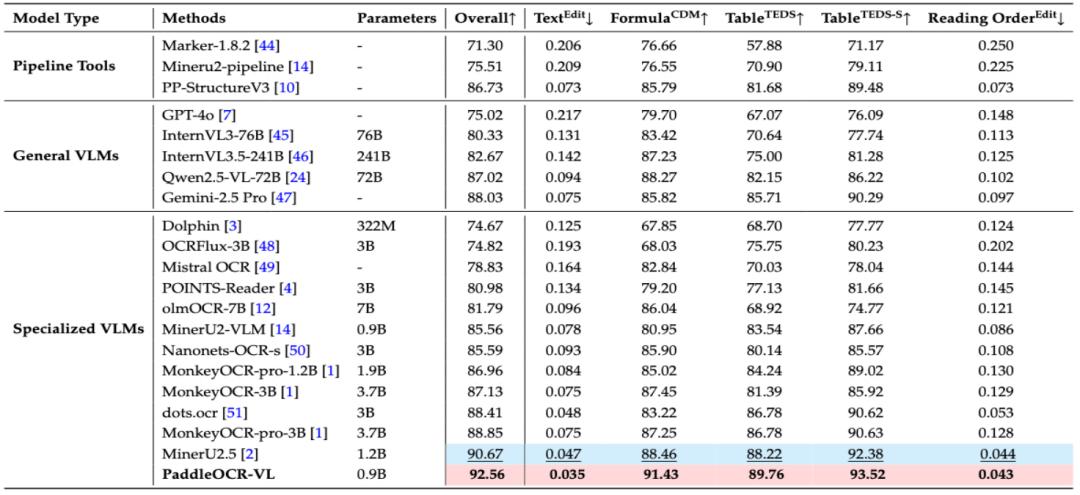
在国际权威评测OmniDocBench V1.5中,PaddleOCR-VL综合性能排名全球第一,超越Gemini-2.5 Pro、GPT-4o等主流模型。在页级文档解析方面,PaddleOCR-VL展现出了卓越的性能,尤其是在处理复杂版面和多语言文档时,其准确率和效率均处于行业领先水平。
(二)元素级识别
PaddleOCR-VL在元素级识别方面也表现出色,支持文本、表格、公式、图表等多种元素的精准识别:
1. 文本识别:支持109种语言,编辑距离最低,准确率高达97%以上。
2. 表格识别:支持全边框、部分边框、无边框等多种表格类型,准确率高。
3. 公式识别:简单印刷公式识别准确率98%以上,手写公式识别准确率88%以上。
4. 图表识别:支持11种图表类型,包括柱状图、折线图等,识别效果优于同类模型。
(三)推理速度
PaddleOCR-VL在单张A100 GPU上,每秒可处理1881个Token,推理速度较MinerU2.5提升14.2%,较dots.ocr提升253.01%。其轻量化设计使其在资源受限的设备上也能高效运行,适合大规模文档处理和实时应用场景。
(四)资源消耗
PaddleOCR-VL的模型参数量仅为0.9B,专为低算力设备优化。它可以在普通CPU上高效运行,显著降低了硬件成本和部署难度。这种轻量化设计使其在边缘设备和移动设备上也能表现出色,适合各种资源受限的场景。
(一)大规模文档数字化
PaddleOCR-VL适用于将纸质档案、历史文献、合同等批量转换为可编辑的电子格式。它支持多语言及复杂版面(如表格、公式)的精准解析,能够高效处理大规模文档数字化项目。无论是图书馆的古籍数字化还是企业的档案管理,PaddleOCR-VL都能提供高效、准确的解决方案。
(二)金融与商业票据处理
PaddleOCR-VL能够自动识别发票、收据、银行单据中的关键信息,如金额、日期、公司名称等,显著提升财务审核与税务管理的效率。其多语言支持和高精度识别能力使其在跨国金融业务中表现出色,适用于各种复杂票据的自动化处理。
(三)学术研究与教育数字化
PaddleOCR-VL可以解析学术论文、教材中的文本、公式、图表,支持知识抽取和结构化整理。它适用于科研信息管理和智能教育工具开发,能够帮助研究人员和教育工作者快速获取和整理学术资料,提高研究和教学效率。
(四)多语言全球化文档处理
PaddleOCR-VL支持109种语言,覆盖全球主要语种,适用于跨国企业、翻译平台及多语种档案管理。无论是阿拉伯语、俄语还是日语等特殊书写体系,PaddleOCR-VL都能精准识别,满足全球化文档处理的需求。
(五)隐私敏感场景的本地化部署
PaddleOCR-VL模型轻量(0.9B参数),可在普通CPU或边缘设备运行,适合政府、医疗等对数据安全要求高的领域。其本地化部署能力确保数据隐私,满足隐私敏感场景的需求,如医疗报告的本地解析和处理。
(六)智能知识库与检索系统
PaddleOCR-VL与RAG技术结合,将扫描文档转换为结构化数据,增强企业知识管理效率和检索精度。它能够将复杂的文档内容转化为可检索的知识库,提升企业内部信息的利用效率,适用于智能知识库和检索系统的开发。
(一)安装依赖
python -m pip install paddlepaddle-gpu==3.2.0 -i https://www.paddlepaddle.org.cn/packages/stable/cu126/python -m pip install -U "paddleocr[doc-parser]"python -m pip install https://paddle-whl.bj.bcebos.com/nightly/cu126/safetensors/safetensors-0.6.2.dev0-cp38-abi3-linux_x86_64.whl
(二)基本用法
1、CLI命令行:
paddleocr doc_parser -i https://paddle-model-ecology.bj.bcebos.com/paddlex/imgs/demo_image/pp_ocr_vl_demo.png2、Python API:
from paddleocr import PaddleOCRVLpipeline = PaddleOCRVL()output = pipeline.predict("https://paddle-model-ecology.bj.bcebos.com/paddlex/imgs/demo_image/pp_ocr_vl_demo.png")for res in output:res.print()res.save_to_json(save_path="output")res.save_to_markdown(save_path="output")
(三)使用vLLM加速VLM
1、启动VLM推理服务器:
docker run \--rm \--gpus all \--network host \ccr-2vdh3abv-pub.cnc.bj.baidubce.com/paddlepaddle/paddlex-genai-vllm-server
2、调用PaddleOCR CLI或Python API:
paddleocr doc_parser \-i https://paddle-model-ecology.bj.bcebos.com/paddlex/imgs/demo_image/pp_ocr_vl_demo.png \--vl_rec_backend vllm-server \--vl_rec_server_url http://127.0.0.1:8080/v1
PaddleOCR-VL以其卓越的性能和广泛的应用场景,为文档解析领域带来了新的突破。它不仅在技术上实现了创新,更在实际应用中展现了强大的实用价值。无论是学术研究、商业运营还是日常办公,PaddleOCR-VL都能提供高效、准确的文档解析解决方案。希望本文能够帮助您更好地了解和使用PaddleOCR-VL,推动文档解析技术的发展。
项目官网:https://ernie.baidu.com/blog/zh/posts/paddleocr-vl/
HuggingFace模型库:https://huggingface.co/PaddlePaddle/PaddleOCR-VL
arXiv技术论文:https://arxiv.org/pdf/2510.14528
点亮“关注”,设为“星标”,精彩不迷路!与你携手探索AI的无限可能,精彩内容持续更新!🚀