引领金融知识图谱新时代:FinReflectKG——AI大模型驱动的Agentic
文章摘要
本篇推文深入解读了FinReflectKG——一种由AI驱动的金融知识图谱新范式。文章聚焦于其创新的“反思型智能体流程”,如何通过多轮反馈实现优质知识抽取,并引入KL散度作为语义多样性监控的前沿方案。分析涵盖方法、评估、实验结果及未来方向,为金融AI专家、研究者和投资人提供实用洞察。
正文
一、背景与挑战
金融领域,尤其是监管文件如SEC申报、上市公司公告等,蕴含着庞大结构化和非结构化数据。大语言模型(LLM)在文本理解上表现强劲,但对复杂金融关系的“符号式推理”却远不及专业应用需求。
- 研究问题:这篇文章要解决的问题是如何从金融文件中构建高质量的金融知识图谱(Knowledge Graph, KG)。金融领域由于其复杂性和监管特性,缺乏大规模的开源数据集来捕捉企业披露中的丰富语义关系。
- 研究难点:该问题的研究难点包括:金融文件的异构性和高度互联性;现有金融知识图谱要么范围有限,要么缺乏严格的评估;大多数现有金融知识图谱依赖于新闻源,而非权威金融文件(如SEC 10-K文件)。
- 相关工作:该问题的研究相关工作有:利用大型语言模型(LLMs)进行零样本和少样本提取;规范化和模式标准化方法;早期的金融知识图谱工作主要集中于从新闻中提取结构化事件表示。
知识图谱三元组结构举例
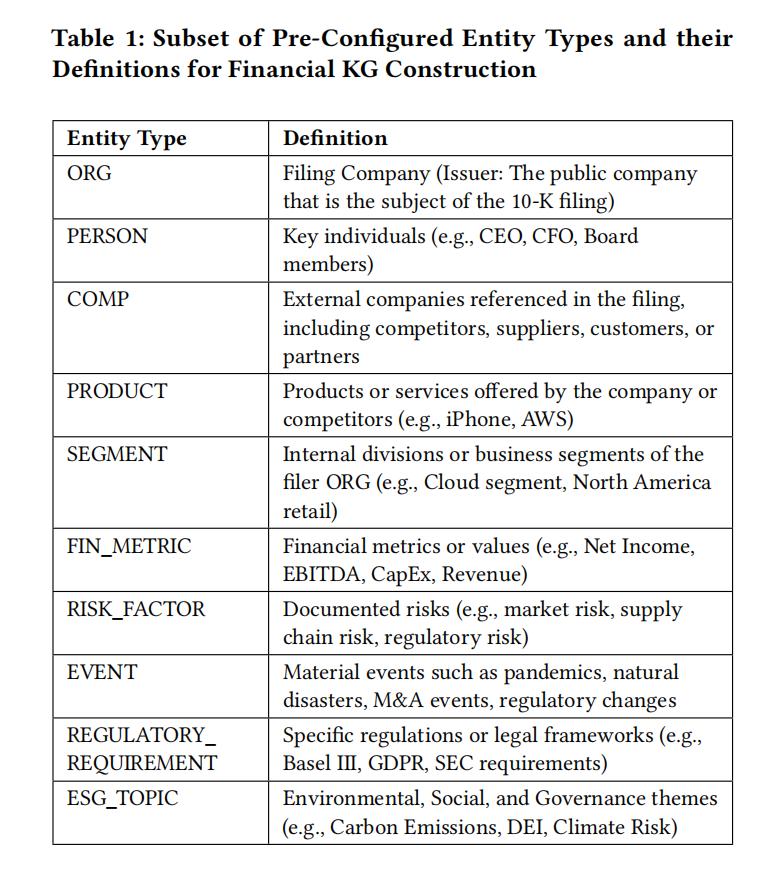
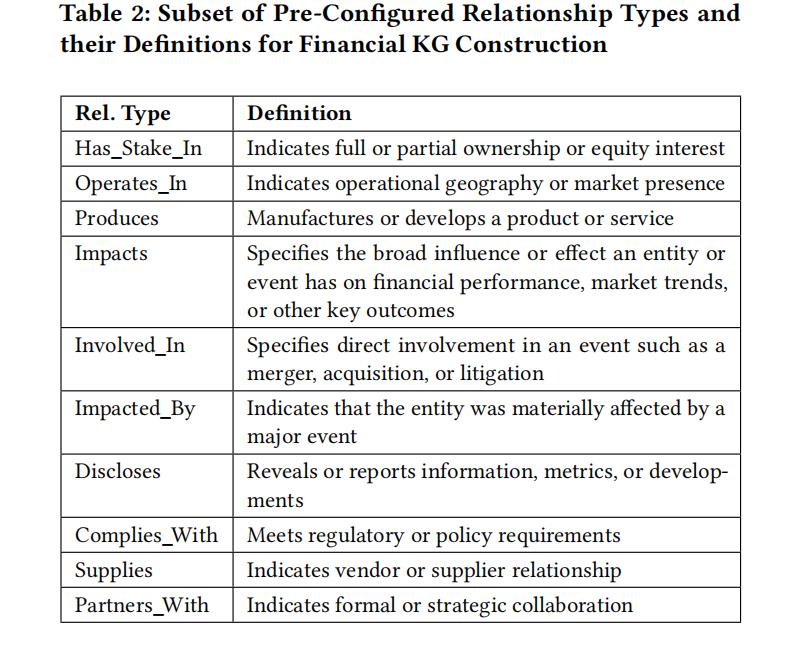
知识图谱(KG)是解决这一问题的核心工具,能够将文本转化为“实体-关系-实体”三元组。然而,金融文档文化多样、术语众多,自动高质量抽取KG面临如下瓶颈:
- 模型易混淆主语,诸如“We”、公司职称等不规范表达;
- 关系标准不一,覆盖有限;
- 缺乏可比“标准答案”来做数据验证,系统性误差难测。
研究方法
- 多次工作流程:在第一次提取候选三元组后,模型重新处理其输出和原始块,并应用专门的规范化提示。
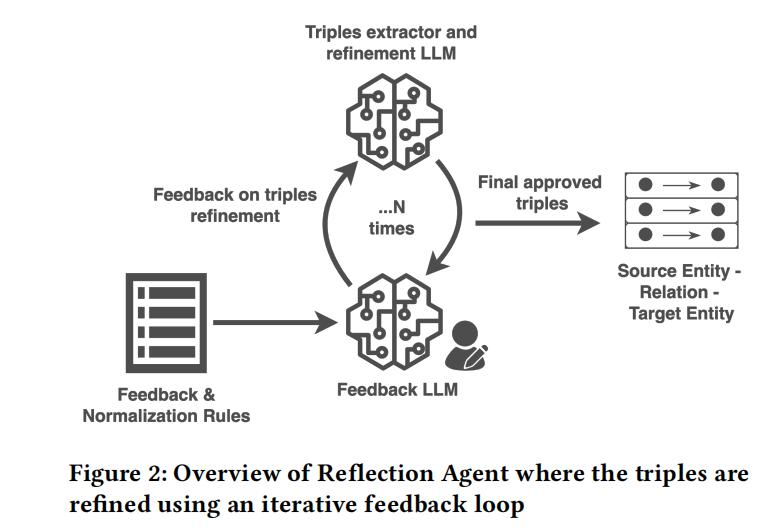
- 反射驱动的代理工作流和元分析:部署一个专门的反思代理,通过模拟反馈(评论家)和纠正LLM之间的多轮交互,迭代改进初始三元组集。
- 数据收集:构建了一个开源的、大规模的金融知识图谱数据集,仅使用2024年所有标普100公司的年度SEC 10-K文件。
- 样本选择:选择了2024年所有标普100公司的SEC 10-K文件作为数据源。
- 参数配置:使用了Qwen2.5-72B-Instruct作为LLMs进行KG构建,提示中明确列举了实体和关系类型,要求规范化实体名称,并以严格的JSON格式输出结果。
- 智能文档解析层:利用基于docling的先进文档解析层,保留SEC 10-K文件中的多种格式,包括叙述文本、表格和图像。表格被保留为markdown上下文,以保持行和列的关联和语义上下文。
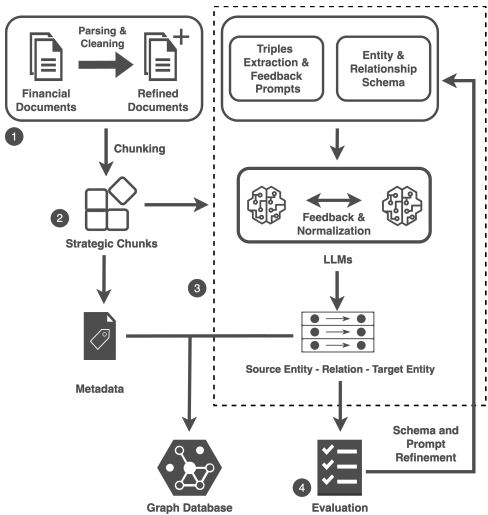
- 表格感知语义分块层:采用自定义的分块算法,保留表格作为单个原子块,确保金融数据的完整性和语义一致性。每个块的最大大小为2048个令牌。
- 迭代提示和代理驱动的三元组提取层:使用预定义的模式,采用迭代经验方法识别最可靠的KG三元组。使用了Qwen2.5-72B-Instruct作为LLMs进行KG构建。
- 鲁棒评估层:结合规则检查、统计验证和LLM作为评委的评估,全面衡量提取质量。
二、FinReflectKG 的核心创新
1. “反思型智能体”三阶段流程
FinReflectKG开创性地设计了一个“反思/迭代智能体”抽取流程,分为三个角色:
- 抽取LLM:从文档片段中提取初始三元组;
- 批判LLM:对抽取结果进行结构化反馈,指出实体模糊、关系不规范等问题;
- 修正LLM:参考批判意见,反复修正三元组,至问题消除或达最大迭代次数。
此循环反馈直到三元组质量无进一步提升,系统性提高了信息准确度、覆盖面和一致性。
2. 多维评估体系创新
传统KG难以精准评估,FinReflectKG提出了多元化自动性能测量框架:
- CheckRules:自定义规则检测,如强制主语标准化、关系合规性等,严格检验抽取精度;
- Coverage Ratios:覆盖比率,衡量KG是否真实反映原文多元关系与实体分布;
- Semantic Diversity:采用信息论(Shannon、Rényi熵)计量知识图谱语义多样性,防止只抽取高频模式,提升整体丰富性;
- LLM-as-a-Judge:由大模型分别评判三种抽取模式在精确性、完备性、相关性等方面的表现。
3. 关键实验结果
在多项评测下,“反思智能体模式”遥遥领先——:
- CheckRules合规通过率最高,达64.8%;
- 单文档三元组数量最多,平均达15.8个;
- 实体和关系覆盖率显著优于单次、复合流程;
- 精确性、完备性和相关性综合评分最佳。
- 主要劣势是速度,迭代多轮使计算负担加重,不适合实时场景。单次抽取适用于时效性强的应用。
三、语义多样性监控的前沿方法:KL散度与最小交叉熵准则
论文指出反思迭代虽然提升了符号和规则一致性,却会降低语义多样性(熵值降低)。但用“绝对熵阈值”监控多样性并不科学,易导致阈值设置随意。
创新建议(KL散度监管):
作者提出,采用“最小交叉熵准则”(MinXEnt,源于Jaynes的最大熵原理的扩展),即监控基线(Single-Pass法)与每轮迭代分布的KL散度,量化反思流程带来信息分布的变化。
步骤:
- 基准分布设定(p)
先用Single-Pass处理全数据,统计实体、关系等的频率分布。
迭代分布(q(t))
每步抽取-反馈-修正后,重新统计频率分布,形成q(t)。统一词表与平滑
把全部p与q(t)中的元素集合取并集,未出现者频率为0,然后用Laplace(加一)平滑,避免KL公式分母为零。KL散度计算与监控
逐步计算KL(q(t)|p),绘图追踪每一步的信息变化。找到KL最小值点,即最佳语义多样性与规则一致性平衡点,可作为智能体最优停止条件,而不是绝对熵值阈限。
四、行业影响与未来计划
FinReflectKG不仅是学术创新,更为AI金融知识图谱工程奠定了可扩展、可验证的新范式:
未来方向包括:
- 数据集扩展至涵盖过去十年全部S&P 500公司,覆盖更全面金融生态;
- 开发无Schema管道,可基于原文自动构建本体,类似“抽取-定义-规范化(EDC)”流程,实现真正零样本符号推理;
- 构建时序知识图谱,捕捉关系随时间演化(如投资主题推理、因果链分析);
五、科研与应用价值
FinReflectKG带来的“符号-统计-反馈”三元融合范式,指引AI从“统计鹦鹉”升级为“可验证的逻辑推理者”。为企事业,尤其是金融科技、投资决策、监管科技、金融数据服务等创新应用带来坚实基础。
结果与分析
- 规则检查(CheckRules):反射模式在所有四个规则上的合规得分为64.8%,显著提高了实体命名长度和关系模式规则的合规性。
- 局部提取效率:反射模式在每个块中生成更多的三元组,实体、类型和关系的覆盖率显著高于单次和多次模式。
- 全局语义多样性:反射模式在覆盖率最高的情况下,所有维度的熵最低,表明其有意减少了不确定性,生成更紧凑、连接和可导航的图。
- 比较评估:LLM作为评委:反射模式在精度、全面性和相关性方面优于其他模式,尽管在忠实度方面略低,但总体上反映了更高的提取质量。
总体结论
优点与创新
- 大规模开源金融知识图谱数据集:发布了基于所有标普100公司2024年年度SEC 10-K文件的开源、全面的金融知识图谱,为金融AI研究和应用提供了大量高质量资源。
- 新颖的反射驱动提取框架:提出了三种提取模式(单次、多次、反射代理),并通过反射驱动的反馈系统系统地提高提取质量,在所有规则下达到64.8%的合规性得分,并在LLM评估中表现优于基线方法(单次和多次)。
- 可泛化的评估方法:开发了一个综合评估框架,包括基于规则的合规性检查、覆盖范围分析、语义多样性指标和LLM作为评委的比较评估,建立了金融知识图谱评估的新基准。
- 智能文档解析层:利用先进的文档解析层,保留SEC 10-K文件中的多种格式,包括叙述文本、表格和图像,确保在预处理过程中不会丢失关键信息。
- 表感知语义分块层:采用自定义的分块算法,保留表格的完整上下文,确保金融数据的完整性和语义一致性。
- 迭代提示和代理驱动的三元组提取层:通过迭代经验和代理驱动的方法,识别最可靠和扎实的知识图谱三元组。
不足与反思
- 跨文档共指解析:反射循环仅部分解决了跨文档共指解析问题,因为反射循环操作的是孤立文件。
- 评估方法的依赖性:评估方法依赖于LLM投票替代真实情况,存在传播底层评委模型固有偏见的风险。
- 实时应用的局限性:反射代理需要额外的推理轮次,可能限制其在需要快速响应的实时应用(例如日内新闻源)中的适用性。在这种情况下,单次策略可能提供一个可行的替代方案,以减少计算开销的同时恢复大部分规范化好处。
- 未来工作:计划开发一个无模式的知识图谱构建和自我改进管道,特别是对于私有金融数据源,其中模式要求是未知的。此外,还将扩展知识图谱三元组数据集,包括过去10年所有标普500公司的年度SEC 10-K文件,显著扩大金融知识图谱的范围和时间覆盖范围。
- 单次工作流程:在这种模式下,使用一个综合提示,指示语言模型从每个文档块中一步提取所有有效的知识图谱三元组。提示中明确列举了实体和关系类型,要求规范化实体名称,并以严格的JSON格式输出结果。这种方法的优点是高效,但可能存在偶尔的不一致性问题。
- 多次工作流程:为了提高提取质量和一致性,采用多次提示策略。首先,模型从每个块中提取候选三元组,然后在第二次提示中重新处理其输出和原始块,并应用专门的规范化提示。这种方法利用了LLM的推理能力进行提取和细化,结果更高精度和一致性。
- 反射驱动的代理工作流和元分析:部署一个专门的反思代理,通过模拟反馈(评论家)和纠正LLM之间的多轮交互,迭代改进初始三元组集。评论家LLM验证实体标签和关系分配是否符合域模式,并评估业务相关性和标记低价值或矛盾的三元组。反馈以结构化的JSON格式返回,所有批评实例记录进行元分析,揭示重复错误模式并指导提示重新设计。
- 规则检查(CheckRules):评估每个提取的三元组是否符合一组规则,包括主题引用、实体长度约束、实体模式合规性和关系模式合规性。每个提取的三元组单独评估,合规得分在0到1之间。规则检查揭示了具体的合规瓶颈,并量化了在越来越严格的条件下有效三元组的数量。
- 局部提取效率:计算覆盖率比率,量化实体、实体类型和关系的多样性和完整性。具体指标包括唯一实体和实体类型的覆盖率(TCR和TCR-N)以及关系的覆盖率(RCR和RCR-N)。反射模式在所有覆盖率指标上均优于单次和多次模式,表明其生成了更多、更丰富的语义内容。
- 全局语义多样性:使用信息论度量分析提取的实体、类型和关系的分布,包括香农熵、模式归一化熵和Rényi熵。反射模式在覆盖率最高的情况下,所有维度的熵最低,表明其有意减少了不确定性,生成更紧凑、连接和可导航的图。
- 比较评估:LLM作为评委:利用LLMs作为比较评委,评估提取三元组的精确度、忠实度、全面性和相关性。采用直接指令的提示策略,避免中间推理步骤。通过多次独立评估和一致性检查,确保评估结果的可靠性。
- 单次工作流程:
- 优点:高效,能够在一次处理中完成所有提取任务。
- 缺点:可能存在偶尔的不一致性问题,如实体规范化或关系分配的错误。
- 表现:在规则检查和局部提取效率方面表现良好,但在全局语义多样性和LLM评估中略逊于反射模式。
- 优点:通过两次处理提高了提取的质量和一致性。
- 缺点:增加了处理时间和复杂性。
- 表现:在规则检查和局部提取效率方面优于单次模式,但在全局语义多样性和LLM评估中仍不如反射模式。
- 优点:通过迭代反馈和纠正机制,显著提高了提取的准确性和一致性,生成更密集和更清洁的知识图谱。
- 缺点:需要额外的推理轮次,可能不适合实时应用。
- 表现:在规则检查、局部提取效率、全局语义多样性和LLM评估中均表现最佳,达到了最高的合规得分和全面的提取质量。
标签推荐
#知识图谱 #大模型 #金融科技 #信息熵 #KG #LLM
欢迎在下方留言交流对知识图谱与大模型融合创新的思考与实践经验!
欢迎加入「知识图谱增强大模型产学研」知识星球,获取最新产学研相关"知识图谱+大模型"相关论文、政府企业落地案例、避坑指南、电子书、文章等,行业重点是医疗护理、医药大健康、工业能源制造领域,也会跟踪AI4S科学研究相关内容,以及Palantir、OpenAI、微软、Writer、Glean、OpenEvidence等相关公司进展。
电子书推荐
[300页电子书]Palantir 股票的大数据,大利润:为什么Palantir是未来企业级AI的潜力股
[555页电子书]从LLM Agent到RAG与知识图谱全攻略实战指南重磅发布——构建具备推理、检索与行动能力的智能体
250页电子书-医学领域的人工智能革命:GPT-4及医学大模型未来展望。OpenAI CEO作序
[100页电子书]知识图谱&大模型双轮驱动的工业 AI 数智化转型权威指南 - Cognite
[73页]OpenAI联合哈佛等重磅发布全球首份ChatGPT使用报告,分析用户增长、使用模式及其经济价值
[140页]Neo4j GraphRAG白皮书
[72页]谷歌推出个性化实时监测主动健康管理大模型PH-LLM
[180页电子书]GraphRAG全面解析及实践-Neo4j:构建准确、可解释、具有上下文意识的生成式人工智能应用
[30页电子书]GraphRAG开发者指南
往期推荐
亚马逊云科技与柯基数据联合打造的“Automotive Services GraphRAG”解决方案亮相慕尼黑IAA展会!
GraphRAG实施中常见挑战的分析及其应对策略-海外图谱增强大模型公司Lettria的GraphRAG实践建议
知识图谱与大模型的融合:SubGraphRAG在减少幻觉和提升准确性上的突破
海外大模型落地故事: Medisolv如何利用GraphRAG破解医疗报告难题 — Writer
图谱增强生成 GraphRAG :突破 GenAI 应用边界的利器
“GraphRAG+DeepSearch” 企业级多模态Agent知识平台V2.0 重磅升级!
利用 Amazon Bedrock 知识库构建 GraphRAG 应用的全面实战指南
理解与创新:RAG、Graph RAG以及Agentic RAG在AI中的应用
引领智能检索新纪元:Graph RAG vs RAG,谁才是真正的AI知识利器?
GraphRAG:连接数据世界的AI新引擎
GraphRAG性能飞跃:结合向量搜索与Agent路由,实现知识图谱复杂问题高效解答
突破AI知识边界:探索GraphRAG、向量RAG和Agentic RAG的融合之路
图谱增强大模型智能新纪元:RAG vs Graph RAG,"生成式+结构化+可解释+深度推理" 驱动的企业智能引擎
颠覆RAG的智能媒体检索利器:GraphRAG详解
用模糊解析强化LangChain的GraphRAG:自动构建知识图谱准确率提升3倍 — 基于BAML的实践笔记
构建高效的GraphRAG系统:简化架构与工具选择的艺术
FrOG:基于知识图谱的开源GraphRAG问答系统研究综述
工业大模型公司 Mivva 解锁能源AI见解:GraphRAG智能问答助手的实践旅程
MMGraphRAG:通过可解释的多模态知识图谱桥接视觉与语言模型
OpenAI重磅发布“KG+LLM”结合的企业智能知识管理红宝书,利用大模型构建时序知识图谱与新一代“GraphRAG”智能体
Timbr GraphRAG:结构化与非结构化数据,驱动更聪明的企业级GenAI
企业GenAI革命:海外大模型创业公司Writer解密GraphRAG和知识图谱如何引领智能知识服务未来
GraphRAG革命:如何利用知识图谱提升LLM的检索与生成能力
GraphRAG:用知识图谱与生成式AI开创关系感知的智能新时代
EraRAG:突破传统GraphRAG限制,实现动态语料库的高效检索增强生成
探索AI未来:GraphRAG——更高效智能的跨文档查询方式
知识增强大模型GraphRAG 如何彻底改变阿尔茨海默病的基因研究和治疗 - 美国Cedars-Sinai 医疗中心
GraphRAG + DeepSearch: 下一代企业级人机协同大模型推理架构及医药法律等领域Agent深度详解
GraphRAG:重新定义信息检索的智能革命
九大GraphRAG的全面评估:GraphRAG-Bench基准测试集解析 - 香港理工&腾讯优图等
什么时候GraphRAG超越传统RAG:突破医学等知识密集任务的AI新范式和GraphRAG-Bench评估框架
Precina Health 如何使用GraphRAG 通过实时洞察彻底改变 2 型糖尿病护理
Graph RAG框架、基本工具和实际用例
基于GraphRAG的妊娠期糖尿病管理本地大模型
OpenTCM:基于GraphRAG的传统中医药知识检索与诊断问答图谱增强大模型系统 - 香港中文大学
HyperGraphRAG:基于超图结构知识表示的新版GraphRAG - 北邮、安贞医院等
多模态GraphRAG初探:文档智能+知识图谱+大模型结合范式
如何构建医疗健康等复杂场景下的Agentic GraphRAG?
Agentic-RAG和GraphRAG双轮驱动,基于NCCN肿瘤医学指南开发用于个性化无幻觉乳腺癌治疗
GraphRAG最新成果:基于图的RAG统一框架深度分析 — 港中深&华为
Diffbot的GraphRAG大模型
医学知识图谱驱动的GraphRAG:Deepseek-R1与Weaviate用于高级Chatbot
利用GraphRAG和数字孪生进行个性化教育:面向工业4.0劳动力发展的虚拟现实、增量式学习和零样本情感分析- 亚利桑那大学等
用GraphRAG和知识图谱解锁GenAI大模型 - Neo4j CTO 演讲视频&PPT
普华永道GraphRAG-工具融合
释放多模态GraphRAG的力量:集成图像特征以获得更深入的洞察 - 2025最新PPT
PIKE-RAG: 微软开源下一代GraphRAG,知识增强大模型解锁企业级私有数据应用落地价值
[2025最新综述解读]定制化大模型的GraphRAG - 香港理工&吉林大学等
(88页)知识图谱增强大模型GraphRAG 2025年最新调研综述 - 密歇根大学、Adobe、Meta、亚马逊等
“大模型+知识图谱”双轮驱动的见解、技术和评估 - 英伟达的GraphRAG
GraphRAG和轻量级LightRAG技术及应用案例深度解析
故障分析怎么做?朴素KG方案及LLM+Graph RAG方案实现思路
GraphRAG 的演变 -Neo4j GenAI Graph Gathering 2.0
微软GraphRAG框架演进之路及带来的一些思考
LazyGraphRAG:微软重磅推出高性价比下一代GraphRAG
提升大型语言模型结果:何时使用GraphRAG
GraphRAG产业化应用落地挑战和探索:知易行难 - 企业大模型独角兽Glean实践之四
微软GraphRAG最新动态:通过动态社区选择改善全球搜索
现有RAG框架非完全总结:7个GraphRAG+17个传统RAG框架归纳
GraphRAG从研发到上线的挑战-硅谷企业级大模型知识库独角兽Glean系列之三
企业级知识库为什么要用GraphRAG - 硅谷企业级ChatGPT独角兽Glean系列之二
企业智能知识库企业Glean利用GraphRAG融资2.6亿美元
MedGraphRAG最新版:探索医学大模型领域的未来新革命 - 牛津&CMU
医学GraphRAG案例研究:将医生记录转换为医学时序知识图谱
微软GraphRAG 0.4.0&DRIFT图推理搜索更新
GraphRAG图检索增强,助力新一代大模型知识库的落地|爱分析活动
StructRAG: 下一代GraphRAG - 中科院&阿里
RAG前沿之RAG–知识图谱构建框架Graphusion:兼看LongRAG双视角检索增强生成范式
Structured-GraphRAG知识增强框架——足球游戏数据案例研究
解锁洞察:金融服务中的GraphRAG和标准RAG对比案例解析
蚂蚁图团队GraphRAG支持社区摘要——Token相比微软直降50%
从知识图谱到 GraphRAG:探索属性图的构建和复杂的数据检索实践
基于图谱和智能体的法律文档 GraphRAG案例深度解析 - WhyHow.AI
什么时候(不)用GraphRAG
GraphRAG工程落地成本详细解读和实例分析
企业生成式人工智能应用的架构模式:GraphRAG、RAG、DSFT和RAFT
知识图谱增强大模型GraphRAG全面综述解读 - 蚂蚁集团、北大、浙大、人大等
GraphRAG:使用知识图谱进行AI Agent编排和工业化路径
贝莱德&英伟达 - HybridRAG:整合GraphRAG和VectorRAG以实现金融信息高效提取
医学GraphRAG:通过知识图谱检索增强实现安全医疗大语言模型 - 牛津大学最新论文
GraphRAG类型、限制、案例、使用场景详细解析
GraphRAG在网络安全情报分析的变革性应用
GraphRAG + GPT-4o mini 低成本构建 AI 图谱知识库
GraphRAG案例讲解-由知识图谱驱动的辅助数据目录元数据发现大模型
GraphRAG有多贵?基于GPT-4o的Token令牌消耗成本分析
使用Streamlit、LangChain、Neo4j和GPT-4o构建GraphRAG实战讲解及开源实现
基于GraphRAG的SEO智能助手实战案例 - 解锁大模型和知识图谱结合的力量
[重磅]图数据库厂商Neo4j CTO详解GraphRAG:为生成式人工智能增添知识
引入GraphRAG的场景条件分析
重磅 - 微软官宣正式在GitHub开源GraphRAG
GraphRAG如何应用于合同文档管理
开源GraphRAG解读:微软的人工智能驱动知识发现方法
揭示微软开源的RAG策略:GraphRAG
Microsoft 的 GraphRAG实践
何时构建知识图谱驱动的GraphRAG系统 — 投入和产出分析
Vector | Graph:蚂蚁首个开源Graph RAG框架设计解读
GraphRAG工作原理揭秘及挑战
从RAG到GraphRAG: 用知识图谱帮助RAG链接数据 — 海外GenAI公司Chanko实践
[万字长文]GraphRAG技术栈及样例全面解析
GraphRAG应用中小图谱与大图谱的角色
GraphRAG:设计模式,挑战和落地指南
从RAG到GraphRAG的应用落地揭秘
快速医疗信息互操作标准FHIR上的GraphRAG
Neo4j与微软合作GraphRAG,以增强GenAI能力
Linkedin的GraphRAG客服问答系统实践
重磅-微软发表GraphRAG论文并即将开源项目
企业级RAG向量检索的限制和Writer的GraphRAG方案 - Part2
海外人工智能公司Writer的GraphRAG实践揭秘- Part1
LLM的前沿高效探索 - GraphRAG: 更好,更快,更便宜
微软的GraphRAG:智能问答系统的革命
从传统RAG到GraphRAG - 当大模型遇见知识图谱
深度解析知识图谱增强的GraphRAG及医药案例
基于知识图谱的RAG全生命周期知识增强 - GraphRAG
GraphRAG: 解锁大模型RAG知识增强
大模型&知识图谱双轮驱动的企业智能与分析用
用智能体优化智能体工具:Anthropic揭秘高效Agent开发新范式
基于知识图谱增强大模型的企业级智能知识库独角兽Glean获1.5亿美元F轮融资,估值72亿美元
DoorDash如何利用知识图谱增强大模型提升搜索召回精度
ESCARGOT:一种利用大模型、动态思维图和生物医学知识图谱以增强推理的AI智能体
论文浅尝 | CogMG:大语言模型与知识图谱的协同增强(ACL2024)
知识图谱增强大模型KERAP:多智能体推理语言模型在零样本诊断预测中的革新应用 - 哈佛大学&埃默里大学等
LLM vs LMM:知识图谱增强大模型驱动营销革新浪潮
BEKO:大语言模型与知识图谱的双向增强-吴信东
重磅发布|智护成长新纪元:知识图谱增强的儿童青少年健康管理智能体
MSG-LLM:多维度互动框架用于图谱增强大模型
[npj 数字医学]知识图谱增强的无幻觉医学信息大模型
DO-RAG:一种使用知识图谱增强检索辅助生成的领域特定问答框架 - 清华大学等
论文浅尝 | KnowGPT:利用知识图谱增强大型语言模型的专业领域问答能力(NeurIPS2024)
知识图谱增强的合规医学大模型产学研新范式探索
RAKG:文档级检索增强知识图谱构建 - 上海人工智能实验室等
AMG-RAG自适应知识图谱增强医学问答:弥合大模型与动态医学知识的差距 - 多伦多大学等
将知识图谱与大模型 (LLM) 协同化:实现语义增强智能的途径
利用大型语言模型增强知识图谱查询-意大利帕维亚大学
喜讯|柯基数据知识图谱增强的医学合规科研智能体荣获信通院智能体应用优秀案例
[论文解读]知识图谱引导的检索增强生成RAG - 南京大学&阿里巴巴
喜讯|柯基数据“知识图谱增强大模型”获得“国家电网科学技术进步奖”三等奖!
富士通推出知识图谱增强RAG软件分析和可视化服务,以支持企业最佳现代化规划流程
知识图谱增强营养健康大模型:迈向改进的管理、可重复性和验证 - RPI等
[2025论文解读]基于知识图谱的思考:一种知识增强的泛癌症问答大模型框架 - 中科院&广州国家实验室等
[VLDB24 KG+LLM论文]利用多模态和知识图谱增强大模型以实现无幻觉的开放集物体识别 - 河海大学等
medIKAL-知识图谱增强大模型以提升电子病历临床诊断能力
KG4Diagnosis - 知识图谱增强的多智能体大模型在医学诊断中的应用
北大Chatlaw - 基于知识图谱增强混合专家模型的多智能体法律助手
Stardog-知识图谱增强大模型企业智能体平台Voicebox的愿景
以内容为中心的粗粒度知识图谱增强大模型的实践研究 - DataStax
EMNLP 2024 | CoTKR:面向复杂知识图谱问答任务的思维链增强的知识改写方法
MedSyn:基于医学知识图谱增强大模型的合成医学文本生成框架
事实发现者 - 通过引入知识图谱增强大模型的生物医药领域专业知识(拜耳制药&IAIS)
KRAGEN:使用知识图谱增强的RAG解决生物医学大型语言模型问题