NurseLLM:海外首个专为护理领域定制的大型语言模型
原文链接 https://t.zsxq.com/l9pOQ
研究背景
- 研究问题:这篇文章要解决的问题是如何在护理领域利用大型语言模型(LLMs)进行有效的问答任务。尽管LLMs在通用医学AI系统中取得了显著进展,但在护理领域的潜力尚未得到充分探索。
- 研究难点:该问题的研究难点包括:护理和医学领域的知识体系不同,护理强调全面的、以患者为中心的护理,而医学则侧重于诊断和治疗;现有的护理问答数据集规模较小,且缺乏针对护理专业知识的评估标准,如美国的NCLEX考试。
- 相关工作:目前,尚未有专门针对护理领域的LLMs。大多数护理应用依赖于通用或医学领域的LLMs,但这些模型在临床评估中表现出不确定性,可能会导致不必要的诊断测试,误解护理概念,从而增加过度分诊的风险。
研究方法
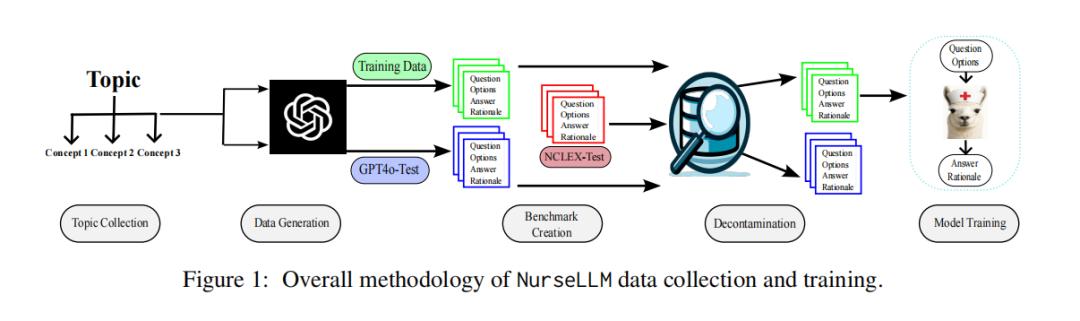
- 主题收集:首先,创建了一个全面的NCLEX主题分类体系,涵盖7个专科、60个领域、232个主题和1830个概念。
- 合成NCLEX问答生成:使用GPT-4o从这些概念中生成相应的NCLEX问答对,并为正确答案提供理由。这些理由随后用于训练NurseLLM,采用链式思维(CoT)推理方法。
- 基准测试创建:开发了多个基于NCLEX的基准测试,包括人类标注的黄金NCLEX基准(1726个问题)、GPT-4o生成的测试基准(1830个问题)、MultiMedQA(多个医学问答数据集的集合)及其护理子集MultiNurseQA。
- 去污染:为了确保训练样本的多样性和泛化能力,采用两步过滤法去除与测试集重叠的样本,并使用ROUGE-L评分进行样本比较。
实验设计
- 模型训练:使用Llama3-Med42-8B作为基础模型,最大长度设置为2048,批量大小为1,梯度累积步长为8,训练2个epoch,学习率为2e-5。模型在AWS SageMaker上使用NVIDIA 10G GPU训练4天。
- 模型合并:为了防止微调过程中出现的灾难性遗忘,使用MergeKit将微调后的LLM与基础模型Med42合并,合并比例为60%。
- 评估基准:使用四个基准进行评估:NCLEX-Test(1726个MCQ问题)、GPT4o-Test(1830个NCLEX MCQ问题)、MultiMedQA和MultiNurseQA。
- 基线模型:包括通用和医学领域的LLMs,如Med42、Gemma、Apollo、LLaMA、OpenBioLLM、Mistral、BioMistral、MedAlpaca和DeepSeek-LLaMA。
结果与分析
- NCLEX-Test上的表现:NurseLLM在NCLEX-Test基准上的准确率超过76%,优于所有开源LLMs,甚至优于一些医学领域的LLMs。
- GPT4o-Test上的表现:尽管GPT-4o生成的基准存在随机性,但NurseLLM在8B参数下达到了91%以上的准确率,接近GPT-4o-mini的94.97%。
- MultiMedQA上的表现:在通用医学基准上,医学领域的LLMs如Med42表现优于NurseLLM,但NurseLLM仍能保持与其他基线相当的表现。
- MultiNurseQA上的表现:在护理子集上,Med42继续优于NurseLLM,但NurseLLM紧随其后,仅落后0.19%。与其他基准相比,NurseLLM的性能下降最小。
总体结论
优点与创新
- 首个专门针对护理领域的语言模型:NurseLLM是首个专门为护理问答任务设计的语言模型,不仅提供答案,还提供理由以确保模型的透明性和可信度。
- 多阶段数据生成管道:开发了第一个大规模且主题多样的护理问答数据集,涵盖广泛的护理主题。
- 多种护理基准测试:开发了三个不同的护理MCQ基准,用于系统地评估LLMs在护理问答任务上的表现。
- 显著优于通用和医疗专业LLMs:广泛的评估显示,NurseLLM在护理基准上的表现优于同等参数规模的最先进的通用和医疗专业LLMs。
- 推理和多代理协作系统的潜力:探讨了推理和多代理协作系统在护理领域中的潜力,展示了未来研究和应用的前景。
不足与反思
- 数据生成时间线:由于使用了2024年5月的GPT-4o版本,模型的响应可能会随时间变化,因此提示策略和数据生成管道应相应处理。
- 数据质量:尽管自动化数据生成管道使整体数据生成过程可扩展,但存在低质量数据进入语料库的风险,建议进行人工检查以维持语料库的标准质量。
- 模型响应:尽管NurseLLM在NCLEX问题上表现出色,但仍需提高准确性,表明LLM在回答护理问题时可能会产生不准确的响应。考虑到该领域的敏感性,建议在部署前谨慎使用NurseLLM。
- 模型评估:仅使用开源模型进行评估,未评估闭源LLMs,因为闭源模型的规模不具可比性且出于专有原因未将其纳入NCLEX基准测试。然而,计划在接受后发布合成测试基准和训练数据集。
- 主题收集:首先,创建了一个全面的NCLEX主题分类体系,涵盖7个专科、60个领域、232个主题和1830个概念。
- 合成NCLEX问答生成:使用GPT-4o从这些概念中生成相应的NCLEX问答对,并为正确答案提供理由。这些理由随后用于训练NurseLLM,采用链式思维(CoT)推理方法。
- 基准测试创建:开发了多个基于NCLEX的基准测试,包括人类标注的黄金NCLEX基准(1726个问题)、GPT-4o生成的测试基准(1830个问题)、MultiMedQA(多个医学问答数据集的集合)及其护理子集MultiNurseQA。
- 去污染:为了确保训练样本的多样性和泛化能力,采用两步过滤法去除与测试集重叠的样本,并使用ROUGE-L评分进行样本比较。
- 模型微调:使用Llama3-Med42-8B作为基础模型,在护理数据上进行微调。
- 模型合并:使用MergeKit将微调后的LLM与基础模型Med42合并,合并比例为60%。这样可以在保留基础模型的通用医学能力的同时,适应新的护理知识。
- NCLEX-Test:NurseLLM在NCLEX-Test基准上的准确率超过76%,优于所有开源LLMs,甚至优于一些医学领域的LLMs。
- GPT4o-Test:尽管GPT-4o生成的基准存在随机性,但NurseLLM在8B参数下达到了91%以上的准确率,接近GPT-4o-mini的94.97%。
- MultiMedQA:在通用医学基准上,医学领域的LLMs如Med42表现优于NurseLLM,但NurseLLM仍能保持与其他基线相当的表现。
- MultiNurseQA:在护理子集上,Med42继续优于NurseLLM,但NurseLLM紧随其后,仅落后0.19%。与其他基准相比,NurseLLM的性能下降最小。
欢迎加入「知识图谱增强大模型产学研」知识星球,获取最新产学研相关"知识图谱+大模型"相关论文、政府企业落地案例、避坑指南、电子书、文章等,行业重点是医疗护理、医药大健康、工业能源制造领域,也会跟踪AI4S科学研究相关内容,以及Palantir、OpenAI、微软、Writer、Glean、OpenEvidence等相关公司进展。
电子书推荐
[300页电子书]Palantir 股票的大数据,大利润:为什么Palantir是未来企业级AI的潜力股
[555页电子书]从LLM Agent到RAG与知识图谱全攻略实战指南重磅发布——构建具备推理、检索与行动能力的智能体
250页电子书-医学领域的人工智能革命:GPT-4及医学大模型未来展望。OpenAI CEO作序
[100页电子书]知识图谱&大模型双轮驱动的工业 AI 数智化转型权威指南 - Cognite
[73页]OpenAI联合哈佛等重磅发布全球首份ChatGPT使用报告,分析用户增长、使用模式及其经济价值
[140页]Neo4j GraphRAG白皮书
[72页]谷歌推出个性化实时监测主动健康管理大模型PH-LLM
[180页电子书]GraphRAG全面解析及实践-Neo4j:构建准确、可解释、具有上下文意识的生成式人工智能应用
[30页电子书]GraphRAG开发者指南
往期推荐
N.U.R.S.E.S. 拥抱人工智能:护理专业人工智能素养指南重磅发布
智能守护银发族:Palantir×SOMPO共塑日本医疗与护理新时代
药械营养保健企业的Agentic AI应用(罕见病诊断、患者护理、生产检测等)全解析
生成式人工智能在护理中被忽视的阴暗面:国际智库的视角
Precina Health 如何使用GraphRAG 通过实时洞察彻底改变 2 型糖尿病护理
利用生成式人工智能增强重症监护室护理实践:一项基于模拟临床案例的诊断协同效应形成性研究
多模态生成式人工智能辅助医疗护理培训 - DFKI、南安普顿大学等
大模型在失智患者护理的研究 - Cardiff&剑桥大学
CancerKG.ORG - “知识图谱 +大模型”双轮驱动的人机协同癌症诊疗与护理智能体
利用大模型提升护理与老年照护:一个AI驱动的框架 - 复旦、上交等
[最新论文]探索大模型在乳腺癌肿瘤学护理领域中的应用潜力 - 谷歌DeepMind等
厦门·护理信息大会|首都医科大学与柯基数据合作的NursGPT项目顺利启动!
从“小白”到“专家”:大模型在肿瘤护理中的潜力探索
使用大模型指导患者创建高效全面的临床护理信息
Nature - 基于护理大模型的医院门诊接待机器人和护士的人机协同新范式
护理临床智能决策的新颖方法:大语言模型与本地知识库的整合
护理国自然近一半竟然是这个?