精度提升12.7%!SwinMamba 对比 Swin Transformer在 LoveDA 数据集的突破性表现!
点击下方卡片,关注「AI视界引擎」公众号
精度提升12.7%!SwinMamba对比 Swin Transformer在LoveDA数据集的突破性表现!
遥感图像的语义分割是计算机视觉中的一项基本任务,其目标是将图像中的每个像素分配到预定义的特定类别,如建筑物、道路、植被、水体和裸地[1]。这种像素级分类对于多种应用至关重要,如农业监测、城市规划和基础设施建设[2]。与自然图像的语义分割不同,遥感图像因其独特的数据特性而带来重大挑战[3]。这些图像通常表现出高空间分辨率[4]、目标尺度变化、光谱不一致性[5]和复杂的空间依赖关系。此外,类别重叠和边界模糊等现象进一步挑战了准确分割。上述复杂性远远超过了自然图像中相对均匀的尺度和较简单的上下文特征,因此需要更先进的计算策略。因此,深度学习已成为解决此任务的主要方法,利用其提取层次化特征和高效处理大规模数据的能力[6]。
基于卷积神经网络(CNN)的方法凭借其在卷积操作中捕捉局部特征的能力,已成为遥感语义分割任务中的主流方法[7]。这些方法在建模遥感数据中固有的复杂纹理和模式方面表现出色。然而,CNN受限于其有限的感受野,这阻碍了它们捕捉长距离依赖关系的能力,在解释大规模场景中的上下文信息时是一个显著的限制[8]。为了克服这一缺陷,研究行人已将Transformer架构引入视觉领域[9]。Transformer最初是为自然语言处理(NLP)开发的,其自注意力机制在处理上下文关系方面的优越性备受赞誉[10]。当适应视觉任务时,视觉Transformer(ViT)在语义分割中表现出卓越的性能[11]。尽管如此,它们的计算复杂度随序列长度呈二次方增长,这为处理高分辨率遥感图像带来了重大挑战。为了解决这一 Bottleneck ,最近提出的Mamba模型已成为一个有前景的解决方案[12]。Mamba同样源自NLP领域,旨在减轻Transformer的二次方复杂度,同时保留类似全局注意力的能力。研究表明,Mamba在视觉任务中表现出显著的适应性[13],在不同场景中取得了出色的成果[1, 14]。在遥感图像语义分割领域,多项研究[13, 14]已应用Vision Mamba,证实了其在此任务中的效率和有效性。
尽管基于Mamba的语义分割方法取得了显著进展,但它们普遍依赖全局扫描策略,这在需要精确描绘空间邻近细节(如边缘和纹理)的遥感图像语义分割中暴露了一个根本性局限。现有的基于Mamba的方法主要专注于优化全局扫描模式[15],如Z形[16]、S形[17]、对角线[18]、螺旋形[19]、基于树的结构[20]或随机序列[21],以将2D特征图转换为1D序列[13],通常集成双编码器架构以增强任务特定的适应性[1]。虽然这些努力增强了模型学习多样化图像模式的能力,但这些全局扫描范式始终将图像视为一个统一的全局序列[15],从而忽略了感知的关键局部特征。这一疏忽凸显了对能够智能整合局部和全局上下文感知的创新框架的迫切需求,从而为更准确和鲁棒的像素级分类铺平道路。
为此,作者提出了SwinMamba,这是一个能够融合局部和全局上下文信息的新框架,使其特别适用于遥感图像的语义分割。受Swin Transformer [22]首创的局部自注意力机制启发,作者调整了Vision Mamba的四向扫描范式,使其在局部区域内运行。这种调整实现了模型的全局建模能力与局部特征提取之间的无缝协同。通过引入重叠移位窗口机制,SwinMamba促进了局部区域之间更强大的信息交换,减轻了纯局部处理中固有的隔离问题。为了进一步优化细粒度局部细节与全局感知之间的平衡,作者在前两个阶段采用基于局部窗口的扫描策略,优先捕获局部细节,而在后两个阶段过渡到全局扫描,以获取全局上下文信息。在LoveDA和ISPRS Potsdam数据集上的广泛评估验证了SwinMamba的有效性,相比最先进的Vision Mamba方法,分别实现了和的平均IoU(mIoU)提升。
本文的主要贡献总结如下:
作者介绍了具有新颖局部扫描策略的SwinMamba框架,这标志着首次尝试将Mamba的扫描机制适配到局部区域。
通过将局部扫描策略与移位窗口机制相结合,作者实现了相邻局部区域之间的有效信息交换,从而增强了模型在这些区域间整合特征的能力。
作者提出一种集成的扫描方法,该方法在初始阶段采用局部扫描,在后期阶段采用全局扫描,显著提高了局部和全局特征的融合。
语义分割是计算机视觉中的一项基础任务,其中CNN和ViT等神经网络架构各自表现出独特的优势和劣势。CNN在局部区域处理方面表现出色,通过卷积操作有效捕获细粒度细节,而ViT则通过全局自注意力机制在整体图像理解方面表现出卓越的能力。为了利用这些互补优势,许多语义分割架构采用了整合局部和全局视角的策略[23]。
一种有效的方法是使用混合架构,例如融合CNN和ViT范式的架构。例如,Wang等人[24]提出了一个结合CNN和ViT特征学习优势的框架,采用一致性感知伪标签自集成策略来增强半监督语义分割,在医学图像分割任务中显示出有希望的结果。除了半监督学习,Wang等人[25]将CNN特征嵌入到ViT架构中,使模型能够同时捕获全局上下文和局部多模态信息,从而提高高分辨率遥感影像中的特征提取。类似地,Wang等人[26]通过CNN增强来改进MobileViT[27],以细化细粒度区域分割,并将其应用于野火场景中的语义分割。
除了混合架构外,许多方法对架构本身进行优化。对于基于CNN的模型,DeepLab系列[28]引入了扩张卷积来扩大感受野,通过不同速率的空洞卷积增强多尺度感知能力。HRNet[4]通过并行的多分辨率分支在整个网络中保持高分辨率表示,从高分辨率分支(专注于局部细节)开始,逐步添加低分辨率分支(强调全局上下文),并通过交换块进行重复的多尺度融合。相比之下,基于ViT的模型着重于增强局部细节捕获能力。例如,Swin Transformer[22]采用局部自注意力机制来强制关注局部区域,同时在连续层中交替使用移位窗口来全局传播信息,实现了平衡的层次结构。SegFormer[29]在分层Transformer编码器中利用重叠块合并来提取多级特征,简化了全局-局部融合,无需复杂的位置编码。
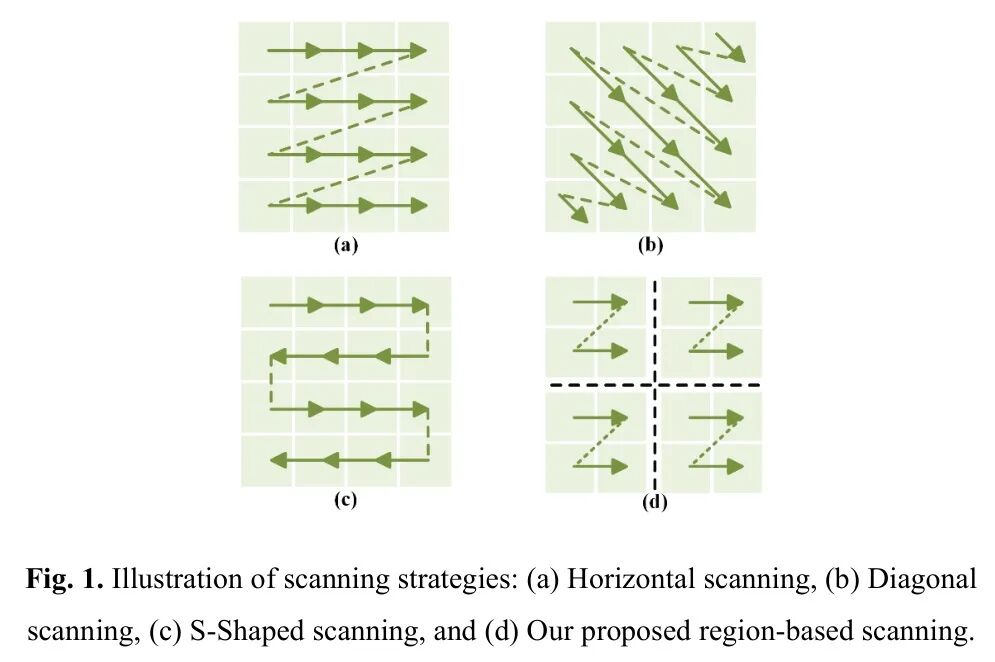
Mamba已成为自然语言处理任务中的一种强大架构[30],促使研究行人探索其向视觉领域的适应性。借鉴Vision Transformer[9]将图像划分为token的有效方法,Vim[31]通过序列化图像token并采用双向Mamba块进行压缩视觉表示建模,开创了这一努力——具体而言,以Z形模式从左到右(如图1(a)所示)和从右到左扫描。与此同时,VMamba[16]采用了类似的策略,但将其扩展为四向Z形扫描:从左到右(如图1(a)所示)、从右到左、从上到下和从下到上。
这些基于Mamba的方法规避了限制ViTs的二次复杂度,使它们更适合高分辨率图像的语义分割。由于其架构优势,简单地将Vim或VMamba与高性能解码器(如UperNet)连接,已在语义分割任务中取得了优异的结果[32]。大量工作也集中于改进基于Mamba的架构,改进主要集中在优化扫描方向[33]。Samba[14]避免多向扫描,而采用单向序列方法来高效处理高分辨率遥感图像,实现了与多向策略相当的竞争性分割结果。
更进一步,Shi等人[18]yinqing-SwinMamba_2509包含了六个方向,在VMamba的四向扫描基础上增加了两条对角线路径(如图1(b)所示)。虽然带来了性能提升,但他们的方法因方向增加而产生了额外的计算开销。类似地,Chen等人[34]通过一种随机打乱token的新型扫描策略增强了Vim。PlainMamba[17]偏离了上述跨行跳跃扫描,认为扫描的连续性增强了空间连贯性和视觉特征提取。如图1(c)所示,它采用S形蛇形扫描。除此之外,新颖的扫描方向还包括螺旋形[19]和基于树形[20]的模式。尽管Mamba方法中的扫描方向多种多样,但缺乏公平的定量比较使得这些变体带来的改进尚不明确[15]。Zhu等人[15]在遥感图像分割中通过提出一个实验框架来评估各种扫描方向及其组合,解决了这一问题,表明扫描方向及其堆叠方式的差异对性能影响甚微。
与扫描方向的探索相比,作者提出的SwinMamba在机制层面进行了创新,保留了类似VMamba的四向扫描,但首次有效地将局部-全局概念与Mamba架构融合。
具体而言,SwinMamba在早期阶段对局部区域内的tokens进行扫描(如图1(d)所示),通过类似移位窗口的机制促进窗口间信息交换,随后在后期阶段进行全局扫描以进行整体建模。
这种方法使架构能够平衡局部和全局信息,从而有效支持遥感图像中的语义分割任务。
SwinMamba架构建立在编码器-解码器框架之上,这种结构在语义分割任务的网络中被广泛采用。编码器包含四个阶段:前两个阶段由Local SwinMamba Blocks组成,擅长捕获细粒度的局部特征,而后两个阶段采用Global SwinMamba Blocks,旨在整合更广泛的上下文信息。每个阶段利用渐进式下采样,将输入图像从的大小转换为具有降低的空间分辨率和增加的通道深度的特征图。具体而言,此过程生成大小为、、以及最终为的特征图,如图2所示。这种分层设计使模型能够有效平衡详细局部结构的提取和全面全局上下文的整合,这是实现高精度语义分割的关键因素。解码器利用最先进的UperNet,通过聚合多尺度特征来产生最终的分割结果。
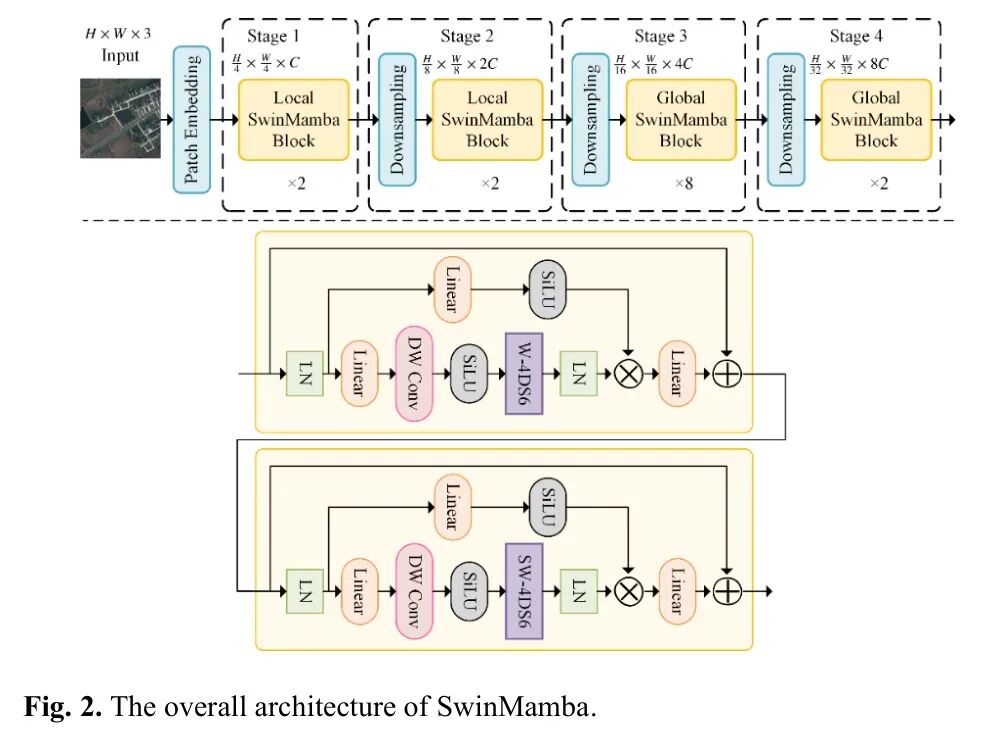
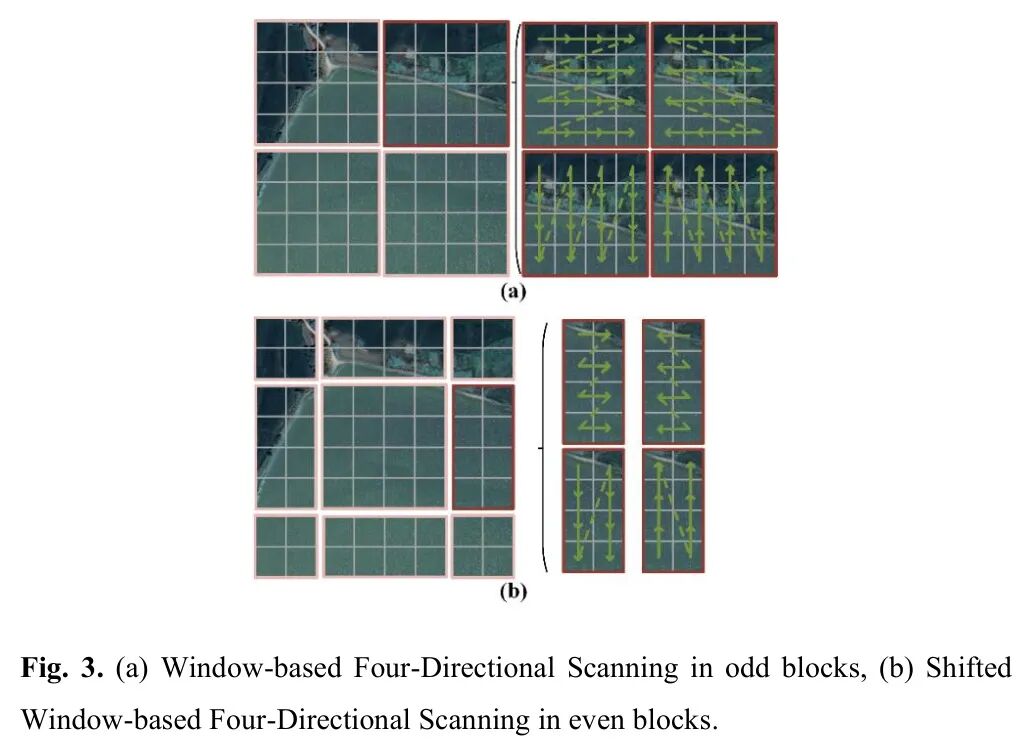
Local SwinMamba Block采用双配置策略以高效处理空间信息。如图2所示,奇数块实现Window-based Four-Directional Scanning S6 (W-4DS6)计算,将特征图划分为不重叠的窗口。紧接着是偶数块,它们采用Shifted Window-based FourDirectional Scanning S6 (SW-4DS6)方法,其中窗口被移位以创建与前一个窗口的重叠区域。这种交替机制增强了模型捕获细粒度局部细节和跨区域依赖的能力。
在W-4DS6配置中(如图3(a)所示),输入特征图F ∈ R×H×W被划分为大小为的不重叠矩形窗口:
其中表示窗口的数量,并表示批量大小。在每个窗口 内,一个覆盖水平和垂直方向的四向扫描过程将2D特征图转换为1D序列:
这些序列随后通过S6计算进行处理,这是Mamba架构[12]的一个特征,它以线性复杂度高效地建模依赖关系:
其中表示模型参数。
在SW-4DS6配置(如图3(b)所示)中,窗口边界在偶数块中移动,重新定义分区以覆盖相邻区域。特征图首先沿着空间维度移动距离:
位移后的特征图然后被分割成窗口并进行类似处理:
这种移动方案促进了窗口之间的信息交换,将四向扫描和S6计算应用于新划分的区域。
与通过 Mask 和连接来优化移位窗口自注意力的Swin Transformer不同,Mamba架构中的S6计算由于其顺序处理范式而固有地适应任意矩形形状。这消除了对额外优化策略的需求,能够在不同窗口配置下实现无缝的四向扫描。
在前两个阶段(即Local SwinMamba Block)进行下采样后,进入第三和第四阶段的输入特征图的形状分别为。在这两个阶段,特征图的空间维度显著减少,导致特征图内的单个区域变大。因此,Global SwinMamba Block放弃了Local SwinMambaBlock中使用的窗口分区方法,而是直接对特征图应用全局四向扫描策略:
生成的序列通过S6模块进行处理:
该过程将特征图转换为沿水平和垂直方向扫描的序列,随后由S6计算高效处理这些序列,以捕获整个图像中的全局依赖关系和上下文关系。
为了全面评估SwinMamba架构的有效性,作者选择了两个经典的遥感语义分割数据集:LoveDA [3]和ISPRS Potsdam。在作者的实验中,数据集配置与其他研究中使用的配置保持一致。
LoveDA数据集包含2,522张训练图像,1,669张验证图像和1,796张测试图像。每张图像由像素和三通道RGB构成,并具有0.3米的空间分辨率。该数据集包括七个类别:背景、建筑、道路、水体、荒地、森林和农田。
ISPRS Potsdam数据集包含38幅高分辨率遥感图像,每幅图像的空间分辨率为,尺寸为像素。这些图像包括近红外、红、绿和蓝通道;然而,在作者的实验中,仅使用了红、绿和蓝通道。该数据集包含六个类别:不透水面、建筑物、低矮植被、树木、汽车和杂乱物体。值得注意的是,杂乱物体类别被排除在验证指标的计算之外。ID为2_10, 2_11, 2_12, 3_10, 3_11, 3_12, 4_10, 4_11, 4_12, 5_10, 5_11, 5_12, 6_07, 6_08, 6_09, 6_10, 6_11, 6_12, 7_07, 7_08, 7_09, 7_10, 7_11和7_12的图像用于训练,而ID为2_13, 2_14, 3_13, 3_14, 4_13, 4_14, 4_15, 5_13, 5_14, 5_15, 6_13, 6_14, 6_15和7_13的图像则用于验证。
在遵循编码器-解码器范式的SwinMamba架构中,预训练编码器是优化其在遥感图像下游语义分割性能的关键步骤。在大规模数据集上进行预训练使模型能够学习鲁棒的、可迁移的表示,这些表示能够捕捉通用视觉模式,从而减轻遥感等专业领域中 Token 数据有限带来的挑战。考虑到遥感图像的高分辨率和多光谱特性,这一点尤为重要,因为从头开始直接训练往往会导致过拟合或次优收敛。为此,作者在ImageNet1k数据集上对SwinMamba编码器进行了预训练,该基准数据集包含约128万张跨越1000个类别的训练图像,被广泛认为在培养强大的特征提取器方面非常有效。预训练阶段的分类性能指标如表1所示。
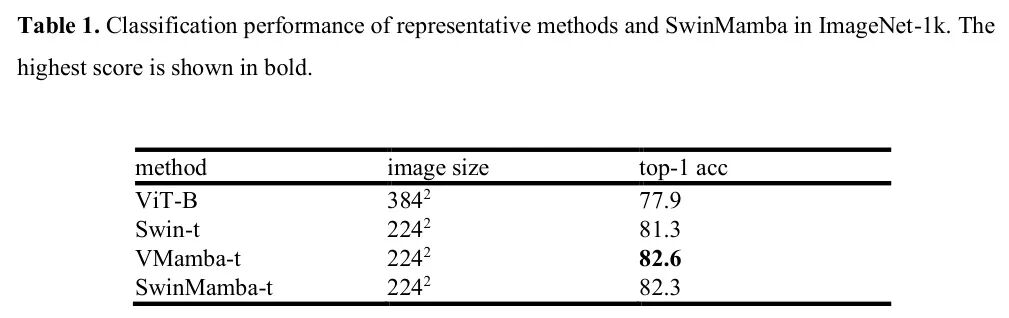
正如预期的那样,与 Baseline VMamba模型相比,SwinMamba在图像分类性能上表现出轻微下降,该 Baseline 模型达到了的top1准确率。这的轻微下降既是预期的也是合理的。VMamba的设计在每个模块中都利用了全局扫描机制,该机制通过统一的序列转换过程有效地捕获整个图像中的全面token交互。这种全局方法对于图像分类任务本质上是有利的,因为在图像分类中,整体场景理解通常比局部细节更重要,而局部和全局信息的平衡加权则不那么关键。相比之下,SwinMamba的扫描策略通过基于窗口的分区和移位机制故意优先考虑局部token交互,这可能不完全符合倾向于立即聚合全局上下文的分类需求。然而,这种有意的设计选择强调了SwinMamba对语义分割的优化,在语义分割中,专注于局部特征提取(如边缘、纹理和细粒度边界)对于复杂遥感场景中的精确像素级预测至关重要。
4.3 实验设置
在本研究中,作者将作者的SwinMamba与几种代表性的最先进的全监督语义分割方法进行比较。这些包括基于CNN的方法,如ConvNeXt [35]和ResNet [36],基于Vision Transformer (ViT)的方法,如CMTFNet [37]、UNetformer [38]、Swin Transformer [22]和Segformer [29],以及最新的基于Mamba的方法,RS3Mamba [1]和VMamba [16]。这些 Baseline 方法的配置遵循广泛接受的最优设置。作者使用AdamW优化器,学习率为0.00006,每GPU批处理大小为8,总共进行15,000次迭代的训练。在前两个阶段,窗口大小设置为14,移动距离为7。为了评估所提出方法的有效性,作者采用了最常用的指标mIoU。CMTFNet、UNetformer和RS3Mamba在LoveDA和Potsdam数据集上的分割结果如[1]和[39]中所报告。
此外,作者对SwinMamba和其他代表性方法在LoveDA和Potsdam数据集上生成的几个示例语义分割结果进行了可视化分析,如图4所示。与 Baseline 方法相比,SwinMamba在减轻假阴性和假阳性等错误方面表现出优越的性能。
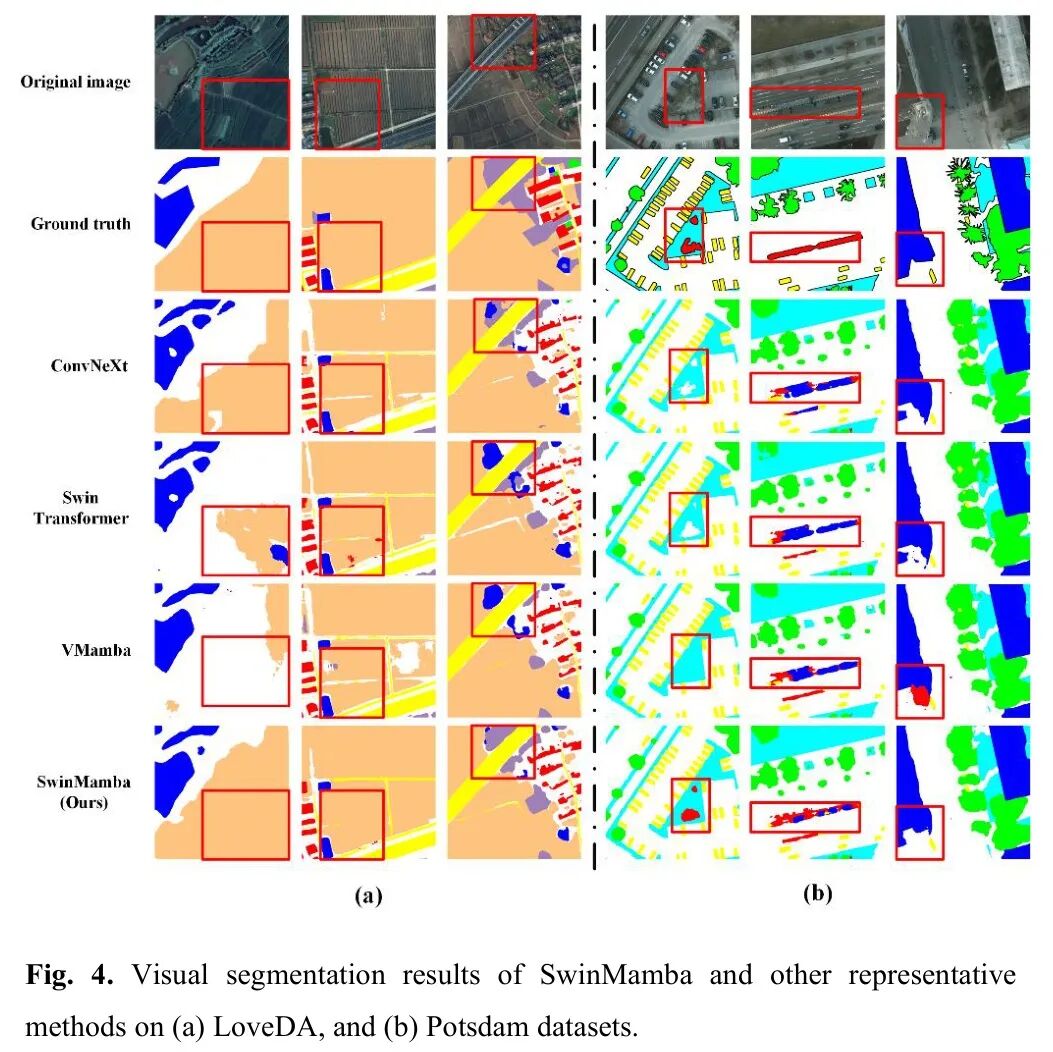
具体来说,在LoveDA数据集的第一张图像(图4(a)中最左侧)中,SwinMamba准确捕获了代表农业类别的大部分区域(以橙色[255, 195, 128]表示),如红色方框区域所突出显示的。然而,其他测试网络对此类别表现出不同程度的漏检,其中 Baseline VMamba显示出最严重的遗漏。类似地,第二张图像中红色方框区域的农业类别几乎完全被SwinMamba预测出来,优于其他测试方法。在第三张图像中,红色方框内的荒地类别(以紫灰色[149, 129, 183]表示)再次被SwinMamba最佳分割,而其他网络倾向于将该区域误分类为水域(以蓝色[0, 0, 255]表示)。
在Potsdam数据集上,第一张图像(图4(b)中最左侧)中红色框选区域对应于杂波类别(以红色[255, 0, 0]表示),该类别仅被SwinMamba正确分类。同样,在第二张图像中,其他网络倾向于将红色框选区域内的杂波错误分类为建筑物(以蓝色[0, 0, 255]表示)。在第三张图像中,SwinMamba对建筑物类别实现了更准确的边界描绘,而其他方法则表现出各种分割错误。显然,由于其局部-全局架构设计,SwinMamba提供了更精细的局部感知,与 Baseline 方法相比,实现了更优的边界描绘和类别分类。
为了验证SwinMamba中扫描策略的有效性,其中前两个阶段采用局部扫描,后两个阶段采用全局扫描,作者进行了一系列比较实验。这些实验评估了三种配置:(1)所有四个阶段都使用全局扫描,(2)所有四个阶段都使用局部扫描,以及(3)混合配置,即前两个阶段使用局部扫描,后两个阶段使用全局扫描。值得注意的是,对于在所有阶段都使用局部扫描的配置,由于空间维度减少,窗口大小14在最后阶段是不可行的;因此,作者将其调整为7。如表4所示的实验结果表明,作者采用的混合扫描策略在LoveDA和ISPRS Potsdam数据集上都实现了最高的mIoU。其次是全局部扫描配置,而全全局扫描配置表现最差。这些发现强调了分阶段整合局部细节保留和全局上下文理解的优势。
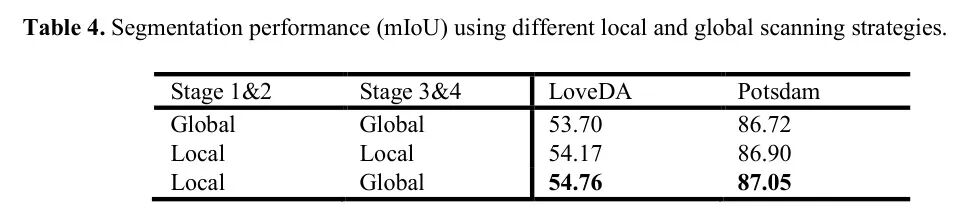
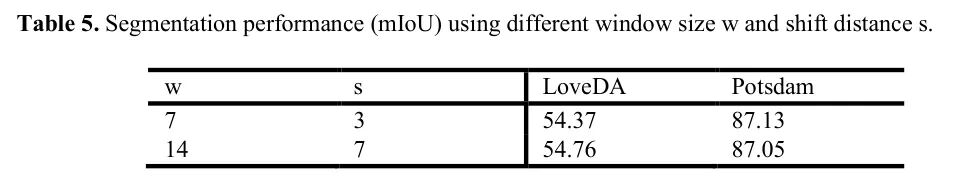
此外,作者进行了消融实验以评估窗口大小和移位距离的影响,比较了两种设置:(1) 窗口大小为14,移位距离为7;(2) 窗口大小为7,移位距离为3。如表5所示,这些参数对整体性能的影响微乎其微。在LoveDA数据集上,窗口大小为14的设置在mIoU上略微优于窗口大小为7的设置,高出;而在Potsdam数据集上,窗口大小为7的设置优于窗口大小为14的设置,高出。考虑到这些微小的差异和计算效率,作者最终选择了窗口大小为14的配置。这些发现证实了混合扫描方法的鲁棒性及其在遥感语义分割任务中跨不同超参数设置的适应性。
在本研究中,SwinMamba在遥感图像语义分割方面取得了显著进展,特别是通过其创新性地整合局部Mamba扫描与移位窗口机制。通过在早期阶段采用局部扫描以捕获细粒度细节,并在后期阶段过渡到全局扫描以实现全面的上下文融合,SwinMamba有效解决了遥感数据中固有的多尺度挑战。作者在LoveDA和ISPRS Potsdam数据集上的实证评估显示出mIoU的持续改进,不仅验证了作者混合扫描策略的有效性,还突显了其在不同数据集上的鲁棒性,将SwinMamba定位为遥感应用未来研究的一个有前景的基准。
尽管取得了这些成就,但仍有几个局限性值得讨论。首先,在局部扫描阶段对预定义窗口大小的依赖可能会限制对具有极端分辨率变化的数据集的适应性,在这种情况下需要手动调整滑动窗口大小和移动距离,例如在目标尺度变化极大的超高分辨率卫星图像中。此外,虽然局部分区策略显著提高了下游语义分割任务的性能,但它轻微削弱了图像分类的结果,如表1所示。减轻局部区域分区对全局图像理解的影响仍是一个需要考虑的领域,特别是在整体场景理解至关重要的场景中。
展望未来,未来的工作可以通过探索几个途径来增强SwinMamba的能力。一个有前景的方向是效率优化。作者的区域划分策略生成的子区域中,大多数表现出一致的token长度,使得可以在这些均匀片段上进行并行计算,与VMamba的全局扫描方法相比,这可能会显著提高效率,因为VMamba的方法排除了这种并行性。尽管作者当前的实现在工程意义上没有充分利用这一潜力,但未来的工作可以结合GPU加速并行技术,如分布式张量处理,来实现这些优势,并减少大规模遥感处理流程中的推理时间。此外,如第2.2节所述,移位窗口划分产生了具有不同token长度的子区域;虽然Mamba的S6计算无需额外调整就能适应任意长度,但作者可以从Swin Transformer的token连接和 Mask 策略中汲取灵感,以标准化序列长度,开发S6特定的 Mask 机制,进一步增强并行性,促进更均匀和高效的计算。此外,未来的工作可以考虑窗口大小和移位距离的自适应机制,以消除它们作为外部超参数。最后,在实时系统中部署SwinMamba,如用于灾害监测的边缘设备,将需要模型压缩技术,如剪枝或量化,以确保可扩展性,同时保持分割精度。这些探索不仅将完善SwinMamba,还将推动遥感语义分割领域的更广泛进展。
本文中,作者提出了SwinMamba,该模型将移位窗口内的局部Mamba风格扫描与全局感受野相结合,以显著增强遥感图像语义分割中的局部和全局特征提取。在LoveDA和ISPRS Potsdam数据集上进行的实验表明,与几种最先进的方法相比,它具有优越的性能,验证了其有效性。
虽然SwinMamba在多尺度特征融合方面表现出色,但其预定义的窗口大小可能限制了对极端分辨率的适应性,而移位分区可能会引入轻微的计算开销。这些权衡突显了进一步改进的机会。
未来的工作可以通过诸如统一token长度子区域的GPU加速并行化和S6特定 Mask 来标准化序列等方法优先提高效率。此外,未来的工作可以将模型扩展到多模态数据融合和自适应窗口机制,进一步扩大其在实时遥感任务中的适用性,同时保持其在分割精度方面的性能。
[1]. SwinMamba: A hybrid local-global mamba framework for enhancing semantic segmentation of remotely sensed images
点击上方卡片,关注「AI视界引擎」公众号