NeuTTS Air来袭!高拟真语音合成,极速克隆音色,本地运行更安全
在人工智能技术飞速发展的当下,语音合成(TTS)技术正逐渐渗透到我们生活的各个角落。从智能语音助手到各种互动娱乐应用,TTS模型为人们带来了更加便捷和自然的交互体验。然而,大多数高质量的TTS模型都依赖于云端计算,这不仅限制了其在离线环境中的应用,还可能引发数据隐私和安全问题。NeuTTS Air的出现,打破了这一局限,为TTS技术的发展开辟了新的道路。
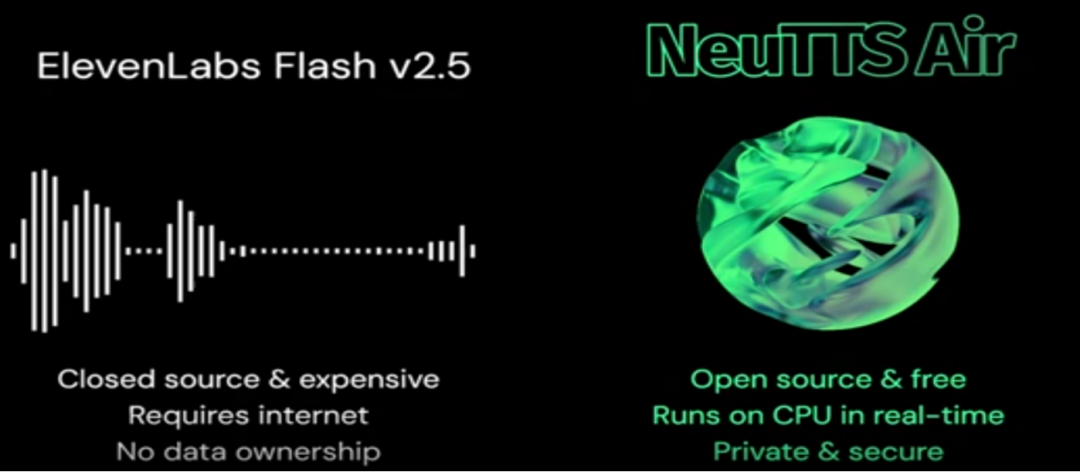
NeuTTS Air是由Neuphonic开发的一款超拟真、可离线运行的文本到语音(TTS)模型。它以0.5B参数的Qwen语言模型为基础,结合自研的NeuCodec音频编解码器,实现了在本地设备上的高效语音合成。NeuTTS Air不仅能够生成自然流畅、接近真人的语音,还具备即时语音克隆功能,仅需3秒音频样本即可精准复刻说话者的声音。其紧凑的架构设计使其在性能、速度和质量之间达到了绝佳的平衡,能够在中端设备上实现实时推理,广泛应用于离线语音助手、智能玩具、本地AI Agent嵌入式语音接口、游戏与互动角色配音以及对隐私敏感的医疗、司法、教育等领域。
(一)高拟真语音合成
NeuTTS Air生成的语音具有良好的韵律、停顿和音色连续性,其自然度在同类尺寸模型中表现出色,相比传统拼接式或参数化TTS,其输出更少机械感,更适合需要“拟人化”表达的应用。在社区演示中,其自然度的MOS评分约为4.2-4.5(满分5分),与Google WaveNet在1/10大小下相当。
(二)离线运行支持
模型以GGML格式提供,专为CPU推理和低内存环境设计,可在多种设备上运行,包括智能手机(Android/iOS)、笔记本电脑(x86/ARM)、树莓派、Jetson等嵌入式平台。无需GPU加速,也不依赖持续网络连接,真正实现“端侧闭环”,特别适用于网络覆盖不足或对数据安全有高要求的场景。
(三)即时语音克隆
通过一段简短的参考音频(如3秒说话录音),NeuTTS Air可快速提取声纹特征,生成带有个人音色的语音输出。这一功能可用于创建个性化语音助手、辅助沟通设备(如为语言障碍者定制声音)、教育类交互产品等。使用3秒参考音频,通过嵌入上的余弦距离测量的说话人相似性达到85-90%;使用15秒输入可提高到95%以上。
(四)轻量级架构
NeuTTS Air采用简洁高效的两段式架构,即基于LM + Codec的混合架构。Qwen 0.5B语言模型负责文本理解与音素预测,具备轻量但具备上下文建模能力;NeuCodec编解码器则将隐变量流解码为高保真音频,使用单码本实现低比特率下的优质还原。这种设计在模型大小、推理速度与语音质量之间取得了实用平衡,避免了大模型带来的部署难题。
(五)隐私保护
NeuTTS Air的所有处理过程均在本地完成,无需将数据上传至云端,从而确保了用户隐私不受侵犯和数据安全可靠。此外,生成的语音结果内置水印,这不仅确保了其可溯源性,也保障了合规使用。
(六)多平台兼容
NeuTTS Air支持多种操作系统和设备平台,包括移动设备、个人电脑、树莓派等,易于集成到各种应用中。
(七)实时推理能力
在中端设备上,NeuTTS Air可实现实时语音合成,满足即时交互应用需求。例如,在CPU上(如Intel i5或ARM-based Raspberry Pi 5)实时因子(RTF)<0.5,以约50个标记/秒生成24kHz音频;在中等笔记本电脑上,完整句子的合成时间不到1秒。
(一)基于LM + Codec的混合架构
NeuTTS Air巧妙地结合了语言模型(LM)和音频编解码器(Codec)的优势,实现了高效且高质量的文本到语音转换。这种混合架构充分发挥了语言模型在文本理解方面的强大能力,以及音频编解码器在音频生成方面的高效性,从而在保证语音质量的同时,提高了模型的运行效率。
(二)语言模型优化
NeuTTS Air采用了Qwen 0.5B语言模型,该模型经过深度优化,显著提升了文本的理解能力和语音生成的自然度与准确性。通过优化文本理解与生成,Qwen 0.5B语言模型能够更好地捕捉文本中的语义信息,从而生成更加自然流畅的语音。
(三)自研NeuCodec音频编解码器
NeuCodec是Neuphonic自主研发的单码本结构音频编解码器,能够实现高保真且低码率的音频生成。在最小感知损失(PESQ >3.5在干净语音上)下,NeuCodec可实现0.8kbps压缩,优于传统编解码器如Opus在神经任务中的表现。这使得NeuTTS Air能够在保持高质量语音输出的同时,降低模型的存储和计算需求。
(四)GGML格式支持
NeuTTS Air提供GGML格式,使得模型能够在多种平台(如CPU、移动端)上高效运行。GGML格式的采用,不仅提高了模型的兼容性,还进一步优化了模型在不同设备上的运行效率。
(五)实时推理优化
通过精细的功耗优化,NeuTTS Air确保在中端设备上也能实现实时语音合成。这种优化不仅涉及到模型结构的调整,还包括对硬件资源的合理利用,从而在保证实时性的同时,降低了模型的功耗。
(六)语音克隆技术
NeuTTS Air的语音克隆技术利用极少量的音频样本(仅需3秒),即可快速准确地克隆出说话者的声音。这一技术的核心在于对音频特征的有效提取和建模,使得模型能够快速适应不同的说话者。
(一)离线语音助手
在没有网络连接的环境中,NeuTTS Air可为用户提供语音交互服务,如智能家居控制、车载语音助手等。其离线运行能力和高拟真语音合成效果,能够为用户提供更加自然和便捷的交互体验。
(二)智能玩具
NeuTTS Air能够为儿童玩具提供自然语音交互,增强玩具的趣味性和互动性。通过即时语音克隆功能,玩具还可以根据孩子的声音进行个性化回应,进一步提升孩子的参与感。
(三)本地AI Agent
作为本地运行的AI助手的语音接口,NeuTTS Air提供更安全、私密的语音交互体验。其隐私保护功能确保了用户的语音数据不会泄露,适用于对数据安全要求较高的场景。
(四)游戏与互动娱乐
在游戏和互动娱乐应用中,NeuTTS Air可用于为游戏角色和互动场景生成个性化语音。其高拟真语音合成效果和实时推理能力,能够为用户带来更加沉浸式的体验。
(五)隐私敏感领域
在医疗、司法、教育等对数据隐私要求高的场景中,NeuTTS Air的本地处理和隐私保护功能使其成为理想的语音解决方案。其内置水印机制进一步确保了语音数据的可溯源性和合规性。
(六)移动设备应用
NeuTTS Air在手机、平板等移动设备上,为各种应用提供离线语音功能。其优化的功耗和实时推理能力,使其能够在移动设备上高效运行,减少对网络的依赖。
(一)环境准备
1. 克隆Git仓库
首先,需要从GitHub克隆NeuTTS Air的仓库。
git clone https://github.com/neuphonic/neutts-air.gitcd neutts-air
2. 安装`espeak`
`espeak`是NeuTTS Air运行所需的一个依赖项。根据操作系统选择相应的安装方式:
Mac OS:
brew install espeakUbuntu/Debian:
sudo apt install espeakWindows:Windows用户可能需要运行以下命令(参考[bootphon/phonemizer#163](https://github.com/bootphon/phonemizer/issues/163)):
$env:PHONEMIZER_ESPEAK_LIBRARY = "c:\Program Files\eSpeak NG\libespeak-ng.dll"$env:PHONEMIZER_ESPEAK_PATH = "c:\Program Files\eSpeak NG"setx PHONEMIZER_ESPEAK_LIBRARY "c:\Program Files\eSpeak NG\libespeak-ng.dll"setx PHONEMIZER_ESPEAK_PATH "c:\Program Files\eSpeak NG"
3. 安装Python依赖
安装运行模型所需的Python依赖项。NeuTTS Air支持`python>=3.11`。
pip install -r requirements.txt4. (可选)安装`llama-cpp-python`
如果需要使用GGUF格式的模型,则需要安装`llama-cpp-python`。
pip install llama-cpp-python5. (可选)安装`onnxruntime`
如果需要使用`.onnx`格式的解码器,则需要安装`onnxruntime`。
pip install onnxruntime(二)基本使用示例
运行以下命令,使用NeuTTS Air合成语音:
python -m examples.basic_example \--input_text "My name is Dave, and um, I'm from London" \--ref_audio samples/dave.wav \--ref_text samples/dave.txt
(三)代码块使用示例
以下是一个简单的Python代码示例,展示如何使用NeuTTS Air生成语音:
from neuttsair.neutts import NeuTTSAirimport soundfile as sf# 初始化NeuTTSAir模型tts = NeuTTSAir(backbone_repo="neuphonic/neutts-air-q4-gguf", # 使用GGUF格式的模型backbone_device="cpu", # 在CPU上运行codec_repo="neuphonic/neucodec", # 使用NeuCodec编解码器codec_device="cpu" # 在CPU上运行)# 输入文本input_text = "My name is Dave, and um, I'm from London."# 参考文本和音频ref_text = "samples/dave.txt"ref_audio_path = "samples/dave.wav"# 读取参考文本ref_text = open(ref_text, "r").read().strip()# 编码参考音频ref_codes = tts.encode_reference(ref_audio_path)# 生成语音wav = tts.infer(input_text, ref_codes, ref_text)# 保存生成的语音文件sf.write("test.wav", wav, 24000)
(四)流式合成
NeuTTS Air还支持流式合成模式,音频会随着生成而逐块输出。这需要安装`pyaudio`库。运行以下命令:
python -m examples.basic_streaming_example \--input_text "My name is Dave, and um, I'm from London" \--ref_codes samples/dave.pt \--ref_text samples/dave.txt
(五)准备参考音频
NeuTTS Air的语音克隆功能需要以下两个输入:
1. 参考音频样本(`.wav`文件)
2. 文本字符串
模型会根据参考音频的风格合成输入文本的语音,从而实现即时语音克隆功能。为了获得最佳效果,参考音频样本应满足以下条件:
1. 单声道
2. 采样率为16-44kHz
3. 时长为3-15秒
4. 保存为`.wav`文件
5. 清晰,背景噪音尽可能少
6. 自然连续的语音,如独白或对话,停顿较少,以便模型能够有效捕捉语调
NeuTTS Air作为一款超拟真、可离线运行的TTS模型,凭借其强大的语音合成能力、即时语音克隆功能以及轻量级架构,为TTS技术的发展带来了新的突破。它不仅满足了离线环境下的语音交互需求,还为隐私保护和数据安全提供了有力保障。无论是应用于智能家居、智能玩具、本地AI Agent,还是游戏与互动娱乐等领域,NeuTTS Air都展现出了巨大的应用潜力。
GitHub仓库:https://github.com/neuphonic/neutts-air
Hugging Face模型库:https://huggingface.co/neuphonic/neutts-air
点亮“关注”,设为“星标”,精彩不迷路!与你携手探索AI的无限可能,精彩内容持续更新!🚀