YOLOv5、Faster R-CNN、SSD 和RetinaNet在基加利自动驾驶环境中检测的比较分析!
点击下方卡片,关注「AI视界引擎」公众号
在卢旺达等发展中国家,摩托车出租车(当地称为"moto taxis")主导着城市交通,特别是在基加利。这些车辆经常无视交通规则,在车流中穿行,为自动驾驶车辆和机器人创造了动态且不可预测的环境。
在这样的条件下,稳健的目标检测对于确保安全导航至关重要。本研究评估了四种最先进的模型——YOLOv5 [1]、Faster R-CNN [2]、SSD [3]和RetinaNet [4]——用于摩托车检测,使用了一个在基加利收集的198张图像的自定义数据集,该数据集以COCO格式进行了标注。这些模型在PyTorch中通过迁移学习实现,并进行了比较,以确定在资源受限的非洲城市中自动驾驶的最佳解决方案。
作者的贡献是:
YOLOv5、Faster R-CNN、SSD和RetinaNet在基加利城市环境中摩托车检测的比较分析
识别挑战,包括数据集限制和模型特定复杂性,与发展中国家相关
关于简化架构的建议以增强资源有限环境中自主系统的可访问性
非洲的自动驾驶面临独特挑战,这源于摩托车的普遍存在,特别是在基加利等城市中心。像[6]这样的研究强调了需要强大的检测系统来处理不合规的摩托车出租车,这些出租车通常以不可预测的方式行驶。内罗毕的研究[7]强调了在拥挤、混合交通环境中检测两轮车辆的复杂性。关于非洲道路安全的现有工作[8]指出,摩托车在交通事故中占有重要比例,因此自动驾驶需要精确的检测能力。
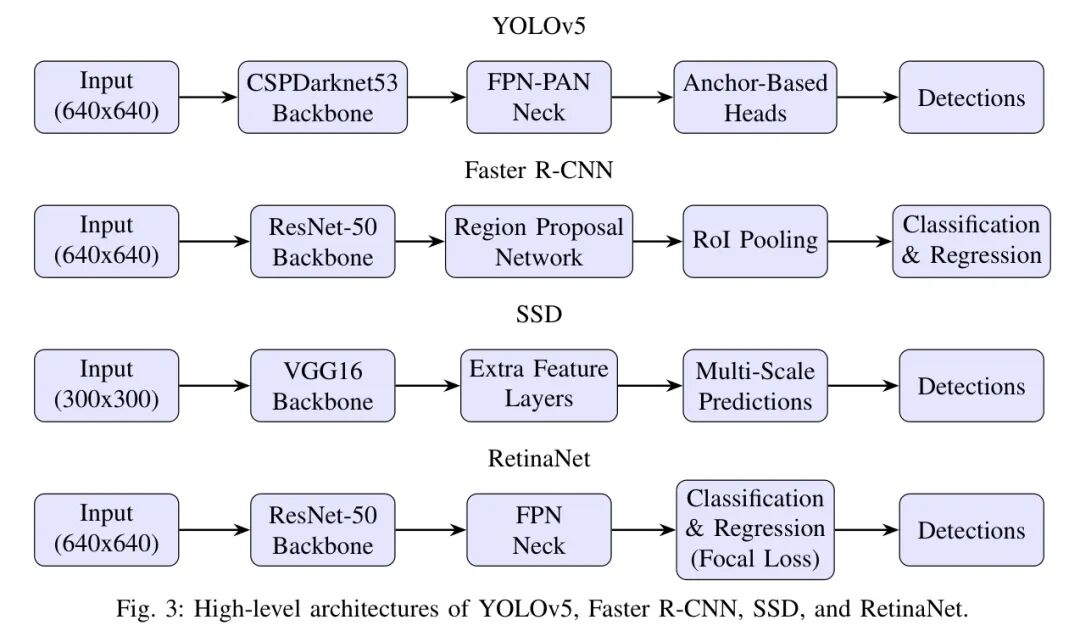
目标检测模型分为两阶段(如Faster R-CNN [2])和单阶段(如YOLO [5]、SSD [3]、RetinaNet [4])。Faster R-CNN使用ResNet Backbone 网络和区域 Proposal 网络(RPN)以实现高精度[2]。
YOLOv5采用CSPDarknet53和FPN-PAN以平衡速度和精度[1]。SSD利用VGG16实现快速检测[3],而RetinaNet引入Focal Loss来解决类别不平衡问题[4]。自定义实现通常在复杂解码和损失函数方面面临挑战,特别是在计算基础设施有限的资源受限环境中。
在卢旺达等中低收入国家(LMICs)部署High-Level驾驶辅助系统(ADAS)和自动驾驶汽车(AVs)面临着独特的挑战,尤其是在以摩托车出租车为主体的基加利非结构化城市交通环境中。本节详细阐述了摩托车检测的背景必要性、架构权衡和技术挑战,重点关注小目标检测(SOD)、遮挡问题和边缘部署。
A. 上下文必要性:非结构化交通中的摩托车检测
基加利交通的特点是高度异质性和不可预测性,摩托车、行人和车辆的混合交通流在通常缺乏标准化标志或车道 Token 的道路上行驶[9]。与西方基准(如KITTI,nuScenes)不同,基加利的环境要求检测算法在可变条件下处理多样化的物体类别[10]。
摩托车作为弱势道路使用者,因其体积小、移动速度快且经常被遮挡,构成了安全关键挑战[11]。准确的检测和定位对于实时交通监控和拥堵管理至关重要[12]。卢旺达开创性的自动速度执法(ASE)系统于2021年在全国范围内推广,通过降低平均速度减少了与碰撞相关的死亡人数[13],[14],为先进的计算机视觉系统提供了政策基础[15]。
目标检测模型平衡准确性和推理速度,这对基加利动态交通环境中的ADAS至关重要。
两阶段检测器:Faster R-CNN:Faster R-CNN的两阶段处理过程,包括区域 Proposal 网络(RPN)和后续分类,在密集场景的定位精度 方面表现出色[2], [16]。然而,其计算复杂度限制了实时应用性,除非通过轻量级 Backbone 网络(如Res2Net-101)或量化[17], [18]进行优化。
单阶段检测器:单阶段检测器优先考虑速度。YOLOv5的CSPDarknet主干网络、FPN-PAN Neck 和Mosaic增强技术提供了稳健的速度-准确性平衡,其灵活的模型尺寸(如YOLOv5s)适合边缘部署[1], [19]。
SSD的VGG16主干网络支持快速推理,但由于浅层中有限的语义深度而在小目标检测方面存在困难[3], [20]。特征融合SSD (FSSD)通过增强特征图来缓解这一问题[20]。RetinaNet的Focal Loss解决了类别不平衡问题,使其对Sparse、被遮挡的摩托车检测有效,FPN确保了多尺度检测[4]。
基加利的摩托车检测需要解决小目标检测 (SOD) 和遮挡问题。SOD 具有挑战性,这源于其低像素覆盖率,以及在下采样过程中的特征退化 [21]。增强的 FPNs 和注意力机制(例如,AFYOLO 中的通道和空间注意力)改善了针对小目标的特征提取 [22]。遮挡,在密集交通中很常见,可以通过双流网络中的上下文特征融合以及来自光流的运动线索来缓解 [23], [24]。
基加利的实时ADAS需要适用于NVIDIA Jetson等边缘设备的轻量级模型。量化为8位整数可以减少内存占用和延迟,使SSD MobileNetV2能够在Jetson Orin Nano上实现低延迟[25]。剪枝和知识蒸馏进一步优化模型[26]。YOLOv5的生态系统支持快速边缘部署,而Faster R-CNN和RetinaNet需要激进的优化才能满足实时FPS阈值[19], [27]。
在基加利收集了一个包含198张摩托车图像的数据集,捕捉了诸如拥堵交通、夜间条件和不合规的摩托车出租车等场景。图像通过Roboflow以COCO格式进行标注,并分割为:
训练集:168张图像(244个标注)• 验证集:20张图像(48个标注)
测试集:10张图像(30个标注)
预处理涉及JSON到DataFrame的转换、边界框验证(排除了三张无效图像)以及方向标准化(旋转了13张横向图像)。小数据集规模限制了泛化能力,如第七节所讨论的。
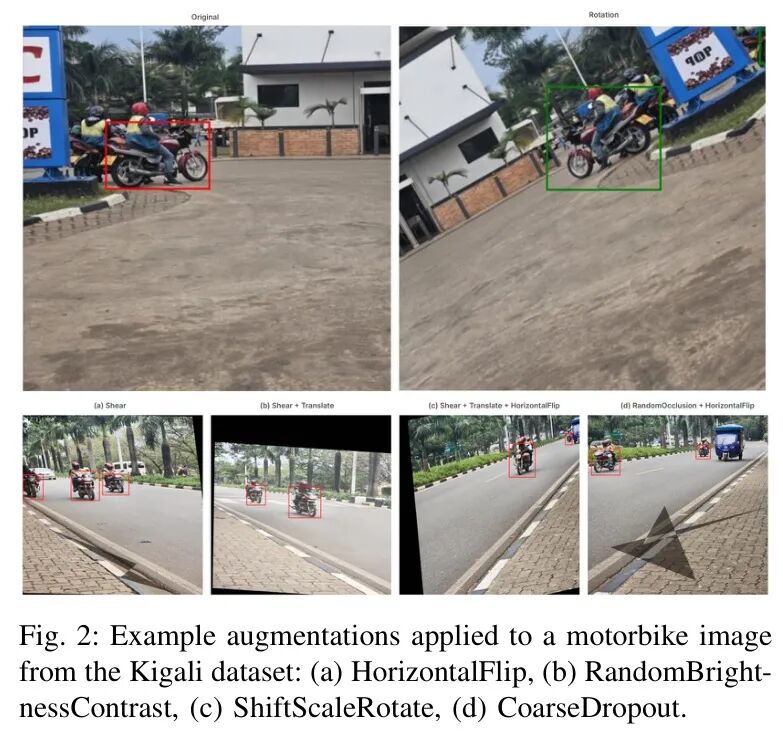
为了增强鲁棒性,应用了针对每个模型量身定制的数据增强。YOLOv5使用了HorizontalFlip 和ColorJitter (brightnes , contras , saturation )。Faster R-CNN应用了HorizontalFlip 和ColorJitter。SSD采用了HorizontalFlip 、RandomBrightnessContrast 、ColorJitter和GaussianNoise (variance 5–20)。RetinaNet使用了HorizontalFlip 、RandomBrightnessContrast 、RandomRotate90 、ShiftScaleRotate 、RGBShift 和CoarseDropout。图2展示了应用于摩托车图像的数据增强示例,其中包含COCO格式的边界框。
所有模型均在PyTorch中使用torchvision实现,并采用迁移学习,利用预训练权重以适应Kigali数据集。图3展示了它们的架构。
YOLOv5:官方YOLOv5s模型[1],通过torchvision实现,使用了COCO预训练权重(yolov5s.pt)。尝试了自定义实现,复制了CSPDarknet53 Backbone 网络、FPN-PAN Neck 和基于 Anchor 点的检测Head,但由于训练有限(5个epoch)而失败(),如第六节所讨论。官方模型在双T4 GPU上进行了100个epoch的微调。
Faster R-CNN: Faster R-CNN [2],通过torchvision实现并使用COCO预训练的ResNet-50-FPN权重,采用预热策略进行了55个epoch的微调。
SSD: SSD300 [3],通过torchvision实现并使用ImageNet预训练的VGG16权重,被修改用于2类预测,并进行了10个周期的微调。
RetinaNet: RetinaNet [4]通过torchvision实现,使用COCO预训练的ResNet-50-FPN权重,针对2个类别更新 Head 后进行了22个周期的微调。
YOLOv5的高mAP(0.5223)和FPS(24.7)使其适用于基加利的实时导航。RetinaNet的定位能力(mAP 0.6013,IoU 0.8122)对安全至关重要,Faster R-CNN提供高精确度(0.8837),而SSD则优先考虑速度(49.67 FPS)。
数据集的局限性和模型的复杂性凸显了对更大数据集和优化架构的需求,以确保在基加利实现安全的自主导航。
[1]. Comparative Analysis of YOLOv5, Faster R-CNN, SSD, and RetinaNet for Motorbike Detection in Kigali's Autonomous Driving Context
点击上方卡片,关注「AI视界引擎」公众号