音乐创作者的福音!SongBloom:腾讯AI Lab开源的全长度歌曲生成模型
在人工智能与音乐创作融合的浪潮中,歌曲生成技术正逐渐成为音乐创作领域的一股新力量。腾讯AI Lab 联合香港中文大学(深圳)、南京大学,共同研发了一款创新的歌曲生成模型——SongBloom。该模型凭借其独特的技术架构和出色的表现,为音乐创作带来了全新的可能性,也推动了 AI 音乐生成技术的发展。
SongBloom 是一个由腾讯 AI Lab 联合顶尖高校研发的开源歌曲生成模型。它采用自回归扩散模型,将扩散模型的高保真度与语言模型的可扩展性相结合,通过交错生成范式,逐步将音乐草图从短到长进行扩展,并将细节从粗粒度提升到细粒度。仅需输入 10 秒参考音频和对应歌词,SongBloom 即可生成长达 2 分 30 秒的双通道、48kHz 高质量完整歌曲。在主观和客观评测中,SongBloom 均优于现有开源方法,并与顶尖商业平台 Suno-v4.5 相当。
1. 高效歌曲生成:SongBloom 能够快速生成完整歌曲,支持双通道、48kHz 高质量音频输出。
2. 创新生成范式:采用交错生成技术,结合自回归草图绘制和基于扩散的细化,交替生成语义和声学上下文。
3. 卓越音质与准确性:在音频质量和歌词准确性方面表现出色,接近领域最佳水平(SOTA),超越现有开源模型。
4. 开源与易用性:项目已开源,提供详细指南和多种模型版本,支持低显存设备运行,方便用户快速上手。
5. 广泛的应用前景:为音乐创作、音频制作等领域提供了强大的工具,能够显著提升创作效率,激发音乐创作的新灵感。
(一)交错生成范式
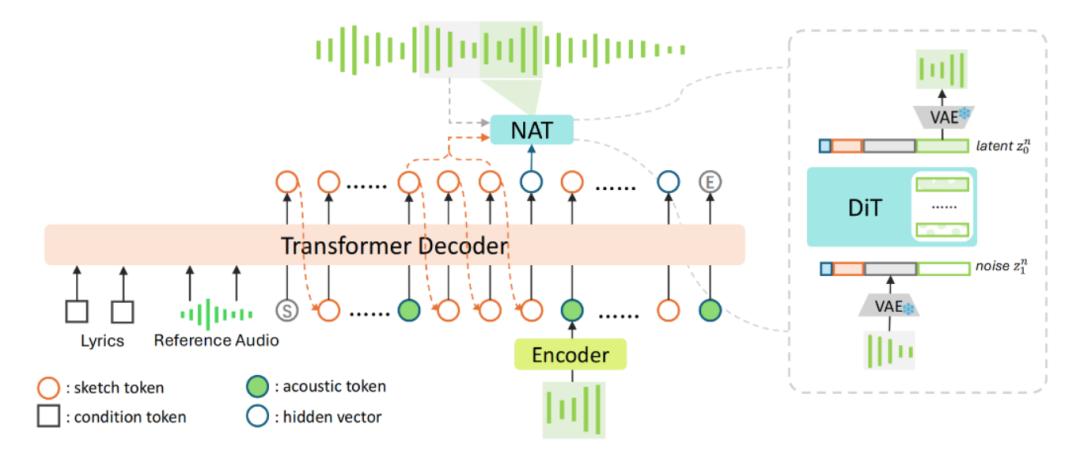
SongBloom 的核心之一是交错生成范式。该范式通过交替生成语义和声学上下文,动态切换生成过程,优化歌曲整体结构和音质。这种范式使得语义和声学表示之间能够进行双向信息交换,并且两个阶段共享部分模型参数并联合优化。
(二)自回归草图绘制
自回归草图绘制阶段使用因果掩码的Transformer 解码器栈,生成草图 token 和对应的隐藏向量。歌词和风格提示等条件被添加到输入序列开头,先前 patch 的声学特征通过声学编码器压缩后,作为下一个 token 插入到隐藏向量的位置,为草图生成提供声学上下文。
(三)扩散模型细化
非自回归潜在扩散模块在每个patch 内并行预测声学潜在变量。模型使用 Rectified Flow-Matching (RFM) 目标进行训练,旨在预测速度场。条件包括自回归阶段生成的隐藏向量、当前 patch 的草图 token 以及前一个 patch 的声学潜在变量。
(四)离散与连续特征的融合
SongBloom 使用离散的 sketch token 和连续的 VAE latent 输出最终结果。这种融合方式既完整保留了自回归模型在结构连贯性、音素对齐上的优势,又充分发挥了扩散模型在连续特征生成中对音质的提升作用。
(五)多模态输入融合
模型能够深度理解歌词与音频样本这两类截然不同的输入信息,并通过强大的多模态融合技术,实现高度精准的歌曲生成。
(一)客观指标
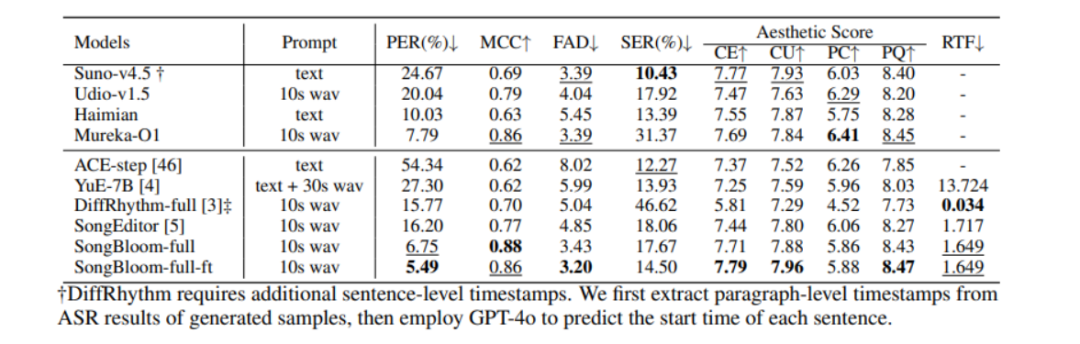
在客观指标方面,SongBloom 在多项指标上显著优于现有开源方法,并与领先的商业平台 Suno-v4.5 具有竞争力。例如,在音素错误率(PER)上,SongBloom 表现优秀,得益于对输入歌词结构的更忠实遵循。在 MuLan Cycle Consistency(MCC)上,SongBloom-full 取得了最高分。在自动评估的美学分数上,SongBloom-full-ft 在四项指标中的三项上优于所有其他基线。
(二)主观指标
在主观评估中,SongBloom 和 Suno-v4.5 表现最佳。SongBloom 在声乐相关指标(MUSV, QLTV, CRR)和一致性(CST)上表现出色。这表明 SongBloom 在生成音乐的听感上具有很高的质量,能够更好地满足用户的期望。
(一)音乐创作
SongBloom 为音乐人和创作者提供了强大的灵感来源。它能够快速生成高质量的歌曲基础框架,帮助创作者探索新的音乐风格和创作方向。无论是独立音乐人快速生成歌曲初稿,降低创作门槛,还是影视、游戏配乐根据场景需求生成定制化背景音乐,SongBloom 都能提供高效、专业的解决方案。
(二)音频制作
在影视、游戏、广告等行业的音频制作中,SongBloom 可用于快速生成背景音乐或主题曲,提升制作效率。
(三)教育领域
作为音乐教育工具,SongBloom 能够帮助学生理解音乐结构和创作过程,激发学习兴趣。
(四)娱乐产业
在社交媒体、短视频等平台,SongBloom 可以为用户生成个性化的音乐内容,增强互动性和趣味性。
(五)商业应用
SongBloom 还可用于企业品牌推广、活动宣传等商业领域,为企业和品牌生成定制化的音乐。
(一)环境准备
1. 创建并激活 Python 环境:
conda create -n SongBloom python==3.8.12conda activate SongBloom
2. 克隆仓库代码:
https://github.com/tencent-ailab/SongBloom.gitcd SongBloom
3. 安装依赖库:
# yum install libsndfile# pip install torch==2.2.0 torchaudio==2.2.0 --index-url https://download.pytorch.org/whl/cu118 # For different CUDA versionpip install -r requirements.txt
(二)数据准备
准备一个.jsonl 文件,每行是一个 json 对象:
{"idx": "The index of each sample","lyrics": "The lyrics to be generated","prompt_wav": "The path of the style prompt audio",}
示例文件为example/test.jsonl。提示音频应为 10 秒、48kHz 的音频片段。关于歌词格式的详细信息,请参见 docs/lyric_format.md。
(三)推理
运行模型脚本,输入音频路径与歌词文本:
source set_env.shpython3 infer.py --input-jsonl example/test.jsonl
对于显存较低的GPU(如 RTX4090),可以设置 dtype 为 bfloat16:
python3 infer.py --input-jsonl example/test.jsonl --dtype bfloat16SongBloom 还支持 flash-attn(可选)。如需启用,请手动安装 flash-attn(v2.6.3 是训练时使用的版本),并在 infer.py:8 中设置 os.environ['DISABLE_FLASH_ATTN'] = "0"。
SongBloom 作为一款创新的歌曲生成模型,凭借其独特的技术架构和出色的表现,为音乐创作和音频制作带来了新的可能性。它不仅在音频质量和歌词准确性方面表现出色,还通过开源代码和预训练权重降低了技术门槛,支持学术研究与商业应用的二次开发。无论是在音乐创作、音频制作、教育领域还是商业应用中,SongBloom 都展现出了巨大的应用潜力。
GitHub 仓库:https://github.com/tencent-ailab/SongBloom
Hugging Face 模型库:https://huggingface.co/CypressYang/SongBloom
arXiv 技术论文:https://arxiv.org/pdf/2506.07634
在线体验 Demo:https://cypress-yang.github.io/SongBloom_demo/
点亮“关注”,设为“星标”,精彩不迷路!与你携手探索AI的无限可能,精彩内容持续更新!🚀