ALPHADIVERSE:从“研究坍缩”到“持续探索”,用本地后训练破解阿尔法因子挖掘的困境
“ALPHADIVERSE: POST-TRAINING LOCAL QUANTITATIVE RESEARCH AGENTS FOR DIVERSE EXPLORATION IN ALPHA FACTOR MINING”
在量化投资中,阿尔法因子挖掘是预测股票收益的核心任务。然而,传统基于大型语言模型的多智能体系统面临两大困境:一是高度依赖外部API,导致成本高昂、数据保密性受限;二是长期研究循环容易陷入“路径坍缩”——系统倾向于反复探索少数早期成功的机制,忽略了广阔的搜索空间。
为此,本文提出ALPHADIVERSE框架,首次对多智能体量化研究流程中的规划器(Planner)与实现器(Realizer)进行本地化后训练。该框架通过互补性计划组合与跨环境循环收集多样化研究路径,并利用这些轨迹进行监督微调与联合强化学习(GRPO)。
实验覆盖沪深300、中证500、中证1000及A股四个股票域。结果显示,ALPHADIVERSE在CSI300上实现IC 0.0378、RIC 0.0407,综合表现超越多个ML、DL及智能体基线。其有用机制覆盖数从SFT-only的4提升至23,验证了持续探索能力。本地部署仅需1.436个H200 GPU小时,且无需外部API费用,为机构提供了低成本、高保密性的可行方案。
【 扫描文末二维码加入星球获取论文 】
摘要
大型语言模型(LLM)驱动的多智能体系统可自动化阿尔法因子挖掘,但其对外部API的依赖限制了对成本、可用性和保密性的控制。长期的研究循环也倾向于重复少数成功的经济机制,导致研究路径坍缩。
为解决这些问题,本文提出ALPHADIVERSE框架,该框架集成了多智能体阿尔法研究系统、多样化研究路径收集和本地智能体的后训练。研究系统生成互补的计划组合,并在不同研究环境中循环以收集多样化路径。利用这些多样化轨迹,通过监督微调(SFT)预热本地规划器(Planner)和实现器(Realizer)智能体。
随后,提出一种联合GRPO方法,利用预测质量和贡献多样性来联合优化这两个智能体。研究反馈仅限于内周期数据,而冻结的最终模型在外周期数据上进行评估,从而避免测试集调优。在四个中国股票域上的实验表明,ALPHADIVERSE能够结合竞争性的预测能力和更广泛的探索。
简介
阿尔法因子挖掘是量化研究的核心任务,旨在从市场数据中构建预测未来收益的信号。LLM驱动的多智能体系统虽能覆盖更多研究流程,但现有系统主要依赖外部API,面临成本高、可用性难控、数据保密性受限等问题。此外,长期研究循环存在“研究路径坍缩”现象,即系统倾向于重复扩展少数早期提出的成功机制,仅探索了庞大搜索空间的一小部分。
为克服这些限制,本文提出ALPHADIVERSE框架:首先使用GPT等先进闭源LLM验证研究循环的可靠性,收集涵盖动量、反转、流动性、波动性等多种经济机制的多样化研究路径;然后,基于这些路径,首次在阿尔法挖掘流程中,对本地规划器和实现器智能体进行后训练,以替代API节点,从而降低成本、保证数据隐私并稳定行为。
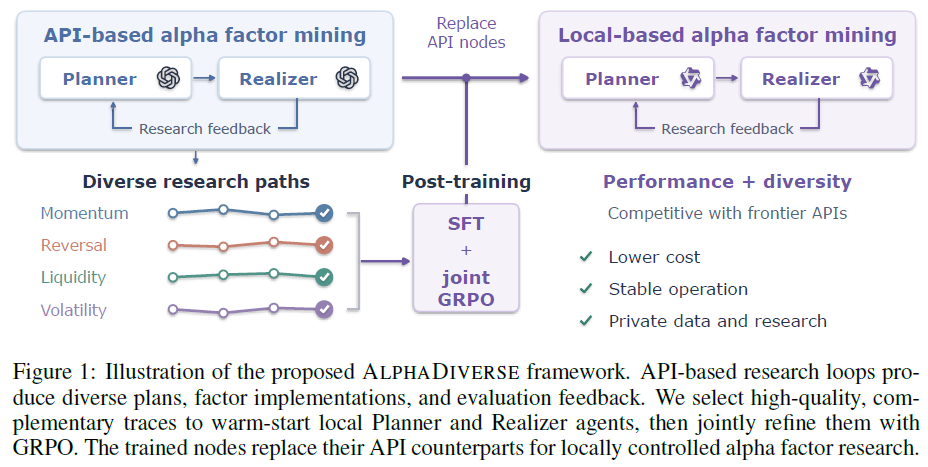
为实现更广泛的探索,框架引入两层探索策略,并应用两阶段后训练:SFT教授指令遵循能力和研究知识,联合GRPO优化两个智能体。实验表明,ALPHADIVERSE在四个中国股票域上取得了与前沿API方法相当的竞争性表现和更广的探索。
相关工作
LLM驱动的金融智能体
已有研究通过金融任务训练、多智能体分工(研究规划、实现、评估)以及奖励训练来支持预测和交易。近年工作进一步训练阿尔法生成策略或利用外部记忆引导搜索。ALPHADIVERSE的独特之处在于首次对本地规划器和实现器进行后训练,完全摆脱对外部API的依赖。
研究路径多样性
现有方法通过表达式正则化、进化搜索和控制因子冗余来鼓励探索。然而研究表明,不同输出可能仍收敛于相似的研究方向。ALPHADIVERSE则要求每轮探索不同的经济机制,并跨环境收集多样化轨迹用于训练。
联合强化学习
相关工作如MARFT和MAGRPO处理多智能体间的依赖关系与共享奖励。ALPHADIVERSE将这一方向专门应用于阿尔法挖掘,规划器信用通过比较研究组合、实现器信用通过比较同一计划的不同实现来分配,并设计了结合预测质量与互补性贡献的共享奖励。
方法
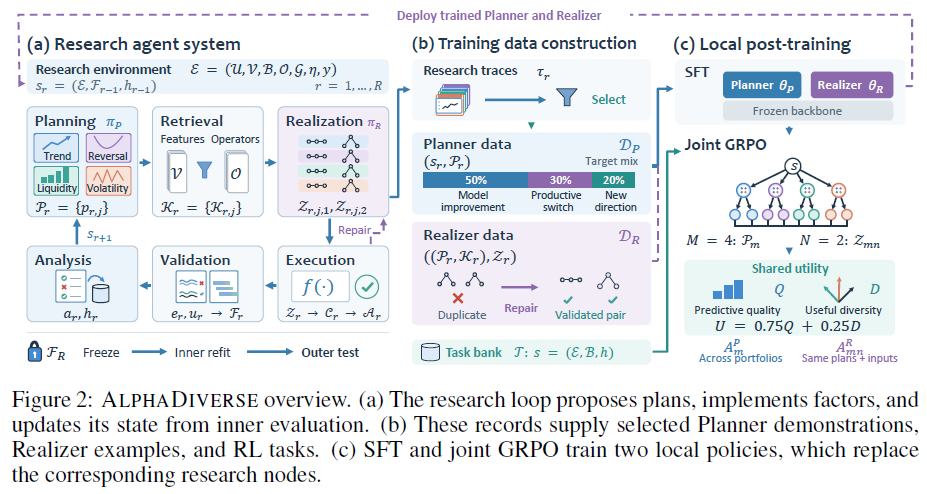
ALPHADIVERSE连接了研究智能体系统、多样化训练轨迹构建和本地后训练。给定研究环境 E = (U, V, B, O, G, η, y),每个研究循环旨在挖掘一组阿尔法因子 F。其中,U 是股票域,V 是可用市场特征,B 是初始因子集,O 是允许的算子,G 是可行的经济机制目录,η 是评估设置,y 是收益目标。每个循环包含 R 轮,第 r 轮状态表示为 s_r = (E, F_r-1, h_r-1)。
研究智能体系统
系统包含六个模块:
规划(Planning):规划器 π_P 基于 G 中的机制生成 J 个互补计划 P_r,每轮覆盖至少三个主题。
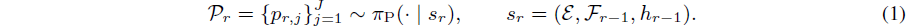
检索与实现(Retrieval and Realization):检索模块为每个计划选择特征和算子 K_r。实现器 π_R 为每个计划生成两个结构不同的因子规格 Z_r,以保证实现的多样性。
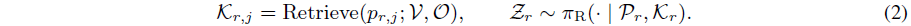
执行与筛选(Execution and Screening):执行模块检查规格的有效性并编译为可执行公式,无效规格将被拒绝并反馈给实现器修复。通过执行产生候选因子 C_r,并依据覆盖率、预测质量和冗余度进行筛选,得到 A_r。因子质量分数公式为:
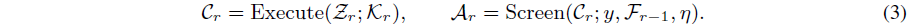
验证与保留(Validation and Retention):使用LightGBM作为预测器。保留决策 u_r 基于 K 个内部分层(folds)的预测得分改进:
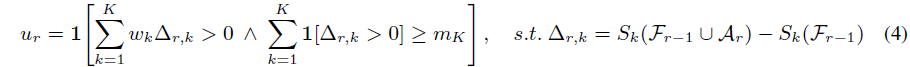
分析(Analysis):分析模块将当前轮的结果转化为反馈 a_r,用于更新下一轮的状态 s_r+1。
最终评估(Final Evaluation):R 轮后冻结因子和预测器设置,仅在外周期数据上评估一次,以避免测试集调优。
训练数据构建
每轮产生记录 τ_r,用于构建规划器和实现器的监督数据集。
规划器数据:选取至少两个计划包含被接受因子的状态-组合对,分为三类:模型改进(50%)、生产性切换(30%)、新方向(20%),并平衡环境和时间阶段。
实现器数据:选取满足质量和相关性阈值的因子对,并构造修复样本,以教导在不同意图和输入下的不同实现。
本地后训练
监督微调(SFT):使用共享的冻结预训练骨干和独立的LoRA适配器(参数 θ_P, θ_R),通过最小化负对数似然损失进行微调。
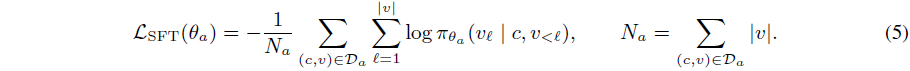
联合GRPO:从SFT策略出发,构建96个任务状态。对同一状态 s,采样 M=4 个计划组合,每个组合产生 N=2 个实现。共享效用 U 结合预测质量 Q 和有用多样性 D。其中 Q 基于得分增益 Δ_s(A),D 基于预测变化向量的增量覆盖:
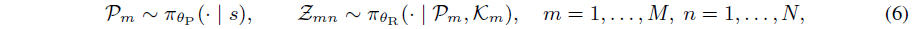
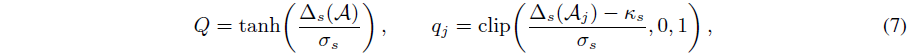
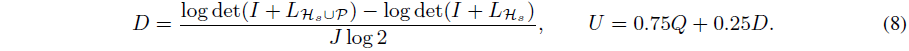
分配角色特定信用:规划器比较组合平均效用,实现器比较同一计划的不同实现。使用带裁剪的GRPO目标更新策略。
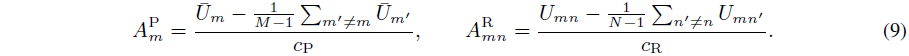
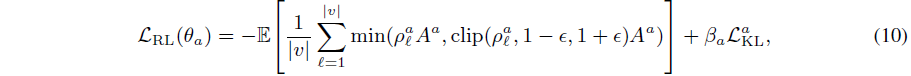
实验
数据和评估
在沪深300(CSI300)、中证500(CSI500)、中证1000(CSI1000)和沪深A股域上,使用日线和分钟级价格量数据。预测目标为 t+1 开盘到 t+2 开盘的超额收益。内周期为2022年5月至2025年12月,外周期为2026年1月至8月。主要对比使用全部特征,K=1 个内层,R=20 轮,J=4 个计划,共160个候选因子槽。
主要结果
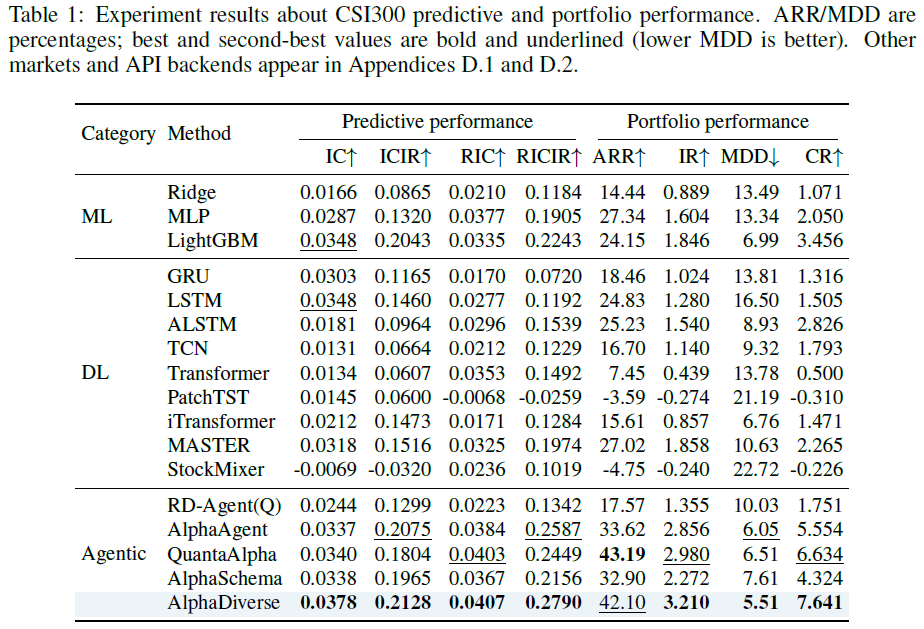
如表1所示(CSI300),ALPHADIVERSE在四项预测指标上均领先,包括IC 0.0378和RIC 0.0407;在组合表现上取得最高IR(3.210)、最高CR(7.641)和最低MDD(5.51%)。在其他三个市场的表现(见附录D.1)呈现相同模式,例如在CSI500上,ALPHADIVERSE的IC为0.0308,IR为1.245,MDD为7.30%。
多样性与泛化
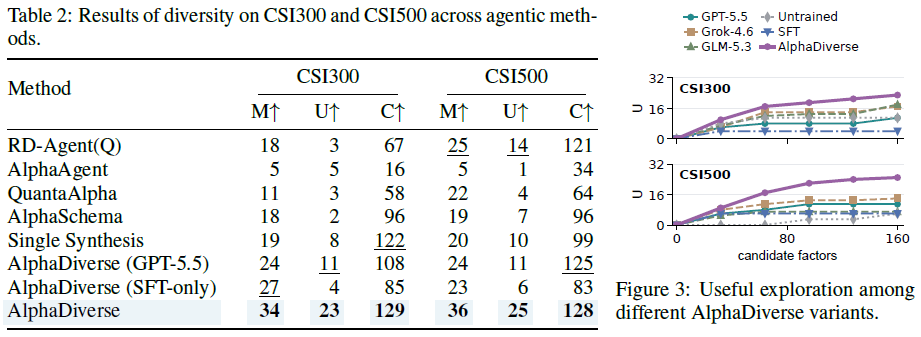
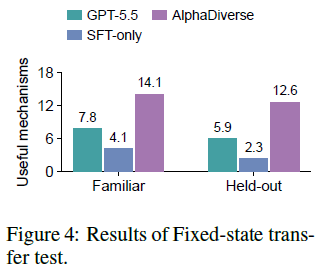
使用机制数(M)、有用机制数(U)、信号簇数(C)等指标评估多样性。如表2和表20所示,ALPHADIVERSE在四个市场上均取得最高的有用机制覆盖率,例如在CSI300上,U从SFT-only的4提升到23;在CSI500上,从6提升到25。图3表明,ALPHADIVERSE能持续发现有用机制,而SFT会早期饱和。图4的固定状态迁移测试显示,ALPHADIVERSE在熟悉和预留的(Held-out)研究状态下都能保留更多有用机制。
消融研究
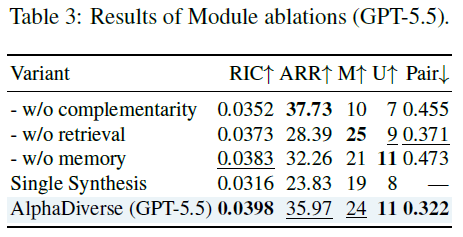
模块消融(表3,GPT-5.5):移除互补性规则(w/o complementarity)会使机制数从24降至10;移除检索(w/o retrieval)会降低有用覆盖和预测质量;移除记忆(w/o memory)会削弱预测性能。
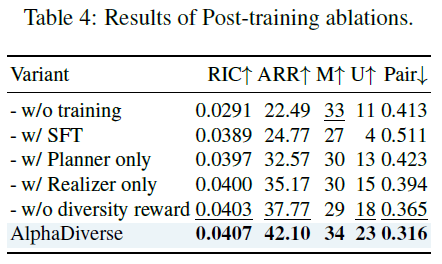
后训练消融(表4):SFT能提升预测但缩小有用覆盖(U降至4)。仅训练规划器或实现器只能部分恢复收益。联合训练并加入多样性奖励后,U从18提升至23,配对相关性从0.365降至0.316,同时ARR、IR等组合指标也显著提升。
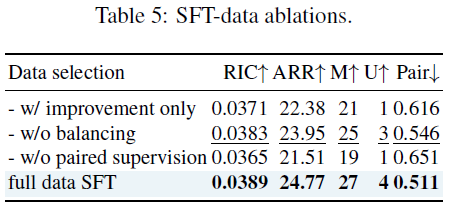
数据消融(表5,SFT阶段):仅使用改进样本(w/ improvement only)会损失有用机制;移除配对监督(w/o paired supervision)会增加实现相关性(0.511至0.651)并降低保留覆盖率。
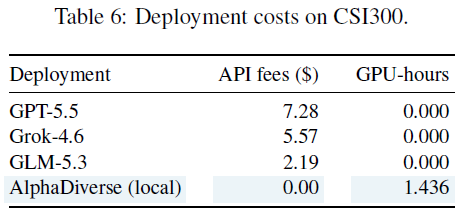
部署成本(表6):在CSI300上运行一个完整20轮实验,API后端收费分别为GPT-5.5 $7.28、Grok-4.6 $5.57、GLM-5.3 $2.19。本地ALPHADIVERSE无需外部API费用,仅使用1.436个H200 GPU小时。
总结
本文提出了ALPHADIVERSE,一个用于多样化阿尔法因子挖掘的本地量化研究智能体训练框架。通过互补规划、多样化轨迹收集和联合强化学习,在四个股票域上取得了竞争性的财务表现和持续探索能力。
局限性:
1) 固定的机制目录和算子库限制了智能体可表达的想法,扩展它们需要可靠的语义和因果检查。
2) 联合训练在有限的内状态库上评估采样计划,仅近似其在长研究循环中的延迟贡献。
学习扩展搜索语言和跨演化研究状态进行信用分配是未来工作的方向。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
