Jev为什么刷屏AI圈?一个不会说话的模型,把Agent决策提速200倍
最近 AI 圈有个反常识的新模型突然刷屏:Jev。
它不会聊天,不会写文章,不会总结会议纪要,甚至你让它多说两句,它都做不到。放在人人都卷长文本、卷多模态、卷深度推理的 2026 年,这玩意儿看起来简直像"反向升级"。
但偏偏是这个不会说话的模型,被 TypeSafe AI 包装成第一款System One Model,还让 LangChain 专门写了一篇《Building a Harness with Jev》,教开发者怎么把它塞进 Agent 系统里。
我一开始也没太当回事。直到看完它的设计,才发现 Jev 真正狠的地方不是"又出了一个新模型",而是它把 AI 从"会说话"往"能被软件稳定调用"这个方向拧了一把。
Jev 的野心不是替代 ChatGPT,而是替代 Agent 里那些又慢、又贵、又不稳定的判断调用。
Jev 最反常识的地方:它主动放弃了"说话"
做出 Jev 的公司叫 TypeSafe AI,创始团队背景很硬。公开资料里最抓眼球的一点是:创始人 Diogo Almeida 是 RLHF(人类反馈强化学习)的共同发明人之一。
这就很有意思了。
RLHF 当年解决的是"怎么让模型更像人一样说话"。ChatGPT 能从一个冷冰冰的补全文本机器,变成会解释、会安慰、会按人类偏好回答的聊天助手,背后就有这条技术路线的影子。
结果现在,这个"教会大模型说话"的人,反手做了一个拒绝说话的模型。
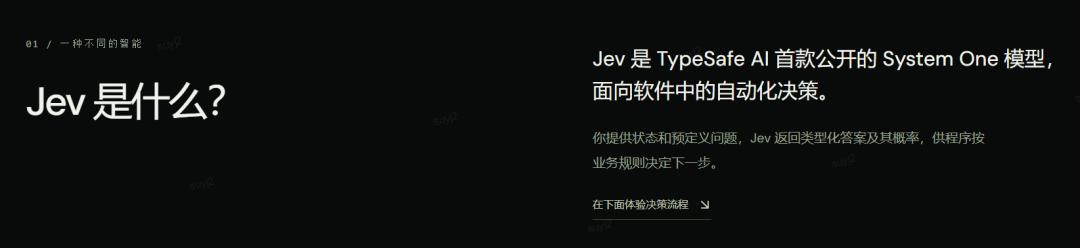
Jev 不输出长文本,不扮演助手,不和你来回对话。它只干一件事:看一段状态,然后给出结构化判断。
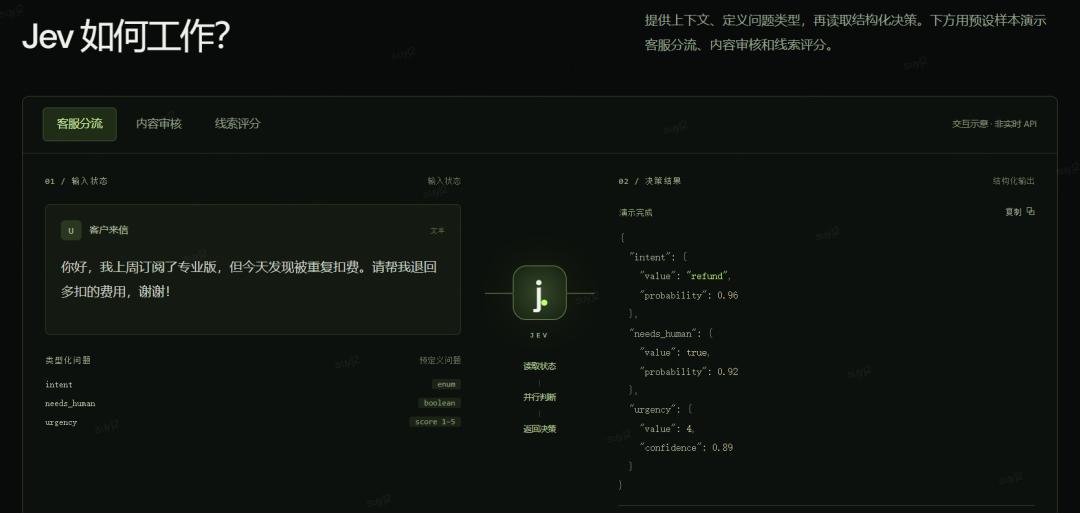
比如客服工单来了这么一句:
"我 Stripe 账号连了三天都失败,现在订单收不了款,麻烦立刻处理。"
传统 LLM 可能会输出一大段:"根据用户描述,该问题具有一定紧急性,建议优先处理……"
Jev 不这么干。你问它:这条消息是否紧急?它直接返回:
{"is_urgent": {"type": "noul","noul": 0.999}}
0.999,就是 99.9% 概率紧急。后端代码拿到这个值,直接进 if 判断、调优先级、进高优队列。
不用哄模型"请只输出 JSON",不用正则抠关键字,也不用担心它突然补一句"希望我的回答对你有帮助"。
大模型是能言善辩的顾问,Jev 是面无表情的质检员——业务流水线上,后者才是刚需。
Jev 到底新在哪:不是小模型,是 System One 模型
Jev 官方给自己的定位不是 LLM,也不是"更便宜的小模型",而是System One Model。
这个词来自人类认知里的快慢系统:
System Two:慢思考,适合推理、规划、写作、复杂分析
System One:快反应,适合一眼判断、直觉分类、风险感知
传统聊天大模型更像 System Two。它要逐字生成,边想边说,输出越长越慢。你让它判断"这条消息是不是投诉",它也要先组织一段语言,再吐出答案。
Jev 更像 System One。它不写废话,只做判断。你给它 state,再给它 questions,它一次性把答案和概率吐回来。
它只有三种问法,反而是它最工程化的地方:
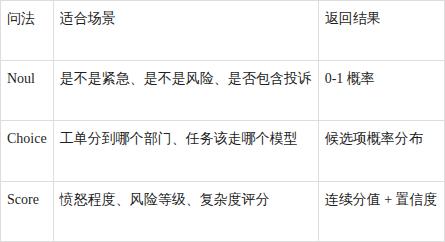
这三种东西看着朴素,但刚好卡住了软件自动化最需要的接口。
软件系统不喜欢一大段自然语言,它喜欢布尔值、枚举值、分数、概率。Jev 输出的就是这些东西。
更关键的是,Jev 的输出是类型锁死的。你问 Choice,它不会凭空编一个候选项;你问 Score,它不会突然写小作文;你问 Noul,它就给你一个概率。
这和传统 LLM 的 JSON mode 不是一回事。JSON mode 只是"尽量按格式说话",Jev 是从模型能力边界上就不让它乱说。
Jev 最狠的一刀,是把"生成文本"这件最贵、最不稳定的能力直接砍掉了
它还会给出 confidence。比如一句话同时涉及退货和重复扣款,传统模型容易拍脑袋选一个;Jev 会告诉你概率分布和把握度:60% 退换货、40% 财务,中等置信。
这一下工程价值就出来了:
置信度 > 0.9:系统自动处理
置信度 0.6-0.9:让用户补充信息
置信度 < 0.6:转人工或转更强的大模型
TypeSafe AI 官网给出的数据更刺激:在 System One 类任务上,Jev 可做到193.6x faster、444.6x cheaper;LangChain 文中也提到,分类任务上最多可达 200 倍速度、400 倍成本优势。
这不是"便宜一点",是直接把一类 Agent 判断从秒级拉到百毫秒级。
Jev 最适合干什么:给软件做"毫秒级判断层"
Jev 不是拿来替代 LLM 的。它真正适合的位置,是所有需要"快判"的业务节点。
我把它分成四类:
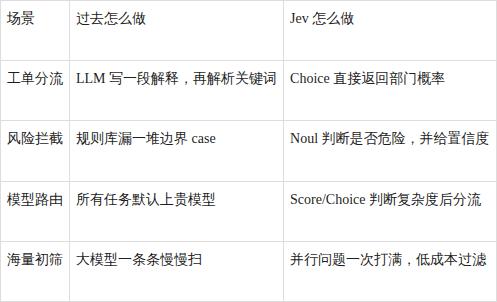
尤其是 Agent 系统。
Agent 每跑一步,都在做一堆小判断:这次要不要调工具?这个工具危险吗?当前任务复杂吗?要不要升级到强模型?输出有没有越界?
这些判断如果全交给聊天大模型,成本和延迟会被迅速放大。LangChain 官方那篇《Building a Harness with Jev》,讲的就是这个核心点:LLM 负责开放式思考,Jev 负责在 Harness 里做低成本快判。
第一个最典型的场景,就是风险动作校验。
# Harness 风险拦截中间件:Agent 执行工具前,先过一遍 Jev 哨兵from langchain.agents import create_agentfrom langchain_typesafe.experimental.middleware import (AutoModeMiddleware,)# 只对 bash 这类高危工具启用风险判断guardrail = AutoModeMiddleware(tools=["bash"])agent = create_agent("openai:gpt-5.6-luna", middleware=[guardrail])# Jev 会在工具真正执行前,先给这次调用打一个风险概率# 概率超过阈值,直接拦下,不让危险命令跑到生产环境
这段代码做了一件事:给每一次高危工具调用加了一道闸——不是等它执行完再算账,是在动手之前先问一句"这个动作靠谱吗"。
上周我们那个自动化运维 Agent 就吃过这个亏:它接到一条模糊指令,判断"该清理日志了",写完 bash 命令直接甩给工具执行层。没人拦、没人问,一路绿灯。事后复盘才发现,命令作用域比预期大出一圈,好在是测试环境。
以前这类"危险动作分类器"往往藏在 Claude Code、Cursor 这类闭源 Harness 内部。Jev 的出现,让普通开发者也能自己搭一层类似的哨兵。
第二个场景是模型路由:简单任务别浪费钱调贵模型。
# Harness 模型路由中间件:让 Jev 先判断任务难度,再分流给合适的模型from langchain.agents import create_agentfrom langchain_typesafe.experimental.middleware import (ModelChoice,ModelRouterMiddleware,)router = ModelRouterMiddleware(choices={"fast": ModelChoice(model="openai:luna",criteria="直接查询、信息抽取、局部小改动",),"powerful": ModelChoice(model="openai:sol",criteria="架构设计、高风险决策类任务",),},instructions="优先选能完成任务的最低成本模型",)agent = create_agent("openai:gpt-5.6-luna", middleware=[router])# 路由结果和置信度会保留在 agent 状态里,全程可追溯
这段代码解决的是"一刀切用同一个模型"的浪费问题——查个订单状态和设计一套系统架构,凭啥用一样贵的模型顶?Jev 先扫一眼任务,几十毫秒给出路由结果,剩下的钱和时间全省下来了。
Jev 在 Harness 里的价值,不是让 Agent 更会说,而是让 Agent 少做蠢决定。
理性看待 Jev:别把它吹成万能药
Jev 这东西很有想象力,但千万别把它理解成"更便宜的 ChatGPT"。
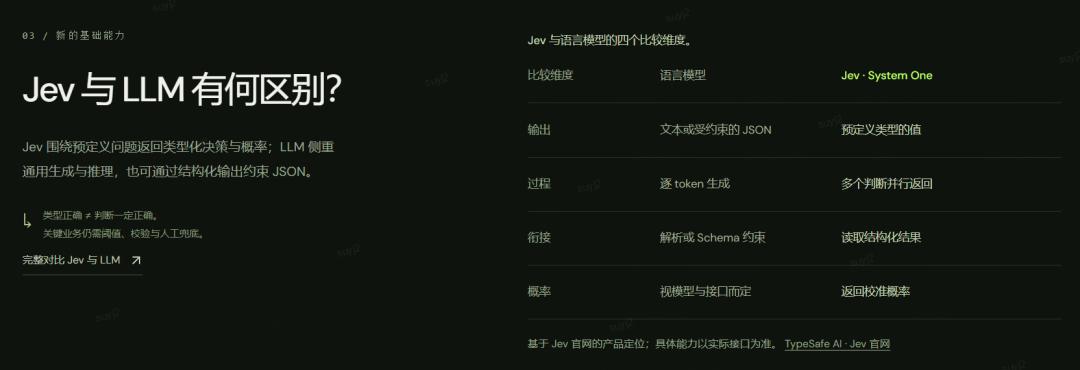
它是一个判断器,不是全能助手。用之前一定要划清边界,官方自己也说得很坦诚:
不做数学计算:它连加减乘除都算不利索,别指望它核对金额
算不清时间先后:能识别出日期字符串,但排不明白谁先谁后
写不出一个字文案:长文生成、总结改写,这些活它天生干不了
不适合智能体单步决策:"浏览器里下一步该点哪"这种连续推理,还是得靠大模型
它不会拒绝回答:给它任何问题它都会强行吐一个概率,敏感内容和权限管控这层安全围栏,必须业务代码自己兜底
我自己踩的坑是:一开始想偷懒,把风险判断和内容合规判断一起丢给 Jev,结果合规这块因为没有外部围栏,被绕过去了。
后来才想明白——Jev 只负责"直觉快判",围栏这道墙,永远得自己在代码里砌。
一个更稳妥的工程姿势是:
用户输入 / Agent 状态↓Jev:快速判断意图、风险、复杂度、置信度↓业务代码:按阈值做路由、拦截、升级、人工兜底↓LLM:只处理真正需要生成、推理、规划的任务```这才是 Jev 的正确打开方式:不是把所有 AI 工作都交给它,而是让它把不该进入大模型的请求挡在门口。
这才是 Jev 的正确打开方式:不是把所有 AI 工作都交给它,而是让它把不该进入大模型的请求挡在门口。
参数内卷这几年,大家一直在问:模型能不能更大、更聪明、更会推理?
Jev 问的是另一个问题:那些不需要"深思熟虑"的判断,凭什么每次都要花几秒钟、几分钱,去问一个会写小作文的大模型?
我觉得这才是 Jev 刷屏的真正原因。它不是又一个聊天机器人,而是把 AI 能力拆成了更适合软件调用的形态:强类型、低延迟、有置信度、可以直接进控制流。
未来的 AI 系统,不会只靠一个全能大模型硬扛,而会像软件架构一样分层:LLM 管思考,Jev 管反射,代码管边界。
你们现在做 Agent 或自动化系统时,有没有遇到过"只是做个判断,却被大模型拖慢拖贵"的问题?评论区聊聊。
觉得这篇有用,转给正在研究 Agent 落地的同事——Jev 这个新物种,值得单独看一眼。
参考资料:LangChain 官方博客《Building a Harness with Jev》、TypeSafe AI 官网、AIJev.org、公众号「超级对齐」相关解读
举报/反馈
对本文内容有合作意向?
我们将在 1 个工作日内与您联系