Jev 落地方法论:概率不是答案,阈值才是
Jev 火起来之后,我被问得最多的一个问题是:“它到底准不准?”
这个问题没法回答。因为“准”不是一个模型的属性,而是一条决策规则的属性。
要讲清楚这件事,得先回到 Jev 这个名字本身。TypeSafe 把它所在的品类命名为 System One Model——这不是随手起的营销词,它指向的是心理学里一套被研究了半个世纪的理论。理解了这套理论,你才知道 Jev 该被放在系统的什么位置。
一、名字的来历:《思考,快与慢》里的两套系统
诺贝尔经济学奖得主丹尼尔·卡尼曼在《思考,快与慢》里,把人类的思考拆成了两套系统。
卡尼曼的原话是:“系统 1 的运行是无意识且快速的,不怎么费脑力,没有感觉,完全处于自主控制状态。”
System 1:快思考,直觉系统
无意识、快速、不费力、自动运行。它依靠直觉、经验、联想和情绪做出判断,几乎不需要刻意动脑。看到一张脸立刻读出表情,听到一句话马上理解语义,这些都在瞬间完成。
System 2:慢思考,理性系统
费力、刻意、理性、需要专注。它负责主动计算、逻辑推理和自我控制。算一道多位数乘法、权衡两份工作的利弊,都要靠它。
System 1 的五个典型特征
- 自动触发,无需努力——不需要你下令“现在开始思考”,它自己就跑了。
- 联想式思维——自动把事物关联起来,擅长讲故事、寻找因果,哪怕只是巧合也会脑补出一套合理解释。
- 自带情绪偏好——自带好恶,会自动生成第一印象,也就是“光环效应”的来源。
- 擅长模式识别——基于过往经验快速匹配。所谓老手的直觉,很多都是系统 1 的成果。
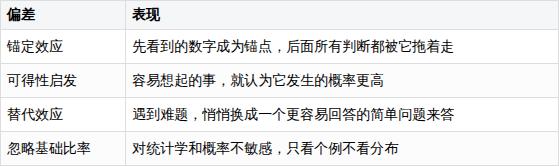
- 存在认知偏差——这是重点,下一小节单独展开。
系统 1 自带的四种认知偏差
两个系统怎么协作?
大部分日常判断,默认由系统 1 直接输出结论;系统 2 平时处于低功耗待机状态。只有当遇到困难、反常、需要自我控制的事情时,系统 2 才会被唤醒,去审核、修正系统 1 给出的直觉答案。
卡尼曼指出的短板:系统 2 很懒,常常直接采信系统 1 的结论,懒得校验。 这就是很多认知谬误的根源——不是算错了,是压根没启动计算。
二、这套理论,正好解释了 Agent 架构缺了什么
把这套框架套到今天的 Agent 上,会看到一个挺别扭的事实:
我们现在造的 Agent,几乎是一个“只有系统 2”的结构。
每一次路由判断、每一轮检索结果筛选、每一次“工具返回的信息够不够”的检查,都要完整启动一次生成链路:把上下文塞进去,让旗舰模型逐 token 推理一遍,再从返回的文本里把答案解析出来。
换成人的类比就是——你每判断一句话是陈述还是疑问,都要先在草稿纸上列一遍完整的论证过程。这不是严谨,这是浪费。
Jev 这类模型补上的,正是那个一直缺席的系统 1。
把两边的对应关系列出来,会发现每一条都严丝合缝:
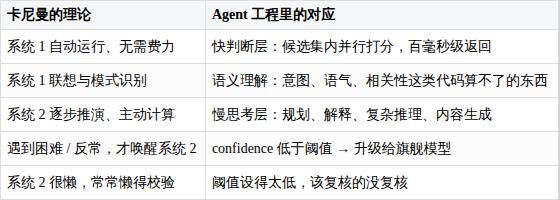
最后一行是这篇文章里我最想让你记住的一句,值得单独展开。
卡尼曼说,人的谬误往往不是算错了,而是系统 2 根本没被唤醒。系统 1 给了一个顺手的答案,系统 2 觉得“差不多”,就放行了。
在 Agent 里,这个毛病有个非常具体的名字:阈值设得太低。 你的级联结构也许搭起来了,但如果自动执行的门槛定在 0.6,那么大量本该送去复核的判断都会被直接采信——系统 2 在架构图里存在,却在运行时缺席。
现在可以回头看开头那个问题了。
假设 Jev 判断“这条消息是否要求转人工”,返回 0.72:
- 如果你的策略是“0.72 就转人工”,转错了要赔一个客服的人力成本;
- 如果你的策略是“低于 0.9 一律不转,让机器人再聊一轮”,不转错了可能丢一个客户。
同一个 0.72,在两种策略下产生完全不同的结果。因为在双系统结构里,快判断层的职责从来不是“给出最终答案”,而是“给出一个带可信度的初步结论”。要不要推翻它,是一道调度题——而这道调度题在工程上就叫阈值。
市面上讲 Jev 的文章,大多停在“它能返回概率,很酷”。但从概率到动作之间,隔着校准、阈值、级联、兜底这四道工序。这篇文章讲的就是这四道工序:我会先用一份公开的第三方实测数据划出 Jev 的能力边界,再给出一套能直接搬进你项目的验证流程和五条工程规则。
三、先看一份别人的实测:Jev 不是全面赢
在决定用不用 Jev 之前,最值得看的一份材料,是 AI/ML API 在 2026 年 9 月 25 日跑的一组对比测试:900 个样本、3 个任务、6 个模型,统一随机种子、统一指令和选项描述。
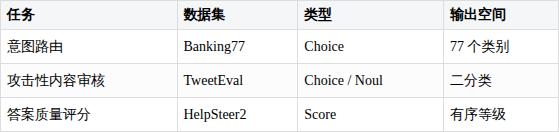
结果很有意思——Jev 在三个任务上的表现差异极大:
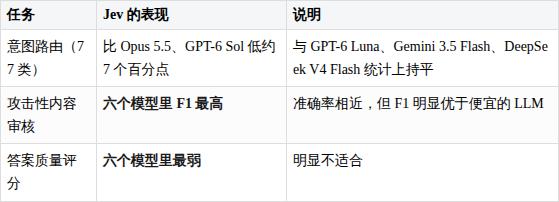
这组数据说明了什么
criteria 且标注员能达成一致的任务 → 右移;标准藏在人类偏好里的任务 → 左移。
第一,Jev 的优势不在“聪明”,在“便宜且快”。 在路由任务上,它没有赢过旗舰模型,但和三个便宜 LLM 打平。而它的价格是 Opus 5.5 的 1/84~1/150,是 GPT-6 Sol 的 1/17~1/30,服务端中位延迟 140 毫秒,而 LLM 们要 0.9~2.6 秒。同样的精度,两个数量级的成本和延迟差——这才是 Jev 的卖点。
第二,Jev 的弱项暴露了它的能力边界。 为什么“答案质量评分”垫底?
因为这个任务看似是评分,其实是伪装成评分的生成任务。什么叫“这个答案写得好”?没有可枚举的判据,标准藏在人类偏好里,需要模型去体会语气、结构、信息密度的综合感受。Jev 的输入只有你给的 state 和 criteria,它不会自己生成一份参考答案来对照。
反过来,为什么“攻击性内容审核”能拿第一?因为判据可以写清楚:有没有侮辱性词汇、有没有针对特定群体、有没有威胁表述。当标准能落成几条可描述的规则时,Jev 就能稳定执行。
一条实用的判断准则:如果你没法用两三句话把评分标准写进
criteria,让一个新来的标注员照着做也能和老标注员达成一致,那么这个任务就不该交给 Jev。
第三,最值得关注的不是 Jev 单打独斗,而是级联。 这份测试里最有商业价值的一条数据是:把 Jev 放在 Opus 5.5 前面做前置过滤器——高置信度的 Jev 直接出结果,低置信度的才交给 Opus——两个分类任务的最终准确率追平了 Opus 单独运行,而成本只有 38%~45%。
这才是 Jev 最现实的落地形态:它不是替代者,是分流器。 后面第六节会展开讲怎么搭。
四、概率、置信度、动作,是三件不同的事
在讲怎么定阈值之前,必须先厘清一个几乎所有人都会混淆的概念。
Jev 的返回里有两个数字,它们不是一回事。
probabilities 和 confidence 的区别
probabilities 是模型在每个候选选项上分配的概率质量。confidence 是 TypeSafe 从这个分布的形状里导出的一个 0~1 数值。
为什么需要两个?看这个例子:
{
  "type": "choice",
  "choice": "vpn",
  "confidence": 0.61,
  "probabilities": {
    "vpn": 0.68, "wifi": 0.19, "auth": 0.09,
    "hardware": 0.02, "other": 0.02
  }
}
冠军是 vpn,拿了 0.68。但亚军 wifi 有 0.19,这是个不小的威胁。所以 confidence 只有 0.61。
如果分布是这样的呢?
{ "vpn": 0.68, "wifi": 0.08, "auth": 0.08, "hardware": 0.08, "other": 0.08 }同样是 0.68 的冠军,但它面对的是一片平地。这时 confidence 会明显更高。
一句话记住:
probabilities回答“哪个选项最可能”,confidence回答“这个结论有多稳”。冠军票数相同,对手分布不同,稳健性完全不同。
Noul 没有 confidence 字段
Noul 只返回一个 noul,一个 0~1 的数。没有单独的 confidence——因为这个数字本身就是信号。
这里有个必须提醒的坑:0.5 不等于“中等程度”,0.5 的意思是“模型分不出来”。
这是判别式模型和使用者之间的一个经典误解。当客服语气暧昧、说法含糊时,Jev 返回 0.5 附近的数值,不是在说“用户有一半的意愿”,而是在说“这条信息不足以支撑判断”。把它当成程度来用,会做出很离谱的决策。
让代码拥有策略
把这三个概念分开之后,架构就清楚了:模型负责判断,代码负责策略。
落地成代码,就是把策略显式化、类型化:
from dataclasses import dataclass
from enum import Enum

class Action(Enum):
    EXECUTE = "execute"      # 自动执行
    CONFIRM = "confirm"      # 弹确认
    ESCALATE = "escalate"    # 升级给人或旗舰模型

@dataclass(frozen=True)
class Policy:
    """阈值是业务决策,不是模型输出。"""
    name: str
    execute_at: float
    confirm_at: float

    def decide(self, p: float) -> Action:
        if p >= self.execute_at:
            return Action.EXECUTE
        if p >= self.confirm_at:
            return Action.CONFIRM
        return Action.ESCALATE

# 按"错了要赔多少"来配阈值,而不是拍脑袋
POLICIES = {
    # 只读操作,错了最多多读一次
    "doc_relevance":   Policy("doc_relevance",   execute_at=0.60, confirm_at=0.35),
    # 分流错了,用户会被转错部门
    "ticket_routing":  Policy("ticket_routing",  execute_at=0.80, confirm_at=0.55),
    # 动了钱,错了要退款+赔信誉
    "auto_refund":     Policy("auto_refund",     execute_at=0.97, confirm_at=0.90),
}注意最后一行。auto_refund 的自动执行阈值设到 0.97——这意味着大部分退款申请都不会被自动执行,而是走向 CONFIRM 或 ESCALATE。这不是保守,这是正确的:退款的错误代价远高于收益。
至于这几个数字怎么算出来的,下一节讲。
五、校准:从“厂家说校准”到“我在自己数据上验过”
TypeSafe 用 RLCD(Reinforcement Learning for Calibrated Decisions)训练 Jev,目标是让概率和实际正确率对得上——当它说 0.9 的时候,长期看应该有约 90% 的情况是对的。
第三方实测给了一个外部佐证:在分类任务上,Jev 置信度 ≥ 0.9 的样本,实际正确率是 94%~96%。这个数字相当不错。
但这不够。因为:
- 这个数字来自公开数据集,不是你的业务数据;
- 校准是分布相关的——在你的数据分布上,它可能偏乐观也可能偏保守;
- 模型会迭代,今天的校准不代表下个版本。
所以你需要一套自己的验证流程。一共四步,都能在一个下午跑完。
第一步:攒一批带标签的样本
不需要很多。300~500 条就有统计意义了,1000 条就很扎实。
关键不是数量,是这批样本要来自真实流量,而不是你构造的。人构造的样本往往太干净,会高估模型表现。
import json
from typesafe_sdk import Noul, TypeSafeClient

def collect(path, question, key):
    """跑一批真实样本,连带标签一起存下来。"""
    rows = [json.loads(l) for l in open(path, encoding="utf-8")]
    client = TypeSafeClient(model="jev-1.13.0")   # 一定要 pin 版本
    out = []
    for row in rows:
        r = client.system_one(
            state=row["state"],
            questions={key: Noul(instructions=question)},
        )
        out.append({
            "id": row["id"],
            "p": r.answers[key].noul,
            "label": row["label"],       # 1 = 是, 0 = 否
        })
    return out
第二步:画可靠性图,算 ECE
可靠性图的做法很简单:把预测概率分成若干档(比如 10 档,每档 0.1),统计每一档里实际为正例的比例。如果校准良好,这些点应该落在对角线上。
def reliability_bins(rows, n_bins=10):
    """分箱统计:每一档的预测均值 vs 实际正确率。"""
    bins = [[] for _ in range(n_bins)]
    for r in rows:
        i = min(int(r["p"] * n_bins), n_bins - 1)
        bins[i].append(r)

    return [
        {
            "lo": i / n_bins,
            "hi": (i + 1) / n_bins,
            "n": len(b),
            "mean_p": sum(x["p"] for x in b) / len(b),
            "acc":    sum(x["label"] for x in b) / len(b),
        }
        for i, b in enumerate(bins) if b
    ]

def ece(rows, n_bins=10):
    """Expected Calibration Error:加权平均的 |预测 - 实际|。"""
    total = len(rows)
    return sum(
        (b["n"] / total) * abs(b["mean_p"] - b["acc"])
        for b in reliability_bins(rows, n_bins)
    )
怎么读这个结果:
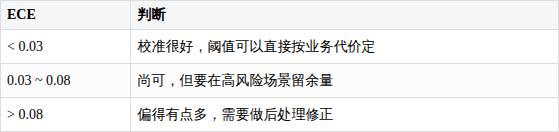
第三步:如果偏了,做重标定
如果发现系统性偏高(比如模型说 0.8,实际只有 0.65),最简单有效的办法是保序回归(isotonic regression)或者Platt scaling(逻辑回归标定)。
from sklearn.isotonic import IsotonicRegression
import numpy as np

def recalibrate(train_rows, test_rows):
    """用留出集拟合一个单调映射,把原始概率掰到真实概率。"""
    p_tr = np.array([r["p"] for r in train_rows])
    y_tr = np.array([r["label"] for r in train_rows])
    ir = IsotonicRegression(out_of_bounds="clip", y_min=0.0, y_max=1.0)
    ir.fit(p_tr, y_tr)

    for r in test_rows:
        r["p_cal"] = float(ir.predict([r["p"]])[0])
return ir, test_rows保序回归的好处是它只要求单调,不假设分布形状,很适合这种场景。拟合完之后再算一次 ECE,应该会明显下降。
容易犯的错
标定映射要在留出集上拟合,在测试集上验证。在自己拟合的数据上算 ECE 会得到近乎完美的假象。
第四步:用代价矩阵定阈值,不要拍脑袋
这是整个流程里最核心、也最被忽略的一步。
阈值的本质是在两类错误之间做取舍。设阈值为 t,那么:
p >= t判为正,可能错(假阳性),每次损失C_fpp < t判为负,可能错(假阴性),每次损失C_fn
def expected_loss(rows, t, c_fp, c_fn):
    """在阈值 t 下的期望损失。"""
    loss = 0.0
    for r in rows:
        p, y = r["p"], r["label"]
        if p >= t and y == 0:
            loss += c_fp      # 误报
        elif p < t and y == 1:
            loss += c_fn      # 漏报
    return loss / len(rows)

def best_threshold(rows, c_fp, c_fn, grid=None):
    """扫描阈值网格,找期望损失最小点。"""
    grid = grid or [i / 100 for i in range(5, 100)]
    scores = [(t, expected_loss(rows, t, c_fp, c_fn)) for t in grid]
    return min(scores, key=lambda x: x[1])
C_fp 和 C_fn 怎么估?不需要精确到分,只要量级对就够了:
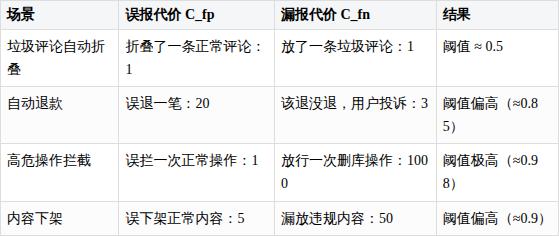
注意第二行的反直觉之处:自动退款的误报代价比漏报高 6 倍,所以阈值要往高推。 很多人凭直觉觉得“宁可多退也别漏退”,那是把代价估错了——误退意味着资金损失加财务对账成本,而漏退只是一笔工单。
曲线的形状值得留意:底部通常比较平。这意味着在最优阈值附近 ±0.05 的范围内,损失差异很小。所以不必纠结精确值,选个整数、写进配置、加上注释说明代价假设,比调到小数点后两位重要得多。
六、级联:Jev 真正的价值是分流器
回到第三节那条被低估的数据:Jev 前置 + Opus 兜底,准确率追平 Opus,成本 38%~45%。
这个结构值得单独讲,因为它是 Jev 最可能落地的形态。
为什么级联比替换更合理
很多人拿到 Jev 的第一反应是“我要用它替换掉现有的 LLM 分类调用”。这个思路在两处会碰壁:
- 精度天花板:在 77 类路由上,Jev 比旗舰低 7 个点。有些业务就是需要那 7 个点。
- 尾部风险:Jev 会在某些样本上很不确定,这些样本如果硬判,错误率会很高。
级联的思路完全不同:让 Jev 处理它擅长的那部分流量,把不确定的部分交给贵模型。
关键洞察是——Jev 的置信度和它的正确率强相关。第三方实测显示 ≥0.9 时正确率 94%~96%,这意味着我们可以用置信度做覆盖率旋钮:
- 阈值设 0.95:可能只有 40% 的流量被 Jev 直出,但这 40% 几乎不会错;
- 阈值设 0.70:可能有 80% 的流量被直出,精度略降,但成本大幅下降。
实现
from typesafe_sdk import Choice, TypeSafeClient

class Cascade:
    """Jev 先判,判不稳就交给兜底模型。"""

    def __init__(self, criteria, threshold=0.80, fallback=None):
        self.client = TypeSafeClient(model="jev-1.13.0")
        self.criteria = criteria
        self.threshold = threshold
        self.fallback = fallback
        self.stats = {"jev": 0, "fallback": 0}

    def route(self, state: str) -> dict:
        r = self.client.system_one(
            state=state,
            questions={"q": Choice(
                instructions="这条请求应该归到哪个类目",
                criteria=self.criteria,
            )},
        )
        ans = r.answers["q"]

        if ans.confidence >= self.threshold:
            self.stats["jev"] += 1
            return {"label": ans.choice, "source": "jev",
                    "confidence": ans.confidence}

        # 置信度不够,交给兜底
        self.stats["fallback"] += 1
        if self.fallback is None:
            return {"label": None, "source": "human"}
        return {"label": self.fallback(state), "source": "fallback"}

    def coverage(self) -> float:
        total = sum(self.stats.values())
        return self.stats["jev"] / total if total else 0.0
coverage() 是你要持续盯的指标。覆盖率 × Jev 精度 + (1 - 覆盖率) × 兜底精度 = 整体精度,而成本则是 覆盖率 × Jev 单价 + (1 - 覆盖率) × 兜底单价。这两个公式一起,就能画出你自己的成本-精度曲线,找到属于你业务的那个拐点。
第三档:不要忘了“拒绝”
上面是两档级联。真正健壮的系统应该有三档:
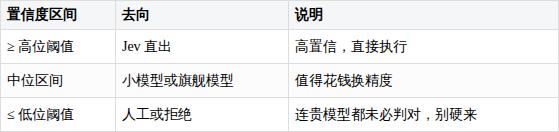
第三档经常被忽略,但它很重要。当置信度极低时,往往说明输入本身有问题——信息缺失、表述歧义、或者根本是域外样本。这种时候把请求丢给更贵的模型,只是在用更贵的方式犯同样的错。
七、五条工程规则
这部分是从社区实践里提炼出来的,每一条都有实测数据支撑。
规则一:一次把问题问完
Jev 的请求里,问题是并行评估的。官方 cookbook 有一组很说明问题的数据:对一篇约 54,000 字符的 GDPR 维基百科文章,问 13 个问题(8 个 Noul、2 个 Choice、3 个 Score)——
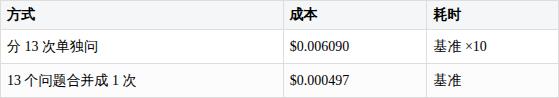
便宜 12.2 倍,快 10 倍。
原因很直接:输出不计费,state 才是成本大头。发 13 次请求等于把 54,000 字符传了 13 遍。
这颠覆了大模型时代养成的直觉。我们习惯了“先便宜地问一句,需要再追问”,但在 Jev 这里,反过来才对:把能想到的判断一次性全问了,让代码去挑哪些用得上。
# 反例:分三次问,state 传三遍
for q in ["是否要求退款", "是否涉及重复扣费", "情绪是否激动"]:
    client.system_one(state=ticket, questions={"q": Noul(instructions=q)})

# 正例:一次问完
client.system_one(
    state=ticket,
    questions={
        "refund":     Noul(instructions="用户是否明确要求退款"),
        "dup_charge": Noul(instructions="用户是否提到被重复扣费"),
        "angry":      Score(instructions="用户情绪激烈程度",
                            criteria=["平静陈述", "明显不满", "强烈指责"]),
    },
)代价:多问一个问题会多花一点 input token(问题描述本身要计费)。但和重发一遍 state 相比,这点开销可以忽略。
规则二:一个问题只做一个判断
和规则一配套的约束:可以一次问很多问题,但每个问题内部必须原子。
不要这样问:
这个工具调用和工具结果是否还重要?如果重要,请判断是否应该截断。这是两个判断混在一起。拆成两个 Noul:
call_matters:知道这个工具调用被发起过,对后续任务还有意义吗?
result_matters:这个工具结果的完整内容还需要保留吗?
一个容易踩的坑
一个 Noul 和一个看起来等价的 Choice,返回的数值可能不一样。 TypeSafe 文档里明确记录过这种情况。比如“用户是否要求退款”,用 Noul 问得到 0.88,用 Choice(criteria={"yes": "要求退款", "no": "不要求退款"})问可能得到 0.76。这不是 bug——两者问的是不同的统计问题。Noul 直接估计 P(命题成立);Choice 在一个二项集合上做归一化,还要处理选项描述的语义。别指望它们算术一致,更别写 assert noul == choice_prob["yes"] 这种断言。
规则三:先精确检索,再便宜判断
Jev 没有外部知识。它只知道你塞进 state 的东西。
更麻烦的是社区里提到的 context rot:state 里无关内容越多,判断准确率越低。这和我们熟悉的“上下文越长模型越蠢”是同一类问题。
所以正确的顺序是:
① 用代码做精确检索(向量、关键词、SQL、规则)
        ↓
② 把检索结果 + 问题组装成精简的 state
        ↓
③ 交给 Jev 做语义判断
不要用 Jev 去做代码能精确算的事。 这是元规则,也是最容易犯的错:判断“这个订单金额是否大于 1000”、“这段文本是否超过 500 字”、“这个 ID 是否在白名单里”——这些用 if 一行搞定,又快又不会错。Jev 该做的是代码算不了的那部分:语义、意图、语气、相关性。
规则四:版本要 pin 死
SDK 的默认模型是 jev-latest,它今天指向 jev-1.13.0,但会随官方发布移动。还有个 jev-preview 别名,会先动。
# 反面教材:生产环境用 latest
client = TypeSafeClient()                      # → jev-latest

# 正确做法
client = TypeSafeClient(model="jev-1.13.0") # 锁死为什么这条这么重要?因为你的阈值是在当前版本上校准出来的。模型一迭代,校准曲线就变了,你那套精心调过的 execute_at=0.97 可能突然就偏了。
正确流程是:新版本发布 → 在影子模式下跑一遍 → 算新的 ECE → 必要时重新标定 → 再切。这也意味着你的验证样本集要长期保存,它是你做版本迁移时的回归基线。
规则五:给每个判断点配一个兜底
Jev 会失败。网络超时、限流、返回格式异常、压缩收益不足——所有这些都要有出口。
def safe_decide(state, question, default=0.5):
    """判断失败时,退回一个保守值,而不是让流程崩掉。"""
    try:
        r = client.system_one(state=state,
                              questions={"q": Noul(instructions=question)})
        return r.answers["q"].noul
    except Exception as e:
        log.warning("jev failed: %s", e)
        return default      # 0.5 → 落在"不确定"区间 → 走兜底分支
注意 default=0.5 的选择:失败时返回“不确定”,而不是返回“否”。 这样策略层会自动把它导向 CONFIRM 或 ESCALATE 分支,系统降级但不失控。
八、什么时候不该用 Jev
讲了这么多该用的,也该说说不该用的。有四种情况,Jev 大概率不是好选择。
1. 判据说不清楚的任务
第三节已经讲过。答案质量评分垫底就是因为标准不可枚举。如果你写不出让两个标注员达成一致的 criteria,别用。
2. 错误代价极高的不可逆操作
删除生产数据、划转资金、关闭权限——这些不该由任何单一模型的单一判断决定,无论它返回 0.99 还是 0.999。
概率再准也是概率。正确的做法是要求第二重独立信号:Jev 判断 + 规则校验 + 人工确认,三取二。
3. 已经有 fine-tuned 分类器的场景
有个很中肯的案例:一位开发者拿 Jev 和他几个月前微调的 BERT 做对比,任务是克罗地亚语文本二分类,3000 条样本——
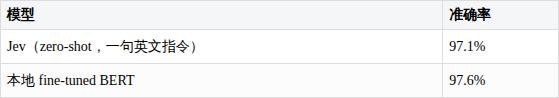
差距很小。如果你的场景已经有训练好的专用模型,先测再换,别为了追新而换。Jev 在这里的收益主要是省掉了微调的工程成本,不是精度提升。
4. 需要向用户解释理由的场景
Jev 不生成文本。你可以拿概率做决策,但没法让它告诉你“为什么是这个分类”。
如果产品要求给出判断依据(比如风控拒绝要给理由、内容审核要说明违规点),那么 Jev 只能做前置筛选,最终的解释还得由 LLM 生成。
一个容易忽略的成本陷阱
最后提醒一个反直觉的点:Jev 的 input token 数可能比 LLM 更多。
因为计费输入 = state + 所有问题描述 + 所有选项描述。在 77 类路由这种选项极多的任务上,光是 77 条选项描述就是一笔不小的 input。实测中 Jev 单次调用的 input token 数超过了 GPT-6 Sol。
大部分情况下这不改变结论——Jev 的单价低 45 倍左右——但在选项极多、state 极短的场景,便宜的 LLM 反而可能更省。实测里就有一个反例:路由任务上,DeepSeek V4 Flash 每百万次决策 $77,Jev 是 $98。
所以选项描述要写短,不要塞进根本不可能适用的选项。 这不是风格问题,是直接的账单问题。
九、上线清单
把上面所有内容压缩成一份可执行的清单:
阶段一:影子模式(1~2 周)
- 攒 300~500 条真实流量样本,人工标注
- Jev 和现有方案并行跑,只记日志,不影响线上
- 画可靠性图,算 ECE
- 统计置信度分布,看覆盖率-阈值曲线
- 用代价矩阵算出候选阈值
阶段二:灰度(1~2 周)
- 只对低风险动作启用自动执行(只读、可撤销)
- 高风险动作保留人工确认
- 监控三个指标:覆盖率、低置信占比、错误工单量
- 和影子期的预期损失做对比
阶段三:全量 + 长期监控
- 每周抽样 100 条人工复核,持续更新校准表
- 模型版本升级时,先跑回归样本集,重算 ECE
- 设置漂移告警:置信度分布突变、覆盖率骤降、ECE 上升
其中“每周抽样复核”这一条最容易被砍掉,但它恰恰是长期保持校准的唯一手段。你的业务在变,用户说话方式在变,去年校准好的阈值今年未必成立。
结语:给判断定价
Jev 这类模型带来的变化,其实不是技术上的——分类、约束输出、logits 打分、概率校准,这些零件以前都有。
真正的变化是经济上的:当一次判断的成本从“几分钱加几秒钟”降到“几万分之一分钱加一百毫秒”,你会开始在系统里那些原本不值得调用模型的地方调用模型。
原本你不会为了“这段日志还要不要留”去调一次 GPT。但现在你可以为每一条工具结果、每一个检索片段、每一次分支选择各做一次判断——因为便宜到可以忽略。
但便宜不等于免费,更不等于正确。概率是原材料,不是成品。 从概率到动作之间,隔着校准、阈值、级联、兜底这四道工序,它们才是决定这个系统靠不靠谱的地方。
所以别再问“Jev 准不准”了。
该问的是:我的误报和漏报各要赔多少钱?我的阈值配不配得上那个数字?我的兜底分支写了吗?
把这三个问题回答清楚,Jev 才真的能用。
最后回到开头那套理论。卡尼曼写《思考,快与慢》,想说明的是:人的大多数错误,来自该慢的时候太快。
而过去两年的 Agent 工程,犯的其实是相反的错——该快的地方慢得离谱。一个简单的判断也要走完整套生成链路,既慢又贵,于是工程师开始偷工减料:跳过检查、减少筛选、砍掉复核。
Jev 这类模型的意义,是让“快”重新变得正当。当快判断的成本低到可以忽略,你才有底气把昂贵的推理资源留给真正需要它的地方——该慢的地方,终于可以慢下来。