ACL 2026|大模型指导化学合成实验?上海交大ChemReason-Bench揭示AI「做实验」的逻辑短板
随着有机合成、材料开发、药物筛选等领域迈向高度自动化,我们与「无人实验室」之间的距离,已不再是机械臂的精度,而是一道语言与逻辑的鸿沟。
学术文献中,化学合成实验流程常以自然语言方式撰写,实验步骤间暗含了无数约定俗成的操作惯例和严格的依赖关系。一个试剂加入顺序的错误,或是一个后处理步骤的遗漏,都可能导致整个合成失败。当前的大语言模型虽已掌握海量化学知识,但会答题的模型,真的会「做实验」吗?
近日,上海交通大学计算机学院、人工智能研究院 AI for Science 团队在许岩岩副教授等人的指导下,发布了 ChemReason-Bench—— 首个大规模、人工验证的实验程序推理基准,专门用于诊断大语言模型在理解与生成可执行实验流程时的逻辑短板。该工作已被自然语言处理顶级会议 ACL 2026 录用。项目代码、数据与更多细节已全面开源。
GitHub 项目地址:https://github.com/Khadaz/ChemReason-Bench
痛点:化学知识 ≠ 程序推理
现有的化学大模型评测大多聚焦于知识问答,模型只需在一组选项中挑出正确答案。然而,真实的实验设计要求模型具备跨步骤的约束满足能力:前一步的反应状态会限制后一步的操作,一个看似合理的化学建议可能与整个流程的操作约束相冲突。
这种「程序一致性」的缺失,会带来严重的评估盲区 —— 一个在多选题中表现优异的模型,可能在生成完整实验流程时犯下致命错误。缺乏对这一能力的诊断工具,就无法定位模型失败的具体环节。
ChemReason-Bench:
给模型的「实验逻辑」做一次全面体检
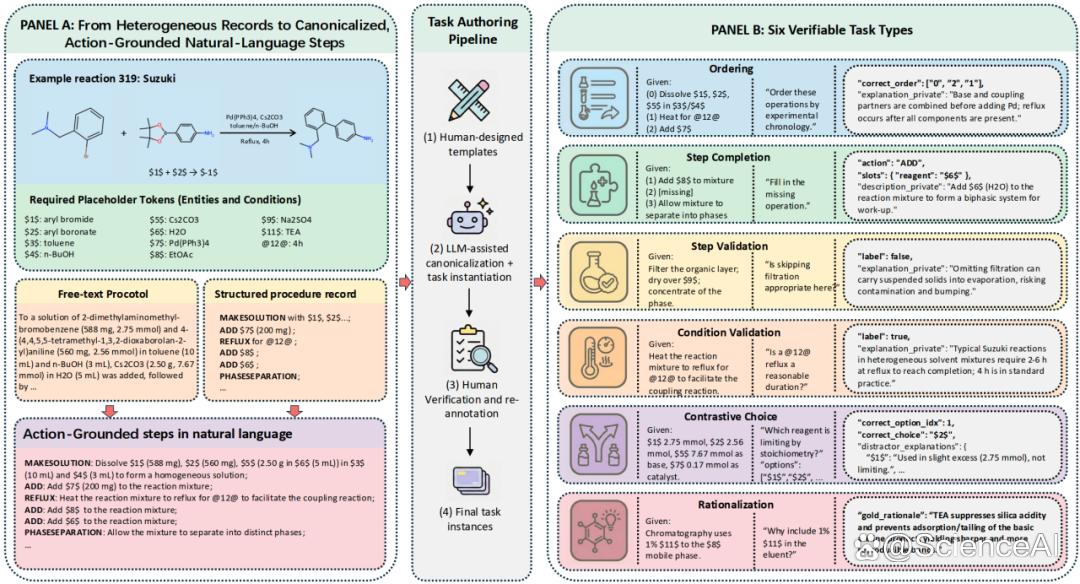
ChemReason-Bench 摒弃了单一的总分评估,而是将实验程序推理拆解为六种互补的能力维度,进行全方位诊断。它基于一个统一的、带有明确占位符的结构化框架,使得大量操作约束可以自动验证。
基于 500 个有机合成反应,研究团队构建了 7,306 个人工验证的高质量任务实例,涵盖以下六类任务:
步骤排序:给定几个候选操作,判断它们的正确先后顺序。
步骤验证:判断一个候选动作在当前实验语境下是否可行。
条件验证:判断给定的温度、时长等反应条件是否合理。
步骤补全:在实验流程的「空缺」处,生成一个符合前后约束的正确操作。
对比选择:从具有迷惑性的选项中,准确识别出物质角色。
原理解释:为某个实验操作或条件选择提供背后的因果逻辑。
通过这一多任务设计,研究者可以绘制出模型的能力雷达图,清晰揭示其强项与短板。
核心发现:结构化生成是最大瓶颈,专业化学模型不敌通用模型
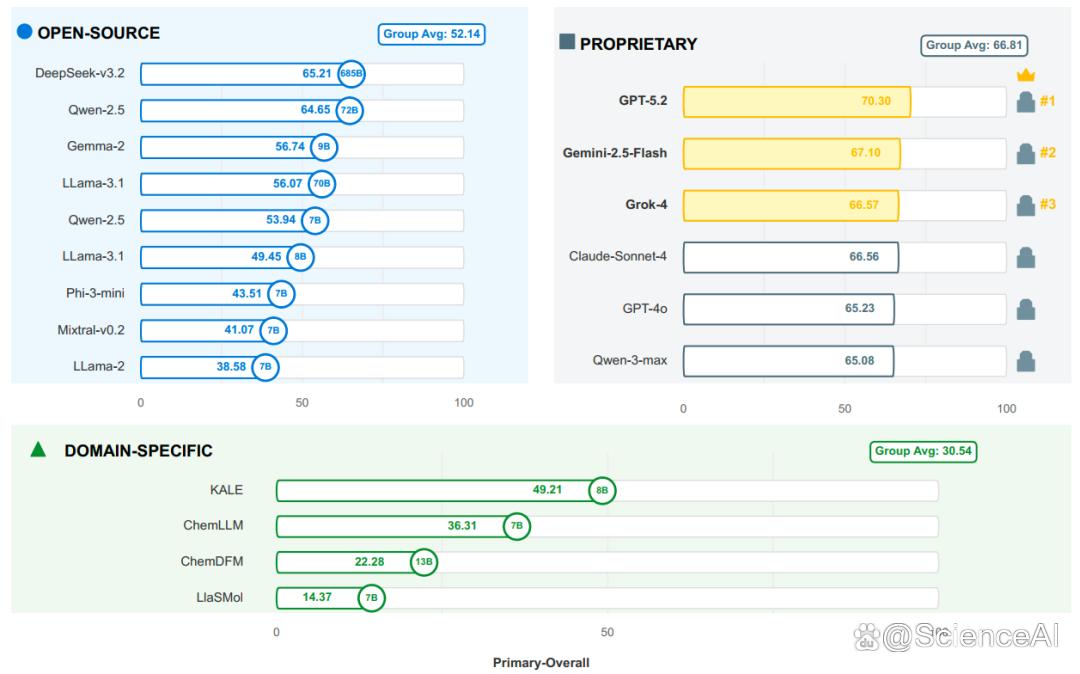
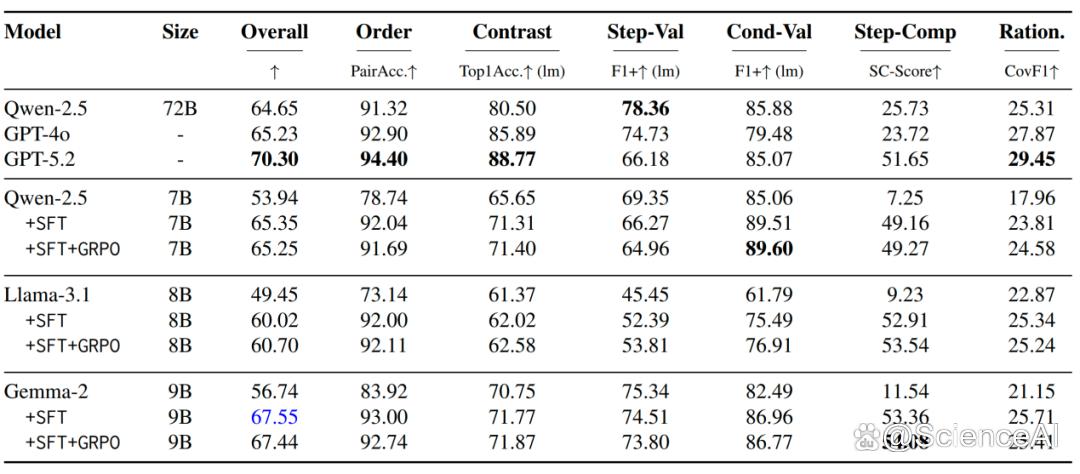
研究团队对包括 GPT-5.2、DeepSeek-v3.2、Llama-3.1 以及 ChemLLM 等在内的 18 个开源、闭源及领域专用模型进行了统一评测,主要发现如下:
(1) 顶尖通才模型初步具备程序推理能力:表现最强的 GPT-5.2 取得 70.30 的综合得分,DeepSeek-v3.2 紧随其后(65.21),显示出在程序一致性方面的初步进展。
(2)「步骤补全」是公认的超级难题:在所有任务中,步骤补全的得分相对低。即便最强的 GPT-5.2 也仅获得 51.65 分。这揭示出,在严格的约束下生成一个完全正确的结构化操作步骤,仍是当前模型面临的重大挑战。
(3) 化学专用模型表现不佳:ChemLLM、ChemDFM、LlaSMol 等经过领域数据训练的模型,在该基准上全面落后于通用大模型。这说明,实验程序的逻辑推理能力,远非简单的领域语料扩充所能赋予,它更需要基础的规划与约束遵循能力。
(4) 生成与决策的不一致现象:部分模型在自由文本生成时表现尚可,但在要求直接输出「是 / 否」等离散决策时却暴露出明显的概率偏差。这种「表里不一」揭示了模型决策过程内在的不稳定性。
从评测到进化:用可验证反馈训练「会思考」的 AI 助手
ChemReason-Bench 不仅是一把「尺子」,更是一套「训练器械」。团队同步发布了一个包含超过 12 万个任务实例的大规模训练集 ChemReason-TUNE。
实验表明,通过在 ChemReason-TUNE 上进行监督微调,Gemma-2-9B 等小模型可以在该基准上取得与顶尖闭源模型相当的性能,为未来在实验室内本地化部署轻量级、高可靠性的化学实验 AI 助手提供了清晰路径。
结语:迈向「语言驱动」的化学研究新范式
ChemReason-Bench 的推出,标志着化学大模型的评估正从浅层的知识问答,迈向深层、多维度的程序逻辑验证。它揭示了一个清晰的现状:即便最强大的 AI,在「动手实操」的逻辑一致性上,距离可靠的化学家仍有不小的距离。
这只是一个新的起点。我们相信,随着可验证评测体系的完善与模型训练范式的革新,大语言模型有望真正跨越化学实验的「最后一道语言壁垒」,从「能说会道」走向「能做会做」,成为未来智能合成平台真正可靠的逻辑引擎。
团队介绍
上海交通大学人工智能研究院 AI for Science 团队在杨小康教授、金耀辉教授、许岩岩副教授带领下,包括十余位博士后与硕博研究生,重点研究生成式人工智能,特别是科学大模型赋能化学研究,针对有机化学合成、自动化实验等重大问题提出了一系列创新解决方案。
团队发布了首个化学合成大语言模型 —— 白玉兰科学大模型 Chemma,是首个具备反应生成与「人在环路」反馈优化能力、能够指导实验探索的化学大模型,并建设了白玉兰合成科学自主智能实验室(BSAIL),实现了以科学大模型为大脑、拥有具身操作能力的「干湿闭环」自主无人实验系统。