卡住AI的是什么:Anthropic用120个真实病毒检索任务为生物学中的智能体铺平道路
编辑丨&
人类似乎已经习惯于 AI 带来的突破:预测蛋白结构、设计抗体、发现药物分子、分析基因组数据。似乎只要模型再强一点,实验室里的许多工作都能被自动化。
那么新的问题由此诞生。
如果未来的 AI 不再只是回答问题,而是像研究员一样自己查数据库、整理数据、运行分析流程、提出假设并验证结果,那么生物学是否已经准备好了迎接这样的「scientific agents 」?
2026 年 6 月 8 日,Anthropic 的「Paving the way for agents in biology」文章中对此问题进行了深入思考。他们认为,很多时候,真正的瓶颈藏在更底层的地方——数据库、检索系统,以及那些几十年来为人类研究者设计、却从未为 AI 设计过的生物信息学基础设施。
为了验证这一点,研究团队让多个当前最先进的 AI 系统完成真实病毒学研究中的数据检索任务。结果显示,即使面对完全相同的问题,不同运行之间得到的数据集也可能相差数十倍;而这种差异最终足以改变疾病传播分析、进化树重建甚至药物评估的结论。
原文链接:https://www.anthropic.com/research/agents-in-biology
案例研究:病毒学
软件世界像是为汽车修过的道路,版本控制、标准化 API、包管理器这些东西,天然就是给机器和自动化流程准备的;而生物数据库则过于难用。毕竟人类不能期望机器理解生物。
为了把这件事说得更实,团队做了一个名叫 VirBench 的基准,里面有 120 个人工核对的病毒序列查询,覆盖 40 种病原体,任务来自真实 virology 工作流,包括监测、诊断试剂设计和训练数据构建。
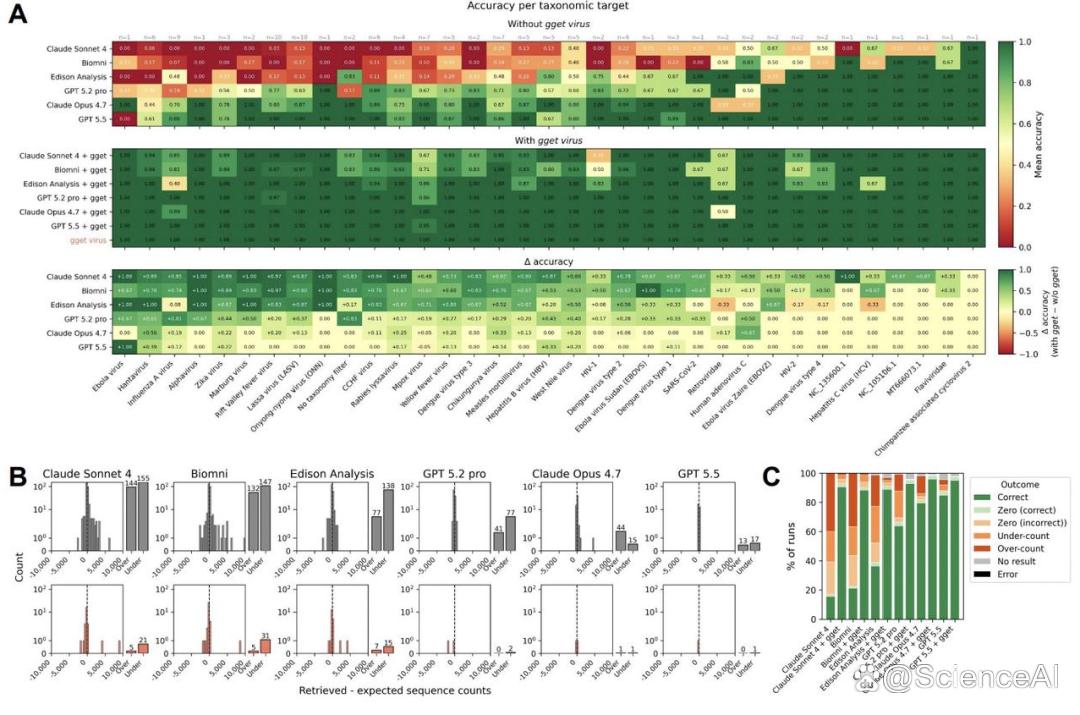
图 1:VirBench 各分类体系中代理的性能和故障模式。
每道题最多带 16 个过滤条件,既有宿主、地理位置、日期范围、序列长度、完整性,也有分段病毒、疫苗株状态这些更细的约束;为了让结果可复现,大多数题还加了最大发布日期限制。
这些题目反映了病毒监测、诊断检测设计和蛋白质模型训练数据构建中出现的任务,以测试最先进的科学研究学员(如 Claude Sonnet 4、Claude Opus 4.7、Biomni OSS、Edison Analysis、GPT)在利用现有基础设施从病毒中检索病毒序列时的能力。
Anthropic 选了一个「细节决定生死」的例子:2014 年 West African Ebolavirus(埃博拉病毒) outbreak 的序列检索。对同一个查询,尽管每次的提示都相同,但 Claude Sonnet 4 三次运行却分别返回了 106、15 和 5 条序列,而期望值是 266。
这种波动足以把下游分析彻底带偏:人工整理的数据能恢复出 2014 年 1 月的 TMRCA,和既有报告一致;但模型生成的数据集却能把推断时间推到 1922 年,或者因为漏掉 Guinea 的样本,把时间改写成 2014 年 4 月。
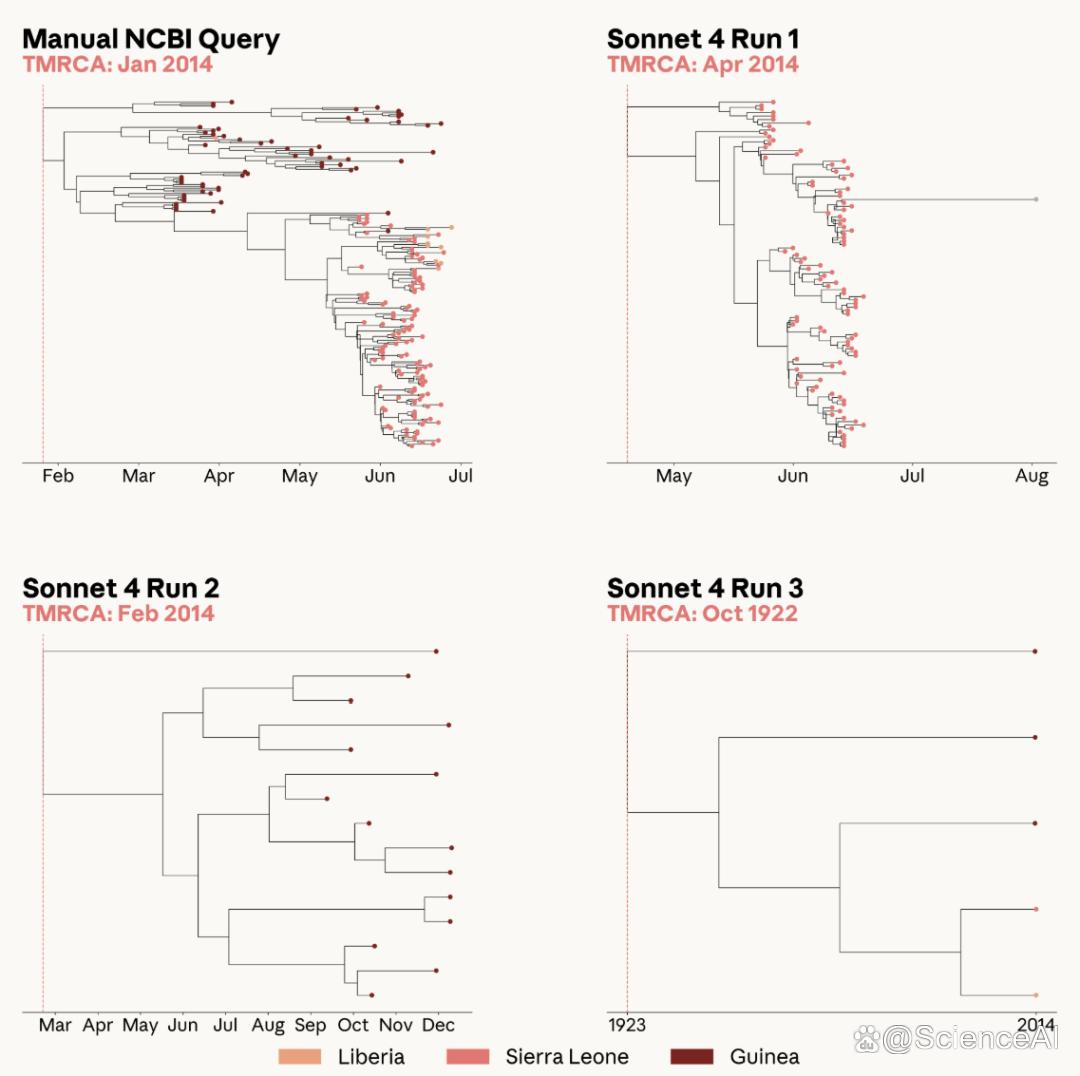
图 2:利用 Delphy 推断出 2014 年西非疫情中的埃博拉病毒系统发育树。第 1 至 3 次由 Sonnet 4 生成。
同样的脆弱性也会打到治疗分析上。文章拿埃博拉病毒糖蛋白的变异分析做了另一个例子:如果序列检索不稳,突变分布就会在不同运行里给出三种不同印象。对公共卫生和治疗决策来说,这不是「结果有点不一样」,而是会直接影响「病毒从哪儿来」「诊断还能不能用」「现有治疗还能不能顶住」这三个问题。
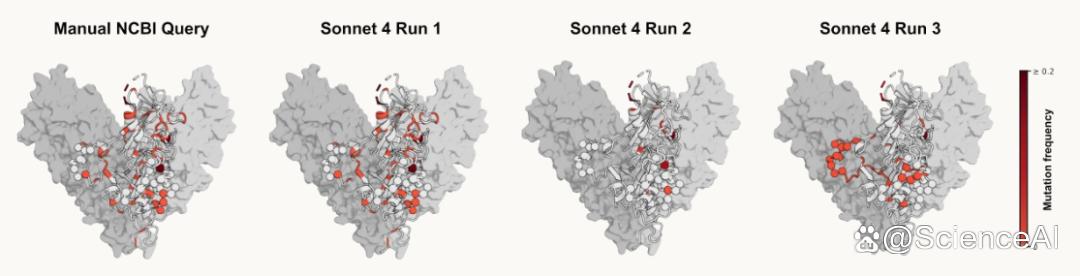
图 3:现有埃博拉病毒糖蛋白上的突变(红色)。第 1 至 3 次由 Sonnet 4 生成。
gget 病毒
于是研究团队和 NCBI 合作做了 gget 病毒。它把 NCBI Virus 网页里那些原本只存在于界面逻辑中的过滤规则,正式化成一个可脚本化、可复现的命令行和 Python 工具。
它会协调 REST、Datasets 和 E-utilities,决定哪些过滤能直接在远端做,哪些必须本地补做;它会处理分页和批量下载,避免像 SARS-CoV-2 或 Influenza A 这种大结果集被半路截断;当某些筛选依赖 GenBank 中的额外信息时,它还会把这些记录拉回来一起判断。最后,输出的不只是结果,还有能让人和机器都复查的日志。
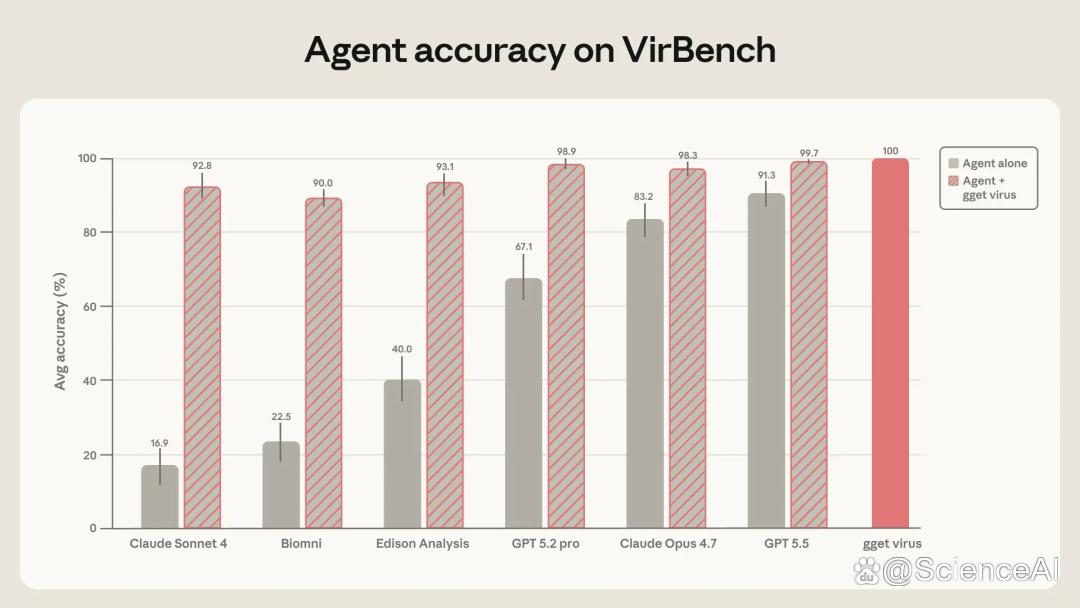
图 4:VirBench 基准测试中的 AI 智能体性能,无论是否携带 gget 病毒。
当赋予智能体访问 gget 病毒的权限时,所有智能体的准确率都超过了 90%,GPT-5.5 的准确率峰值达到 99.7%。运行间的变异性基本消除,模型间的性能差距大幅缩小。
换句话说,添加确定性检索层使模型选择的重要性大大降低。
所以一旦把检索层做成确定性的,模型之间的差别就没那么重要了;真正决定结果的是底下那层基础设施。
让数据对智能体开放
团队表示,仍然希望模型在提出假设、设计实验、推理机制时保持创造性,但在基因标识符、模式、检索逻辑、坐标系统、元数据约定和数据访问路径这些底层层面,系统必须「无聊到可信」。
作者也承认,未来某一天智能体也许能自己穿过这些杂乱门户,但即便如此,重复造轮子也未必划算;对生物数据库来说,更重要的是从现在开始就按智能体的使用方式来设计。