OpenAI:面向基因组分析等生物学任务的新一代评估与应用框架GeneBench-Pro
编辑丨&
在传统的 AI 评测中,大模型只要依靠强大的检索和长文本记忆,就能轻松在各种生物学考试中拿到高分。但真实的生命科学研究充满着物理世界的噪声、复杂的代码流水线以及连续的因果链条。
围绕这个问题,OpenAI 设计了 GeneBench-Pro,不再只关注模型在单一子任务上的表现,它进一步扩展了基因实验室,涵盖基因组学、定量生物学和转化医学等更难、更现实的任务,捕捉计算生物学科学研究的复杂性、迭代性和模糊性。
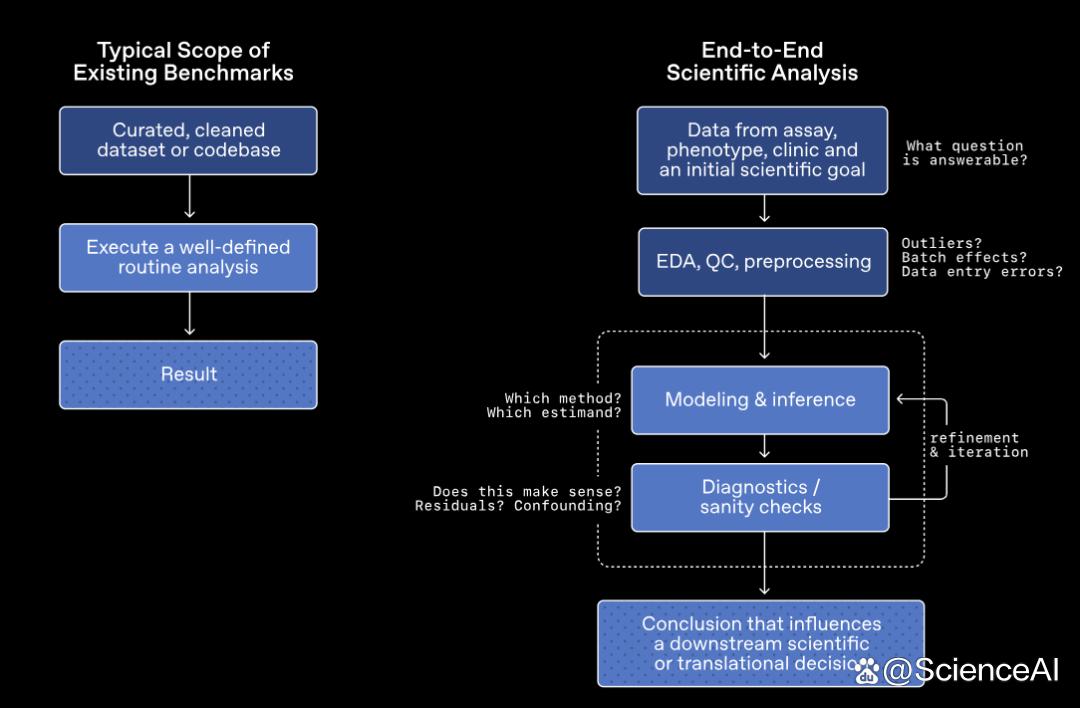
图示:生物学领域的基准差距。
它旨在精确测量如处理歧义、修正假设、选择正确的分析路径并下达决策等高级能力。每个 GeneBench-Pro 问题都为模型提供了真实且混乱的数据集、简短的实验背景,以及与下游决策相关联的目标估计数。要正确回答,模型必须探索数据,选择合适的分析方法,进行迭代实验,并给出最终答案。
数据集构建
生物学领域,数据生成成本大幅降低,这也导致部分研究者认为限制因素已经变为下游的计算与分析。GeneBench-Pro 旨在评估解决这一瓶颈的进展,共有129个问题,涵盖了广泛的计算生物学环境和方法。
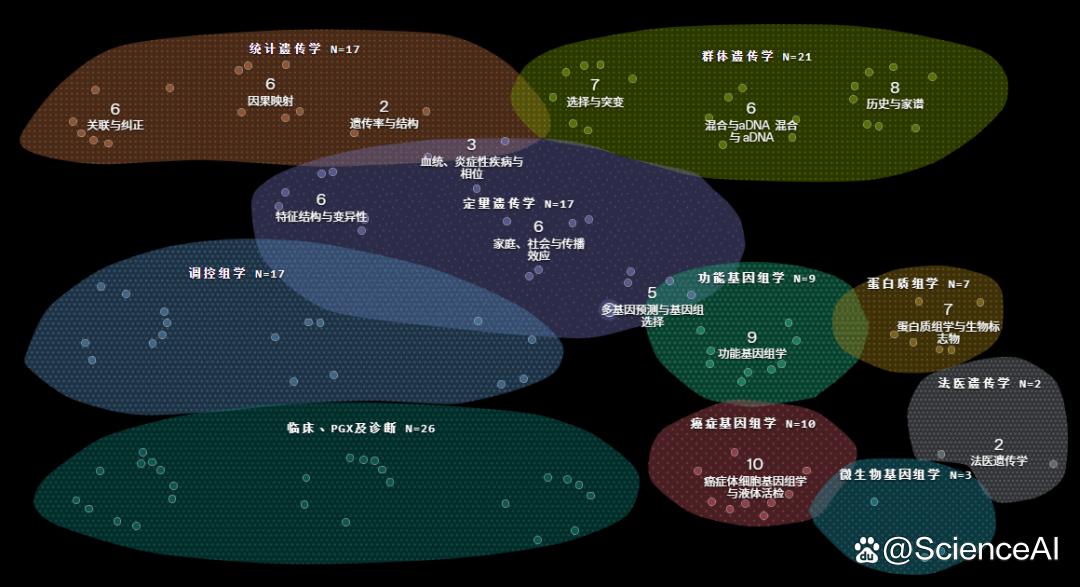
图示:领域图集:10 个领域和 21 个子领域中的 129 个问题。
为了保证评估的绝对客观与严谨,GeneBench-Pro 特意避开了传统长期生物学基准常犯的两大失败模式:
避免任意的选择偏好:许多旧的基准直接围绕混乱的历史数据集构建多步骤问题。在这种情况下,分析过程中往往没有单一正确的路径。AI 1 可能选择了一个完全可辩护的过滤截止点,而 AI 2 则可能选择另一个同样合理的选项。最终的评分差异往往只能反映基准创建者主观的任意选择,而无法体现模型在生物学性能上的根本差异。
避免数值敏感性过低:反之,有些基准问题设计得过于粗糙,即便 AI 在数据处理或中间分析中犯下了不可饶恕的根本性生物学错误,最终竟然误打误撞依然能得到及格的数值结果。
为了彻底杜绝这些失效模式,GeneBench-Pro 中的每一个问题全部采用合成构建的方式。
OpenAI 的研究人员完全掌握了数据底层的因果结构,并直接通过数学和物理模型模拟了整个数据的生成过程。这使得基准能够自由调整每个难题的复杂性,既能确保主观分析选择的合理差异仍能产生被接受的正确数值结果,又能通过消融研究严格验证那些听起来合理但实际上错误的分析路径。
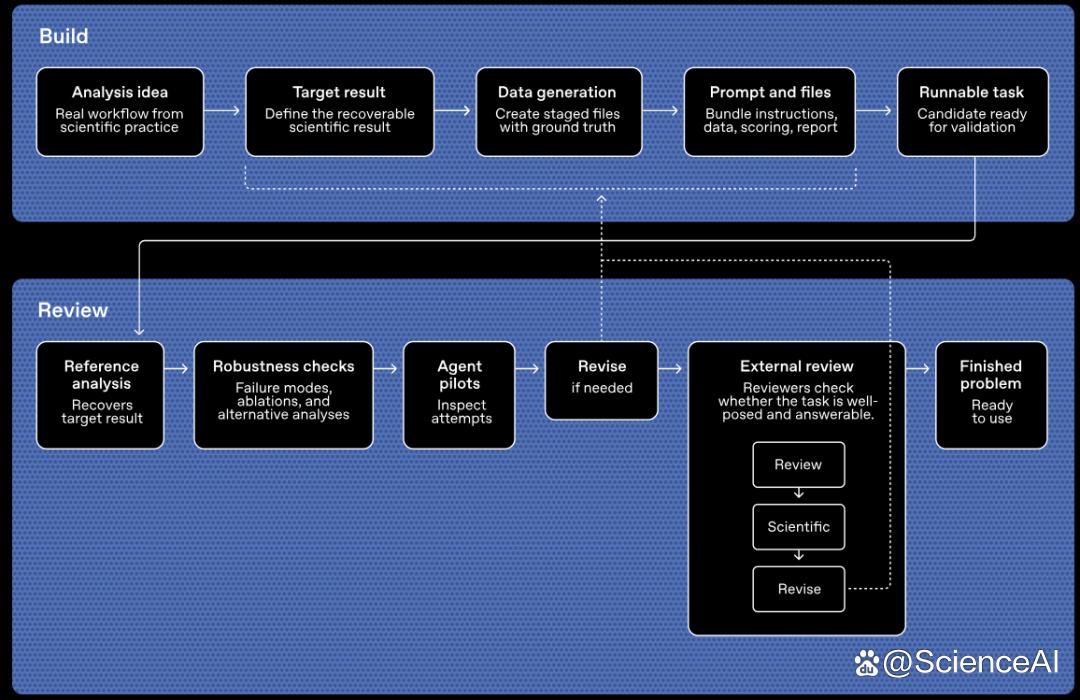
图示:GeneBench-Pro 问题的构建与验证。
评估与评分
OpenAI 将 129 个 GeneBench-Pro 问题中的 82 个直接发送给了顶尖的外部领域专家进行深度评审,评审团由知名高校的研究生、博士后研究员、工业界科学家以及终身教授组成。
两位来自加州大学的评估者表示,那些在 GeneBench-Pro 问题上表现良好的模型显然能帮助研究人员确定正确的工作流程并探索数据,并识别出了潜在的陷阱问题。
每个 GeneBench-Pro 问题都是自成一体的科学分析。在问题解析中,AI 获得一个隔离的工作空间,包含简短提示、数据文件和标准生物信息学堆栈。
这些问题囊括了结构变异导向肿瘤治疗的益处-风险决策、CRISPR 靶点验证、关联遗传位点中的蛋白质药物靶点、DRX1 载体筛选残余风险与父母特定祖源及近期混血时间。每个问题还附带丰富的元数据,包括预期的分析结构、附加数据文件、详细的多页案例研究以及专家评审结果。
测试结果
目前 OpenAI 家族中最强悍的推理模型 GPT-5.6 Sol,在启用了最高推理层级时,拿到了 31.5% 的通过率。而在常规最高推理层级下,其通过率为 28.7%。虽然不到三分之一,但这相比于早期构建该基准时的初代 GPT-5(得分低于 5%)已经实现了跨越式的巨幅增长。
以目前模型的高速改进速度来看,这一极具挑战性的基准可能在年底前就会达到饱和状态。
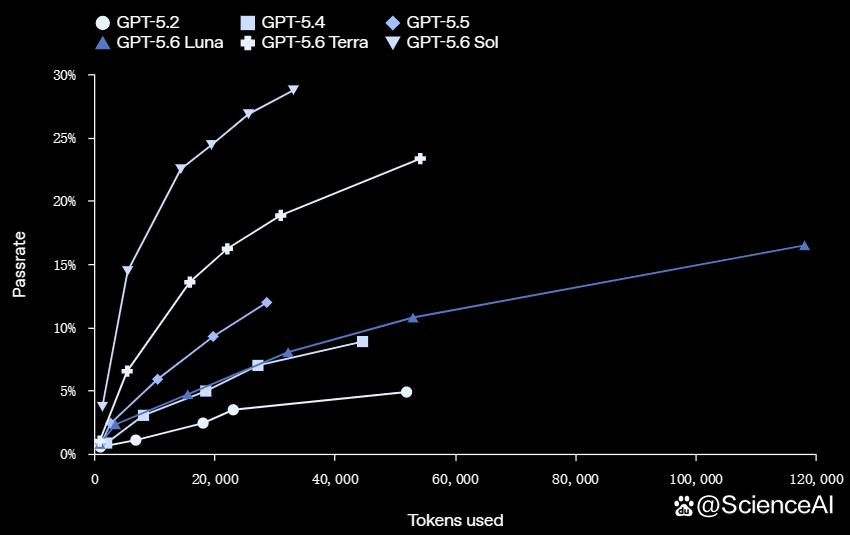
图示:GeneBench-Pro:在 GPT 模型上测试计算性能的提升情况。
GPT 模型在面对存在定量不确定性的高级科学推理任务时,表现出了极强的统治力。GPT-5.6、GPT-5.5 与 GLM 5.2 等主流开源模型之间的性能鸿沟,远比人们在常规编码基准测试中推断出的差距要大得多。
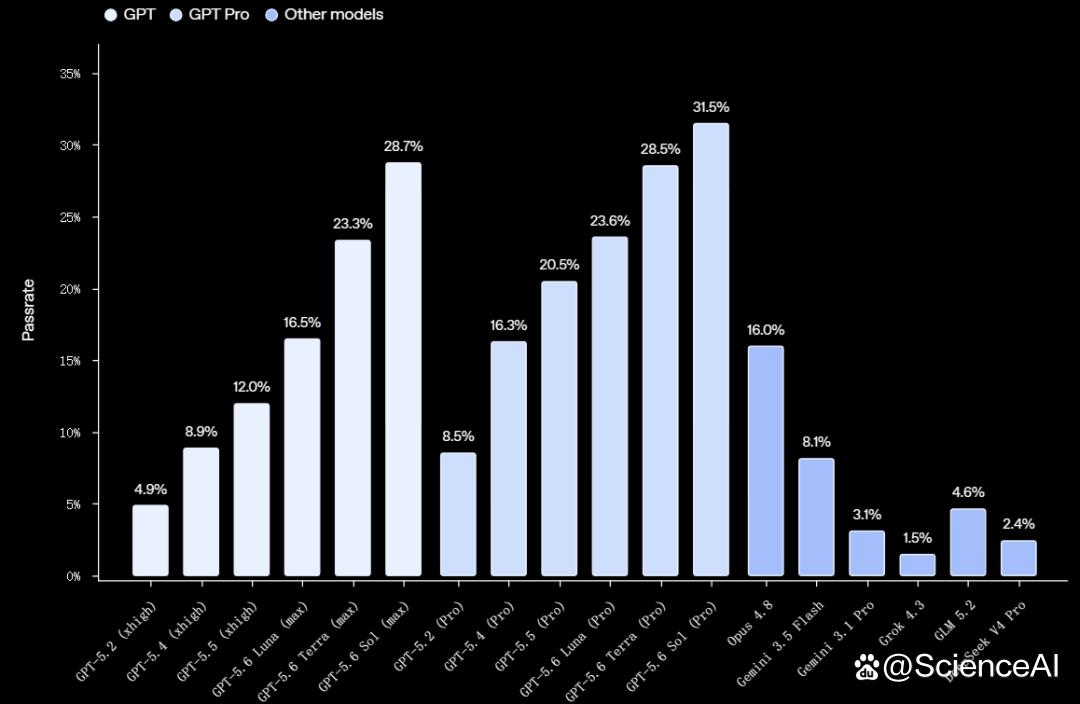
图示:GeneBench-Pro:模型通过率最高推理。
考虑到 GeneBench-Pro 题目的变态难度,GPT-5.6 Sol 斩获的 31.5% 成绩已经足够令人侧目。在一项针对外部评审专家的内部调查中,评审们估计,人类专家平均需要耗费大约 20 到 40 个小时才能完整、独立地解决单个 GeneBench-Pro 问题。
能力转化方案
不过,前沿模型仍能解决不到三分之一的问题,这表明仍有很大改进空间。模型可以在具有挑战性的问题上取得部分进展,但它们难以闭合推理循环。这种失败模式反映了人类专家与新手之间的对比。专家们利用经验来构建问题框架并调整方法,而新手则会做出观察,但难以将其融入更广泛的问题背景中。
要实现近乎完美的性能,需要评估既能可靠衡量进展,又能识别模型仍然存在的缺陷。像 GeneBench-Pro 这样的基准测试就会起到很大作用。
与此同时,测序成本大幅下降,生物样本库规模的数据集现在以前所未有的广度连接分子、表型和健康记录信息。限制因素在于从数据生成转向将信息转化为可操作的洞察。能够持续执行由人类专家团队处理的分析的模型,可以通过加快假设筛选、目标跟进以及数据生成与决策之间的循环来改变工业研究。
GeneBench-Pro 代表了初步的尝试。OpenAI 预估,随着模型能力的进步,探测这些更高抽象层次模型能力的基准将变得越来越有用,超越仅仅测试书籍知识或执行常规分析的能力。