KDD 2026|大模型能读懂DNA吗?中国人民大学团队提出R3LM,让LLM在生命序列上学会「有依据地推理」
为什么大语言模型已经能写代码、解数学题、 完成复杂推理,一遇到 DNA 序列却常常失灵?
一段 DNA 在模型眼里通常只是「ACGTACGT……」这样的长字符串。但在生物学家眼中,同一段序列包含着更丰富的调控信息:哪些转录因子可能结合,motif 出现在哪里,它们如何排列,GC 含量暗示了怎样的序列背景,不同细胞类型下这些信号又可能产生什么功能差异。
围绕这一问题,中国人民大学高瓴人工智能学院研究团队提出 R3LM(Reasoning Regression Reward Language Model),探索了一条让大语言模型理解生命序列的新路径:先把原始 DNA 编译成结构化的生物学证据,再让模型基于这些证据进行机制推理,最终输出可解释的调控活性预测。
相关论文《Biological Reasoning-Informed Regression for Interpretable Regulatory DNA Activity Prediction》已被 KDD 2026 接收。
论文地址:https://arxiv.org/pdf/2606.08147
LLM让 读 DNA,先要改变「输入语言」
顺式调控元件(cis-regulatory elements, CREs)是基因组中控制基因表达的重要区域。准确预测 CRE 活性,对于合成生物学、代谢工程、个性化医学和智慧农业等方向具有重要价值。
近年来,深度学习模型已经能够从 DNA 序列直接预测调控活性。但这类方法大多以黑箱方式工作:模型可以给出一个分数,却很难说明这个分数来自哪些生物学证据。当模型被用于序列设计时,这种黑箱 reward model 还可能带来 reward hacking 风险,即算法找到一批模型打分很高、但生物学上缺乏可信机制的候选序列。
R3LM 的出发点很直接:如果希望 LLM 参与 DNA 建模,就需要把 DNA 转写成它更容易处理、也更符合生物学逻辑的结构化表示。
为此,团队设计了 Regulatory Context Card(RCC)。RCC 可以理解为一张 DNA 的「调控上下文卡片」,它把原始序列整理成多类可检查的信息,包括:
motif 证据:转录因子结合位点、位置、方向和匹配强度;
序列统计:如 GC 含量等全局背景特征;
调控语法:motif 共现、聚集、间距和组合关系;
实验上下文:如细胞类型、测量条件等;
原始序列:保留底层信息,便于追溯。
通过 RCC,模型面对的从单纯四种碱基字符的排列,转变为一组有结构、有来源、有生物学含义的证据。初步实验也显示,直接让 LLM 读取原始 DNA 序列表现较弱;加入 motif 和 GC 等上下文后,模型对调控活性的判断能力显著提升。这说明 LLM 并非完全缺乏推理潜力,真正的瓶颈在于 DNA 如何被表达给模型。
从「打分」到「说明为什么打分」
只有结构化输入还不够。研究团队进一步构建了 CRE-ReasonBench,为调控 DNA 样本补充机制推理轨迹。每个样本不仅包含 DNA 序列和活性标签,还包含一段基于 RCC 证据生成的推理过程,例如先分析 GC 含量,再检查关键 motif,再结合细胞类型背景判断可能的增强子活性。
在此基础上,R3LM 采用两阶段训练:
第一阶段,让模型学习根据 RCC 生成结构化机制解释,掌握「如何从证据推向生物学判断」。
第二阶段,将 RCC 和模型生成的推理轨迹一起输入回归模型,预测连续调控活性分数。为了避免模型直接依赖离散标签,训练时会移除推理文本中的最终等级结论,使模型必须根据证据和推理过程完成预测。
这样,R3LM 输出的结果包含两个层面:一个可用于序列优化的活性分数,以及一段可供研究人员检查的生物学解释。
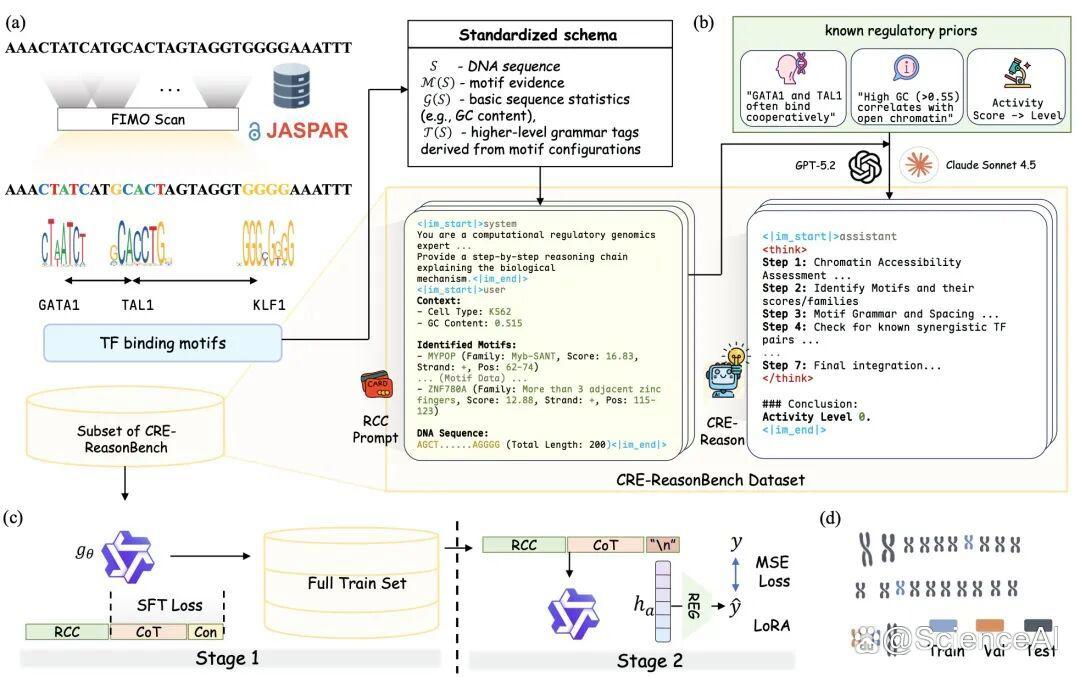
图 1:R3LM 框架总览。图中展示 RCC 构建、CRE-ReasonBench 数据生成、两阶段训练流程。
实验:结构化证据让 LLM 更接近 DNA 专用模型
团队在 K562、HepG2 和 SK-N-SH 三种细胞类型的增强子活性预测任务上评估了 R3LM。结果显示,直接读取原始 DNA 的 LLM 表现明显受限;使用 RCC 后,LLM 性能大幅提升;进一步加入机制推理后,R3LM 在 K562 和 HepG2 上取得最佳表现,在 SK-N-SH 上也保持较强竞争力。
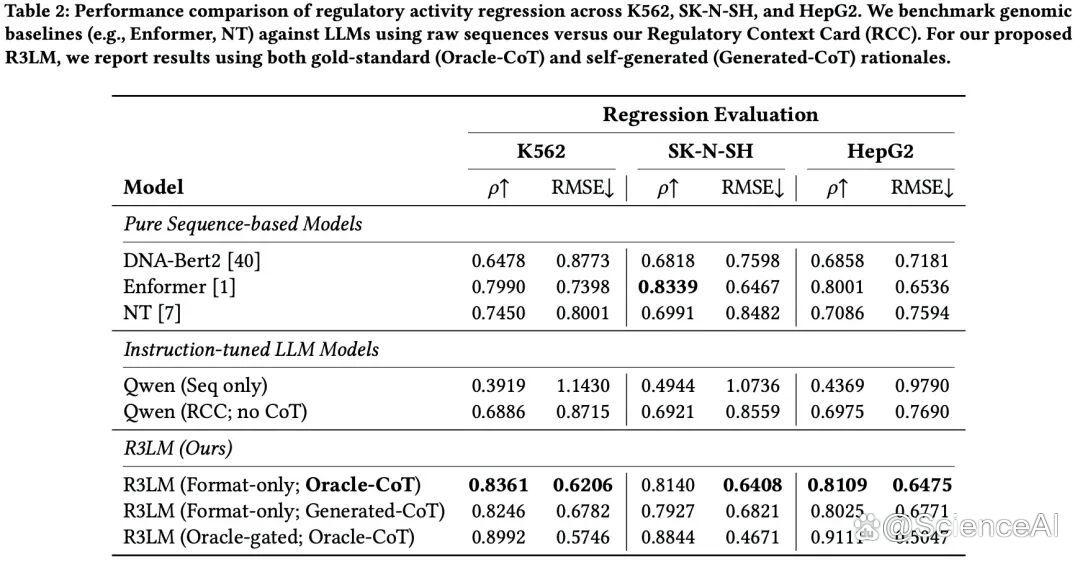
图 2:调控活性预测性能对比。表格展示 R3LM、Enformer、DNABERT-2、NT 以及 Qwen 基线在三个细胞类型上的 Pearson 相关系数和 RMSE。
以 K562 为例,Qwen 直接读取原始序列时 Pearson 相关系数为 0.3919;换用 RCC 后提升至 0.6886;R3LM 在自生成推理设置下进一步达到 0.8246,超过 Enformer 的 0.7990。HepG2 中,R3LM 也取得 0.8025 的相关系数,略高于 Enformer 的 0.8001。
更重要的是,R3LM 的预测过程可以被检查。团队进行的 rationale shuffling 测试显示,若打乱推理轨迹与样本的对应关系,K562 上的性能会从 0.8246 降至 0.0198,说明这些推理文本确实承载了与预测相关的信息,而非附加在结果之后的装饰性解释。
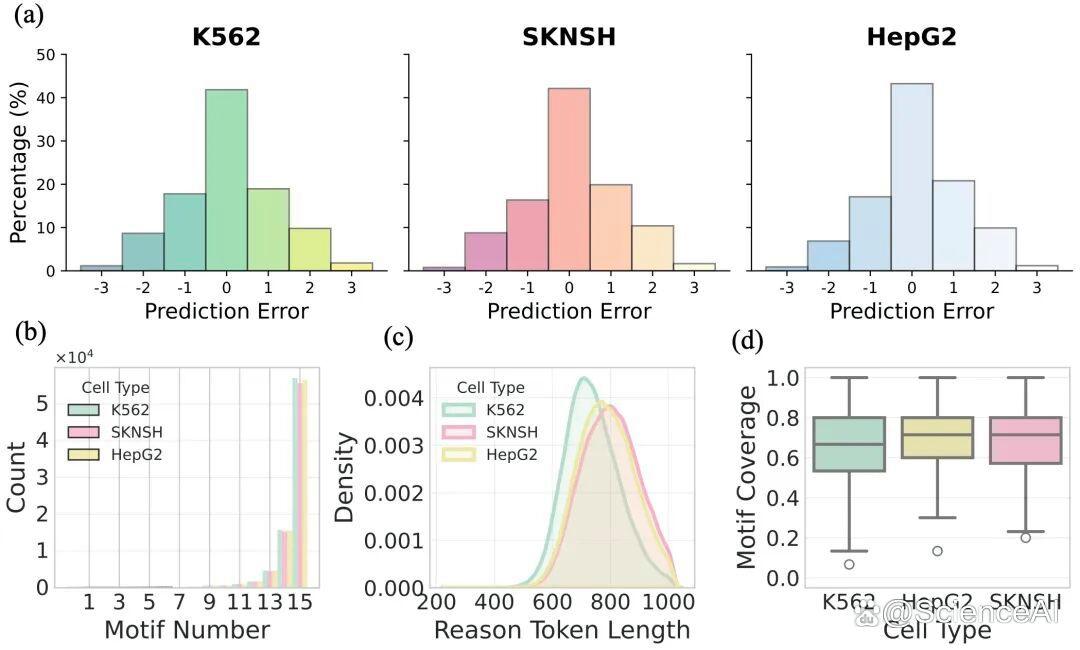
图 3:阶段一推理生成器诊断与 CRE-ReasonBench 统计。图中展示离散活性等级误差分布、RCC 中 motif 数量分布、推理文本长度分布和 motif 覆盖率。
迈向可解释的生命序列智能模型
R3LM 的价值不局限于某一个增强子预测任务。它提出了一种更通用的思路:当 LLM 进入基因组学场景时,关键问题之一是如何为生命序列构造合适的「语言接口」。
通过 RCC,DNA 可以被转写为结构化、可审计的生物学证据;通过机制推理,模型的预测分数可以与 motif、调控语法和细胞类型背景建立联系;通过连续 reward 建模,R3LM 进一步具备辅助 CRE 设计和序列优化的潜力。
当然,R3LM 仍依赖已有 motif 数据库和生物学先验,目前主要在 MPRA 增强子数据上完成验证。未来,如何扩展到更复杂的染色质环境、更长程的基因调控互作,以及更开放的 de novo 调控语法发现,仍值得继续探索。
总体而言,R3LM 提供了一条让 LLM 理解 DNA 的新路径:把生命序列从原始字符转写为结构化知识,让模型在证据上推理,再将推理转化为可用于设计的预测信号。这种「结构化表达 + 机制推理 + 可解释预测」的范式,有望为下一代基因组智能模型提供新的技术支点。