70亿级参数模型BetaDescribe,实现从氨基酸序列到功能描述的智能转换
编辑丨&
在生命世界中,蛋白质像一套由氨基酸组成的复杂语言。每一条蛋白质序列都携带着关于结构、位置和功能的信息,但如何从这串由 20 种氨基酸字母组成的「密码」中准确读出生命活动的含义,长期以来仍是生物学中的核心难题。
面对一个未知蛋白,研究人员通常需要依赖实验验证,或者寻找数据库中与其相似的已知蛋白,通过序列比对推测功能。然而,生命系统中仍存在大量缺乏明确注释的蛋白质,尤其是那些与已知蛋白序列相似度极低的「孤儿蛋白」,传统方法往往难以判断其真实作用。
AI 正在改变这一局面。2026 年 6 月 29 日,在 PNAS 上发表的「BetaDescribe: Providing rich descriptions from protein sequences」,提出了一种名为 BetaDescribe 的蛋白质语言模型框架。该模型能够直接读取蛋白质序列,并生成类似科学注释的自然语言描述,包括蛋白质功能、催化活性、亚细胞定位以及结构域信息等。
论文链接:https://www.pnas.org/doi/10.1073/pnas.2537345123
BetaDescribe
过去十年,深度学习已经逐渐进入蛋白质研究领域。从蛋白质结构预测到序列生成,人工智能展现出了理解复杂生命信息的能力。以蛋白质语言模型为代表的方法,通过将氨基酸序列视为类似自然语言的「生物文本」,让模型从海量序列中学习隐藏规律。
然而,蛋白质与普通语言存在明显区别。文字具有明确语法,而蛋白质序列中的信息隐藏在氨基酸排列、进化约束以及结构特征中。一个模型即使能够识别序列模式,也未必真正理解其对应的生物功能。
BetaDescribe 试图解决这一问题。研究团队以 Llama 2 为基础模型,将原本用于自然语言理解的大语言模型进一步训练,使其掌握蛋白质领域知识。模型首先接受约 2 万亿英文文本 token 的预训练,随后加入超过 1200 亿个包含蛋白质知识的数据 token,使其逐渐建立从蛋白质序列到功能描述之间的联系。
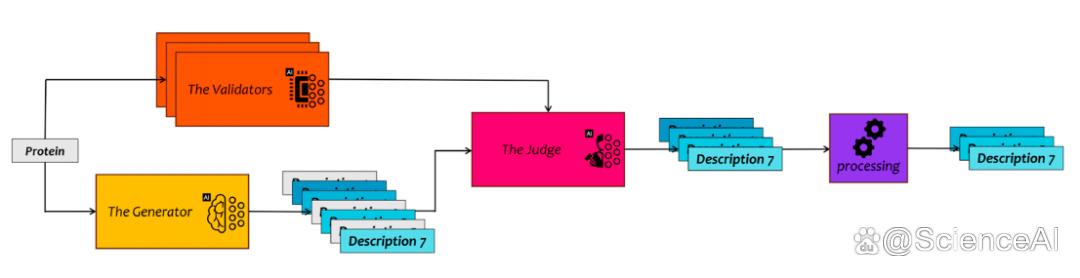
图 1:BetaDescribe 工作流程。
在具体架构上,BetaDescribe 并非简单让一个模型直接生成答案,而是设计了一套由「生成器—验证器—评判器」组成的协作体系。
其中,核心生成器拥有 70 亿参数,负责根据蛋白质序列生成多个候选功能描述;三个验证模型分别预测蛋白质的分类、亚细胞定位以及是否具有酶活性等属性;最终,一个基于 GPT-4 的评判模块会综合这些信息,筛选出更加可信的描述。
这种设计类似于科学研究中的同行评审机制:AI 提出假设,其他模型检查假设是否符合已有生物规律,从而降低生成式模型可能产生错误信息的问题。
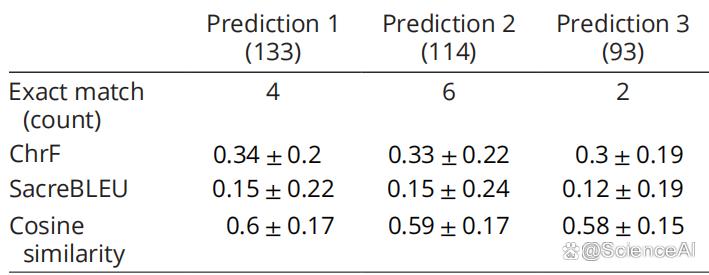
表 1:BetaDescribe 对无 BlastP 匹配结果的测试蛋白质的性能表现。
探索蛋白质
与依赖于已知蛋白质序列相似性的传统方法不同,BetaDescribe 结合了生成模型、验证机制和评估流程。这种方法使系统能够推断蛋白质功能,即使蛋白质与先前描述的蛋白关系不密切。
在罗非鱼湖病毒(TiLV)相关蛋白研究中,传统方法由于病毒蛋白高度变异,仅能正确识别其中一个聚合酶相关蛋白。而 BetaDescribe 全部正确预测 RNA 依赖聚合酶活性,为后续实验研究提供了线索。
表 2:BetaDescribe对 TGV-S 蛋白的预测及 BlastP 的预测结果。
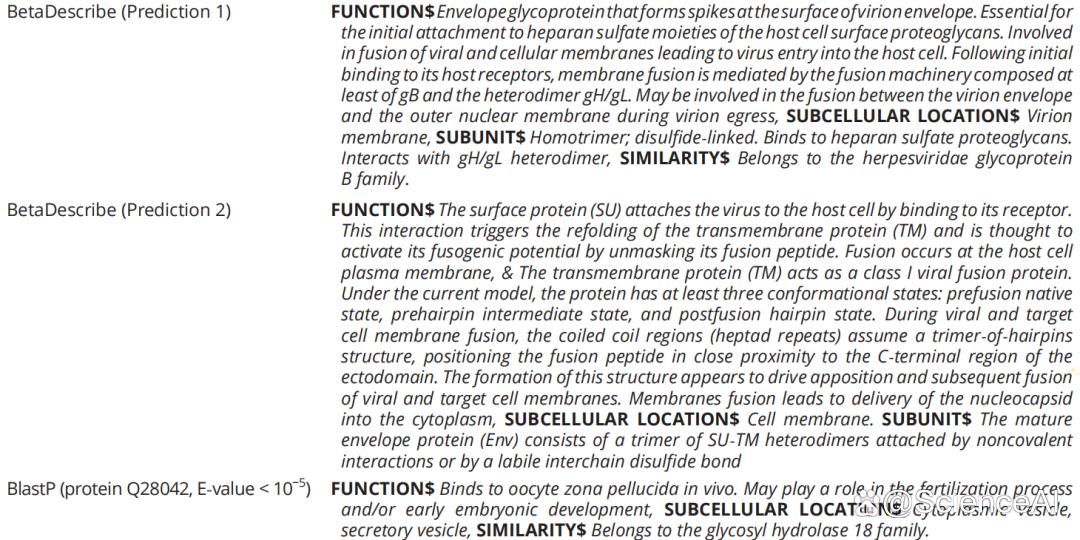
对于细菌蛋白 H5TRP0,传统 BlastP 搜索返回的是一个具有丝氨酸蛋白酶活性的无关蛋白。然而 BetaDescribe 生成的多个预测中,有两个正确关联到了 CRISPR 相关功能,并指出其可能参与细菌免疫系统。
这些案例显示,在传统数据库缺乏参考答案时,生成式 AI 能够提供新的研究假设,帮助科学家探索尚未被充分认识的蛋白质空间。
从实验室瓶颈到应用
研究团队指出,当蛋白质与已知序列高度相似时,BlastP 依然具有更高准确性;但面对低同源性蛋白时,BetaDescribe 能够利用更广泛的序列—功能关联信息,提供更加稳定的预测结果。
未来,这类蛋白质大语言模型有望进一步融合实验数据、结构信息以及进化信息,让 AI 不仅能够描述蛋白质功能,还能够解释功能来源、预测关键突变位置,并辅助药物设计和生物工程。