干湿闭环实战6倍活性提升!上智院提出催化模型CatEmb,从2D分子图读懂3D电子效应
在催化反应中,催化剂和配体的立体效应与电子效应,往往共同决定反应的活性和选择性。然而,传统方法通常需要分别使用多种描述符刻画这些性质:有的依赖人工指定原子索引,有的需要耗时的构象搜索和量子化学计算,还有的只能反映局部结构特征。这种碎片化的表征方式,不仅增加了建模复杂度,也制约了催化剂的大规模自动筛选。
近日,上海科学智能研究院(下称「上智院」)联合复旦大学在 Digital Discovery 发表研究论文,提出了一种名为 CatEmb 的催化剂嵌入模型。作为上智院自研的燧人物质科学系列模型的功能层,该模型通过对比学习对齐二维分子图与三维结构 — 能量信息,仅以二维分子结构为输入,即可快速生成包含立体电子效应的统一向量表示,为催化剂相似性检索、性能预测和智能推荐提供通用工具。
作为「Golab 物质科学智能研发工厂」在干湿闭环实验中用于催化剂推荐的重要模型之一,CatEmb 已被进一步接入该产品中,在超过 100 小时的 AI 自主科研直播中参与催化剂优化,并与自驱动实验室协同完成两轮「模型推荐 — 实验验证 — 数据回流 — 模型再优化」,助力某催化反应提至文献方案的约 6 倍。
论文标题:Stereoelectronic-aware catalyst embeddings from 2D graphs via 2D-3D multi-view alignment
论文链接:https://doi.org/10.1039/D6DD00089D
上智院物质科学方向主任研究员徐丽成为论文第一作者兼通讯作者,上智院 AI 科学家及物质科学方向负责人曹风雷和复旦大学特聘教授、上智院院长漆远为共同作者。
从「碎片化描述符」到统一的立体电子表示
传统催化信息学通常使用不同描述符分别表征分子的空间与电子性质。这些描述符往往需要人工指定关键原子,或依赖耗时的构象搜索与量子化学计算,难以高效扩展至大规模催化剂库。此外,将不同类型的特征简单拼接,也可能引入冗余信息。
CatEmb 的核心思路,是让二维图神经网络直接学习三维结构中蕴含的立体电子信息。研究团队构建了双流编码器,分别处理二维分子图和经 xTB 优化的三维构象及能量,并通过对比学习将同一分子的两种表示对齐。
训练完成后,用户只需输入分子的 SMILES,二维编码器便可快速生成蕴含立体电子信息的 CatEmb 向量,无需额外进行构象搜索或量子化学计算,从而实现催化剂的高效、统一表征。
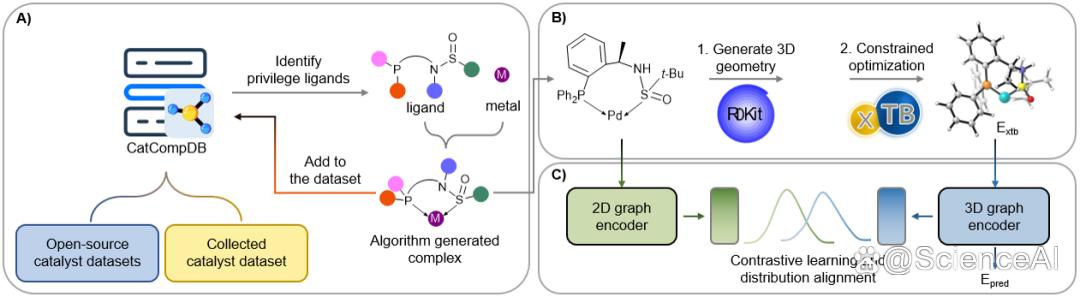
图 1 CatEmb 建模策略
CatCompDB:一个覆盖超过 6 万种催化物种的专用数据集
为了支持 2D-3D 多视图对齐,研究团队构建了面向催化剂和配体的专用数据集 CatCompDB。团队整合多个公开数据集,并补充文献和商业库中的相关分子,在清洗去重后进一步通过算法化配位生成配体 — 金属配合物,最终形成覆盖多类配体骨架和 32 种中心金属的催化化学空间。
随后,研究团队为这些分子生成三维构象,并在 GFN2-xTB 级别进行结构优化和能量计算,获得用于模型训练的「二维分子图 — 三维结构 — 能量」数据。这一数据集为 CatEmb 学习催化剂的立体电子信息提供了基础,也为面向催化体系的通用分子表示学习积累了重要数据资源。
CatEmb 能否真正读懂立体电子差异?
研究结果表明,CatEmb 学习到的隐空间具有清晰的化学结构规律。在降维可视化中,同类配体会自然聚集,而膦配体、氨基酸配体和 BOX 配体等不同类别则分布在不同区域。
CatEmb 不仅能够区分不同配体骨架,还能识别同一骨架内部细微的取代基差异。例如,在 Salen 配体中,无取代母核、烷基供电子取代和含氮杂环取代的分子形成了不同子簇,说明模型能够同时感知取代基带来的空间与电子变化。
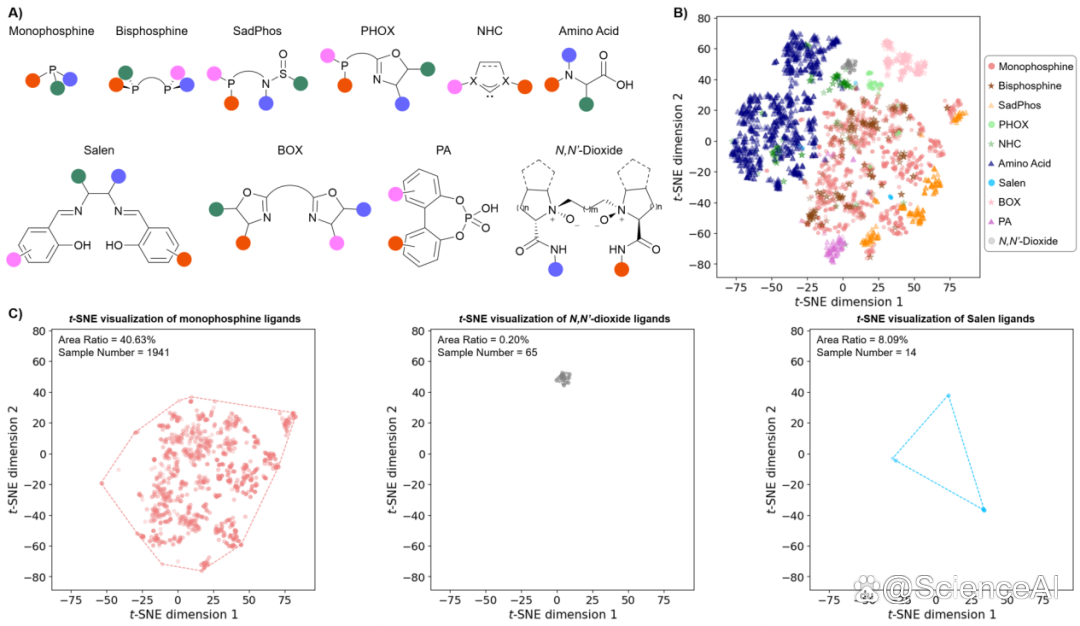
图 2 通过 t-SNE 投影对 CatEmb 空间中的配体相似性进行分析
团队还在 C—H 芳基化和不对称硫醇加成两个催化反应数据集上开展了定量构效关系(QSPR)建模。结果显示,CatEmb 能够提供有效的催化剂特征;将其与反应指纹或分子指纹结合后,预测性能通常可以进一步提升(图 3)。这表明 CatEmb 所编码的立体电子信息,能够为传统反应特征提供有价值的补充。
相似性即策略:从性能预测走向催化剂推荐
除了作为 QSPR 模型的输入特征,CatEmb 还支持一种更直接的催化剂推荐策略:从少量已完成实验的催化剂出发,在 CatEmb 空间中寻找与当前最优催化剂最相似的未测试候选物,并优先进行下一轮验证。
这一策略背后的假设十分直观:在关键立体电子特征上相似的催化剂,可能表现出相近的催化性能。相较于完全依赖监督学习模型进行性能预测,这种方法不需要大量标注数据,在数据稀缺或预测模型精度有限时仍能发挥作用。
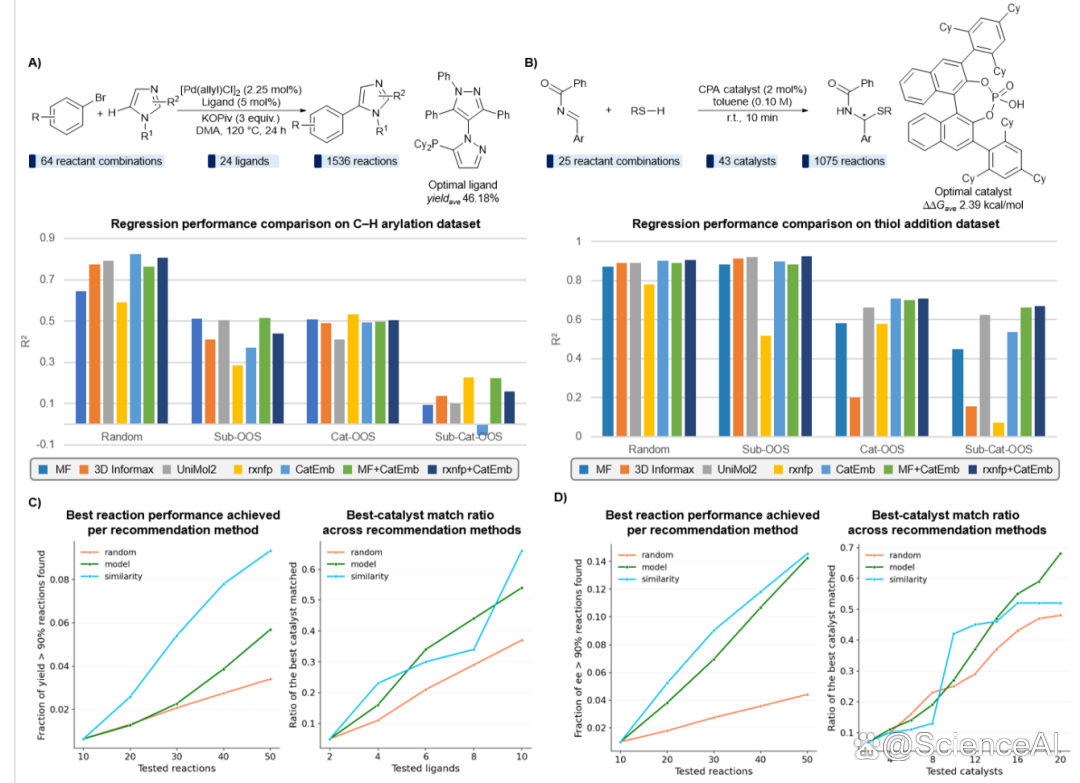
图 3 反应构效关系建模与催化剂推荐任务
研究团队在不同任务中验证了这一思路。在寻找高表现反应条件和底物普适型催化剂时,基于 CatEmb 的相似性推荐整体优于随机筛选;即使在 QSPR 模型预测能力较弱的场景下,该策略仍能为实验提供有效的候选优先级(图 3C 和 3D)。
研究团队将这一策略进一步应用到两个更接近实际需求的场景中。第一个场景是大规模虚拟库的优先级排序:针对洪鑫教授团队报道的 Ni 催化 Suzuki-Miyaura 阻转选择性交叉偶联反应,原始研究从 10,000 余个候选物中筛选出 3 个高 ee 配体(ee 分别为 91%、88%、93%)。团队为其中 4,600 个高可合成性候选物计算了 CatEmb,并按与初始 21 个实测配体中最佳者的相似度排序 ——3 个实验验证的配体分别排在第 5、第 98 和第 100 位,说明 CatEmb 相似性在大库筛选中具备有意义的引导能力(图 4A)。
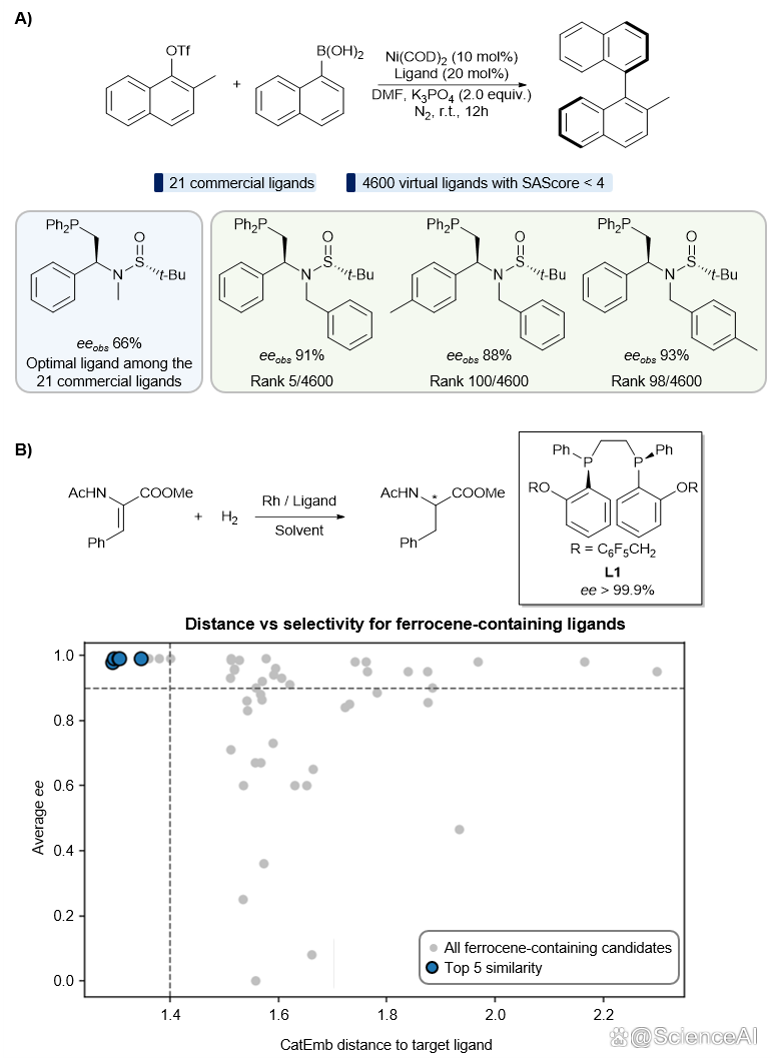
图 4 基于相似性的相同骨架与跨骨架的配体推荐
第二个场景是跨骨架催化剂推荐:在铑催化不对称烯烃氢化反应中,最优配体(ee > 99.9%)是一个不含二茂铁的双膦配体 L1。团队计算了该数据集中所有含二茂铁配体与 L1 的 CatEmb 距离,发现距离最近的 5 个含二茂铁配体,其平均 ee 均高于 90%,而距离越远的配体,平均选择性呈下降趋势(图 4B)。这表明,CatEmb 捕捉到的「立体电子相似性」在一定程度上跨越了骨架类型的界限 —— 即便配体核心结构不同,只要在关键立体电子特征上相近,就可能给出相似的催化表现。
研究团队同时指出,这一结果应当被「审慎地」解读:测试的不对称氢化数据集本身具有较高的整体选择性,这使推荐任务相对容易。该策略在更具区分度的困难任务上的表现,仍有待进一步验证。
走进超 100 小时干湿实验闭环:模型与实验共同迭代
CatEmb 的价值并不止于论文中的离线数据测试。作为「Golab 物质科学智能研发工厂」的重要组成部分,CatEmb 已被接入智能体驱动的催化剂推荐与反应条件优化流程。
在这个「超级科研工厂」开展的超 100 小时智能体干湿实验闭环(7 月 7 日下午至 7 月 11 日深夜于 B 站「上海科学智能研究院」直播间)中,CatEmb 与其他反应预测模型、条件优化算法协同工作,参与候选催化剂的表征、相似性分析和推荐,并通过自驱动实验室接受真实反应验证。
针对 Suzuki 和 Buchwald 偶联反应,团队围绕 4 个典型反应开展了两轮迭代优化。模型首先根据已有文献与实验数据推荐催化体系,随后由自驱动实验室完成反应执行和结果分析。
7 月 10 日傍晚,第一轮实验结果显示,4 个反应中有 3 个的平均催化活性较文献最优方案提升约 15%。对于尚未取得提升的第 4 个反应,智能体平台将第一轮实验结果回流至模型,在重新训练后继续开展催化剂优化。到直播结束时,第二轮实验将第 4 个反应的催化活性提升至文献方案的约 6 倍,约为第一轮实验结果的 8 倍。
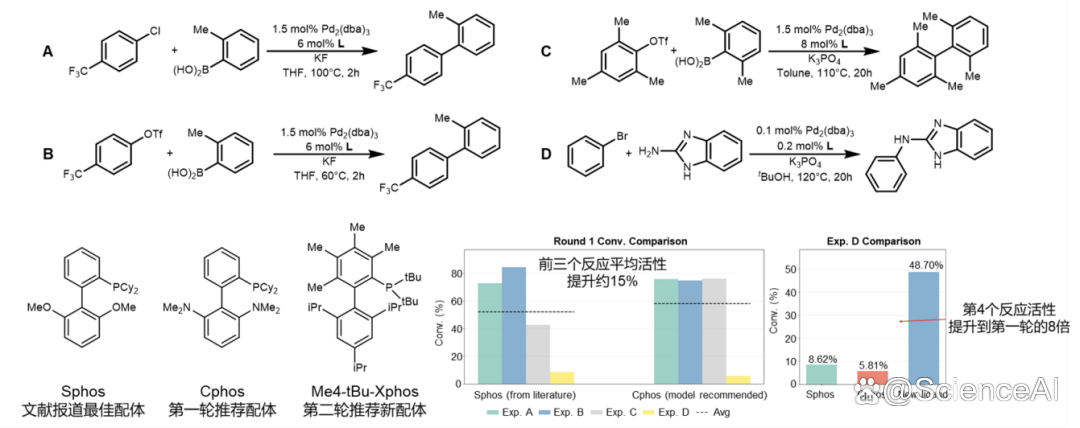
图 5 超 100 小时干湿实验直播中的催化剂配体优化任务结果
相较于一次性的虚拟筛选,这种闭环模式让 AI 能够根据真实实验结果持续修正判断、更新推荐,并将「失败或不理想的实验」转化为下一轮优化所需的新数据。CatEmb 也由此从一个催化剂表征模型,进一步成为连接分子结构、智能推荐和自动化实验的重要环节。
挑战与展望:从通用表示走向催化发现基础设施
CatEmb 通过对比学习将三维结构与能量信息迁移至二维图网络,使研究者仅凭二维分子结构,就能快速获得具有立体电子感知能力的统一表示。这一设计兼顾了推理效率和信息表达能力,可用于大规模催化剂库的快速嵌入、相似性检索、优先级排序和性能预测。
目前,研究团队已开源 CatCompDB 数据集、多个维度的预训练模型权重以及完整代码,方便领域研究者根据具体任务开展使用和二次开发。
数据集和权重地址:https://doi.org/10.6084/m9.figshare.31375579
代码地址:https://github.com/licheng-xu-echo/CatEmb
与此同时,CatEmb 仍有进一步拓展空间。例如,不同下游任务对应的最优嵌入维度可能不同,需要根据具体数据进行选择;当前模型主要面向有机配体和过渡金属配合物,其在酶催化、多相催化和光催化等更复杂体系中的适用性,仍需进一步验证。
未来,CatEmb 所代表的「立体电子感知嵌入」有望不再只是独立的分子描述工具,而是成为 AI 驱动催化发现流程中的基础能力:向前连接文献知识、反应理解和候选生成,向后连接性能预测、催化剂推荐和自动化实验,并在真实实验数据的持续回流中不断进化。
从二维结构中理解三维立体电子效应,从虚拟推荐走向真实实验验证,再从实验结果返回模型开展下一轮优化 ——CatEmb 在超 100 小时干湿实验闭环中的应用,展示了催化信息学从离线预测走向自主迭代的一种新可能。