FinVerse:超越“误差”的金融预测,用决策导向指标重新定义时间序列模型的价值
“FinVerse: Financial Time-Series Benchmark”
在金融领域,预测的价值不在于最小化某个数学误差,而在于能否辅助做出正确的投资决策。然而,现有的时间序列预测基准普遍采用“一刀切”的误差指标(如MASE、CRPS),将股票价格、CPI、外汇汇率等性质迥异的序列混为一谈。这种评估方式与真实世界的金融决策之间存在巨大鸿沟:一个模型虽然能精确预测价格,但如果它无法正确判断方向、无法区分资产优劣,甚至无法在投资组合中带来稳定收益,那么它在金融实务中几乎毫无用处。
为填补这一空白,FinVerse应运而生。这是一个面向金融场景的大型时间序列预测基准,它抛弃了单一的误差指标,转而根据每个时间序列的经济含义,为其量身定制评估方式。该基准包含近12万个金融时间序列、1.7亿个观测值,定义了11个指标族(共78个指标),从逐点精度、横截面排序和投资组合回测三个维度对模型进行全方位评估。通过对43个主流基础模型的实证分析,FinVerse揭示了一个关键结论:在通用基准上表现优异的模型,在金融决策导向的评估中往往会“失灵”。这一发现呼吁行业构建更贴近现实、更懂业务的评估体系。
【 扫描文末二维码加入星球获取论文,源码 】
摘要
随着时间序列基础模型的出现,能够有意义地评估其预测能力的基准测试变得至关重要。现有的基准测试虽然提供了标准化的比较,但往往使用统一的基于误差的指标来评估异构序列。然而,在这些指标上表现优异,并不一定意味着模型能在不同领域做出最佳的实际决策。例如,在股票预测中,正确预测价格涨跌可能比最小化逐点预测误差对实际回报更重要。为此,本文提出了 FinVerse,一个金融领域的时间序列预测基准测试,旨在向更贴近现实的评估迈出第一步。
FinVerse 发布的数据集包含 116,897 个金融时间序列,共计 1.711亿 个观测值。其中,根据其与金融决策的经济相关性,选出了 60,232 个序列(1740万 个观测值)作为评估目标。与主要强调统一点预测或概率精度的通用基准不同,FinVerse 定义了 11 个指标族,共 78 个评估指标,并根据每个时间序列的经济含义为其分配最合适的评估指标。我们对 43 个公开时间序列预测基础模型的分析表明,在通用预测标准下的强性能并不一定能转化为有用的金融预测。这一发现凸显了构建领域感知型基准的必要性,这类基准能在更贴近实际决策的目标下评估模型。
简介
大型语言模型在多个领域的成功,重新激发了人们对基础模型的兴趣,并自然延伸到了时间序列建模。随着模型变得更大、更通用,该领域越来越需要能够区分“仅通用统计指标精确”的模型与“对实际下游决策有用”的模型的评估协议。
自然语言处理领域有定义良好的基准测试(如 GLUE, SuperGLUE),它们提供了共享任务、标准化数据分割和可解释指标,更重要的是,在优秀基准上的强性能应与实际任务中的实用能力相关。
然而,时间序列预测领域尚未有同等令人满意的基准标准。现有的基准,如 GIFT-Eval,通常使用一套统一的基于误差的指标来评估异构时间序列。这引发了一个实际问题:如果决策者根据此类基准选择表现最佳的模型,他们能否期望该模型在真正依赖预测的决策中表现合理?本文认为,答案通常是否定的,因为一个好的预测在不同领域和目标序列中的含义是不同的。例如,在股票预测中,正确预测未来收益的方向或相对排名可能比最小化价格误差更重要。一个对所有序列都应用相同 MASE 和 CRPS 评估指标的基准无法完全捕捉这些特定领域的需求。
为解决这一差距,本文提出了 TimeVerse(时间序列基准宇宙)倡议,旨在实现更现实的时间序列预测评估。作为其首个领域特定基准,FinVerse 专注于金融时间序列预测。FinVerse 的设计原则是:每个时间序列应根据其经济含义所隐含的决策上下文来评估。它将金融时间序列组织在三个评估维度下:逐点预测精度、横截面排序质量和投资组合回测表现。基于这些维度,本文定义了11个指标族(78个评估指标),并根据每个序列的经济含义为其分配最合适的指标。
FinVerse 收集了跨越广泛层级范围和类别的金融时间序列,覆盖外汇、商品、加密资产、固定收益、宏观经济指标、股票、ETF和公司基本面等。发布的数据集包含 116,897 个序列(1.711亿 观测值),其中 60,232 个经济上有意义的序列(1740万 观测值)被选为固定评估集。评估起始日期为 2020-01-01。通过该基准,我们发现,在通用时间序列基准上表现良好的模型,并不一定能为金融预测任务产生有用的结果。
相关工作
时间序列基础模型
基础模型范式已从语言和视觉扩展至时间序列建模。与为特定数据集训练的传统模型不同,近期的基础模型(如 TimesFM, Chronos, Moirai, Timer, TimePFN)旨在在大规模异构时间序列集合上预训练,并支持零样本或少样本预测。主流架构是仅解码器 Transformer,以自回归方式生成未来观测值。此外,通用表示模型(如 MOMENT)学习可迁移的时间序列表示,可适应多种下游任务。
时间序列基准
TSLib 和 Monash 时间序列预测档案等基准推动了标准化的比较。GIFT-Eval 是一个广泛使用的通用基准,但其通用设计忽略了领域特定的目标。FinVerse 旨在通过评估金融特定指标和决策上下文来补充此类通用基准。
金融预测
金融预测是核心任务,因为许多下游决策依赖于对未来市场行为的预期。近期研究从空间-时间建模、分布偏移下的趋势预测、以及基于期权的波动率预测等角度进行了研究。FinTSB 等基准主要关注股票数据。相比之下,FinVerse 收集了多个数据类别,支持多种频率和评估范围,旨在提供更广泛、更实用的评估设置。
FinVerse
基准环境
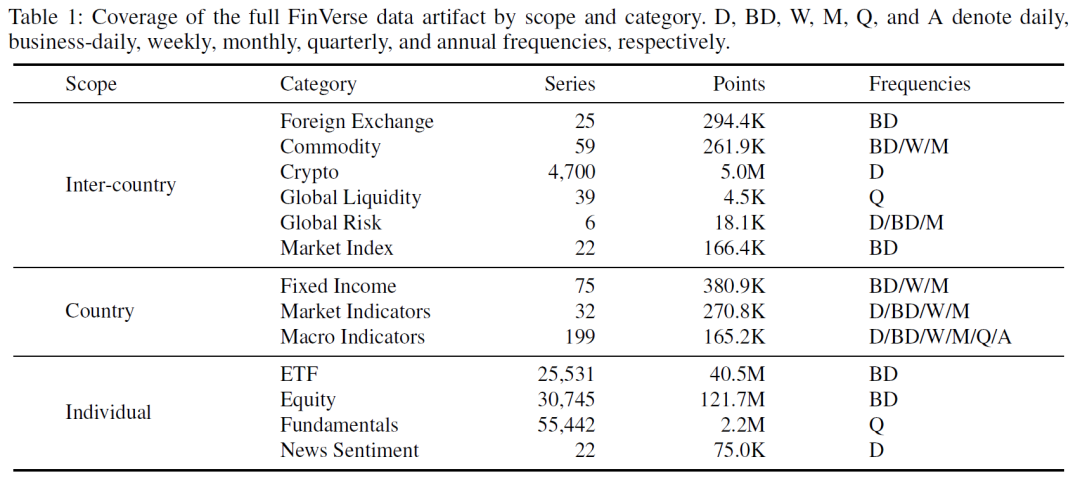
FinVerse 按 范围-类别-详细类别 层次结构组织金融时间序列。
国家间范围:涵盖外汇、商品、加密资产、市场指数等。
国家范围:涵盖固定收益、宏观经济指标、市场指标等。
个体范围:涵盖 ETF、股票、基本面数据等。
总共有 3 个范围、13 个类别、101 个详细类别。完整数据包含 116,897 个序列(1.711亿 观测值),频率包括日、交易日、周、月、季、年。
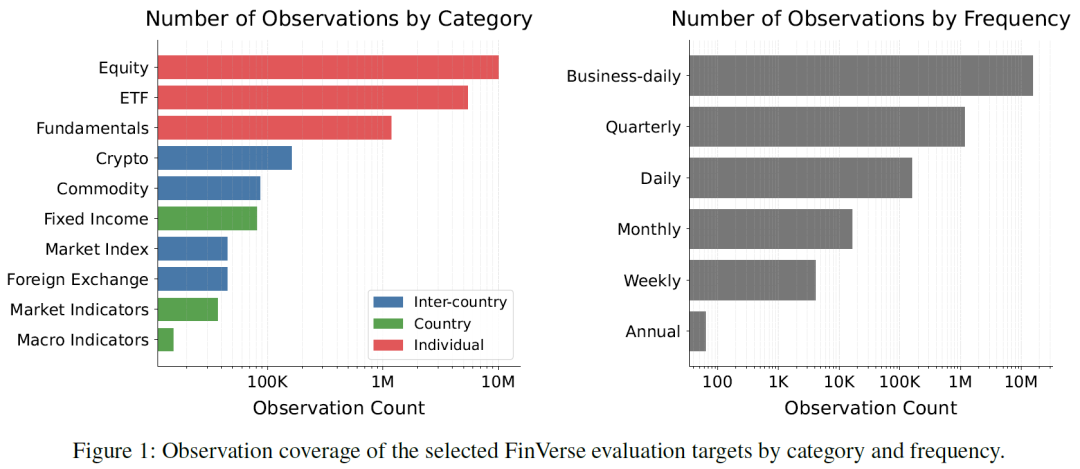
评估集为手动选出的 60,232 个目标序列(1740万 观测值),覆盖 3 个范围、10 个评估类别、67 个评估详细类别。其中,股票和 ETF 的日度观测数据占比最大,但国家间和国家级的宏观/市场指标同样重要。
基准评估指标
FinVerse 使用三类评估指标族:
逐点预测
命中率 (Hit Ratio, HR):衡量方向正确性。对于比较窗口 p 和预测期 h,定义实现变化和预测变化,其命中率为符号一致的比例。HR 及其一阶导数 Δ HR 和二阶导数 Δ^2 HR 分别衡量方向变化、变化率是否加速或减速,这对宏观经济指标(如 CPI)尤其重要。
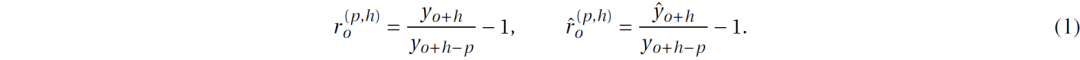
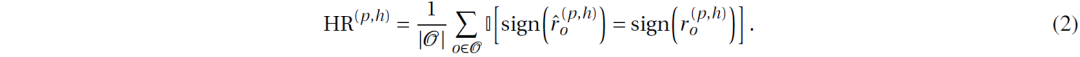


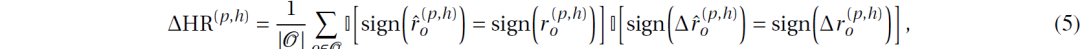
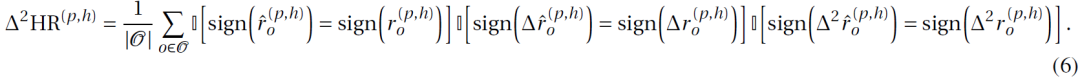
平均绝对缩放误差 (MASE):提供尺度的无关系数。FinVerse 定义了三个变体:
MASE_{rel}:评估相对变化预测精度,基准是预测零变化。
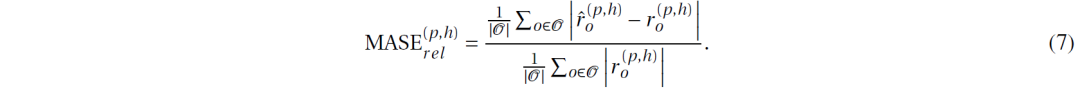
MASE_{abs}:评估原始值预测精度,基准是重复比较窗口末端的观测值。
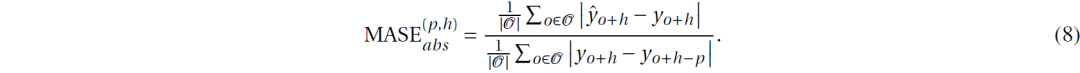
MASE_{ori}:评估原始值预测精度,基准是重复预测起点的观测值。
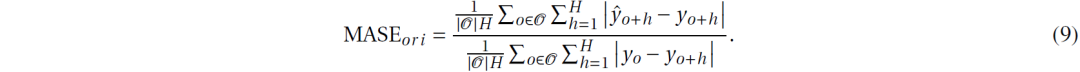
横截面排序
信息系数 (Information Coefficient, IC):评估横截面排序质量。计算预测的未来变化与实现的未来变化之间的 Spearman 秩相关。IC 用于货币、商品、股票等相对排序有意义的资产组。
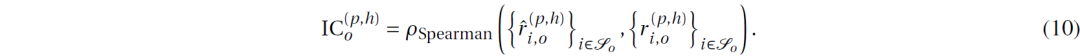
投资组合回测
将预测转化为等权重多头策略。在每个再平衡时点,按预测信号对资产排序,选取前 10% 的资产,持有期为 h。通过运行所有可能的偏移起点并平均结果,来计算年化收益率、年化波动率、夏普比率和最大回撤。这些指标评估了预测在现实风险回报权衡下的实用性。
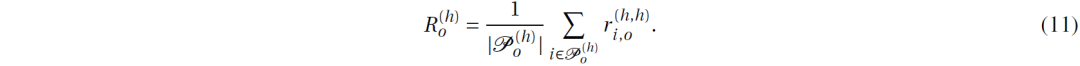
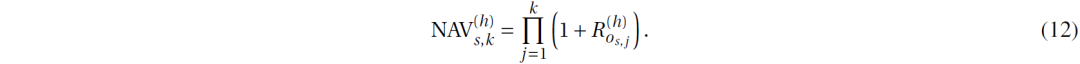
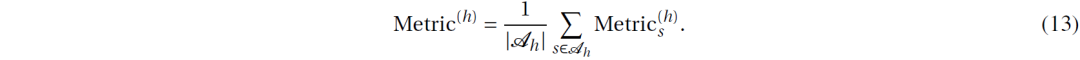
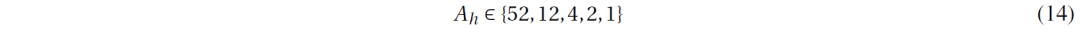
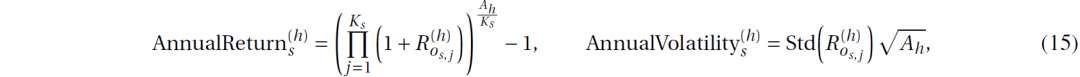
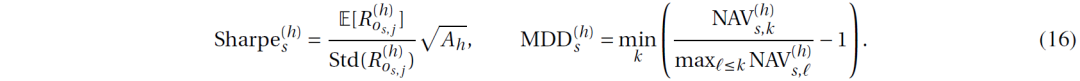
总体而言,FinVerse 定义了 6 个逐点预测指标族、1 个横截面排序指标族和 4 个投资组合回测指标族,共 78 个评估指标。
评估期与预测期
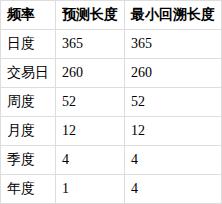
评估起始日期为 2020-01-01。每个频率的预测长度和最小回溯窗口长度如下表所示。
使用 FinVerse 进行评估
评估模型
评估了 43 个公共时间序列基础模型,包括 TimesFM 系列、Chronos 系列、Moirai 系列、Timer、Toto 系列、TiRex 系列、VisionTS 等。
总体排名聚合
由于不同指标数值特性不同,时间序列数量差异大,FinVerse 采用基于排名的聚合策略:
在每个详细类别-频率组合内,计算每个模型的指标平均分。
在每个组合内,对每个指标单独进行模型排名。
对三个评估组(逐点、横截面、投资组合),分别计算组内指标排名的几何平均值 K。
模型在三个组内分别按 K 值排名,最终总体排名为三个组排名之和。
FinVerse 中的表现
总体表现
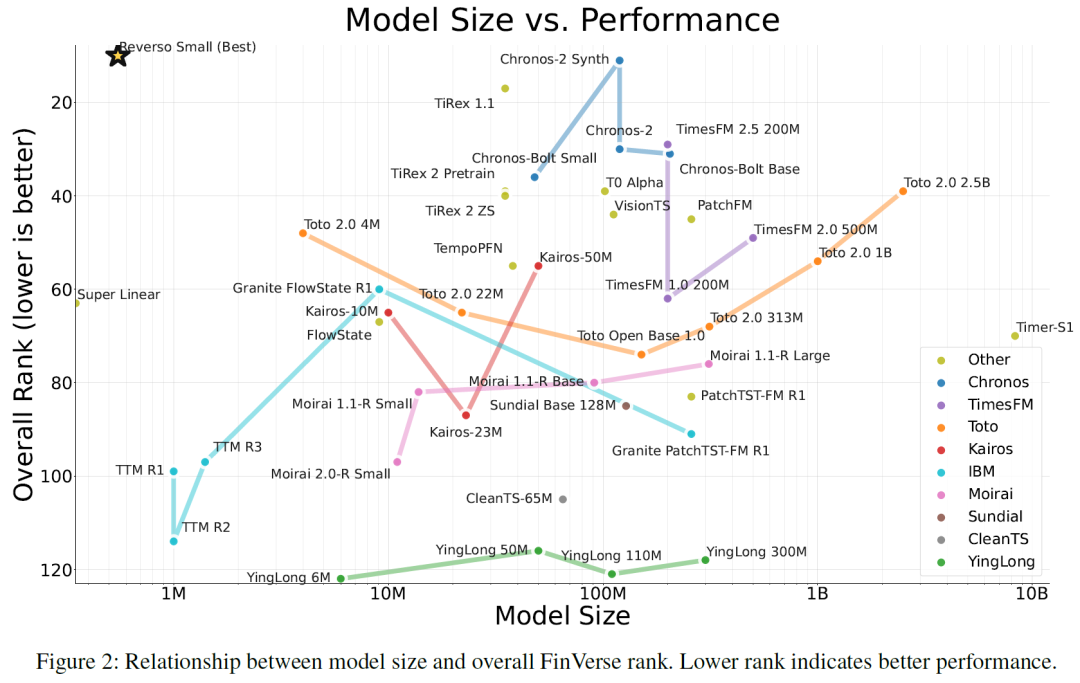
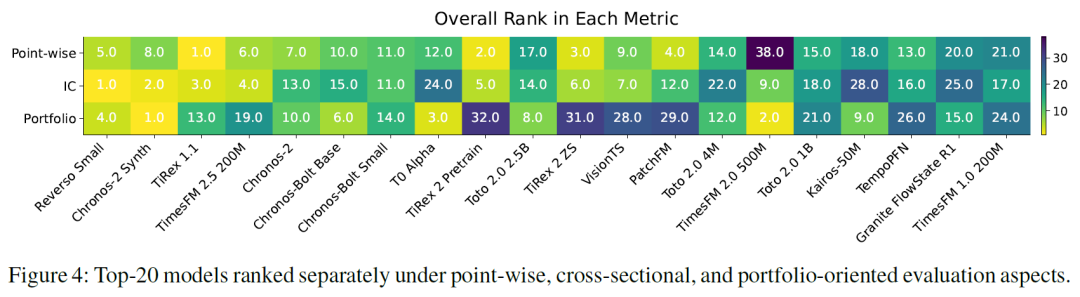
Reverso Small 获得最佳总体排名,其次是 Chronos-2 Synth、TiRex 1.1、TimesFM 2.5 200M 和 Chronos-2。
有趣的是,较大的模型并未持续占优,表明金融决策导向评估不能仅由参数数量解释。
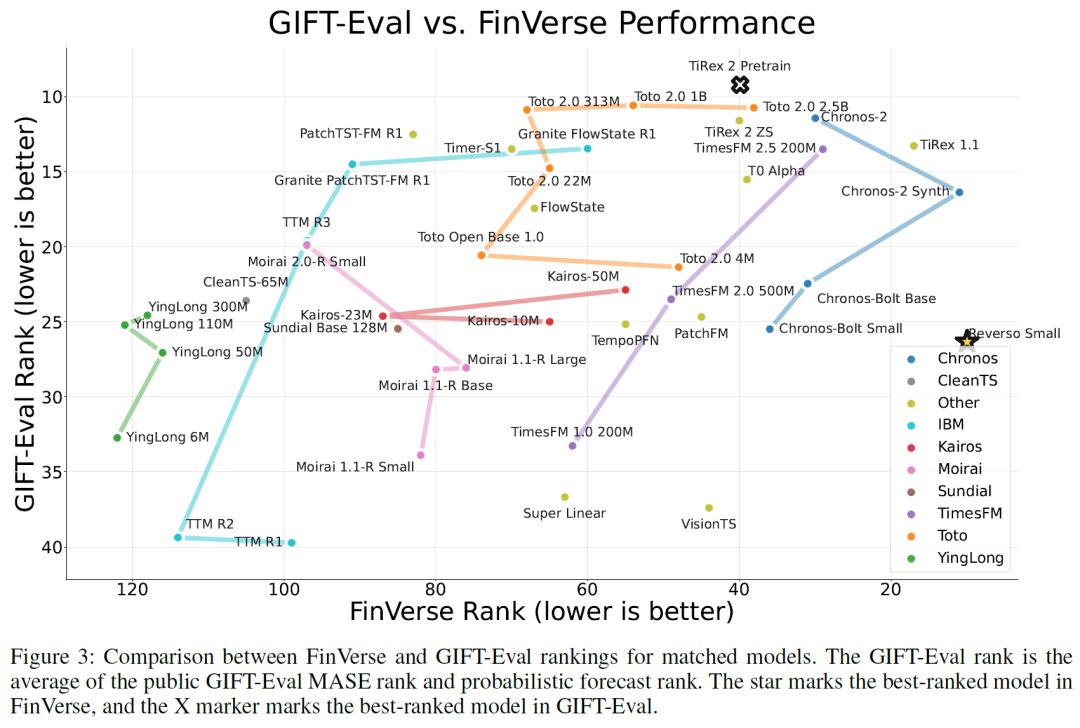
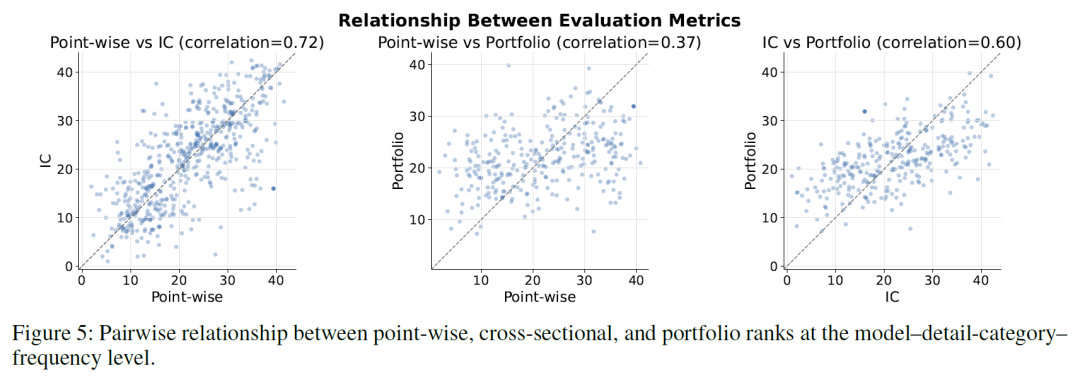
FinVerse 排名与 GIFT-Eval 排名的相关性仅为 0.40,表明两者相关但远非可互换,这证实了通用基准的强性能不保证在金融决策导向评估中表现优异。
各评估维度表现
逐点预测:TiRex 1.1 最佳,其后为 TiRex 2 Pretrain, TiRex 2 ZS, PatchFM, Reverso Small。
横截面排序:Reverso Small 最佳,其后为 Chronos-2 Synth, TiRex 1.1, TimesFM 2.5 200M, TiRex 2 Pretrain。
投资组合表现:Chronos-2 Synth 第一,其后为 TimesFM 2.0 500M, T0 Alpha, Reverso Small, Moirai 1.1-R Large。
这表明,强逐点预测能力并不保证强横截面排序或投资组合表现。三个维度是互补的。
指标族分析
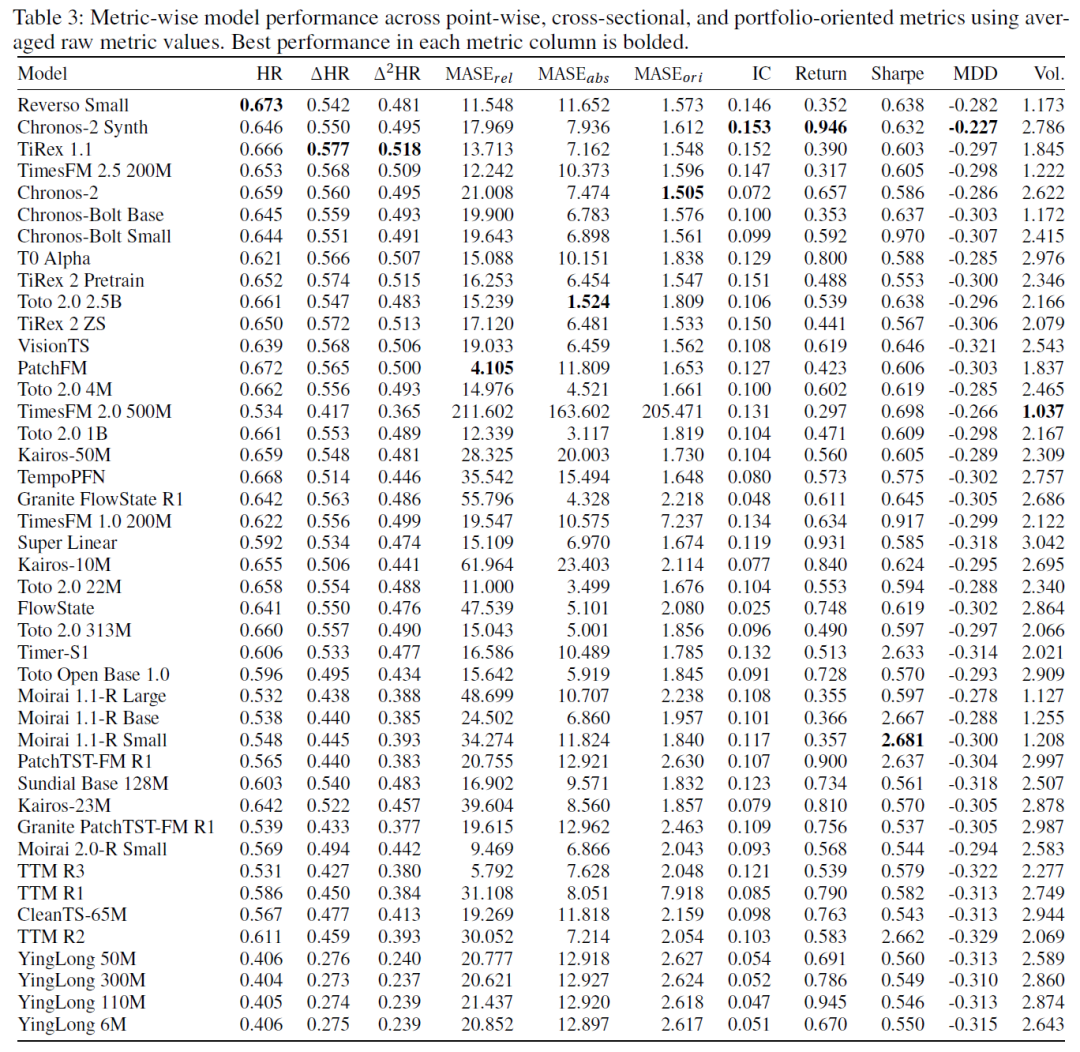
不同模型在不同指标族上表现各异。例如,Reverso Small 在 HR 上最强,TiRex 1.1 在 $\Delta HR$ 和 $\Delta^2 HR$ 上领先,PatchFM 在 $MASE_{rel}$ 上最佳,Toto 2.0 2.5B 在 $MASE_{abs}$ 上领先,Chronos-2 在 $MASE_{ori}$ 上最佳。在投资组合方面,Chronos-2 Synth 在 IC、Return 和 MDD 上最强,Moirai 1.1-R Small 在 Sharpe 上领先。这进一步证明没有单一模型能统治所有指标。
已知局限与未来工作
日历与发布日期对齐
FinVerse 目前将周、月、季、年观测值标准化为日历期末,这未完全保留特定系列的财报日历(如财年9月结束)。
存在发布日期间隔问题:某些经济指标的时间戳标注为测量期,但实际数据在之后才发布,可能导致基准假设信息提前可用。
未来扩展
改进时间对齐,加入日历感知预处理和发布日期元数据。
扩大对美国以外国家、指数成分股、行业指数、调查指标、固定收益工具等的覆盖。
扩展面向决策的评估任务和投资组合构建协议。
总结
本文介绍了 FinVerse,一个面向金融领域的基准测试。其动机在于通用时间序列预测精度与金融决策导向目标之间的差距。FinVerse 通过三个互补维度(逐点精度、横截面排序、投资组合回测)来组织评估。它包含 116,897 个序列(1.711亿 观测值),其中 60,232 个目标序列(1740万 观测值),使用 11 个指标族(78 个指标)进行评估。实证结果表明,模型质量随金融目标的变化而变化,且没有模型能统治所有指标。这证实了 FinVerse 的核心前提:仅凭强大的基于误差的预测性能,并不一定意味着在涉及方向、排序、风险或实际投资组合回报的金融决策中有用。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
