属于Quant的LLM评测基准:QBench正式发布!
现有大模型基准已经覆盖数学、编程、金融知识和 Agent 工具调用等常见场景,但是在量化投资中,除了这些基础知识外,还存在很多量化所特有的问题,非专业人士很难发现其中的问题,由此评测出的大模型能力很难反应其在量化场景中的真实能力。 为此,我们专门设计了一套面向量化的专业LLM/AI Agent评测基准:QBench
QBench 并没有被设计成金融知识题库。它是一套面向量化投资 LLM 与 AI Agent 的真实场景的评测,试图回答一个更实际的问题:模型交付的量化研究结果,究竟能不能被信任?
完整评测由两部分组成。Theory Track 为100分,占综合成绩30%;Engineering Track 同样为100分,占70%。最终成绩按下式计算:
其中Theory部分相对较为简单,涵盖一些常见的量化问题以及易犯的错误,需要大模型在不借助任何工具的情况下给出正确答案。Engineering 则考察大模型的实战能力。模型需要完成代码编写、运行、调试和结果交付,任务覆盖数据契约、因子实现、机器学习复现、回测修复、组合风险、性能优化、产物审计和端到端研究等。
QuantML-Research/QBench项目及测试结果已开源,欢迎大家加入开发组,共同维护项目,可以提交测试结果或者测试题目
理论测试
本次发布首先测试 Theory Track。它包含8道题,全都有确定答案和分项评分标准,不依赖主观印象打分。
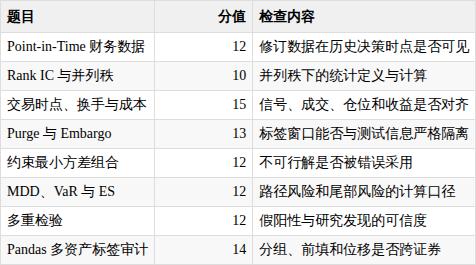
都是量化中一些常见的问题以及易犯的错误,测试难度不高,属于量化研究员入门笔试的水平。理论测试采用整卷一次作答的 score@1。模型不能调用工具、网络或其他代理。这里测量的是首次独立提交的可靠性。如果不能正确回答所有问题,说明模型对于量化场景的熟悉程度还有待提高。
模型结果
首轮测试基于 OpenCode 1.18.13 完成。本次我们对比了gpt,claude以及deepseek的相关模型,模型的结果如下:
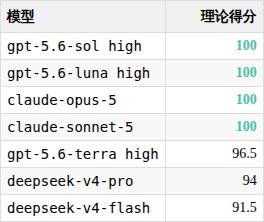
Sol、Luna、Opus 5和Sonnet 5均取得满分。 基本复合预期,Luna 真是GPT的甜点模型了,性价比拉满。
Terra high 的96.5分全部失在 Purge/Embargo。标准测试结果是:训练集最后一个合法样本为95,96—100需要清除(标签为未来5日收益,否则会看到测试集信息);测试后的121—125仍处于测试信息区间,126—130属于额外 embargo,首个可恢复训练的样本是131。Terra 正确回答了大部分区间,却遗漏125,并将其视为合法训练样本。这个错误只扣3.5分,但样本125仍与测试信息端点接触。
DeepSeek V4 Pro 得到94分。它正确处理了大部分统计与组合问题,在交易成本题中也给出了正确方法,只因最后一次乘法错误扣1分。它同样也在Purge/Embargo的问题上发错:V4 Pro把题目明确给出的126—130重新解释成一个信息区间,又用训练标签与它求交,最终把 embargo 扩张为121—129,并把130判断为可训练。推导写得很长,术语也都正确,结论却改变了题目的数据契约。属于是过度思考导致的错误。
DeepSeek V4 Flash 的91.5分则揭示了另一类错误。它知道全表 ffill() 可能把一只证券的价格填入另一只证券,却没有看出下面的 shift(-5) 已经离开分组:
df.groupby("ticker")["close"].pct_change(5).shift(-5)
pct_change(5) 返回普通 Series 后,后续位移会按照整张表的行序执行,这属于是常见的代码错误之一。
工程测试
Theory Track 解决的是准入问题。它检查模型有没有基本的量化定义、时间意识、统计判断和代码语义能力,但不会要求模型真正读取行情数据、建立项目、修复回测、管理依赖或提交可复现产物。
理论测试只是考察模型对于量化场景的熟悉程度,工程测试才是QBench权重最高的部分,它直接考察了模型在实际项目中的能力,包含了数据检查、因子 SDK、机器学习复现、回测修复、组合风险、性能与断点续跑、产物审计以及端到端研究等任务。候选模型需要在8个独立会话和工作区中完成任务,再由冷启动 harness 与隐藏案例检查结果。后续我们也会逐一测试个模型的工程测试结果。敬请期待。
总结
属于量化的大模型评测基准,最终需要回答的问题是,当LLM交出一个因子、一段回测代码或一份研究结论时,我们有没有足够的证据相信它。
还想看哪些模型的评测结果,欢迎在评论区留言
关于QuantML
QuantML 是链接全球顶尖量化人才的高端社群,我们聚焦于机器学习在量化投资中的最前沿应用。
核心价值:
- 顶级圈层: 社区涵盖头部机构从业者、知名私募创始人、机构量化负责人,基金经理,券商金工分析师、GitHub千星作者及顶会学者构成。
- 每日高价值内容: 持续分享前沿论文、论文研报复现、模型代码、核心Alpha因子以及QuantML-Qlib框架等。
加入我们,与最强大脑同行,洞见量化未来。