通义万象开源Wan-Animate-2!角色动画比肩商业SOTA
通义万象刚刚开源了 Wan-Animate-2,一个端到端的角色动画框架。
不提取骨架、不压缩运动特征,DiT(扩散Transformer)直接喂驱动视频,角色就动了,还能做到 24 fps 实时流式输出。而且与商业闭源方案对比,效果也具备竞争力。
看得见的效果
Wan-Animate-2 的整体质量优于前代 Wan-Animate。相比第1代,它能自动完成动作重定向,按参考图的实际尺寸驱动,手部形变和肢体伪影明显减少。与 Dreamina、Kling-MotionControl 等商业闭源方案对比,效果也具备竞争力。
具体能力上,几个亮点值得展开。
高保真动画。复杂肢体动作、细微面部表情、角色与场景的物理交互,Wan-Animate-2 都能处理。不同宽高比、不同体型的角色输入,稳定性和鲁棒性表现良好。
多角色动画。支持单人驱动多人、多人驱动多人的视频合成。
多机位动画。同一段角色动画,可以通过显式相机位姿条件生成多角度观察。
因为运动不绑定刚性空间锚点,视角和参考信息之间可以解耦,多视角内容保持一致。
扔掉中间环节
角色动画这个领域,过去的方案大致分三条路。
第一条,显式运动表示。先从驱动视频里提取骨架、姿态关键点,再拿这些中间表示去驱动目标角色。问题在于,提取本身就会出错,误差一路传递,身份也容易漂移。
第二条,隐式运动特征。把运动压缩成一组隐向量,省去了显式骨架,但压缩过程会丢掉细粒度的动态信息,手指的微妙弯曲、嘴角的轻微抽动,可能就没了。
第三条,上下文学习。把参考信息直接塞进生成模型的上下文窗口,绕开中间表示,但计算开销大得离谱。
更关键的是,以上方案全部面向离线合成,做不了实时交互。
Wan-Animate-2 直接把中间环节全部去掉。
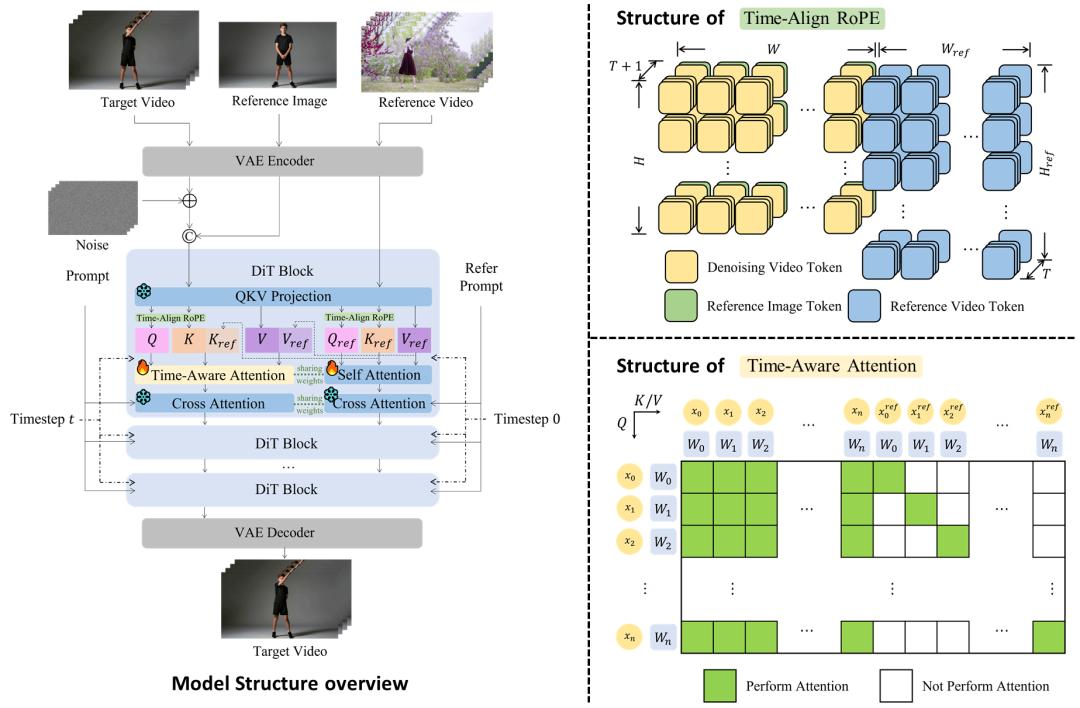
它采用双分支 DiT 架构,一支处理参考图像(提供外观),一支处理参考视频(提供运动)。没有姿态提取网络,没有骨架检测,驱动视频原封不动地进入模型。运动先验直接从视频帧里学,身份保真度自然就上来了。
为了让静态外观和动态运动两路信息更好地融合,团队设计了两个模块:Time-Align RoPE,负责在时间维度上对齐去噪视频 token 和参考 token;Sparse-Ref Attention,让模型选择性地关注参考特征中真正有用的部分,而非全部塞进去。
另外,Wan-Animate-2 加入了文本驱动的视角控制。你用文字描述想要的机位角度,输出画面的摄像机视角就和驱动视频解耦了。过去依赖显式运动表示的方法很难做到这一点,因为骨架是绑死在特定空间坐标上的。
实时
离线生成做得再好,遇到数字人直播、虚拟主播这类场景,延迟就是硬伤。
Wan-Animate-2-Lite 就是为这个问题准备的。它把推理延迟压到了实时阈值,支持 24 fps 的流式角色动画,直接从摄像头画面驱动,动作和表情同步,延迟极低。
为降低多步扩散的推理成本,Lite 版本采用因果 DiT 做分块自回归生成(每块 8 帧)。团队用 teacher forcing 预训练,搭配 error buffer 机制,让模型先学会基本的生成能力。然后 Self-Forcing 蒸馏,配合 chunk-wise backpropagation(分块反向传播),把推理速度提上来。
最终在 4 卡 H100 上以流水线并行部署时,400 × 720 分辨率、3 步去噪可达到 24 fps,超过实时阈值。
开源
Wan-Animate-2 的模型权重已面向公众开源。而且英特尔已完成 Wan-Animate-2 在锐炫 Pro B70 显卡上的端到端适配,与模型开源同步提供 Day 0 支持。用英特尔显卡的开发者,不用再等社区慢慢移植了。
Wan-Animate-2 提出端到端方案解决中间表示带来的误差累积和身份漂移;引入视角解耦能力;并通过训练策略把推理速度拉到了实时。三方面的能力提升,为角色动画创作打开了新的大门。
过去受限于延迟和部署成本的数字人直播、虚拟主播、互动娱乐这些场景,现在多了一个开源选项。
参考资料:
https://humanaigc.github.io/wan-animate-2/
https://github.com/Wan-Video/Wan-Animate-2
https://huggingface.co/Wan-AI/Wan2.2-Animate-2-14B
https://modelscope.cn/models/Wan-AI/Wan2.2-Animate-2-14B