蚂蚁百灵新一代Ling-3.0开源,智效比13.2,124B释放1T能力
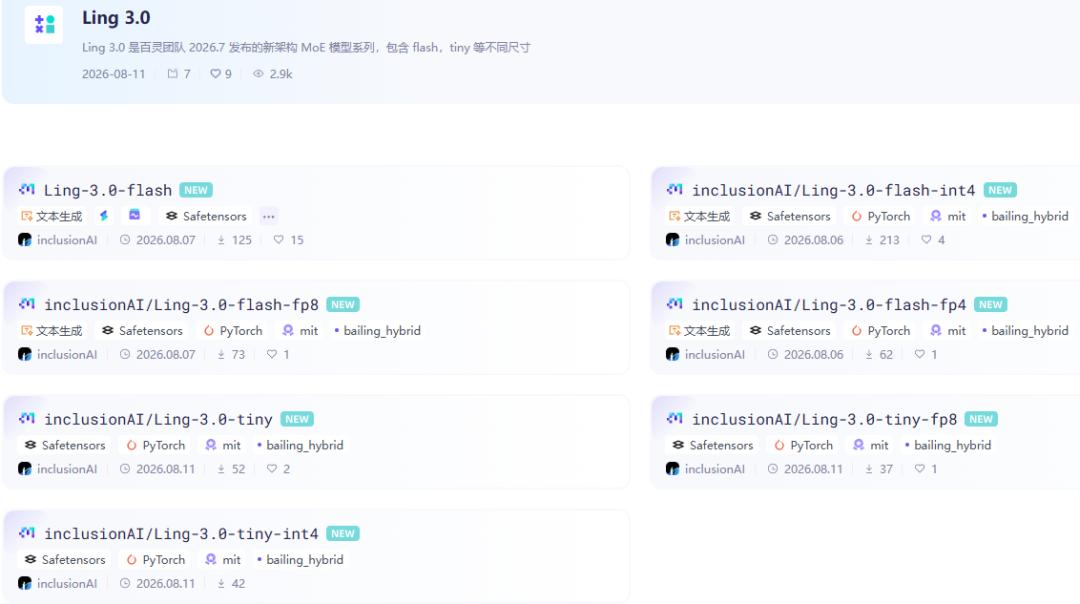
蚂蚁百灵新一代模型 Ling-3.0 开源了,同时带来 flash 和 tiny 两个版本,都是原生混合推理模型,FP8、INT4 等多个精度版本一并开放。
Ling-3.0-flash 总参数量 124B,激活参数只有 5.1B,激活规模约为上一代旗舰 Ring-2.6-1T 的 8.1%,却在多项测评中反超这位 1T 级前辈。
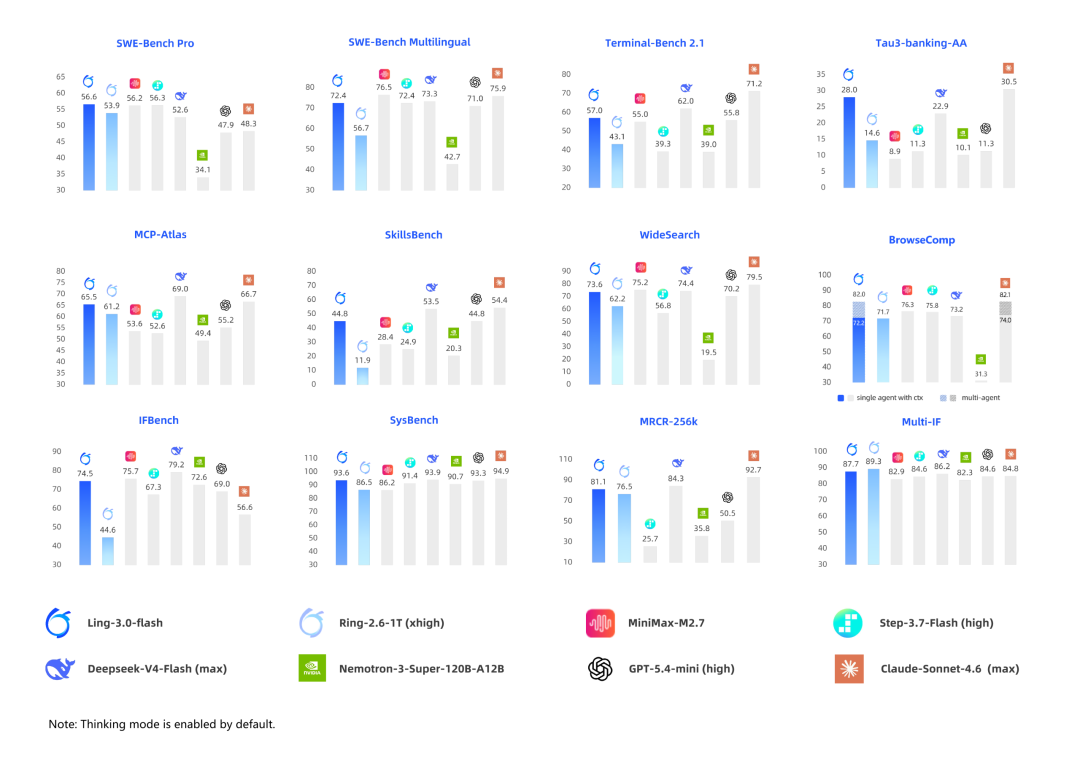
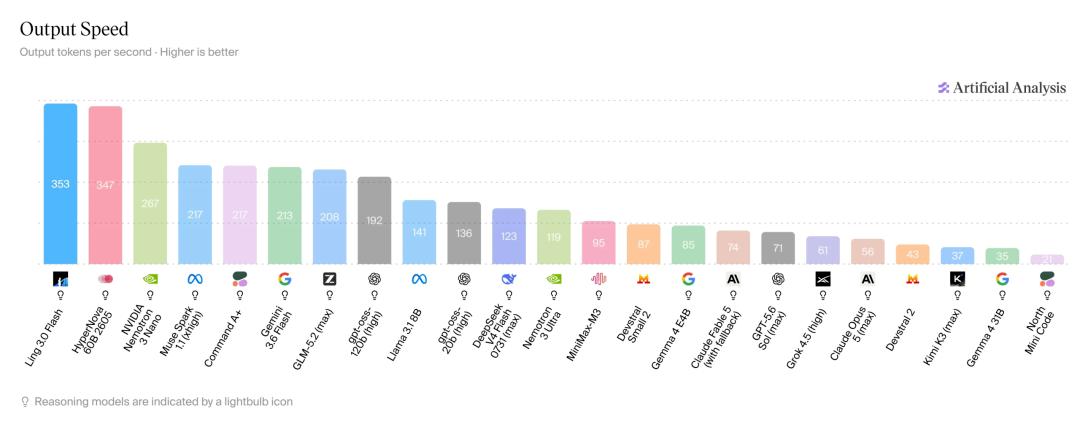
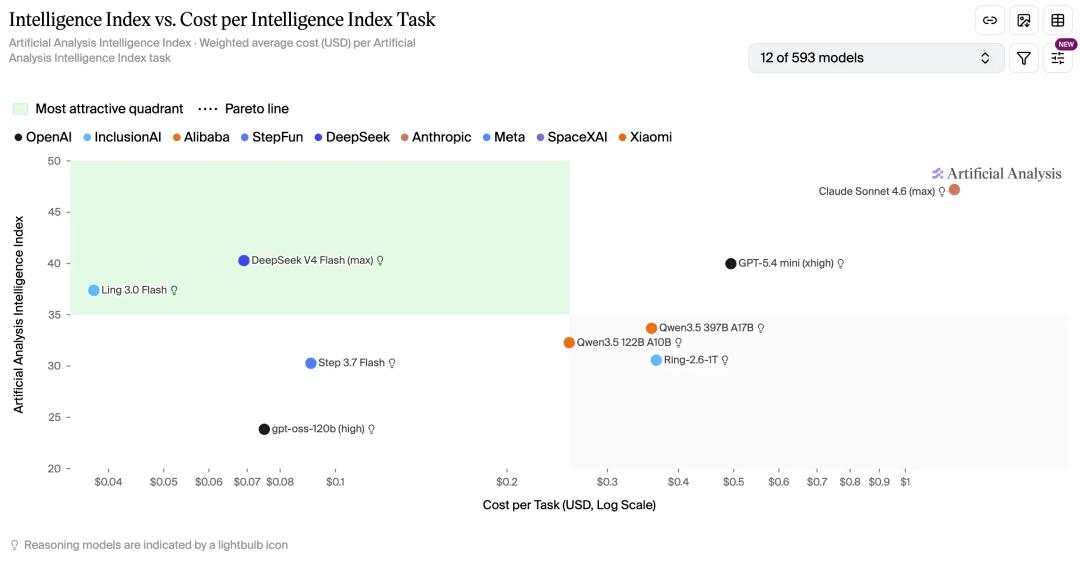
智效比 13.2 远领先于同行,输出速度 353 tokens/s,单个任务平均成本约 0.04 美元。它对每一寸算力与状态高效压榨,追求“智能密度”的极致提升。
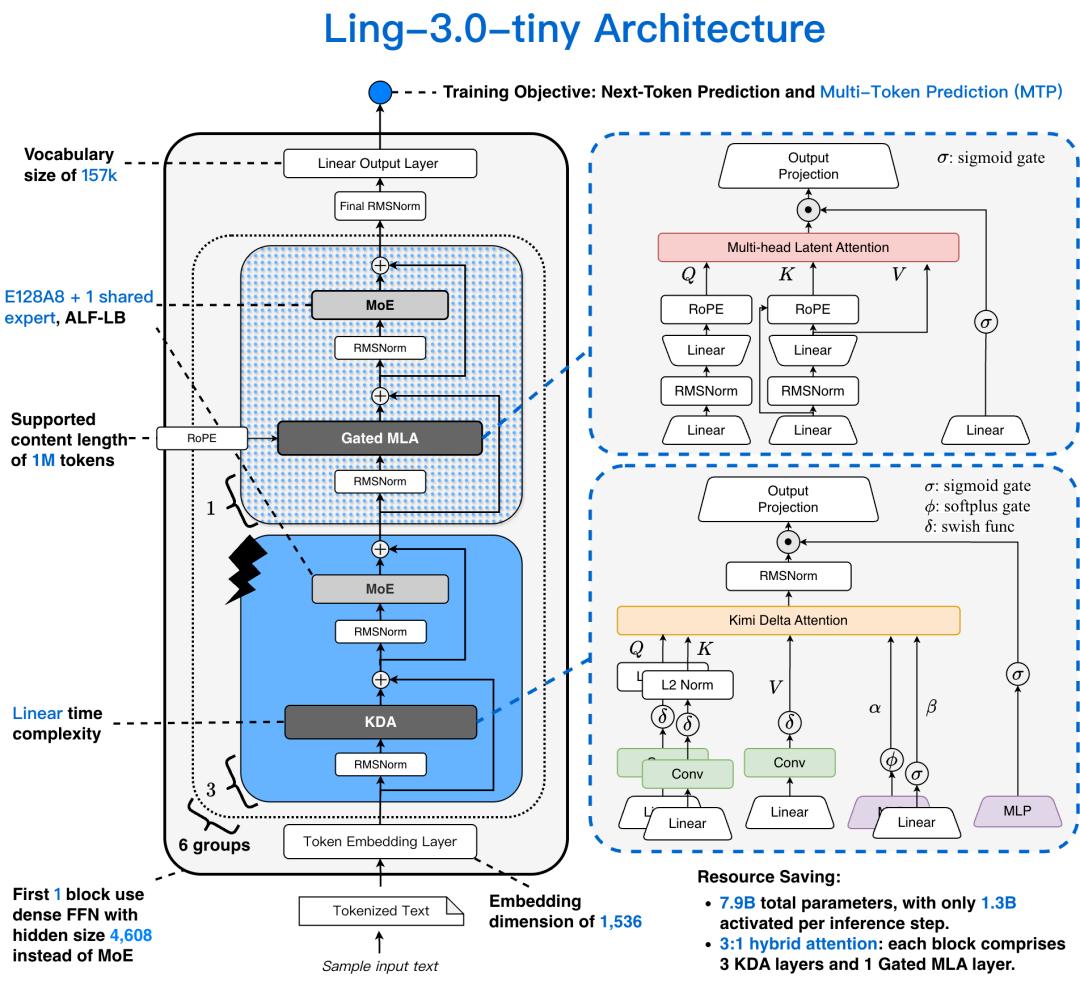
更小的 Ling-3.0-tiny,总参数量为 7.9B、推理时激活参数量仅为 1.3B,它以更少的激活参数承载更完整的任务能力,以更灵活的精度与设备选择,让开放智能真正进入现实环境。
十二分之一的激活参数
Ring-2.6-1T 总参数量 1T,激活 63B。Ling-3.0-flash 总参数量 124B,约为它的 12.4%,激活 5.1B,约为 8.1%,差不多是1/8和1/12。
完整基准表中,flash 均分 67.4,与 DeepSeek-V4-Flash(max)持平,高于 Ring-2.6-1T 的 59.7,同场模型中只低于 Claude-Sonnet-4.6(max)的 69.0。
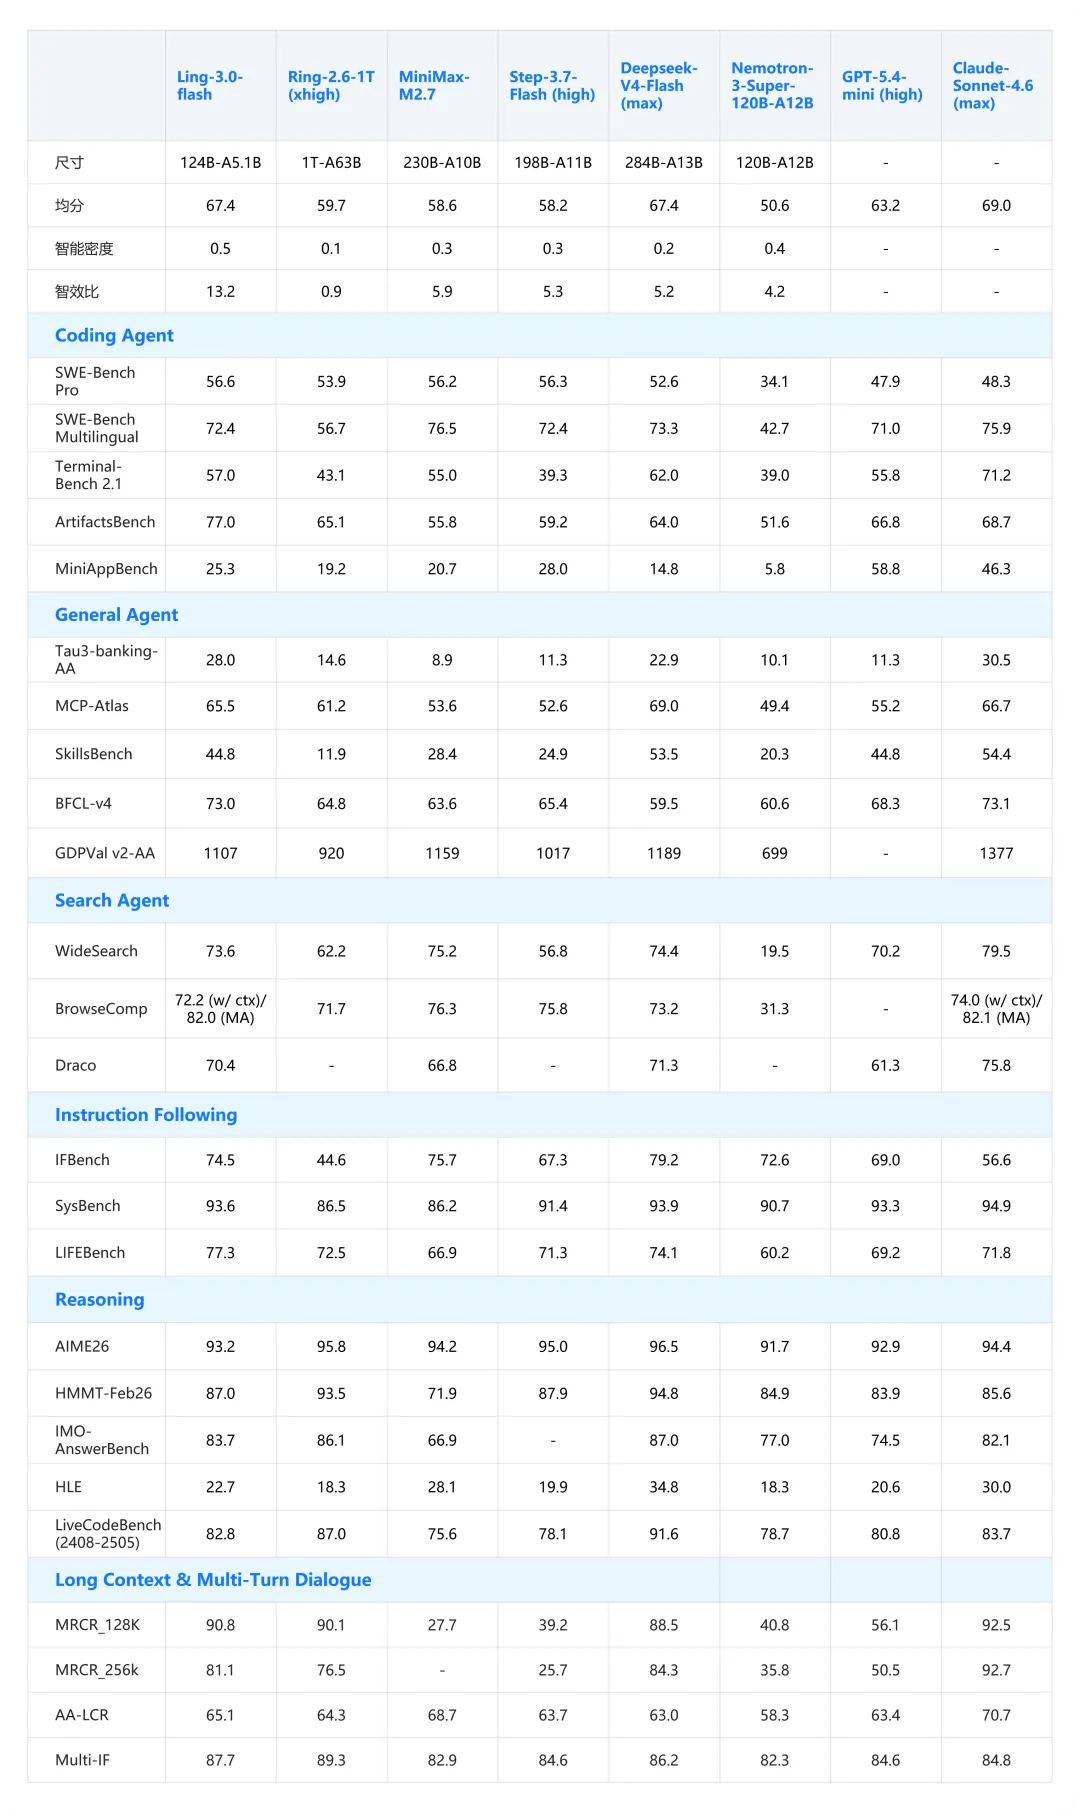
flash 智能密度 0.5,全场对比模型中最高;智效比 13.2,对照 Ring-2.6-1T 的 0.9 和同行普遍的 4 到 6,差距一目了然。
SWE-Bench Pro 56.6,SWE-Bench Multilingual 72.4,Terminal-Bench 2.1 57.0,都明显领先 Ring。
Tau3-banking-AA 28.0,接近 Ring 14.6 的两倍。SkillsBench 44.8,追平 GPT-5.4-mini(high)。通用 Agent 方向,MCP-Atlas 65.5,GDPval v2-AA 1107,同样压过 Ring 的 61.2 和 920。
搜索与指令遵循是 flash 的舒适区。WideSearch 73.6,IFBench 74.5,SysBench 93.6,都处在表中高位,IFBench 还大幅超过 Claude-Sonnet-4.6(max)的 56.6。
推理上,AIME26 93.2,HMMT-Feb26 87.0,略逊于几个大激活模型,HLE 22.7 低于 DeepSeek-V4-Flash(max)的 34.8。
长上下文 MRCR_128K 90.8,MRCR_256k 81.1,排在对比模型前列。
架构的细账
能力跃迁的功劳在架构和 Agent 定向优化。
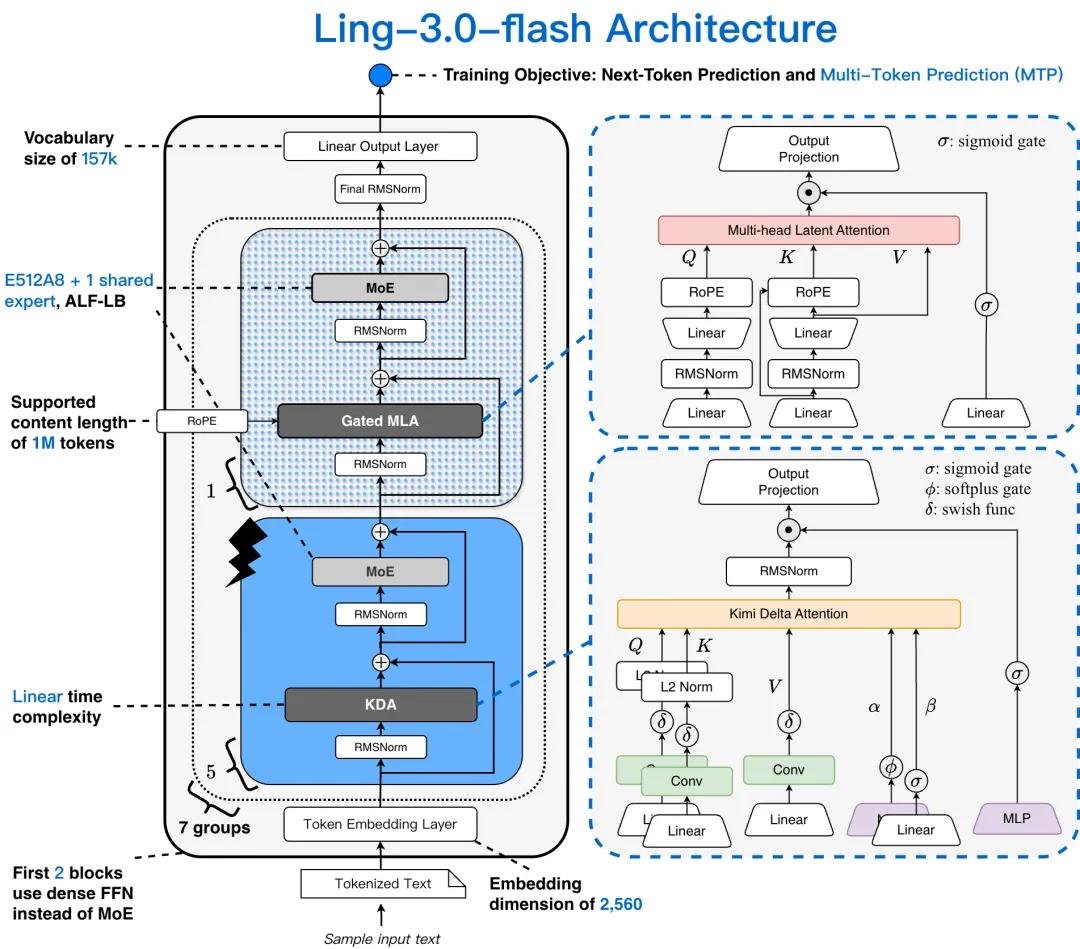
原生混合线性注意力是底座。上一代 Ling-2.6 靠架构迁移做预训练改造,Ling-3.0 从预训练伊始就原生采用混合线性注意力架构,KDA(Kimi Delta Attention)线性注意力层与 MLA(多头潜在注意力)层按 5:1 交替堆叠,每 6 层包含 5 层 KDA 和 1 层 MLA,全链路组件在整个训练周期内协同优化,兼顾长上下文效率与模型能力。
KDA 由 Lightning Attention 升级而来。它在 Delta Rule 的状态更新中引入细粒度对角门控,让不同特征通道拥有独立的保留、衰减与写入控制,有限状态记忆的控制精度明显提高。
更稀疏的 MoE(稀疏混合专家)。依据 Ling Scaling Law,更低的专家激活比例能带来更高的效率杠杆,用更少的实际计算换更高的等效能力。Ling-3.0 把每个 Token(词元)的专家激活比例从前代的 1/32 降到 1/64。
三者协同,参数与计算向实际能力的转化效率大幅提升,flash 在 124B 规模下的跨越由此而来。
为 Agent 而生
flash 的优化方向很明确,对准真实生产力场景。面对复杂约束和长程任务,它能持续规划、调用工具、响应环境反馈,根据中间结果动态调整执行路径,最终完成可验证的任务交付。
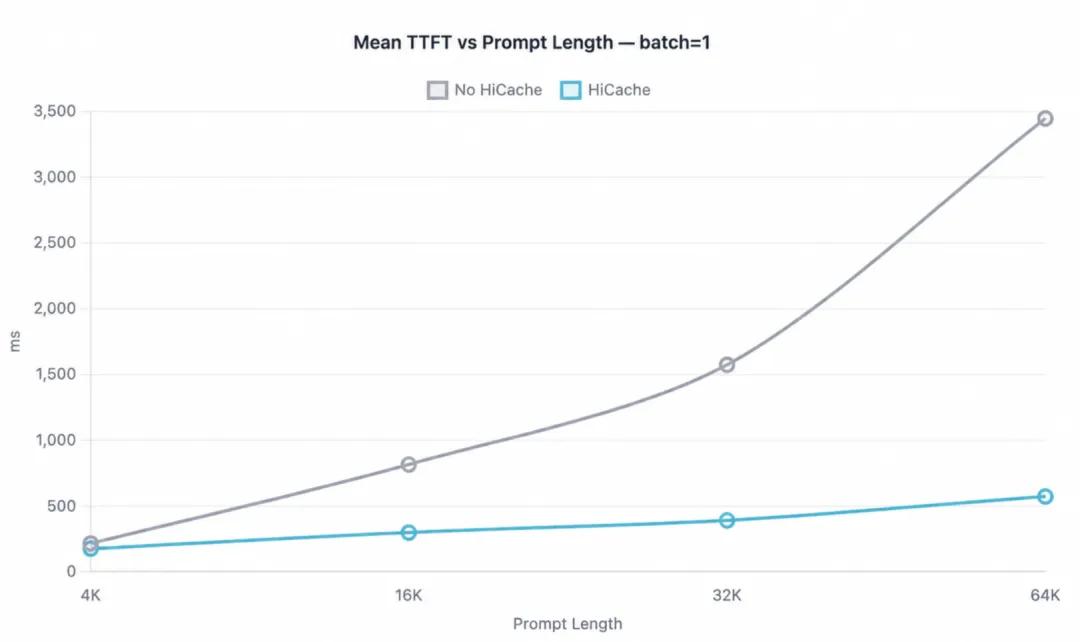
效率一端是分级缓存体系。基于 SGLang HiCache 与 Mooncake 构建集群级分层缓存,上下文可以跨层级存储、跨节点共享、按需恢复,缓存从实例私有升级为集群共享,长上下文的重复计算被压到最低。实测显示,长输入场景下命中 L3 Cache 相比直接重新计算,TTFT(首 Token 延迟)降低 60%~80% 以上。
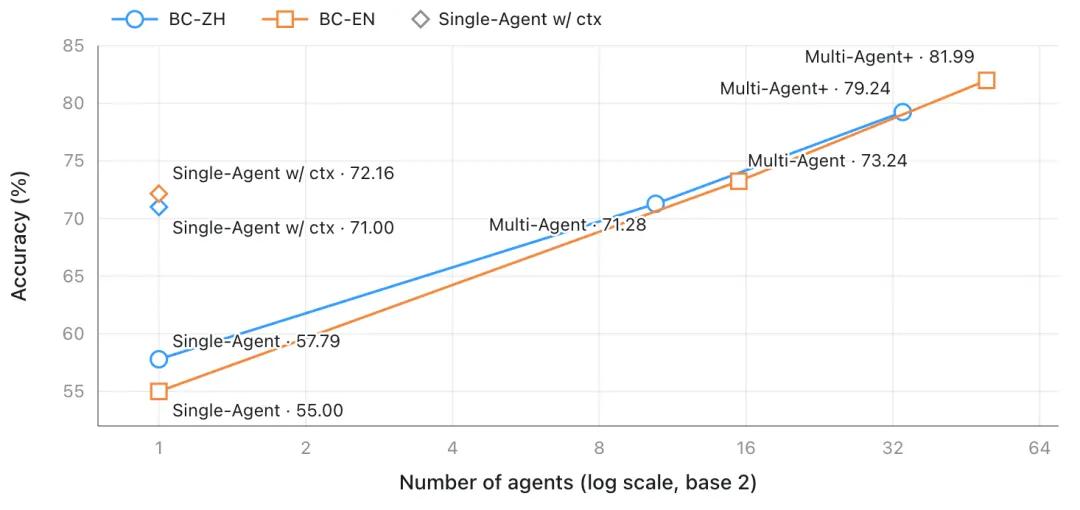
协同一端是 Ling Multi-Agent 架构。不同 Agent 围绕任务多层级分工,交叉验证、信息补充、协同纠错、竞争赛马,降低单一推理路径的偏差。在 BrowseComp 和 BrowseComp-zh 上,准确率随智能体数量呈 log-linear 增长。
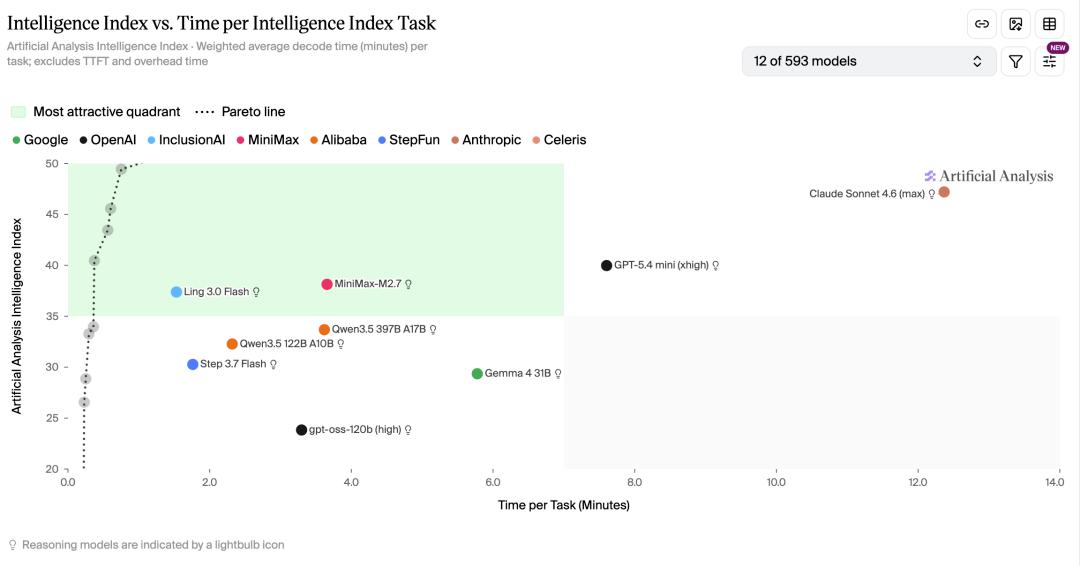
速度与成本是 flash 的另一张牌。在 Artificial Analysis 榜单上,它的输出速度 353 tokens/s,代码生成、长文本处理、Agent 执行的等待时间都被直接缩短。
AA Intelligence Index 中,每项任务加权平均调用成本约 0.04 美元,加权平均解码时间约 1.4 分钟,同时进入智能水平与成本、智能水平与耗时的两个优势区域。
官方开源提供基础版本和 FP8、FP4、INT4 多个版本,开发者按精度、硬件、成本、数据安全需求自选部署方式。
适用场景包括 Coding Agent 和代码生成工具,搜索、调研与信息整合 Agent,API、MCP 和终端工具调用,网页、游戏及轻量应用开发,办公文档与数据处理,多智能体协作中的执行节点。
例如:
Blender自动化建模。Ling-3.0-flash 通过 Blender MCP 接口控制 3D 软件,自动编写 Python 脚本在一句话指令下搭建包含高架路网、摩天大楼与材质的城场景,最后设置相机路径并渲染输出航拍视频。
在生成过程中,Ling-3.0-flash 体现出了复杂 3D 几何空间推理、Blender Python API 控制以及长程 MCP 工具调用等能力。
Ling-3.0-flash 搭建的自主多智能体科研大盘,支持跨角色自主进行假说推演、文献检索、数据质询打回、黄区现场研讨与自动化成果论文及 Slide 报告合成。
如果你需要一个多媒体应用来教学或了解,可以让 Ling-3.0-flash 给你写一个。例如开发一个网页版黑白钢琴电子琴,Ling-3.0-flash 利用浏览器 Web Audio API 实现多种合成器波形选择与声音包络调校,并配合 Canvas 实时声波可视化动效。
轻量 tiny
轻量级的 Ling-3.0-tiny,总参数量 7.9B,激活只有 1.3B,同时提供了 BF16、FP8、INT4 三个版本。
Ling-3.0-tiny 延续了 Ling-3.0 series 的原生混合线性注意力路线,还进一步面向轻量化与低门槛场景进行了优化。
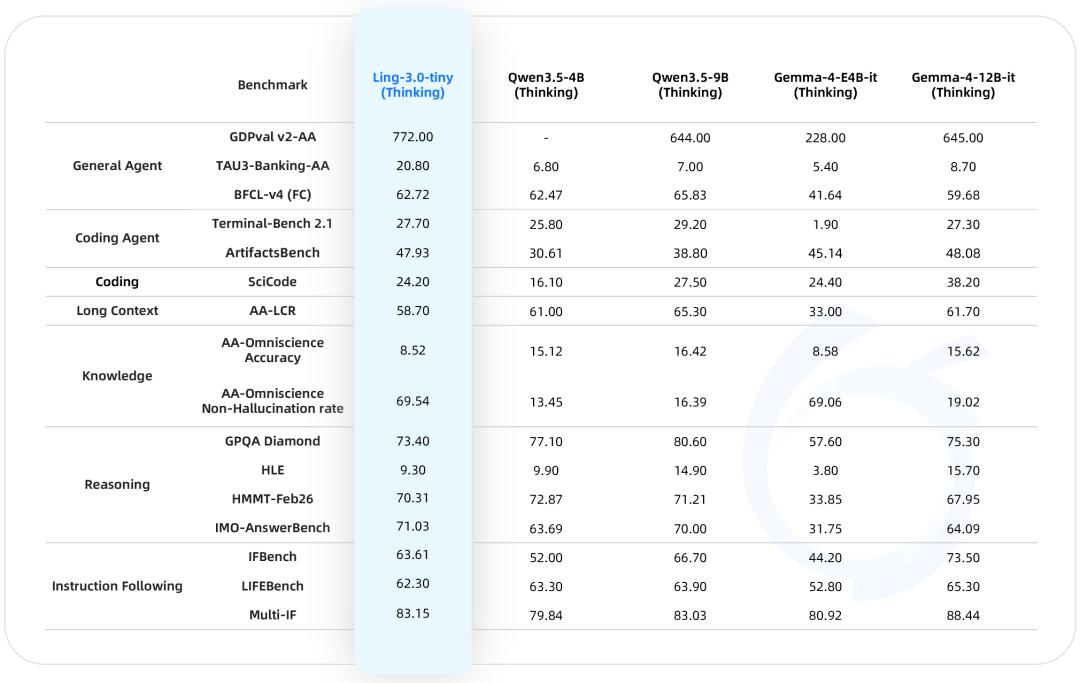
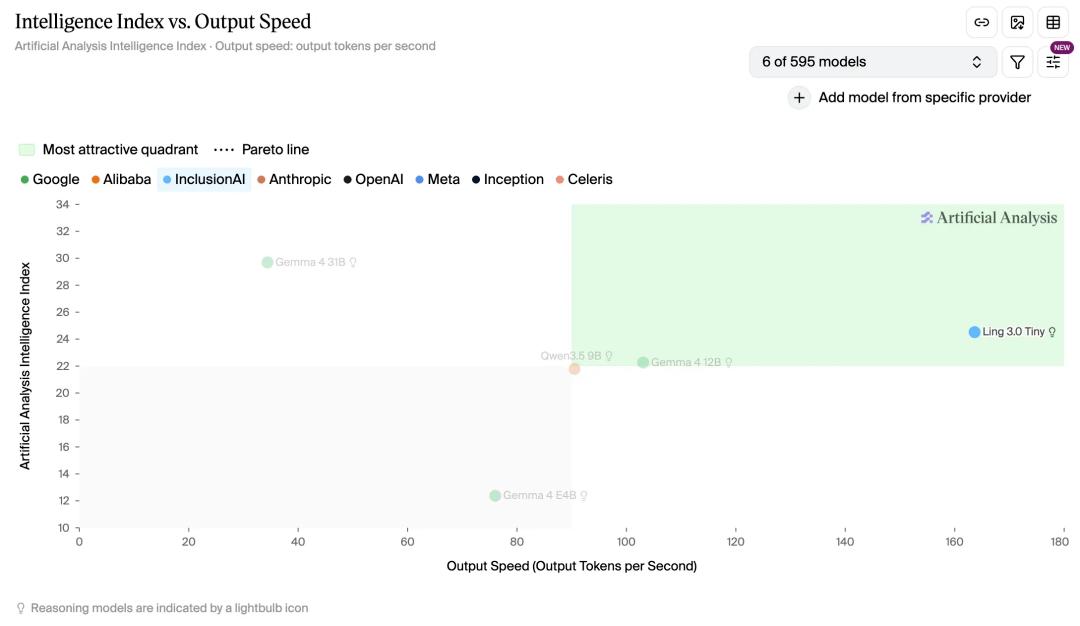
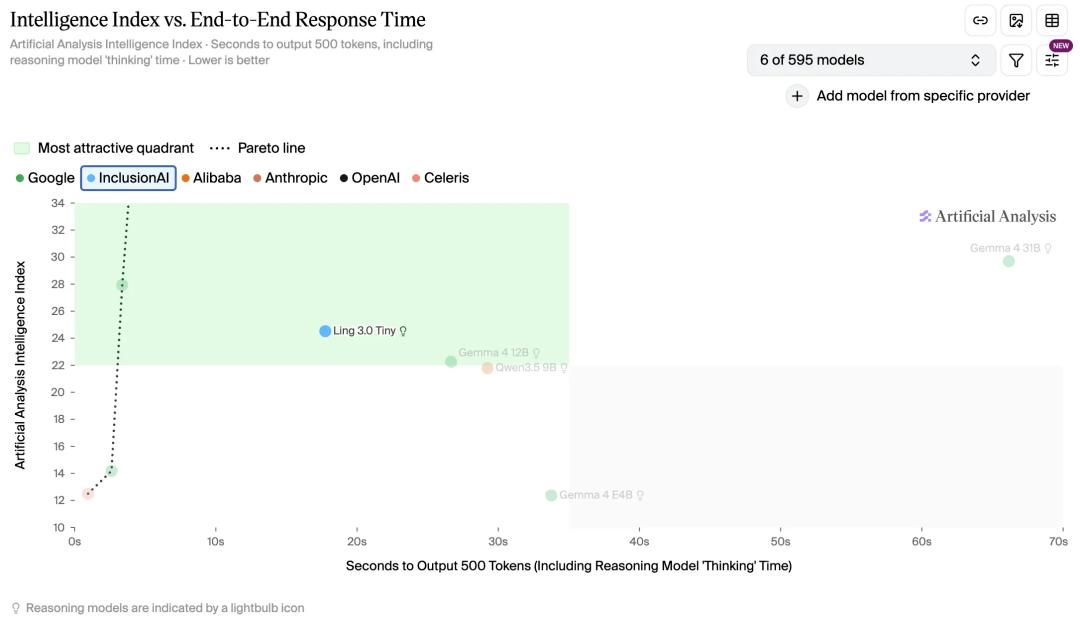
Artificial Analysis Intelligence Index 上,tiny 拿到 25 分。
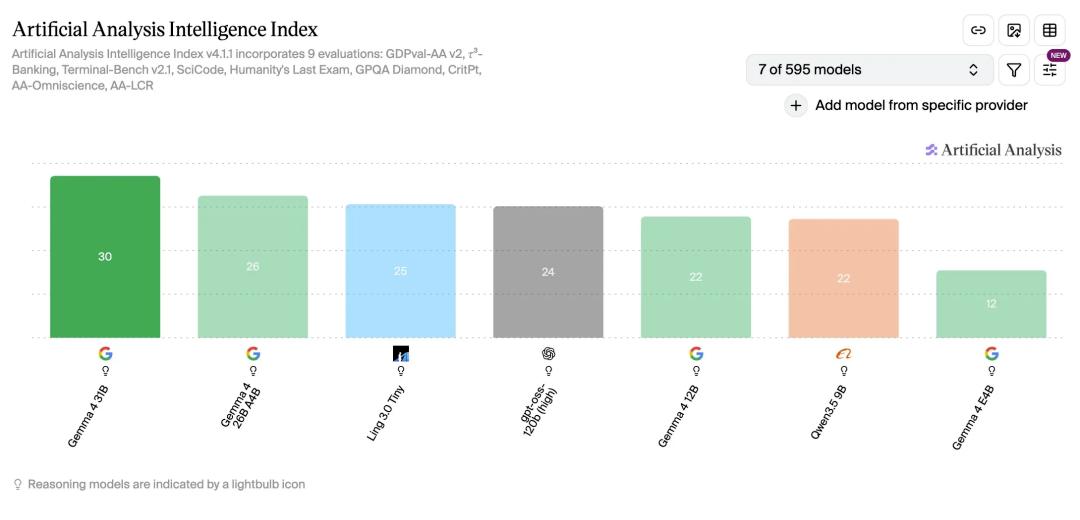
该指数综合考察真实任务、工具使用、代码、科学推理、知识可靠性、长上下文等 9 个方向。
7.9B 的 tiny,得分高于 gpt-oss-120B(high)的 24 分、Qwen3.5-9B 的 22 分、Gemma-4-12B 的 22 分、以及Gemma-4-E4B 的 12 分。
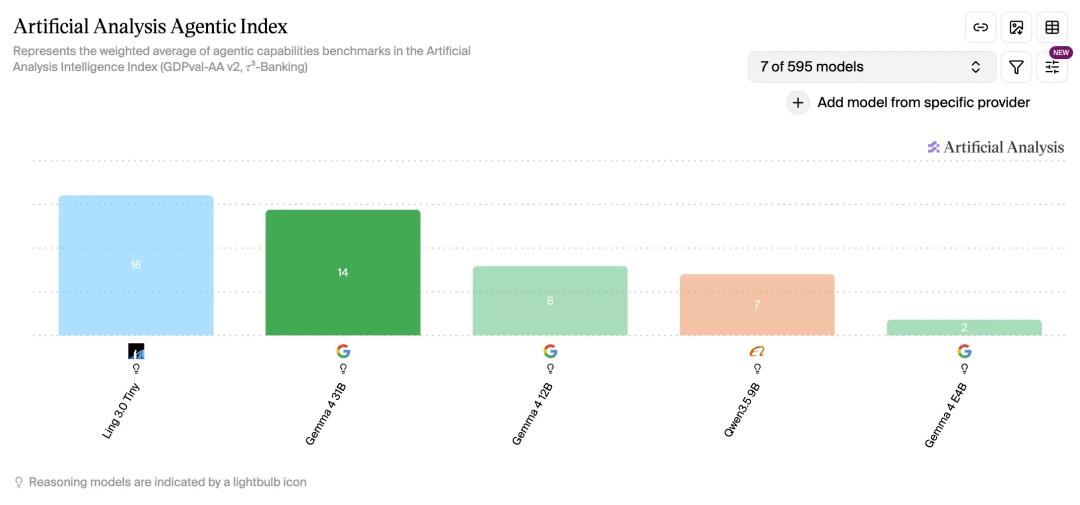
更亮眼的是 Agent 执行。AA Agentic Index 16 分,超出 Gemma 4 31B 的 14 分;GDPval-AA v2 达到 772 Elo,τ³-Banking 20.80。
IMO-AnswerBench 和非幻觉率取得领先,数学、科学推理、代码 Agent、指令遵循、长上下文表现均衡。
速度也不慢。输出超过 160 tokens/s,输出 500 tokens 的端到端时间约 18 秒,已包含思考时间。
从专业级本地工作站到个人电脑,它可以接进本地知识库、代码助手、UI 自动化、企业任务智能体等真实工作流。
例如,在 Mac mini 上部署 Ling-3.0-tiny,可以用来划词翻译、语法纠错和文本改写等日常辅助。
模型无需将数据上传云端,即可提供即选即答的低延迟体验,保护内容隐私的同时支持离线使用,为个人及企业提供轻量、低成本的本地阅读与写作方案。
Ling-3.0,不追求参数,而是算每个参数、每瓦电力能换多少智能。
flash 5.1B 激活扛起 1T 级能力,tiny 1.3B 激活跑进主流模型区间,将模型效率挖掘到了极致。
参考资料:
https://modelscope.cn/collections/inclusionAI/Ling-30
https://huggingface.co/collections/inclusionAI/ling-30