百度与浙大联手揭秘:AI大模型加速推理的“捷径”,真的靠谱吗?
这项由百度公司与浙江大学、独立研究者联合开展的研究,以预印本形式于2026年7月29日发布,论文编号为arXiv:2607.26627,有兴趣深入探究的读者可通过该编号查阅完整原文。
你每天和各种AI聊天助手对话,等待它一字一字吐出回复时,有没有想过那几秒钟的延迟究竟从何而来?事实上,像GPT、文心一言这类大型语言模型,本质上是在一个巨大的"知识仓库"里,每次只从货架上取一件商品,放到传送带上,然后再去取下一件——它无法同时取多件。这种"一件一件搬货"的工作方式,是当前AI推理速度无法进一步提升的核心瓶颈。
为了解决这个问题,研究者们发明了一种叫做"投机解码"(Speculative Decoding)的技术。简单来说,就是让一个动作迅速但不那么聪明的"小助理"先把接下来的几个词猜出来,再由那个博学但行动迟缓的"大专家"一口气检查这些猜测是否正确。如果猜对了,就直接用;如果猜错了,就纠正并重新开始。这样,大专家就不必每次都从零开始,效率大幅提升。
然而,研究者们发现,现实中很多号称能进一步加速这个过程的方法,其实暗藏隐患——它们在追求速度的同时,悄悄扭曲了AI输出内容的质量分布,而这种扭曲在简单任务上几乎看不出来,但在困难任务上却会造成显著的质量下滑。这篇论文的目的,就是把这个隐患彻底揭露出来,并找到一个更稳健的解决方向。
一、搬货工人与质检员:投机解码的基本原理
要理解这项研究,不妨把大语言模型的推理过程想象成一家高端定制餐厅的出餐流程。顾客点了一道菜(给了一个输入),厨房里有两位厨师:一位是经验丰富、厨艺精湛的"主厨"(大目标模型),另一位是手脚麻利但口味判断不够精准的"助厨"(小草稿模型)。
在传统做法里,每道菜的每一个步骤都必须由主厨亲自完成,哪怕只是撒一把盐,他也要停下手头所有工作,专门处理这一步。可想而知,这样的出餐速度极为缓慢。
投机解码的聪明之处在于,让助厨先把接下来几步的操作猜出来并提前做好,比如"我猜接下来要放盐、翻炒、加葱"。然后主厨只需扫一眼这几步操作,判断猜得对不对。如果对了,直接放行;如果错了,从错误的那步开始重做。主厨的宝贵时间,就这样被节省了大量在"决策"上的消耗。
这套机制有一个严格的保证:最终出餐的结果,必须和主厨亲自一步步完成时完全一致——即所谓的"无损验证"。这就好比,不管有没有助厨帮忙,顾客收到的那盘菜在味道上必须分毫不差。
但是,有些研究者开始琢磨:既然质量上要求分毫不差的代价是验证过程比较严格,那能不能稍微放松一点质量要求,换取更快的出餐速度?这就是所谓的"有损验证"方法的出发点。
二、为了速度放宽标准,代价究竟几何?
"有损验证"的逻辑听起来合理:毕竟,大多数情况下,差一点点的菜也是可以接受的,顾客未必能尝出区别。然而,研究团队发现,现有的有损验证方法在宣称性能相当的时候,往往是在打一个统计学上的掩护——它们比较的基准本身就已经偷偷提升了质量。
具体而言,这些有损方法在测试时,往往拿自己的结果去和一个"已经用了更好的采样策略"的主厨结果相比,而不是和什么都没加的原始主厨相比。一旦把这个虚假对比拆穿,在困难任务上,有损验证与真正的高质量基准之间的差距就会原形毕露。
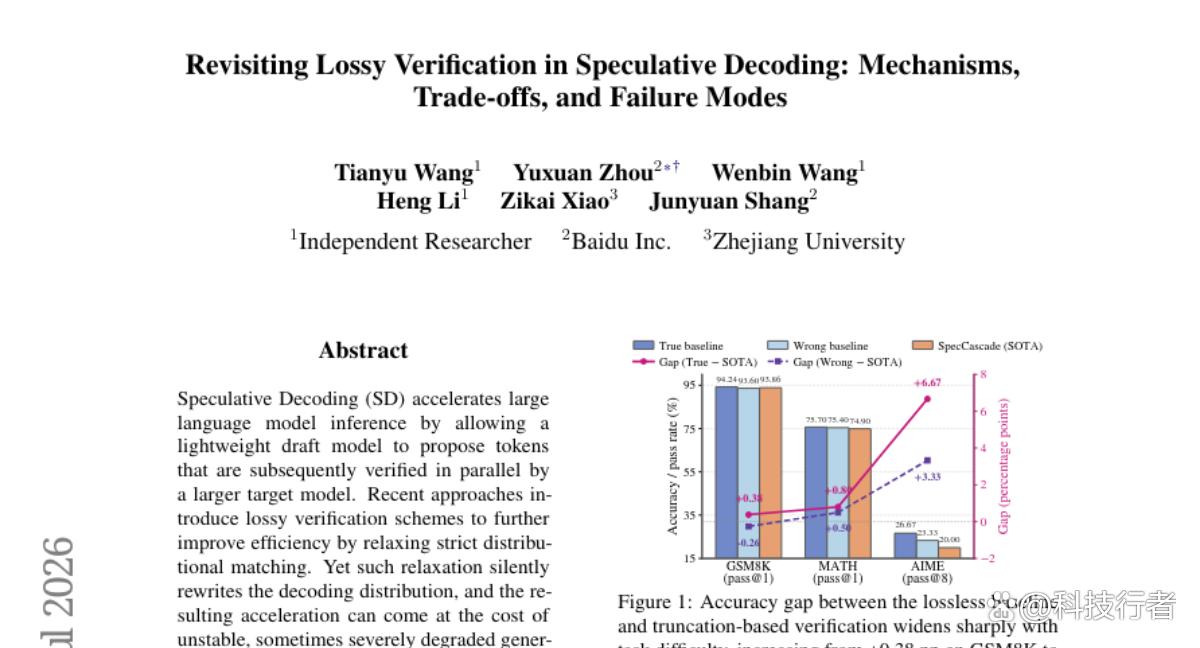
以论文中测试的数学竞赛题集(AIME)为例,这是一种需要多步骤精确推理的题目。研究团队发现,采用正确基准之后,最优秀的有损验证方法(SpecCascade)与真实基准之间的准确率差距高达6.67个百分点。而在相对简单的小学数学题集(GSM8K)上,这个差距仅有0.38个百分点。这个对比意义深远:任务越困难、越接近真实应用场景,有损方法的缺陷就暴露得越彻底。
这就像一个助手说自己能替代主厨,但他的评测方式是:把自己做的菜和一道经过精心调味的主厨菜做比较——表面上差距不大,但一旦换成正确的对照(未调味的原始菜品),差距立刻显现。
三、摸清家底:两类"有损验证"的本质差别
研究团队首先做的一件重要工作,是对现有的有损验证方法进行系统归类。他们发现,尽管各种方法名字不同、来自不同研究机构,但本质上只有两种工作机制,就像所有的锁虽然外形各异,但核心结构要么是弹子锁、要么是叶片锁。
第一类机制叫做"截断验证"。这类方法的逻辑是:主厨事先划定一个"合格词汇表",只要助厨猜的词出现在这个表里,就无条件通过,不管这个词在主厨心目中的优先级有多低。Medusa(一种加速框架)和SpecCascade都属于这类方法,它们分别使用两种不同的"划表规则"——η采样和min-p采样——来决定哪些词进入合格表。
这就像餐厅规定,只要助厨选的食材在"允许食材清单"里,就算主厨不太喜欢这种组合,也直接放行。问题在于,清单里的食材未必是主厨最想用的,最终出的菜虽然"没用禁用食材",但口味可能已经悄然偏离了主厨的理想状态。
第二类机制叫做"协作验证"。这类方法不设白名单,而是把助厨和主厨的"意见"混合在一起,形成一个折中的输出分布。就像主厨和助厨各有一票,最终的决策按某种比例结合两人的判断。CoS(Collaborative Decoding via Speculation)和"宽容松弛"(Lenience-based relaxation)方法都属于这类,区别在于混合比例是固定的还是动态调整的。
通过这个分类,研究团队揭示了一个重要事实:很多看似截然不同的方法,本质上不过是同一种机制的不同变体,而非真正的创新。
四、截断验证的隐形陷阱:清单决定命运
研究团队接下来深入剖析了截断验证的问题所在。根据截断验证的规则,只要助厨猜的词在合格表内,就无条件通过。这意味着最终输出的分布,其实是助厨模型经过合格表过滤后的分布,而不是主厨的分布。
用餐厅的比喻来说:最终上桌的菜,其实是"助厨风格受限版",而不是"主厨风格受限版"。两者都受到了同一份食材清单的约束,但操刀者不同,口味自然有偏差。
研究团队证明,真正能够提升质量的,是直接让主厨在合格表范围内选择(也就是截断采样基准),而不是让助厨在合格表范围内自由发挥。用数学表达,截断验证产生的分布是草稿模型q受限于合格表的归一化分布,而截断采样基准产生的是目标模型p受限于合格表的归一化分布。这两者之间,存在由草稿模型质量决定的固有差距。
更糟糕的是,当把截断验证方法集成到EAGLE-3这样的多候选树形框架时,这个差距会被进一步放大,而不是随着草稿模型改进而消失。研究团队通过数学推导证明,在EAGLE-3的树形验证机制下,截断验证与截断采样基准之间的KL散度(一种衡量两个分布差异程度的指标)不会随着草稿质量提升而趋向零,而是始终保持一个正值下界。这个理论预测在实验中得到了充分印证:在EAGLE-3框架下,SpecCascade与正确基准的平均准确率差距从单草稿模式下的0.38个百分点扩大到了1.68个百分点;而典型接受(Typical Acceptance)方法的差距则从0.32个百分点急剧扩大到了6.32个百分点,在部分语言理解任务(INCLUDE)上甚至达到了惊人的8.8个百分点。
研究团队还推导出一个关于截断采样对加速效果影响的定理,说明截断采样对推理效率的正负影响,取决于被保留词汇带来的"收益"与被丢弃词汇导致的"损失"之间的平衡。以min-p采样为例,当截断阈值(pbase)较小时,收益大于损失,效率有所提升;但当阈值接近0.9时,丢弃的词汇过多,效率反而下滑。η采样则表现更稳健,在测试范围内始终保持正向的效率增益。
五、协作验证的关键密码:控制"超调"才是王道
在协作验证方面,研究团队重点分析了CoS和宽容松弛两种方法为何表现差异如此巨大。CoS的做法很直接:把主厨分布和助厨分布按照固定比例(λ和1-λ)混合在一起。比如λ=0.4,就意味着最终输出有40%来自主厨,60%来自助厨。随着λ降低,越来越多的比重被分配给助厨,效率提升了,但质量也在线性下滑——在代码生成任务(MBPP+)上,当λ=0.2时,Pass@1(第一次就答对的比例)从基准的75.84%跌至71.43%,λ=0.4时跌至61.20%,λ=0.2时进一步跌至50.26%,质量下降趋势非常明显。
宽容松弛方法的表现则截然不同:它也能提升效率,但质量几乎没有损失。研究团队分析这种方法的数学结构,发现它对词汇的处理分为三个区间。当助厨的概率低于主厨时(草稿低估目标),对输出分布做自适应插值;当助厨的概率略高于主厨但没超过主厨概率除以宽容因子l时(草稿轻度高估),直接用助厨的分布;而当助厨的概率超过主厨概率除以l时(草稿严重高估,即"超调"),则对概率设置一个上限,不允许超过p/l这个"天花板"。
为了弄清楚究竟是哪一部分在保护质量,研究团队设计了一个精巧的消融实验——就像医生逐一关闭身体器官来判断哪个器官负责某个功能一样。他们把宽容松弛方法的两个组成部分拆开,分别测试:一组只保留"低估区的自适应插值",另一组只保留"超调区的概率天花板"。
结果令人印象深刻。只保留自适应插值的方法,表现和CoS几乎一样糟糕——质量随效率提升而大幅下滑,λ=0.2时Pass@1仅为50.26%。而只保留超调天花板的方法,在不同λ值下Pass@1始终维持在75%左右(75.93%、75.13%、75.66%、75.13%),与无损基准(75.84%)相差无几,同时效率仍有3%的提升。
这个发现非常直接:保护生成质量的核心机制,是对助厨超调行为的压制,而不是复杂的自适应混合。换句话说,在助厨预测得太"自信"、概率分配过于集中于某些低质量词汇的地方,踩一脚刹车就够了;至于助厨预测不足的地方,其实没必要过度干预。
这与近年来多项独立研究的发现高度吻合——大语言模型生成低质量内容,往往源于少数"超调词汇"(即草稿模型对某些词语赋予了远超目标模型的概率),而不是整体分布的偏差。
六、实验场的真实考验:四个任务的全面比拼
研究团队选择了四个难度各异、领域不同的测试集,来全面评估各类方法的实际表现,这样的多维度评估就像同时考察一个厨师在中餐、西餐、甜点、饮料四个方面的水准。
数学推理任务(MATH)考察的是精确的多步骤计算,需要模型在推理链条的每一环都保持准确。代码生成任务(MBPP+)要求模型写出能实际运行且通过测试用例的Python代码,容错空间极小。多语言理解任务(INCLUDE)覆盖了多种语言和地区文化知识,对语言多样性要求极高。工具调用任务(BFCL)则测试模型能否准确生成API调用格式,哪怕一个符号的差错都可能导致调用失败。
在标准单草稿投机解码框架下,截断验证方法(SpecCascade和Typical Acceptance)与各自的截断采样基准相比,在大多数任务上的质量均有所下降,差距最大出现在多语言理解任务上,超过1个百分点。效率上的提升微乎其微,与额外引入的质量风险并不相称。
切换到EAGLE-3多候选树形框架后,局面急剧恶化。典型接受方法在所有四个任务上的质量均低于EAGLE-3的基础无损基准,在多语言理解任务上准确率仅为27.91%,而基础EAGLE-3已有35.50%,截断采样基准更高达36.73%。SpecCascade情况稍好,但在多语言理解和代码生成两个任务上同样跌破了EAGLE-3基准线。
论文还给出了三个生动的质量失效案例。第一个案例是Python函数返回值错误:给定"找到需要多少次旋转才能得到相同字符串(大于0次)"的题目,截断采样基准正确返回了n(完整旋转周期),而SpecCascade的输出返回了0——这显然违反了"大于0次"的规定,而且这个错误看起来天衣无缝,很难被发现。第二个案例是数学符号与Python符号的混淆:在工具调用任务中,正确答案要求输入Python形式的x**2,而SpecCascade的输出却是数学形式的x^2,导致API调用失败,而且这种错误在整个参数网格中重复出现了14次,说明这是一种系统性偏差而非偶然失误。第三个案例是函数签名被误读:题目中要求编写一个"判断是否无盈亏"的函数,正确版本接受cost_price(成本价)和selling_price(售价)两个参数,但SpecCascade版本只接受了一个amount参数并返回amount==0——草稿模型被提示词中的"金额"一词带偏,生成了一个表面合理但逻辑错误的答案。
七、一个更好的思路:禁区之外加个天花板
研究团队在实验末尾还提出了一个令人充满期待的改进方向:把截断验证和超调天花板结合起来。具体规则是,合格表(AΘ)内的词汇直接用草稿概率;合格表之外的词汇,则用min{草稿概率, 主厨概率/l}作为生成概率,也就是说,在被主厨认为不够好的词汇范围内,依然允许草稿模型输出,但对其概率设置天花板。
在代码生成任务(MBPP+)上,这个组合规则在测试中实现了3.7%的效率增益,同时Pass@1与无损基准完全持平(75.66% vs 75.66%)。相比之下,纯截断验证方法(SpecCascade)效率提升1.7%但质量下降1%,纯宽容松弛效率提升2.0%质量下降0.6%,组合规则在效率与质量的平衡上均优于现有方案。
这个发现意味着,那些被截断规则"打入冷宫"的低概率词汇,其实并非一文不值——它们可以作为一个探索空间,只需加上超调天花板这道安全阀,就能在不影响质量的前提下挖掘出更多的效率潜力。
归根结底,这项研究传递的核心信息是:用于加速AI推理的"捷径"并非一定有害,但必须用正确的尺子来量它的代价。现有很多有损验证方法之所以看起来"性价比高",不过是因为选错了参照物。一旦换上正确的参照系,尤其是在困难任务上,那些看似无伤大雅的加速方案,可能已经在悄悄侵蚀你最需要的那部分准确性。
而真正值得信赖的加速方案,应当把注意力集中在压制草稿模型的"超调行为"上——这才是质量劣化的根源所在。有损加速的未来,不在于大刀阔斧地混入草稿模型的偏好,而在于精准识别并控制草稿模型偶发的"过度自信"。这个发现,为后续设计更稳健的投机解码算法提供了明确的方向。
---
Q&A
Q1:投机解码(Speculative Decoding)是什么原理,为什么能加速大语言模型的推理?
A:投机解码的原理是用一个轻量级的小模型先快速猜出接下来几个词,再让大模型并行验证这些猜测是否正确。猜对了就直接使用,猜错了就从错误处重新生成。由于大模型每次验证多个词远比一个个生成要快,整体推理速度因此得到提升,而标准做法能保证最终输出与大模型独立生成时分布完全一致。
Q2:截断验证方法(SpecCascade、Typical Acceptance)在EAGLE-3框架下为何表现更差?
A:在EAGLE-3的树形候选验证机制下,草稿模型的概率不再参与验证决策,验证完全依赖目标模型的截断分布。研究证明,此时截断验证产生的分布与截断采样基准之间的KL散度不会随草稿质量提升而消失,导致分布失真被固定在一个正值下界。简单说,EAGLE-3越强,截断验证和正确基准之间的差距反而越大而非越小。
Q3:协作验证中的"超调天花板"具体是怎么工作的,为什么它比均匀混合更有效?
A:超调天花板的做法是:当草稿模型对某个词赋予的概率超过目标模型概率的1/l倍时,就把输出概率强制压回到p/l这个上限,不允许草稿模型在这些词上过度自信。均匀混合(如CoS)在每个词上都按固定比例引入草稿影响,导致质量随混合比例线性下滑;而超调天花板只在草稿"偏离过大"的地方介入,其余地方保持不变,因此在获得效率提升的同时几乎不损失质量。