FactorEngine:突破符号局限,用“图灵完备代码”重塑量化因子挖掘
“FactorEngine: A Program-level Knowledge-Infused Factor Mining Framework for Quantitative Investment”
在量化投资领域,因子挖掘始终面临一个核心矛盾:符号化方法可解释性强,但表达能力受限;神经网络方法性能出色,却难以审计且容易过拟合。面对这一困境,来自北京邮电大学与北京值元科技有限公司的研究团队提出了一种全新的解决方案——FactorEngine,该框架将因子定义为“图灵完备的程序代码”,而非传统的数学表达式,从而赋予因子挖掘前所未有的表达自由与计算效率。
FactorEngine的核心创新在于“三分离”机制:将逻辑演化与参数优化分离、将LLM方向性搜索与贝叶斯自动搜索分离、将LLM计算资源与本地计算资源分离。这种设计不仅大幅提升了因子挖掘的效率,还使得框架能够从金融研究报告中提取知识,转化为可执行的因子程序。实验表明,在真实市场数据上,FactorEngine相比传统方法在信息系数(IC)上提升了58%,年化超额收益提升了126%,且在因子多样性与抗衰减能力上均表现卓越。让我们一同探索,这套颠覆性的框架如何为量化投资打开全新可能。
【 扫描文末二维码加入星球获取论文 】
摘要
本文研究的是Alpha因子挖掘问题,即从充满噪声且非平稳的市场数据中自动发现具有预测能力的信号。研究背景是,实际应用中要求挖掘出的因子必须可直接执行、可审计,并且整个发现过程在计算上要具备可扩展性。现有的符号化方法受限于有限的表达能力,而神经网络预测器则往往牺牲可解释性来换取性能,并且容易受到市场机制转换和过拟合的影响。
本文提出了FactorEngine(FE),一个程序级的因子发现框架。FE将因子视为图灵完备的代码,并通过三种分离机制来提升效果与效率:
(i) 逻辑修订与参数优化的分离
(ii) 大语言模型(LLM)引导的方向性搜索与贝叶斯超参数搜索的分离
(iii) LLM使用与本地计算的资源分离。
FE还包含一个知识注入的引导模块,该模块通过一个闭环的多智能体提取-验证-代码生成流程,将非结构化的金融报告转化为可执行的因子程序。此外,FE还引入了一个经验知识库,支持基于演化轨迹的优化(包括从失败中学习)。在真实OHLCV数据上的广泛回测表明,FE产生的因子在预测稳定性和投资组合表现上显著更强,相比于基线方法,其信息系数(IC)和信息系数信息比率(ICIR)以及Rank IC和Rank ICIR更高,年化收益(AR)和夏普比率(Sharpe)也得到改善,达到了领先的预测和投资组合性能。
简介
Alpha挖掘是量化投资的核心目标,旨在从噪声和非平稳的市场数据中发现可操作的预测信号。尽管经过数十年的研究,但由于市场复杂性、机制转换和严重噪声,高效且有效的因子发现仍然充满挑战。现有方法主要分为两类:
基于符号表达式的方法:此类方法(如遗传规划GP)构建于显式的数学表达式之上,可解释性强,但依赖手工规则和领域知识,可扩展性差,且容易因市场条件变化而失效。它们受限于预定义的算子空间,表达能力和搜索效率有限。
基于神经网络的方法:此类方法(如LSTM、Transformer)能够捕捉市场数据中的隐含模式和非线性关系,预测性能强,但可解释性差,容易过拟合,特别是在缺乏金融归纳偏置的情况下。
近期,大语言模型(LLM)在Alpha挖掘领域展现出潜力,如AlphaAgent和RD-Agent-Quant。然而,现有方法仍面临三大挑战:
符号化因子的表达能力受限:搜索空间有限,演化的因子脆弱,且高度依赖特定训练周期。
因子多样性和稳定性不足:缺乏有效整合金融理论并将复杂报告特征转化为可执行因子的机制。
演化流程效率低下:LLM生成与评估信号产生之间存在速度不匹配,导致计算成本高。
为解决这些问题,作者提出了FactorEngine(FE),一个程序级的因子演化框架,它将逻辑演化与贝叶斯超参数优化相结合。FE将参数优化视为与语义推理不同的计算密集型过程,并通过三种关键分离实现高效的宏观-微观协同演化:
逻辑分离:程序逻辑/思想的演化与参数优化相分离。
搜索策略分离:LLM驱动的方向性搜索与自动化的贝叶斯搜索相分离。
资源分离:LLM的使用与本地计算资源相分离。
LLM智能体专注于逻辑发现,而本地计算结合贝叶斯搜索则自动化参数优化。与以往工作不同,FE使用图灵完备的程序持续演化因子,允许复杂的控制流、条件逻辑和迭代计算,从而更灵活地建模市场动态和高阶特征交互。通过从金融报告和专家设计的因子中获取知识注入的种子因子,FE提升了效率和性能。在真实市场数据上的广泛回测表明,FE在预测和投资组合指标上持续优于现有方法。
本文主要贡献:
程序级超启发式框架:将因子挖掘转化为图灵完备的程序演化问题,利用环境反馈和经验链引导LLM在高维代码空间中进行启发式搜索。
宏观-微观协同演化:将演化解耦为宏观层面的启发式逻辑演化和微观层面的贝叶斯超参数优化,解决了参数局部最优问题,克服了效率瓶颈。
知识注入的因子多样性:提出一个闭环多智能体模块,将非结构化金融报告中的特征精确转化为程序化因子,使系统能够利用基于透明经济原理的多样化先验知识。
卓越的性能与多样性:实验表明,FE在预测和投资组合指标上超越了最先进的基线方法。例如,相比于基于金融报告初始因子的Alpha158,FE的IC提升了58%,年化超额收益提升了126%。同时,FE增强了因子池的多样性。
相关工作
传统Alpha挖掘
包括手工设计的因子(如Alpha158、Alpha360)、基于遗传规划(GP)的方法(如AlphaEvolve)、基于强化学习(RL)的方法(如AlphaForge)以及神经网络模型。这些方法在稳定性、可解释性或效率方面存在局限。
金融中的LLM
新兴方法如FAMA(动态因子组合)、AlphaAgent(利用金融材料提取灵感)、RD-Agent(数据驱动的因子与模型联合优化)等,但它们仍依赖符号表示,限制了表达能力和搜索空间,且LLM需要同时处理逻辑演化和参数优化,限制了可扩展性和效率。
问题定义
考虑一个包含 N 只股票、T 个交易日的股票池。对于每只股票,在时间t有一个 M 维的特征向量。设 X_{t-L+1:t} 为回溯窗口长度为L的原始市场特征。
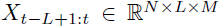
因子挖掘的目标是学习一个Alpha因子 f,将历史特征映射到未来l步的预测信号 r_{t+l}。形式上,因子定义为 f(X_{t-L+1:t}) -> r_{t+l}。在实践中,我们构建一个由K个因子组成的集合 {f_k}_{k=1}^K,并通过函数 g(如线性回归或神经网络)聚合成复合预测信号 z_t。
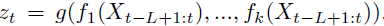
设 Y = {y_{t,1}, y_{t,2}, ..., y_{t,n}} 为t时刻的真实未来收益。Alpha挖掘的目标是构造一组新的 K 个因子,以最大化在整个时间范围上评估的某个预定义性能指标 R(Z, Y),如信息系数(IC)。
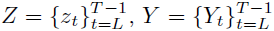
方法
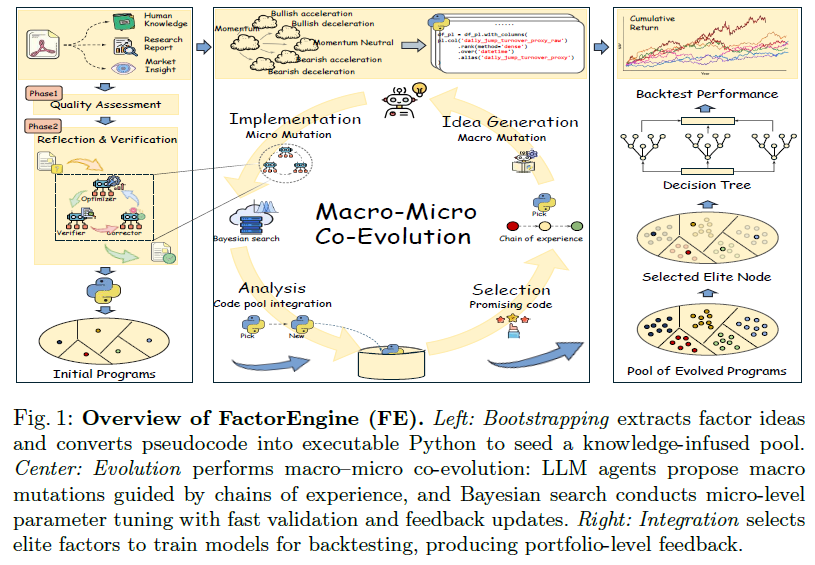
FactorEngine(FE)将程序化(基于代码的)因子作为Alpha挖掘的基本表示。每个因子程序都强制执行明确的接口约束,包括预定义的数据类型、输出格式、允许的Python库和任务特定执行语义。FE系统由三个功能解耦但协同交互的模块组成,形成一个闭环流程:
引导模块:构建一个知识注入的初始因子池。
演化模块:执行由经验链和实证反馈信号引导的代码级因子演化。
集成模块:支持多因子建模和市场数据回测。
引导模块
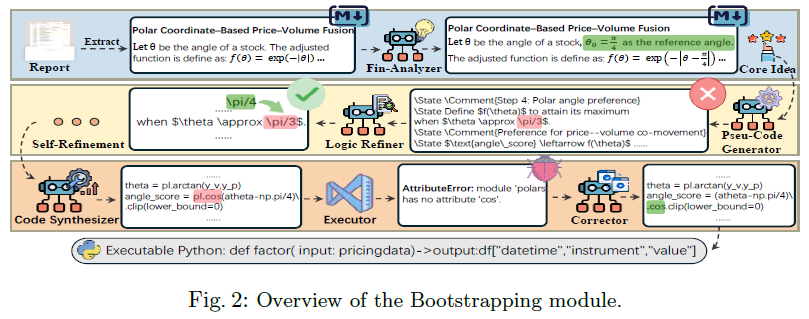
该模块通过一个闭环多智能体系统,将金融报告和专家因子中的知识系统性地提取、精炼并转化为可执行的程序化因子。它包含三个子模块:
PDF处理:基于LLM的合规性筛选,整合核心知识。
因子提取:通过“理解-生成”两步流程,并辅以迭代反思和验证,将研究报告中核心的金融思想提取为结构化的JSON表示和LaTeX格式的伪代码。
代码生成:将验证后的伪代码和核心思想摘要,通过迭代精炼(验证结构合规性)转化为可执行的Python代码。
所有成功提取的因子及其核心思想摘要和经济原理被存储为知识注入的初始因子池,作为演化模块的种子种群。
演化模块
该模块是FE的核心,通过宏观-微观协同演化机制提升因子性能。演化机制将逻辑演化与参数优化分离。每个演化迭代遵循四个阶段:程序选择、想法生成、实现和分析。
程序选择:演化因子池被组织成树结构,每个节点是一个可执行程序。使用适用于树的上置信界算法(UCT)准则来选择最有望的节点进行精炼。节点价值 $Q(v)$ 是其子树内所有评估的均值奖励。UCT值定义为:
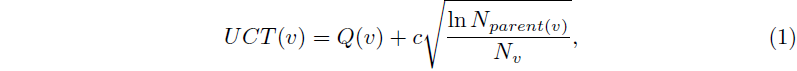
其中 c 控制探索-利用权衡:

想法生成:基于选定的程序节点,从演化池中构建一个由历史轨迹组成的演化经验链(CoE),并选择3条候选路径。每条路径的综合得分由效果得分和覆盖度得分共同决定。这些路径作为上下文,与LLM的参数化知识共同作用,生成突变想法。
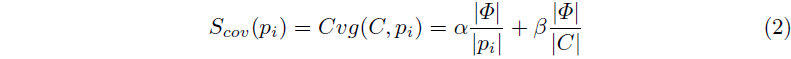
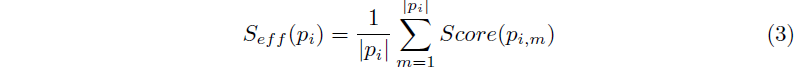
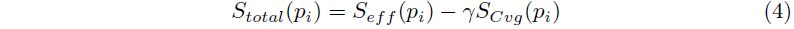
实现:此阶段进行微观突变,即通过贝叶斯搜索算法自动优化与参数相关的组件(如窗口大小、衰减因子)。优化问题为 θ*,其中 f(P, θ) 是评估函数,返回组合得分。贝叶斯方法通过最大化期望提升(EI)来建议参数:
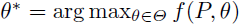
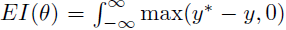
验证过程采用两阶段策略:首先进行基于LLM的序列代码验证,确保正确性;然后完全在本地计算资源上进行并行的贝叶斯优化,无需LLM参与。
反馈传播:新程序评估后,LLM总结其核心逻辑、相对变化和性能提升/下降,存储为节点经验。同时,定量反馈沿演化路径反向传播,更新所有遍历节点的 Q 和 N 值。
为提高效率,FE引入了多岛屿演化配置,即初始化N个独立的演化过程,每隔M轮,各岛屿将其前三的因子迁移到其他岛屿。
集成模块
该模块通过精英节点选择和多因子建模,从演化因子池中构建高性能的多因子信号。采用轻量级的阈值过滤机制,每个因子用加权适应度得分(FS)评估:
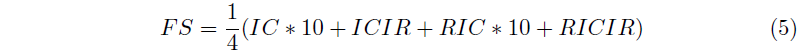
在滚动评估窗口下,保留适应度得分超过0.4的至多前5个因子节点,并为每个节点选择前10个参数配置。
实验
实验设置
基线方法:与GPLearn、LightGBM、LSTM、Transformer、TRA、AlphaAgent、RD-Agent-Quant和Alpha158等基线方法进行比较。所有基于智能体的方法均使用Gemini-2.5-Pro作为骨干模型。
超参数:实验在200次和400次迭代两种预算下进行。FE的岛屿数设为2,每7次迭代迁移一次。初始因子/报告数为5或10。
数据集:使用Qlib提供的全市场数据集,在CSI300和CSI500市场进行评估。数据划分为训练集(2008-2014)、验证集(2015-2016)和测试集(2017-2024)。引导模块仅使用2017年之前的金融研究报告。
评估指标:预测性能指标包括IC、ICIR、Rank IC、Rank ICIR。投资组合性能指标包括年化收益(AR)、信息比率(IR)、最大回撤(MDD)和夏普比率(SR)。
主要结果
性能对比:在CSI300和CSI500市场上,FE-alpha和FE-report在所有实验设置下均显著优于其他基线方法。在CSI300市场中,FE-report实现了最高的IC(0.0474)和年化超额收益(18.99%);在CSI500市场中,分别为0.0536和8.36%。
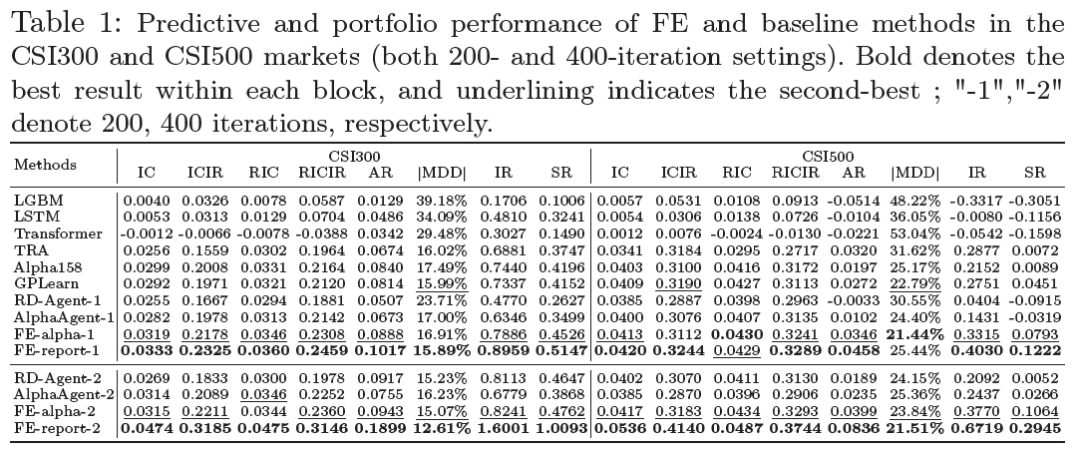
迭代轮次影响:FE在不同迭代轮次下均表现出更好的性能,说明程序级因子演化框架能有效发现捕捉市场特性的因子。
金融报告的价值:当金融报告数据量增加时,FE-report演化出的因子性能显著提升。例如,IC从0.0333提升至0.0474,AR从0.1017提升至0.1899,MDD从15.57%降至12.61%。这表明FE能有效从金融报告中提取知识。
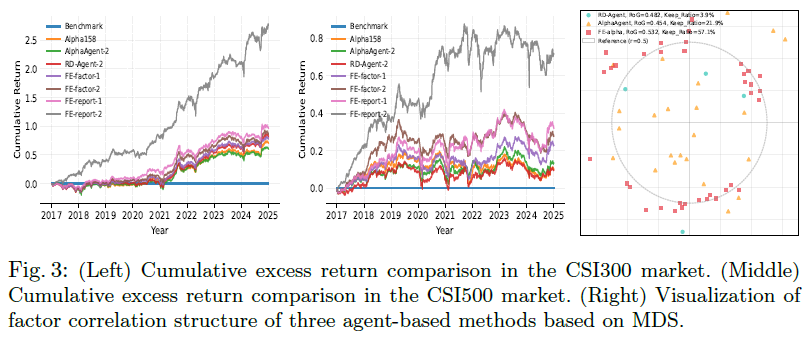
超额收益曲线:FE的因子在2017-2024年间的超额累计收益曲线持续优于Alpha158、AlphaAgent和RD-AGENT。
因子多样性分析
使用多维缩放(MDS)将因子相关矩阵投影到二维空间。FE-alpha的因子保留率(57.1%)显著高于AlphaAgent和RD-AGENT。其因子在空间中呈现“圆形分散”模式,表明相互独立性更强,冗余度更低。FE-alpha的旋转半径(RoG)最大,表明在嵌入空间中的整体分散度最高,为下游多因子模型提供了更丰富的互补Alpha信号。
Alpha衰减分析
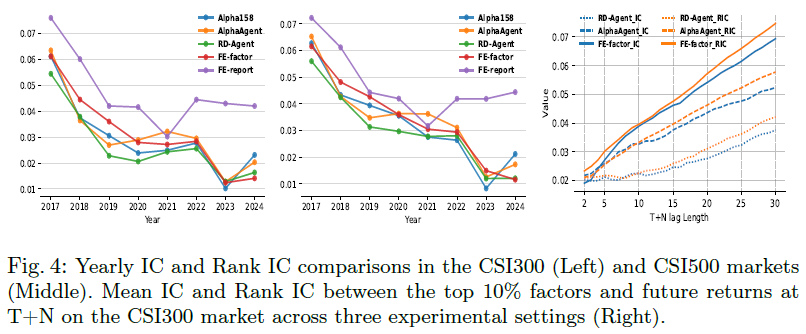
在逐年IC变化趋势中,FE-report在整个测试期(2017-2024)持续保持高IC和Rank IC,且在2021年后停止衰减甚至有所改善。FE-alpha的衰减过程更平缓,无显著波动,从而获得了更优的累计收益和投资组合表现。对于不同滞后期的回报信号,FE演化出的因子与回报信号的平均相关性高于其他两种基线。
Token效率与可执行性
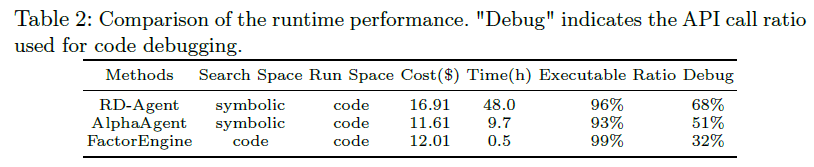
在200次迭代的运行性能对比中,FE的开销与AlphaAgent相当,但显著低于RD-AGENT。FE在运营效率上远超其他方法,得益于使用Polars框架加速计算和因子演化的并行化。FE所需的调试API调用比例最低(32%),且不可执行因子比例最低(1%)。
消融研究
贝叶斯微观搜索 vs. 无贝叶斯搜索:在40次迭代的宏观演化预算下,使用贝叶斯搜索的变体在最终性能和搜索速度上均显著优于使用固定参数的变体。最佳程序得分约为0.38 vs. 0.25。
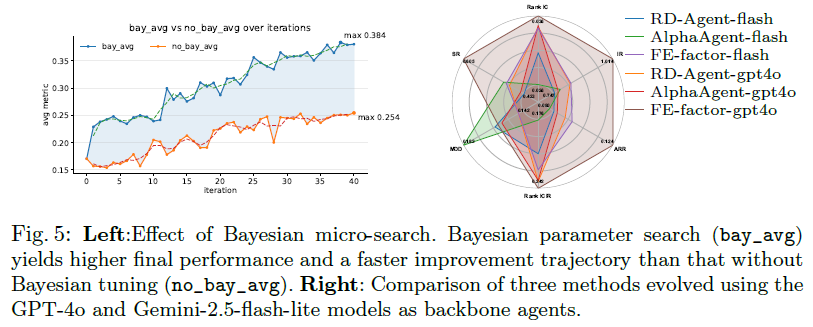
骨干模型:使用GPT-4o作为骨干模型的FE-factor在RankIC、Rank ICIR、AR、IR和SR上表现最佳,说明更强推理能力的模型有助于生成更优的因子。
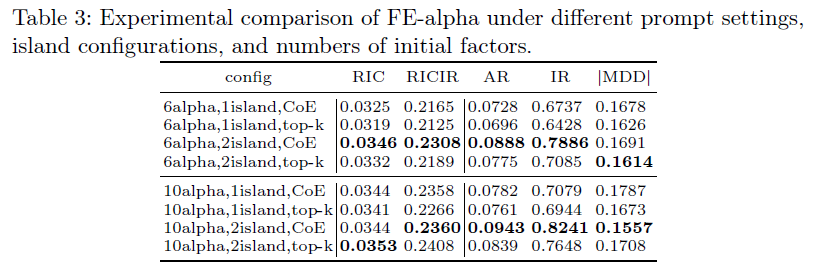
实验配置:实验表明,使用多岛屿配置和基于经验链(CoE)的提示信息能够显著提升因子演化性能,如更高的RankIC和更好的投资组合表现。
总结
本文提出了FactorEngine,一个用于发现可执行、可审计因子的程序级Alpha因子挖掘框架,同时保持整个流程的计算可行性。FE通过将因子表示为图灵完备的程序,并引入知识注入的引导模块和经验链,在效果、效率和多样性上取得了提升。FE本质上是一个针对离散、结构化搜索空间的无梯度优化框架,其核心优化信号来自演化机制,而非Alpha特定的假设,因此该方法可应用于其他评估代价高昂的黑箱离散优化问题。未来工作包括扩展到更丰富的模态、提高对分布漂移和交易成本的稳健性、使LLM能够主动查询市场数据,以及更好地表征经验引导程序演化中的多样性和泛化性。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
