Seedance 2.0的效果!MiniMax H3新一代通用视频模型开源
MiniMax 把自家最新的通用视频模型开源了。
在闭源模型长期主导视频生成领域的当下,这件事对开源社区来说,相当有分量。
文生视频和图生视频(带音频)性能已经登上全球前三。
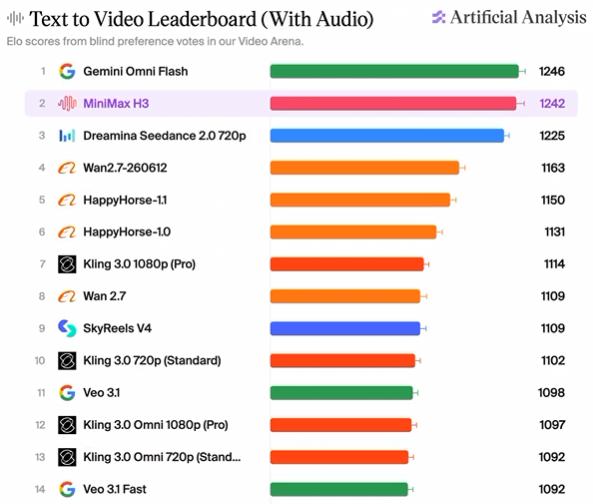
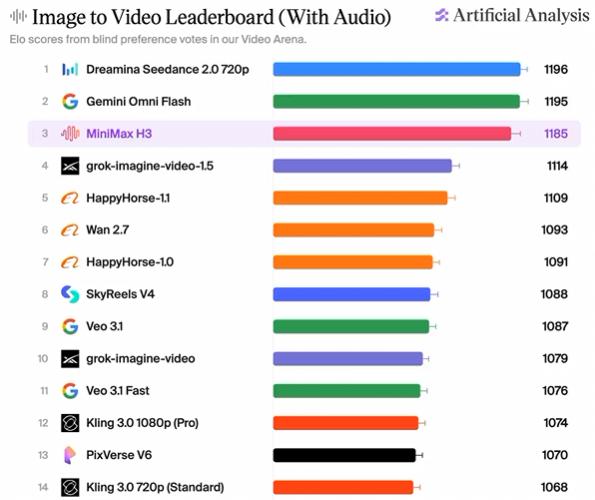
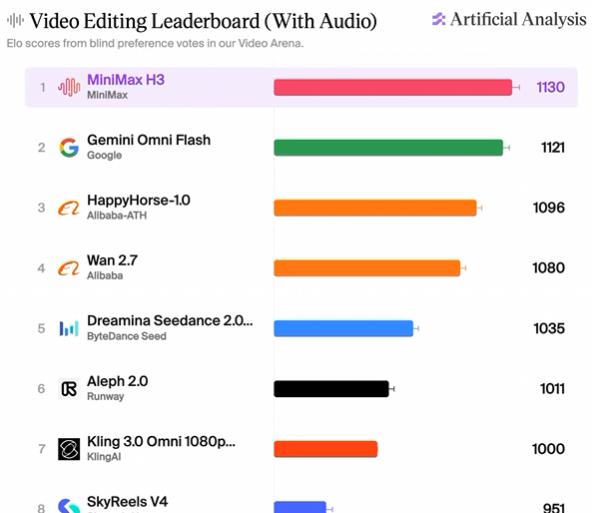
视频编辑全球第一。
视频生成效果不输Seedance 2.0(视频来源:X@LadyyEth)。
更难以置信的是,3060显卡就能本地部署。
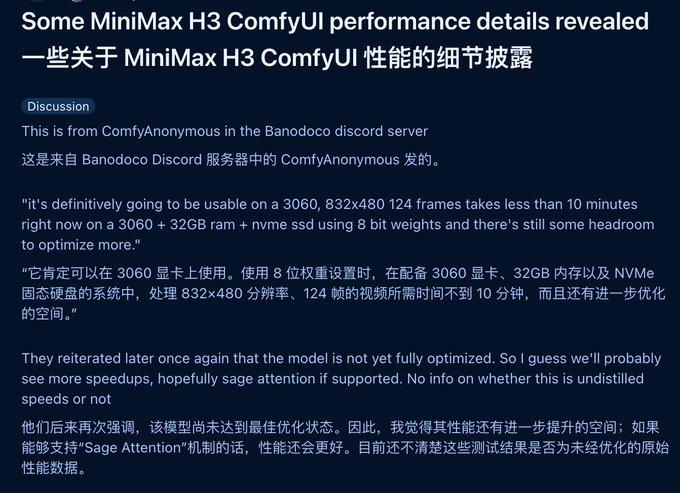
ComfyUI已经原生第一时间支持部署。
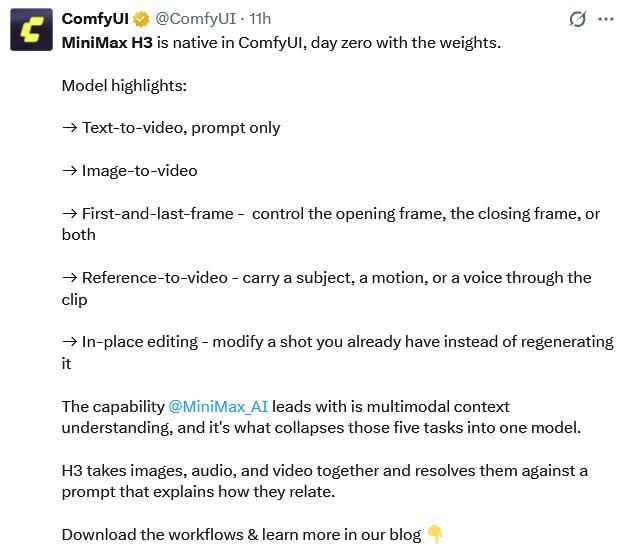
H3 是一个全模态生成模型,能同时理解文字、图片、视频和声音,输出带原生立体声的2K视频,最长15秒。
模型权重已开放下载,而且设计之初就考虑了国产芯片兼容。
一个模型,所有模态
过去做内容生成,任务被切得很碎。图片生成拆成文生图、编辑、主体参考、风格参考等独立模型;声音生成分成人声、音效、音乐各管各的;视频生成更夸张,文生视频、图生视频、首尾帧、动作参考、音色参考、视频编辑……每个细分功能都是单独一套。
这种隔离限制了使用自由度,也从训练范式上卡住了泛化能力。
H3 的设计第一纲领,就是把任务统一起来。
官方Demo演示,上传参考视频、图片和音频,
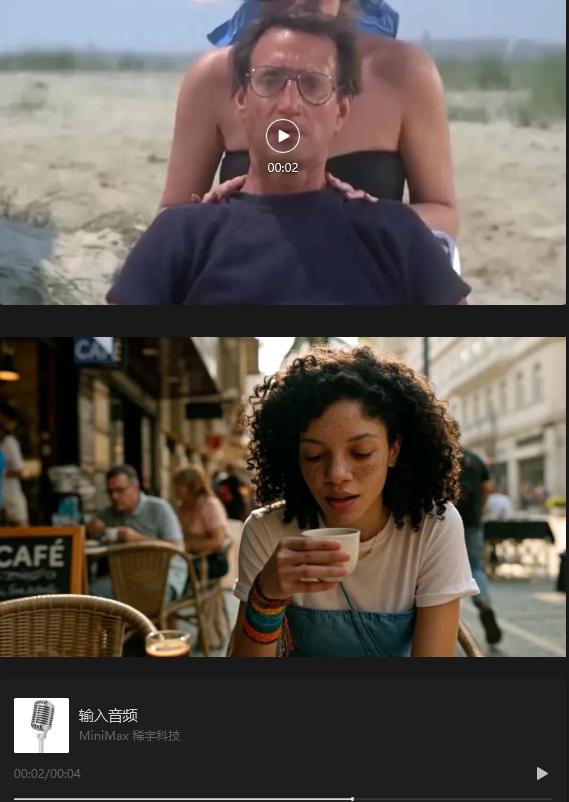
给 H3 一段提示词,“参考视频1的希区柯克镜头运动,让图2中的人物唱歌,歌声参考音频3”。就能得到人物场景和音频完美结合的视频。
语言描述清楚上下文和目标的关系就行,复杂的全模态理解工作,H3 自己完成。不需要你分别去找一个镜头迁移工具、一个人物驱动工具、一个声音克隆工具,再手动拼接。
输出规格上,H3 支持4到15秒时长,宽高比覆盖21:9、16:9、4:3、1:1、3:4、9:16等,默认短边768像素,配合再生成模块可到2K。帧率24 FPS,音频32 kHz立体声。语言方面稳定支持11种,包括中文、英语、日语、韩语、法语、德语等。
商用场景上,H3 在指令遵循、文字与品牌信息呈现、V2V Motion Transfer(视频到视频动作迁移)方面表现扎实,适用于广告、电商、产品设计、UI/UX、游戏等领域。
三个模块,各司其职
完整的 H3 系统由三部分组成。
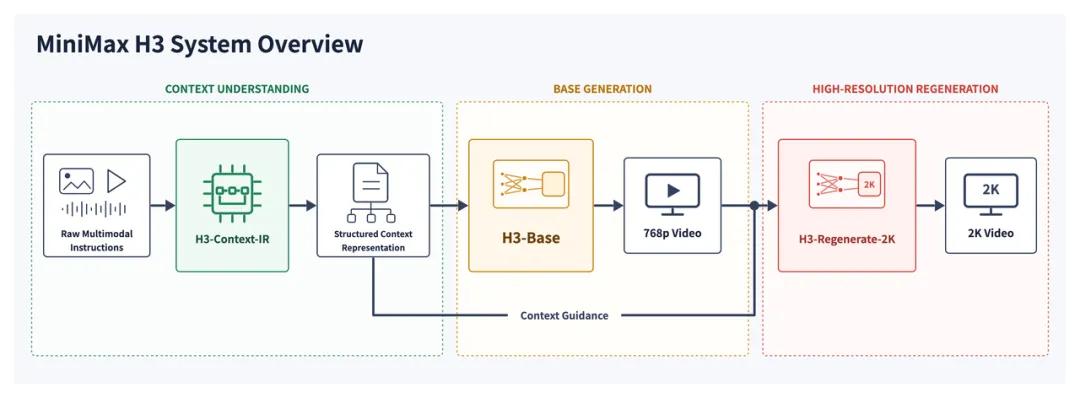
H3-Context-IR,负责理解和编排。用户输入的多模态信息可能很复杂,文字、图片、音频、参考视频混在一起。Context-IR 把它们之间的关系理清楚,做指令解析、跨模态关联、时序理解和逻辑推理,最终序列化成一种结构化的中间表示,交给下一步。
它还能在不偏离用户意图的前提下,补充描述不充分的语义细节。这个模块依赖多阶段工作流和多个托管服务,本次未开源,提供 API 调用。
H3-Base,核心生成引擎。文本由 H3-Encoder 编码,视觉输入同时经过 H3-Encoder 和 H3-VisualVAE 编码,音频由 H3-AudioVAE 编码。
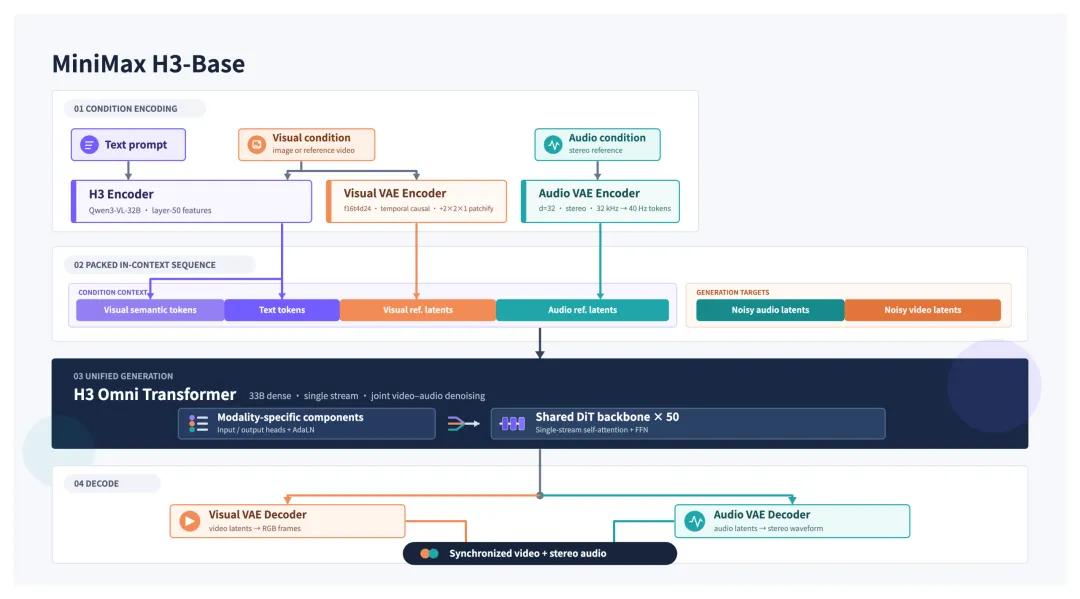
编码后的表示组织成统一的 packed multimodal sequence(打包多模态序列),通过 RoPE 表达 token 之间的空间和时间关系,送入 H3-Omni-Transformer。Transformer 联合预测视频 latent 和音频 latent,再分别解码为视频和立体声音频。
为降低长序列的计算开销,H3 原生支持稀疏注意力训练与推理。首个开源版本提供全注意力推理,稀疏注意力实现后续更新。
H3-Regenerate-2K,负责把768p拉到2K。这里没有用传统的超分辨率模块。做法是把768p结果连同原始上下文一起送回 H3,以 in-context(上下文内)方式重新生成2K版本。
好处有两个:复用 H3 基础模型已有的生成能力;再生成时能再次利用原始多模态上下文,还原传统超分只能靠猜的信息,比如小文字和精细细节。
这个模块目前也未开源,提供 API,团队正在抓紧完成开源所需的工作。
怎么跑起来
H3-Base 以两个 task-specific checkpoints(任务特定检查点)发布,分别是 H3-Base-FL2VA 和 H3-Base-Ref2VA。
H3-Base-FL2VA 处理首尾帧模式。不输入图像就是文生视频;输入首帧就是首帧生视频;输入尾帧就是尾帧生视频;首尾都输入就是首尾帧生视频。
H3-Base-Ref2VA 处理全模态参考模式。图像最多9张,视频最多3段(每段2到15秒,总时长不超15秒),音频最多3段(必须搭配图像或视频一起输入,不能单独作为唯一输入),所有输入文件合计最多12个。
每个 checkpoint 都是自包含的 Hugging Face 模型仓库,内含 processor、tokenizer、text encoder、Omni Transformer、Visual VAE、Audio VAE。推理框架支持 SGLang、vLLM、diffusers 和 ComfyUI。
MiniMax 提供了三类可复现的768p生成案例。
T2VA,输入完整 Prompt 直接生成含画面、环境音、音效与配乐的音视频。
FL2VA,以首帧、尾帧或首尾帧为关键帧生成后续内容。
Ref2VA,联合使用参考图像、视频和音频,实现人物与场景保留、动作与嘴型编辑、音色参考、原始音频复用等复合任务。
如果想验证完整2K流程,MiniMax 提供了 Full 2K Workflow,把本地部署的 H3-Base 与官方 Context-IR、Regenerate-2K API 组合使用。
流程分三步:Context-IR 理解和扩展多模态输入生成完整 Prompt;本地 H3-Base 生成768p音视频;Regenerate-2K 将768p视频作为 base_video,结合扩展 Prompt 和原始上下文再生成2K。
闭源模型长期占据视频生成领域的主导地位,迭代速度和生态开放性落后于大语言模型等领域。
视频生成这个赛道,闭源选手跑得快,但生态一直不够开放。H3 把权重放出来,给这个领域开了一扇充满想象的窗。
模型已上线 Hugging Face,开发文档,提示词指南,官方都为你准备好了。你打算拿它做点什么?
参考资料:
https://huggingface.co/MiniMaxAI/MiniMax-H3
https://huggingface.co/MiniMaxAI/MiniMax-H3/blob/main/docs/VIDEO_PROMPT_WRITING_GUIDE_ref_en.md
https://huggingface.co/MiniMaxAI/MiniMax-H3/blob/main/docs/VIDEO_PROMPT_WRITING_GUIDE_base_en.md
https://platform.minimaxi.com/docs/api-reference/video-generation-v2-create
https://platform.minimaxi.com/docs/api-reference/video-generation-v2-h3-context-ir
https://platform.minimaxi.com/docs/api-reference/video-generation-v2-regeneration