ACL2026 - ARK:给大模型一个图谱自主探索工具,让它自己决定在知识图谱上「该广搜还是该深挖」
01. 先讲一个可能你已经踩过的坑
做医疗、医药、科研领域的知识图谱落地,最后几乎都会遇到一个经典尴尬问题:
你到底是把图谱建得越大越好,还是让检索器能自己决定“现在该往哪走”?
过去两年的主流思路是:先建一张大知识图谱,再塞进 RAG 里,做 GraphRAG。图谱越全,回答越稳。听起来没毛病。
但真落到医疗场景里,问题往往分成两类。第一类是“广搜型”,答案藏在文字描述里;第二类是“深挖型”,答案藏在关系链里。
更麻烦的是,同一份病历、同一个药品问题,可能同时需要两种检索。只给一种工具,就像让医生只能用听诊器,或者只能用 CT——都不够用。
ACL 2026 这篇 ARK 论文,把这两种能力塞进一个智能体,让大模型自己决定:现在是该广搜,还是该深挖。
举个例子:
第一类是“广搜型”。比如:常见、用于缓解打喷嚏和眼睛发痒的 H1 抗组胺药有哪些?答案基本在节点的文字描述里,靠关键词匹配就能找到。
第二类是“深挖型”。比如:氯雷他定直接作用于哪一种组胺受体?这个问题不能只靠氯雷他定那一页的文字,必须沿着“药物 → 靶点 → 基因”这条关系链跳过去。
传统文本检索只能解决第一类,图遍历只能解决第二类,而且后者还高度依赖你一开始选定的“种子实体”——选错了,整个搜索就困死在局部。
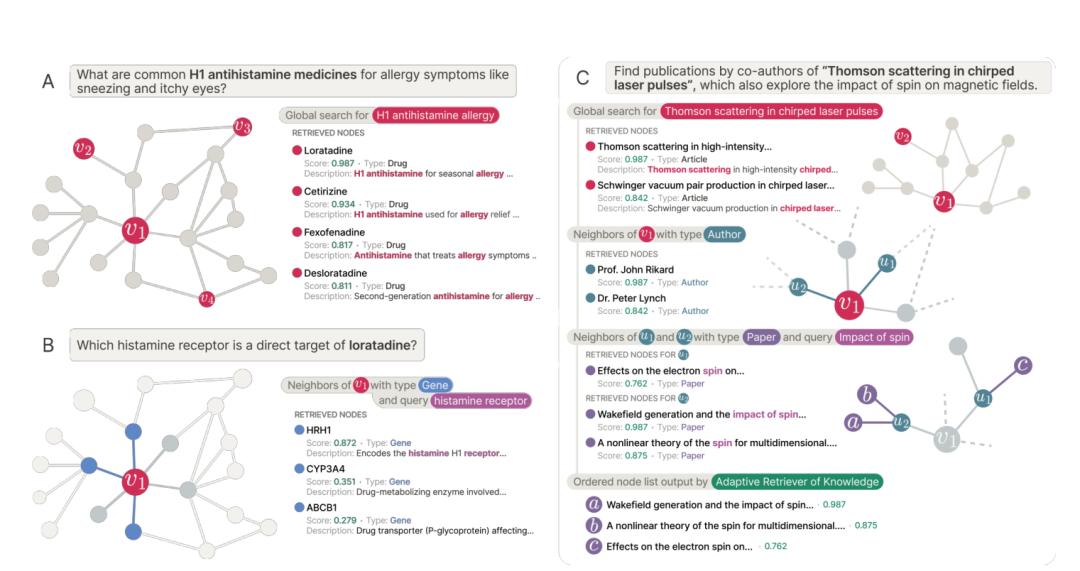
图 1:原文 Figure 1|ARK 的三种典型工作模式:A 文本型广搜、B 关系型深挖、C 多跳组合探索。图片来自原论文。
02. ARK 的解法:只给两把工具,剩下让模型自己决定
工具一:全局搜索(Global Search)
这把工具负责在整张图里做文本匹配。它不是一次性的 BM25,而是可以在检索过程中反复调用。
模型根据当前问题,生成一个短子查询,比如“H1 antihistamine allergy”或者“histamine receptor”。工具返回得分最高的若干节点。
关键点是:它可以在任何时候重新调用。发现局部搜索跑偏了,立刻回到全局重新锚定。
工具二:邻域探索(Neighborhood Exploration)
这把工具只负责“单跳邻居扩展”。从某个节点出发,返回它直接相连的节点。
但模型可以给它加两个约束:节点类型和关系类型。例如从“氯雷他定”出发,只要“基因/靶点”类型的邻居,并用“histamine receptor”做局部排序。
连续调用多次,就形成多跳路径。这相当于把复杂的图遍历,拆成一连串简单、可观察的动作。每一步都能看到中间结果,错了就改。
这里有一个细节很妙:ARK 没有设计一个“多跳搜索工具”,而是只给单跳扩展。
为什么?因为复杂工具会黑箱化。多跳工具一旦输出错了,你不知道错在第几步。单跳工具让模型的每一步决策都暴露在轨迹里,方便调试、也方便蒸馏。
这背后其实是个产品哲学:复杂的能力应该来自模型的连续决策,而不是来自工具的复杂性。你给模型越简单的接口,它反而越能组合出复杂行为。这和“最小工具集”的设计思想一脉相承。
SELECT + FINISH:把“搜索候选”和“最终排名”拆开
ARK 还有一个容易忽略但很重要的设计:模型不会把工具返回的节点直接当成答案。它必须执行 SELECT 动作,把相关节点加入候选列表;觉得证据够了,再 FINISH。
节点越早被 SELECT,最终排名越高。这避免了模型被第一次搜索结果绑架。
更有意思的是“重新锚定”。传统图遍历一旦种子选错,就一路错下去。但 ARK 在探索过程中发现方向不对,可以随时再调一次全局搜索,换一个起始点。
这在医疗里特别关键。比如你想查“阿司匹林对某种罕见突变的影响”,第一步可能搜到了“阿司匹林”,但真正的关联在“突变 → 代谢酶 → 凝血通路”里。如果模型能发现第一轮搜到的“阿司匹林”太泛,就可以重新锚定到更具体的靶点上。
03. 医疗场景为什么最该关注这个设计
ARK 在三个 STaRK 数据集上做了测试:AMAZON(商品,文本型)、MAG(学术,关系型)、PRIME(生物医学,异构密集型)。
为了更直观,我把它和常见方案做了张对比:
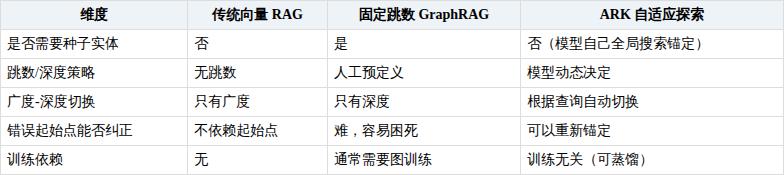
最有意思的是第三个数据集 PRIME。ARK 的工具调用比例是:全局搜索 47.7%,邻域探索 52.3%。
也就是说,医药领域的问题天然一半靠关系,一半靠文本。不是“哪条路更好”的问题,而是“同一个系统里得能自动切换”。
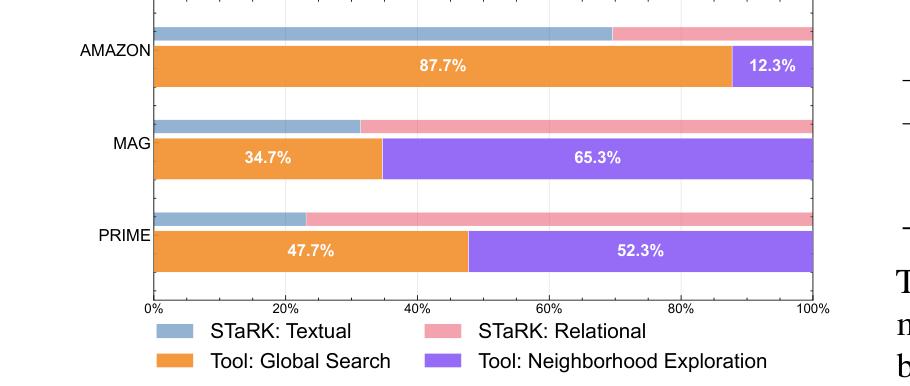
图 2:原文 Figure 3|ARK 在三个数据集上的工具调用比例。PRIME 的邻域探索(紫色)占比过半,说明生物医学问题离不开关系深挖。
反观现在很多医疗大模型的知识增强方案,要么只做向量检索,要么只做固定跳数的图遍历,等于把问题硬塞进单一模具。
比如问“氯雷他定能不能用于这个基因突变的患者”,你可能需要:
先广搜定位药物 → 再深挖靶点 → 再跳转代谢通路 → 再查相关临床表型。这种混合路径,很难靠预定义跳数解决。
ARK 的价值不是它比某个 baseline 高多少点,而是它把“检索策略”从工程规则变成模型决策。
04. 结果:三个并行代理,加一个 8B 蒸馏方案
ARK 的主配置同时跑三个独立代理,每个代理对同一个查询生成自己的检索轨迹,然后用投票合并结果。节点被越多代理选中,排名越高。
作者做了一个等预算对比:一个代理跑 30 步 vs 三个代理各跑 10 步。总步数一样,但三代理配置在 MAG 和 PRIME 上更好,说明“多样性”本身就是信号。
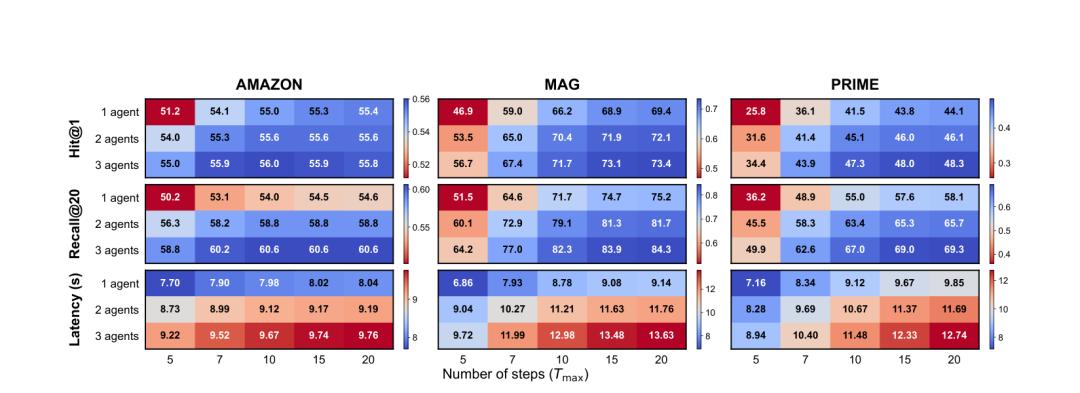
图 3:原文 Figure 2|检索质量与延迟随推理预算变化的热力图。横轴是最大步数,纵轴是代理数。图片来自原论文。
从这张图里能读出两个实用信息:
第一,10 步左右通常是个甜点区。再往后加步数,Hit@1 提升变平,延迟却继续涨。
第二,MAG(学术关系型)最需要多步+多代理;AMAZON(文本型)5 到 7 步就进入平台期。不同任务,预算该不同。
另一个亮点是蒸馏。作者用 GPT-4.1 当教师,生成检索轨迹,无标签蒸馏到 Qwen3-8B。在 MAG 上,基础 8B 模型 Hit@1 只有 35.09,蒸馏后涨到 61.66,保留了教师 98.5% 的 Hit@1 率。
AMAZON 和 PRIME 也分别涨了 7.0 和 13.5 个百分点。更惊喜的是,只用 10% 的训练轨迹数据,就能获得约一半的总提升,说明教师策略的可迁移性很强。
这意味着 ARK 的部署成本可以压得很低。医疗场景里,数据不出域、模型可本地跑,是比单纯效果更重要的需求。
作者还对比了 BM25 和稠密检索。把 ARK 里的 BM25 换成 text-embedding-3-large,并没有全面领先。BM25 在 AMAZON 和 PRIME 上反而更高,稠密检索只在 MAG 上略有优势。
原因很直观:ARK 不是一次检索定生死,而是多次交互、不断改写查询、用邻域探索补足文本匹配不足。单次检索能力被模型的连续决策弥补了。
05. 它解决的是“策略”问题,不是“图谱大小”问题
读完整篇论文,我最大的感受是:
知识图谱 Retrieval 的下一步,不是继续把图谱建得更全,而是让检索器能动态决定策略。
传统 GraphRAG 像一份规划好的旅游路线:提前定好去几个城市、每个城市逛多久。问题是游客还没出发,你怎么知道他想看博物馆还是小吃街?
ARK 更像一个会看地图的航海士:有时候沿航线直走,有时候发现前方有暗礁就改道,有时候觉得目标可能在另一个岛就重新启航。
这个比喻对医疗 AI 尤其重要。因为临床问题的“答案位置”是不确定的。症状描述在文本里,致病机制在关系链里,药物相互作用在跨域跳转里。
如果你只提供一种检索模式,要么漏掉关系证据,要么被噪声淹没。而 ARK 的证明是:只要给模型两种足够简单的工具,它自己就能在“广”和“深”之间切换,而且效果比预定义跳数更稳。
对做医疗/医药知识图谱产品的人来说,这意味着一个判断标准的变化:不要再比拼“我的图谱覆盖了多少实体、多少关系”,而要问“我的检索器能不能根据问题动态选择策略”。
06. 诚实的边界:ARK 不能做什么
论文里没有回避限制。它自己也承认,在复杂生物医学图 PRIME 上,ARK 仍然低于专门用强化学习训练的 GraphFlow。
也就是说,如果你不计成本、能针对特定图谱做专门训练,专用模型还能更强。ARK 的优势是“通用、训练无关、可蒸馏”。
另外,BM25 作为底层检索虽然稳定,但本质还是词法匹配。如果节点的文字描述质量差、命名不统一,全局搜索会受影响。图谱本身的质量,依然是天花板。
还有一个现实问题:ARK 的轨迹长度和代理数量是可调的,但医疗场景对延迟和可解释性要求更高。十步检索、三代理投票,可能还是太慢。这正是蒸馏到小模型的意义。
08. 数据速览:三个关键结论
把论文里我觉得最有用的几个数字列出来,方便你快速判断 ARK 到底值不值得关注:
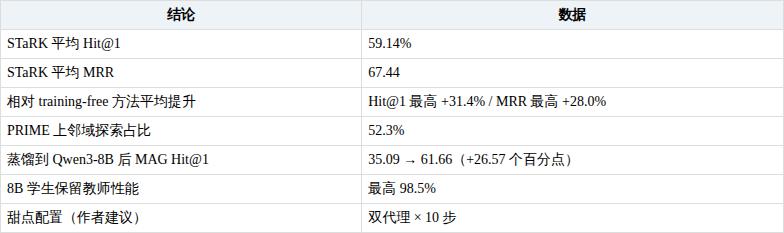
这些数字说明,ARK 不是实验室玩具。它的训练无关、可蒸馏、可配速特性,让它很接近工程落地。
09. 三个问题,送给正在做医疗/医药知识图谱的团队
第一,你的检索器能根据问题类型自动切换“广度”和“深度”吗?还是只固定做向量检索或固定跳数图遍历?
第二,当起始实体识别错了,你的系统能重新锚定吗?还是一步错、步步错?
第三,你的大模型检索策略,能不能无标签蒸馏成一个能在本地跑的 8B 小模型?
如果这三个问题都还没想清楚,ARK 至少给了一个参考答案:别把图谱当仓库,把它当一张会说话的地图。
图谱不是越大越好,模型会不会“看地图”,才是知识图谱 RAG 的下一个分水岭。
往期推荐
亚马逊云科技与柯基数据联合打造的“Automotive Services GraphRAG”解决方案亮相慕尼黑IAA展会!
GraphRAG实施中常见挑战的分析及其应对策略-海外图谱增强大模型公司Lettria的GraphRAG实践建议
知识图谱与大模型的融合:SubGraphRAG在减少幻觉和提升准确性上的突破
海外大模型落地故事: Medisolv如何利用GraphRAG破解医疗报告难题 — Writer
图谱增强生成 GraphRAG :突破 GenAI 应用边界的利器
“GraphRAG+DeepSearch” 企业级多模态Agent知识平台V2.0 重磅升级!
利用 Amazon Bedrock 知识库构建 GraphRAG 应用的全面实战指南
理解与创新:RAG、Graph RAG以及Agentic RAG在AI中的应用
引领智能检索新纪元:Graph RAG vs RAG,谁才是真正的AI知识利器?
GraphRAG:连接数据世界的AI新引擎
GraphRAG性能飞跃:结合向量搜索与Agent路由,实现知识图谱复杂问题高效解答
突破AI知识边界:探索GraphRAG、向量RAG和Agentic RAG的融合之路
图谱增强大模型智能新纪元:RAG vs Graph RAG,"生成式+结构化+可解释+深度推理" 驱动的企业智能引擎
颠覆RAG的智能媒体检索利器:GraphRAG详解
用模糊解析强化LangChain的GraphRAG:自动构建知识图谱准确率提升3倍 — 基于BAML的实践笔记
构建高效的GraphRAG系统:简化架构与工具选择的艺术
FrOG:基于知识图谱的开源GraphRAG问答系统研究综述
工业大模型公司 Mivva 解锁能源AI见解:GraphRAG智能问答助手的实践旅程
MMGraphRAG:通过可解释的多模态知识图谱桥接视觉与语言模型
OpenAI重磅发布“KG+LLM”结合的企业智能知识管理红宝书,利用大模型构建时序知识图谱与新一代“GraphRAG”智能体
Timbr GraphRAG:结构化与非结构化数据,驱动更聪明的企业级GenAI
企业GenAI革命:海外大模型创业公司Writer解密GraphRAG和知识图谱如何引领智能知识服务未来
GraphRAG革命:如何利用知识图谱提升LLM的检索与生成能力
GraphRAG:用知识图谱与生成式AI开创关系感知的智能新时代
EraRAG:突破传统GraphRAG限制,实现动态语料库的高效检索增强生成
探索AI未来:GraphRAG——更高效智能的跨文档查询方式
知识增强大模型GraphRAG 如何彻底改变阿尔茨海默病的基因研究和治疗 - 美国Cedars-Sinai 医疗中心
GraphRAG + DeepSearch: 下一代企业级人机协同大模型推理架构及医药法律等领域Agent深度详解
GraphRAG:重新定义信息检索的智能革命
九大GraphRAG的全面评估:GraphRAG-Bench基准测试集解析 - 香港理工&腾讯优图等
什么时候GraphRAG超越传统RAG:突破医学等知识密集任务的AI新范式和GraphRAG-Bench评估框架
Precina Health 如何使用GraphRAG 通过实时洞察彻底改变 2 型糖尿病护理
Graph RAG框架、基本工具和实际用例
基于GraphRAG的妊娠期糖尿病管理本地大模型
OpenTCM:基于GraphRAG的传统中医药知识检索与诊断问答图谱增强大模型系统 - 香港中文大学
HyperGraphRAG:基于超图结构知识表示的新版GraphRAG - 北邮、安贞医院等
多模态GraphRAG初探:文档智能+知识图谱+大模型结合范式
如何构建医疗健康等复杂场景下的Agentic GraphRAG?
Agentic-RAG和GraphRAG双轮驱动,基于NCCN肿瘤医学指南开发用于个性化无幻觉乳腺癌治疗
GraphRAG最新成果:基于图的RAG统一框架深度分析 — 港中深&华为
Diffbot的GraphRAG大模型
医学知识图谱驱动的GraphRAG:Deepseek-R1与Weaviate用于高级Chatbot
利用GraphRAG和数字孪生进行个性化教育:面向工业4.0劳动力发展的虚拟现实、增量式学习和零样本情感分析- 亚利桑那大学等
用GraphRAG和知识图谱解锁GenAI大模型 - Neo4j CTO 演讲视频&PPT
普华永道GraphRAG-工具融合
释放多模态GraphRAG的力量:集成图像特征以获得更深入的洞察 - 2025最新PPT
PIKE-RAG: 微软开源下一代GraphRAG,知识增强大模型解锁企业级私有数据应用落地价值
[2025最新综述解读]定制化大模型的GraphRAG - 香港理工&吉林大学等
(88页)知识图谱增强大模型GraphRAG 2025年最新调研综述 - 密歇根大学、Adobe、Meta、亚马逊等
“大模型+知识图谱”双轮驱动的见解、技术和评估 - 英伟达的GraphRAG
GraphRAG和轻量级LightRAG技术及应用案例深度解析
故障分析怎么做?朴素KG方案及LLM+Graph RAG方案实现思路
GraphRAG 的演变 -Neo4j GenAI Graph Gathering 2.0
微软GraphRAG框架演进之路及带来的一些思考
LazyGraphRAG:微软重磅推出高性价比下一代GraphRAG
提升大型语言模型结果:何时使用GraphRAG
GraphRAG产业化应用落地挑战和探索:知易行难 - 企业大模型独角兽Glean实践之四
微软GraphRAG最新动态:通过动态社区选择改善全球搜索
现有RAG框架非完全总结:7个GraphRAG+17个传统RAG框架归纳
GraphRAG从研发到上线的挑战-硅谷企业级大模型知识库独角兽Glean系列之三
企业级知识库为什么要用GraphRAG - 硅谷企业级ChatGPT独角兽Glean系列之二
企业智能知识库企业Glean利用GraphRAG融资2.6亿美元
MedGraphRAG最新版:探索医学大模型领域的未来新革命 - 牛津&CMU
医学GraphRAG案例研究:将医生记录转换为医学时序知识图谱
微软GraphRAG 0.4.0&DRIFT图推理搜索更新
GraphRAG图检索增强,助力新一代大模型知识库的落地|爱分析活动
StructRAG: 下一代GraphRAG - 中科院&阿里
RAG前沿之RAG–知识图谱构建框架Graphusion:兼看LongRAG双视角检索增强生成范式
Structured-GraphRAG知识增强框架——足球游戏数据案例研究
解锁洞察:金融服务中的GraphRAG和标准RAG对比案例解析
蚂蚁图团队GraphRAG支持社区摘要——Token相比微软直降50%
从知识图谱到 GraphRAG:探索属性图的构建和复杂的数据检索实践
基于图谱和智能体的法律文档 GraphRAG案例深度解析 - WhyHow.AI
什么时候(不)用GraphRAG
GraphRAG工程落地成本详细解读和实例分析
企业生成式人工智能应用的架构模式:GraphRAG、RAG、DSFT和RAFT
知识图谱增强大模型GraphRAG全面综述解读 - 蚂蚁集团、北大、浙大、人大等
GraphRAG:使用知识图谱进行AI Agent编排和工业化路径
贝莱德&英伟达 - HybridRAG:整合GraphRAG和VectorRAG以实现金融信息高效提取
医学GraphRAG:通过知识图谱检索增强实现安全医疗大语言模型 - 牛津大学最新论文
GraphRAG类型、限制、案例、使用场景详细解析
GraphRAG在网络安全情报分析的变革性应用
GraphRAG + GPT-4o mini 低成本构建 AI 图谱知识库
GraphRAG案例讲解-由知识图谱驱动的辅助数据目录元数据发现大模型
GraphRAG有多贵?基于GPT-4o的Token令牌消耗成本分析
使用Streamlit、LangChain、Neo4j和GPT-4o构建GraphRAG实战讲解及开源实现
基于GraphRAG的SEO智能助手实战案例 - 解锁大模型和知识图谱结合的力量
[重磅]图数据库厂商Neo4j CTO详解GraphRAG:为生成式人工智能增添知识
引入GraphRAG的场景条件分析
重磅 - 微软官宣正式在GitHub开源GraphRAG
GraphRAG如何应用于合同文档管理
开源GraphRAG解读:微软的人工智能驱动知识发现方法
揭示微软开源的RAG策略:GraphRAG
Microsoft 的 GraphRAG实践
何时构建知识图谱驱动的GraphRAG系统 — 投入和产出分析
Vector | Graph:蚂蚁首个开源Graph RAG框架设计解读
GraphRAG工作原理揭秘及挑战
从RAG到GraphRAG: 用知识图谱帮助RAG链接数据 — 海外GenAI公司Chanko实践
[万字长文]GraphRAG技术栈及样例全面解析
GraphRAG应用中小图谱与大图谱的角色
GraphRAG:设计模式,挑战和落地指南
从RAG到GraphRAG的应用落地揭秘
快速医疗信息互操作标准FHIR上的GraphRAG
Neo4j与微软合作GraphRAG,以增强GenAI能力
Linkedin的GraphRAG客服问答系统实践
重磅-微软发表GraphRAG论文并即将开源项目
企业级RAG向量检索的限制和Writer的GraphRAG方案 - Part2
海外人工智能公司Writer的GraphRAG实践揭秘- Part1
LLM的前沿高效探索 - GraphRAG: 更好,更快,更便宜
微软的GraphRAG:智能问答系统的革命
从传统RAG到GraphRAG - 当大模型遇见知识图谱
深度解析知识图谱增强的GraphRAG及医药案例
基于知识图谱的RAG全生命周期知识增强 - GraphRAG
GraphRAG: 解锁大模型RAG知识增强
大模型&知识图谱双轮驱动的企业智能与分析用
用智能体优化智能体工具:Anthropic揭秘高效Agent开发新范式
基于知识图谱增强大模型的企业级智能知识库独角兽Glean获1.5亿美元F轮融资,估值72亿美元
DoorDash如何利用知识图谱增强大模型提升搜索召回精度
ESCARGOT:一种利用大模型、动态思维图和生物医学知识图谱以增强推理的AI智能体
论文浅尝 | CogMG:大语言模型与知识图谱的协同增强(ACL2024)
知识图谱增强大模型KERAP:多智能体推理语言模型在零样本诊断预测中的革新应用 - 哈佛大学&埃默里大学等
LLM vs LMM:知识图谱增强大模型驱动营销革新浪潮
BEKO:大语言模型与知识图谱的双向增强-吴信东
重磅发布|智护成长新纪元:知识图谱增强的儿童青少年健康管理智能体
MSG-LLM:多维度互动框架用于图谱增强大模型
[npj 数字医学]知识图谱增强的无幻觉医学信息大模型
DO-RAG:一种使用知识图谱增强检索辅助生成的领域特定问答框架 - 清华大学等
论文浅尝 | KnowGPT:利用知识图谱增强大型语言模型的专业领域问答能力(NeurIPS2024)
知识图谱增强的合规医学大模型产学研新范式探索
RAKG:文档级检索增强知识图谱构建 - 上海人工智能实验室等
AMG-RAG自适应知识图谱增强医学问答:弥合大模型与动态医学知识的差距 - 多伦多大学等
将知识图谱与大模型 (LLM) 协同化:实现语义增强智能的途径
利用大型语言模型增强知识图谱查询-意大利帕维亚大学
喜讯|柯基数据知识图谱增强的医学合规科研智能体荣获信通院智能体应用优秀案例
[论文解读]知识图谱引导的检索增强生成RAG - 南京大学&阿里巴巴
喜讯|柯基数据“知识图谱增强大模型”获得“国家电网科学技术进步奖”三等奖!
富士通推出知识图谱增强RAG软件分析和可视化服务,以支持企业最佳现代化规划流程
知识图谱增强营养健康大模型:迈向改进的管理、可重复性和验证 - RPI等
[2025论文解读]基于知识图谱的思考:一种知识增强的泛癌症问答大模型框架 - 中科院&广州国家实验室等
[VLDB24 KG+LLM论文]利用多模态和知识图谱增强大模型以实现无幻觉的开放集物体识别 - 河海大学等
medIKAL-知识图谱增强大模型以提升电子病历临床诊断能力
KG4Diagnosis - 知识图谱增强的多智能体大模型在医学诊断中的应用
北大Chatlaw - 基于知识图谱增强混合专家模型的多智能体法律助手
Stardog-知识图谱增强大模型企业智能体平台Voicebox的愿景
以内容为中心的粗粒度知识图谱增强大模型的实践研究 - DataStax
EMNLP 2024 | CoTKR:面向复杂知识图谱问答任务的思维链增强的知识改写方法
MedSyn:基于医学知识图谱增强大模型的合成医学文本生成框架
事实发现者 - 通过引入知识图谱增强大模型的生物医药领域专业知识(拜耳制药&IAIS)
KRAGEN:使用知识图谱增强的RAG解决生物医学大型语言模型问题