Black Forest Labs发布Flux 3!初评超过Seedance 2.0,将开源
曾经的开源图像模型王者 Black Forest Labs(黑森林实验室)刚刚发布了 FLUX 3。
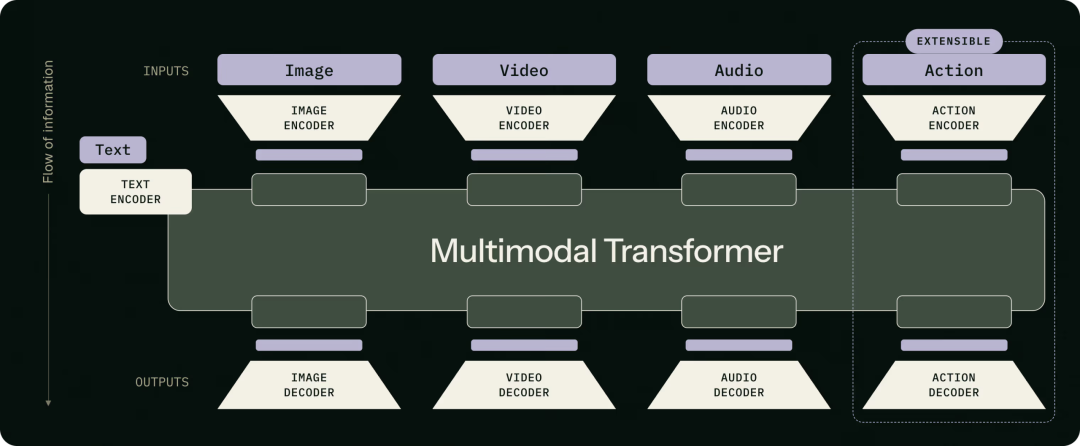
FLUX 3不再是图像模型,已经进化成把视频、音频、动作预测全塞进了同一个模型里的多模态模型。它将多模态流模型作为视觉智能的基石,开始同时用眼睛、耳朵和触觉去理解世界。
Black Forest Labs 成立于2024年,核心创始人是三位曾在Stability AI共同开发了知名开源图像生成模型 Stable Diffusion 的研究人员。
Black Forest Labs 因开源高质量顶级文本生成图像模型 Flux 1 而一战成名,其产品FLUX系列被认为是该领域最强大的工具之一。
后来的 FLUX 2,采用了更先进的“流匹配”(Flow Matching)技术,并融合了Transformer架构元素,在提升画质的同时大幅降低了推理成本。
FLUX 3 则是一款多模态模型,能够统一处理图像、视频和音频,甚至可扩展用于预测动作,为机器人等物理AI应用奠定基础。
Black Forest Labs 融资速度惊人,迅速成为独角兽企业,已筹集超过4.5亿美元资金。2025年12月完成3亿美元的B轮融资,融后估值达到32.5亿美元。主要投资者包括 Nvidia、Salesforce Ventures、Andreessen Horowitz (a16z) 等顶级机构。
一个模型,学所有感官
过去几年,生成式 AI 的路线泾渭分明,做图像的做图像,做视频的做视频,做音频的做音频。
Black Forest Labs 觉得这条路走偏了。
图像捕捉某一时刻的空间结构,视频把时间维度加回来,揭示物体怎么动、物理规律怎么运作,音频则暴露视觉看不到的因果关系,比如一次撞击该发出什么声响。语言负责把这些感知跟目标、抽象概念、指令连起来。
单独学一种模态,你得到的是那个投影的好模型。同时学所有模态,它们之间的相互约束会告诉你更多东西:声音得匹配撞击力度,运动得遵守质量守恒,未来得从过去推导出来。模态之间不再是孤立的,而是关于同一个底层现实的证据。
FLUX 3 就是完全基于这个原则构建的第一个模型。
技术上,它建立在 Self-Flow(自流)方法之上,把多模态生成和理解高效地对齐到同一个底层架构里,然后大幅扩展算力和数据,同时在视频、图像、音频上训练。
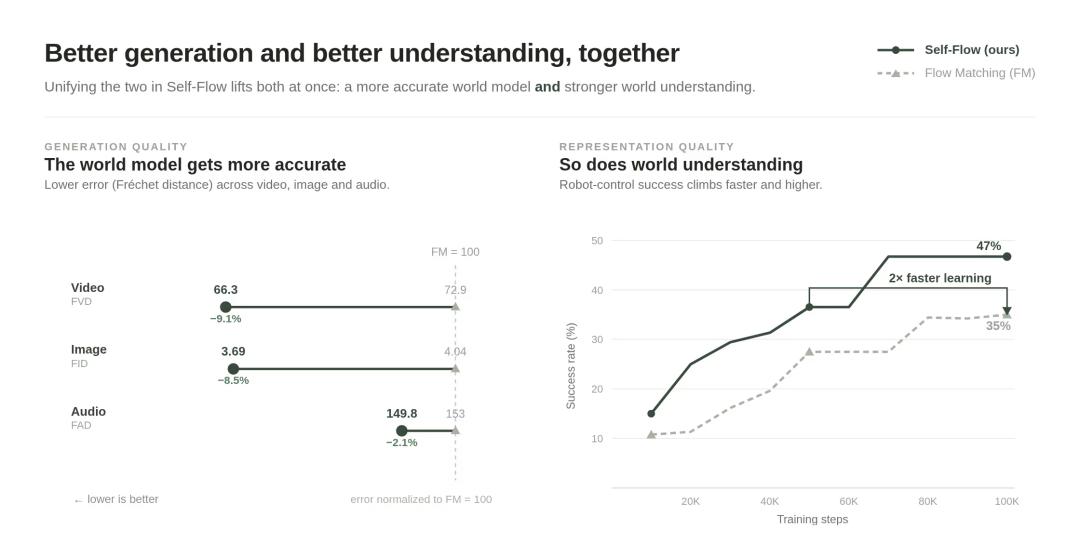
Self-Flow 与 Flow Matching(流匹配)的对比具有更好的生成和理解能力。左图是各模态的生成误差(Fréchet 距离),均以 FM = 100 归一化,越低越好。右图是通过微调在操控任务上的成功率,取4组任务的平均值,越高越好。
视频生成,带原生音频
FLUX 3 的视频能力相当全面。单次生成可以产出分辨率 720p 最长20秒、带音频的视频。
具体能力有:
文本生成视频。
图像生成视频,既可从起始帧延续生成,也可以图像作为视觉参考。
基于参考片段的视频生成视频,将源视频的核心元素(例如同一个角色)带入新的场景或情境。
基于输入视频和音频的生成式视频—音频延续。
关键帧生成视频,用于在既定时刻之间实现可控过渡。
多语言对话。
广泛的视觉风格与画面宽高比,远超传统电影化输出的范畴。
将独立片段自主串联为更长的多镜头序列。
极高的风格多样性——FLUX 3 可轻松驾驭从随性手持摄像素材到动画及电影质感的各类风格。
强大的字体生成与动态设计。
早期评估数据如下(10秒文本生成视频,720p,带音频):
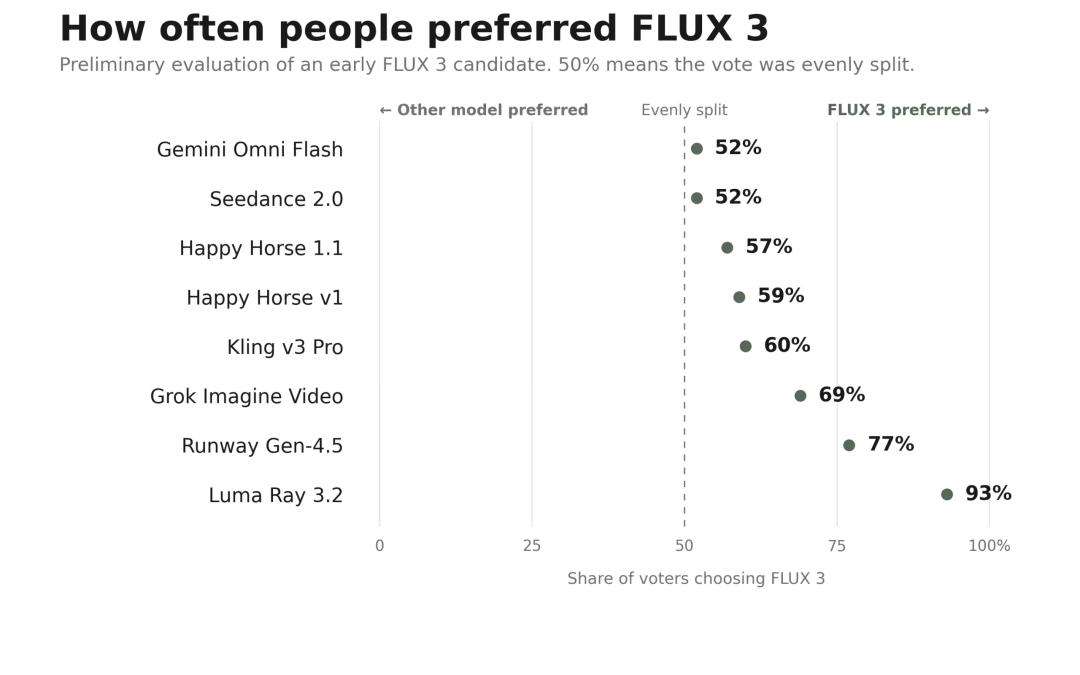
初步评估结果,与其他主流模型的对比中,FLUX 3 获得了压倒性的偏好优势。
与 Gemini Omni Flash 和 Seedance 2.0 对比,它获得了微弱的52%优势。
与 Happy Horse 两个版本、Kling v3 Pro 以及 Grok Imagine Video 的比拼中,偏好率更高,分别为57%、59%、60%和69%。
对阵 Runway Gen-4.5 达到了77%的显著领先。
与 Luma Ray 3.2 比较,实现了近乎压倒性的完胜,有高达93%的投票者选择倾向它。
团队强调,模型和配套工具仍在开发中,这些是初步结果,早期访问阶段还会继续改进。
目前 FLUX 3 特别突出的几个点是人脸表情捕捉,声音与物理事件的关联,多语言能力。这些能力可以组合使用,生成持续数分钟的序列,视觉参考确保角色在所有场景中保持一致。
图像与动作
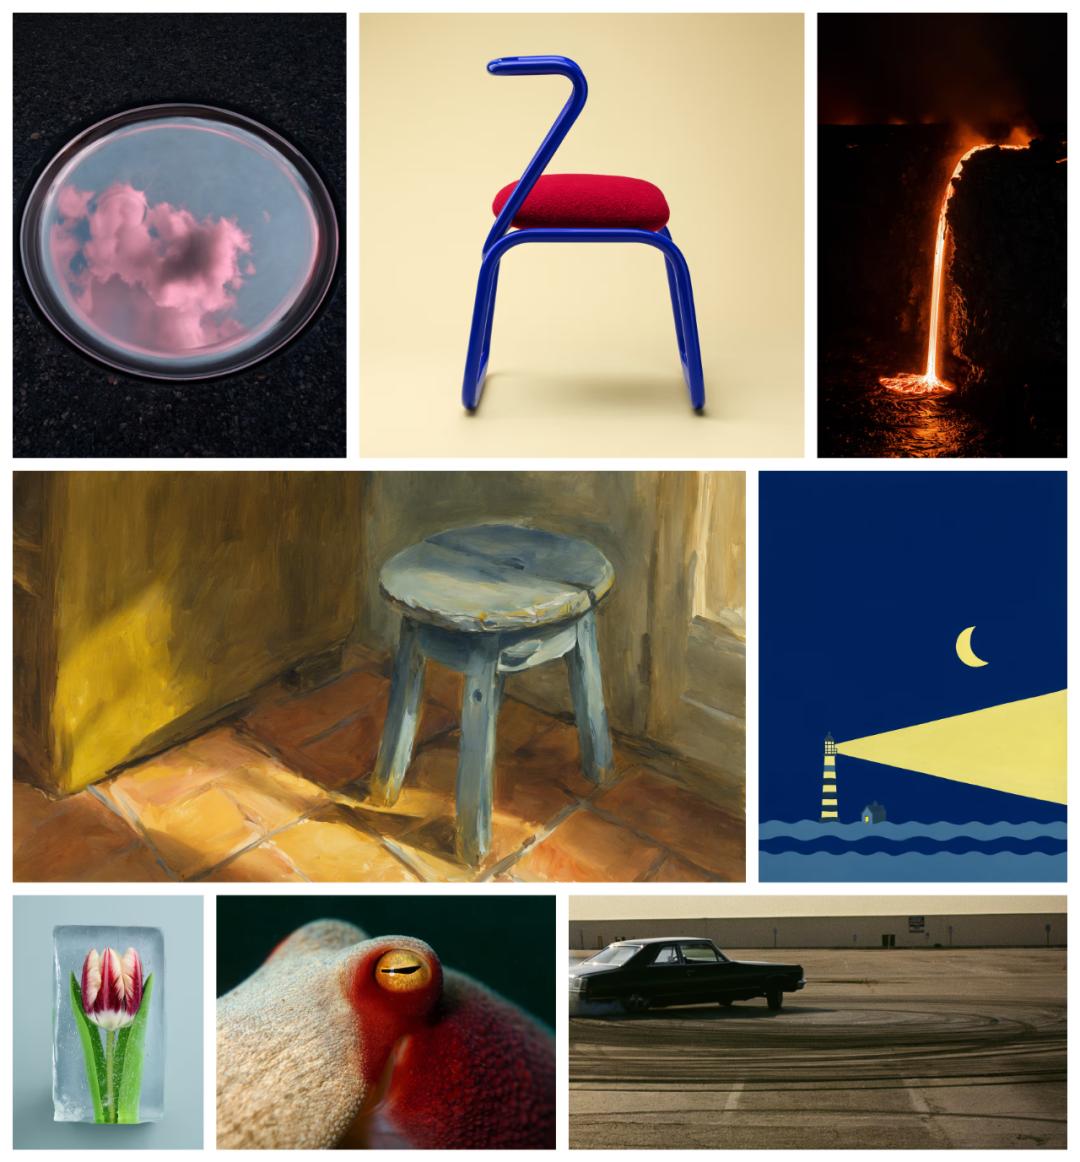
图像方面,FLUX 3 能合成和编辑多种风格、宽高比、分辨率的图像。
中期训练阶段的初步评估显示,相比早期 FLUX 版本,处理复杂提示词和文字生成的能力有明显提升。多语言文字渲染精度也上来了。
FLUX 3 的世界理解延伸到了动作预测。Black Forest Labs 把原生动作预测直接集成进 FLUX 3,扩展了 Self-Flow 的早期工作,将预训练的视频骨干网络当作理解动力学的基座,让专门的动作模型用少量任务数据微调即可。
mimic robotics( mimic 机器人公司)是首批获得 FLUX 3 早期访问权限的合作伙伴之一。双方联合开发了 FLUX-mimic,一个视频动作模型,把 FLUX 3 骨干网络跟 mimic 在灵巧操控和生产部署方面的机器人学习专长结合在一起。
生成令人信服的视觉内容,跟控制机器人,乍看毫无关系。一个要生成像素,一个要理解物理世界在你触碰和操控时如何响应。但一个模型同时做两件事,说明它从来就不只是一个内容创作模型。它是一个关于世界如何运作的模型,内容创作只是它能做的事情之一。
发布节奏与下一步
接下来几周和几个月,Black Forest Labs 会逐步开放以下能力,每项都经过早期访问阶段,确保平稳上线、收集反馈、做严格安全测试:
FLUX 3 Video,视频和音频的生成与编辑,通过 API 和私有权重访问。
FLUX-mimic 和 FLUX 3 Action,动作预测,通过选定的研究和商业合作伙伴开放。
FLUX 3 Image,图像合成与编辑,通过 API 和私有权重访问。
FLUX 3 Dev,用于内容创作(视频、音频、图像)和动作预测,将开源。
团队还会发布更多关于底层技术方法的细节。
Black Forest Labs 的目标是把感知、动作和语言预测统一到同一个模型里。从交互式图像和视频编辑,到仿真、计算机使用、物理 AI,他们认为前沿还很开阔。
下一代模型已经在研发中。
参考资料:
https://bfl.ai/blog/flux-3
https://bfl.ai/models/flux-3
https://bfl.ai/blog/flux-3-mimic