当AI“看图学习”时,它的眼睛里藏着什么秘密?
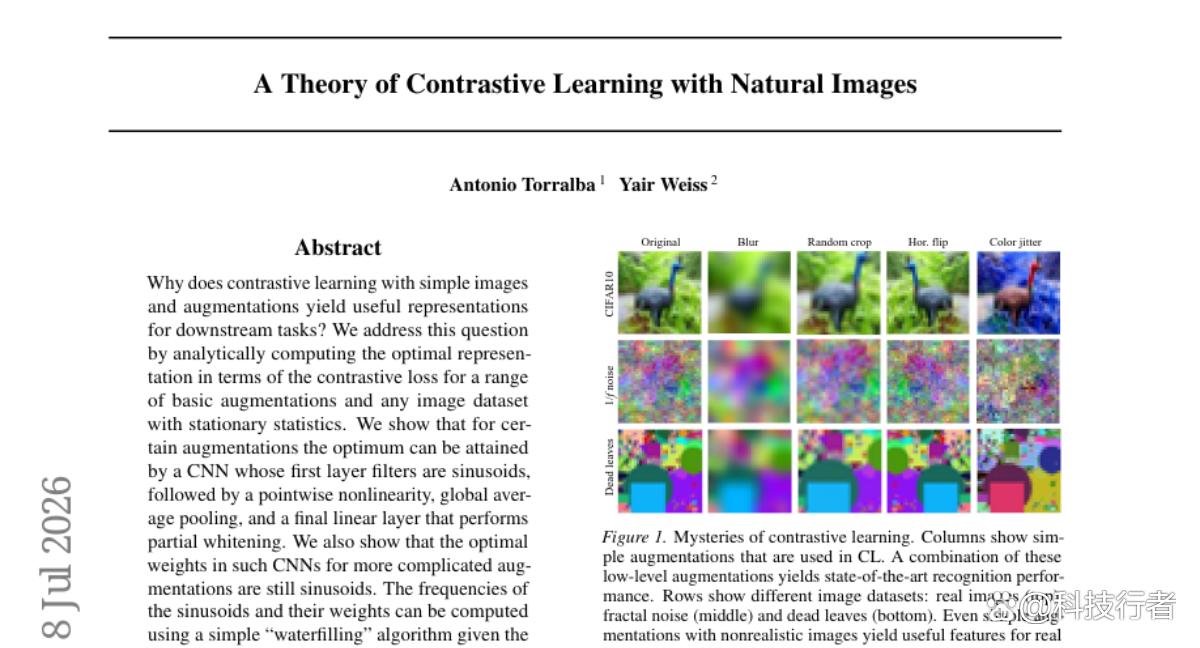
这项由麻省理工学院计算机科学与人工智能实验室(MIT CSAIL)和耶路撒冷希伯来大学计算机科学与工程学院联合开展的研究,发表于2026年第43届国际机器学习大会(ICML 2026),会议地点为韩国首尔,收录于PMLR第306卷。有兴趣深入了解的读者可以通过论文编号arXiv:2607.07470查询完整论文。
**一个让所有人都困惑的谜题**
手机里的人脸识别、购物网站的商品推荐、医院里的CT影像分析——这些技术的背后,都离不开一种叫做"图像表征学习"的核心能力。说白了,就是让计算机学会"看懂"图片。过去十年,研究者发现了一种叫做"对比学习"的训练方法,效果出人意料地好,甚至在不需要人工标注数据的情况下,就能让AI学会辨认猫狗、识别物体。
然而,这里藏着一个长期困扰研究者的谜题:这种方法所用的"训练素材"实在太简单、太基础了。研究者只是把一张图片随机裁剪一下、调暗一点、或者稍微模糊一下,然后告诉AI:这两张图是同一张图的不同版本,你要让它们在"理解层面"彼此接近。就这样,AI居然学会了区分不同物体。更离奇的是,哪怕用的不是真实照片,而是用数学公式随机生成的"噪点图"或"死叶子图"(一堆随机叠在一起的几何形状),AI学到的"理解能力"仍然可以用来识别真实世界中的图片。
这就好像一个从未见过真实街道的孩子,只靠反复拼凑一些颜色随机的积木,居然练出了在真实街道上认路的本领——这怎么可能?这项研究的起点,正是对这个"怎么可能"的追问。
**一、对比学习是怎么工作的,以及研究者发现了什么**
要理解这项研究,首先需要明白"对比学习"的基本逻辑。把它想象成一个"找茬游戏"的反向版本:不是让AI找出两张图的不同之处,而是让AI学会识别两张图的"本质相似性"。具体做法是:拿出一张原图,对它做两种随机变换,比如随机裁剪左半部分和右半部分,得到两张"兄弟图";同时,从数据集里随机拿出其他图片。训练的目标是:让AI把两张兄弟图的"理解结果"(也叫"表征")放得很近,同时把它们与其他随机图片的"理解结果"推得远远的。
研究者们使用的具体损失函数叫做InfoNCE,这个名字听起来很拗口,但本质上只是在量化"AI有多擅长在一堆图片里认出哪两张是同一张图的变体"。研究团队在分析这个损失函数时发现,当AI学到的"表征"近似服从高斯分布(也就是正态分布,那个经典的钟形曲线)时,这个复杂的损失函数可以被简化成一个更好分析的形式,他们称之为LGUPA——高斯均匀加对齐损失。经过实验验证,用这个简化版损失函数训练出来的AI,和用原版InfoNCE训练出来的效果几乎一模一样。这个简化是整个研究的基石,因为它让数学分析变得可行。
**二、自然图像有一个几乎被所有人忽视的规律**
在进入核心发现之前,需要先了解自然图像的一个基本规律,这个规律是整个理论的关键钥匙。
回想一下,当你用手机拍一张公园的照片,画面里的草地、树叶、天空都有各自的纹理,而这些纹理可以用"频率"来描述——细密的纹理对应"高频",大块的颜色区域对应"低频"。如果你把大量自然照片做一个数学分析(具体来说是"离散傅里叶变换",可以把图片分解成不同频率的成分),会发现一个惊人的规律:低频成分的"能量"(功率)总是远大于高频成分,而且这种衰减关系非常规律,大致遵循1/f的规律(f代表频率)。这不是巧合,而是自然界的普遍规律:远处的山、近处的草、头顶的云,大面积的颜色区域总是比细碎的纹理占据更多"能量"。
更重要的是,大量的自然图像数据集(包括CIFAR10、ImageNet)都满足"平稳性"这一数学性质。所谓平稳性,简单理解就是:图片左边两个像素之间的关系,和图片右边两个像素之间的关系,在统计意义上是一样的——图像的统计规律不随位置改变。这个性质带来了一个数学上的重大后果:当你对图像做傅里叶变换时,不同频率的系数之间是统计独立的,而且每个系数都近似服从高斯分布(就是那个钟形曲线)。研究团队用CIFAR10的5万张图片验证了这一点,结果与理论预测高度吻合。有趣的是,哪怕是用数学公式生成的分形噪点图,也满足同样的规律——这正是后来解释"为什么用噪点图训练也有效"的关键线索。
**三、最优的AI应该"做什么"——一个令人意外的答案**
有了上面两个基础,研究团队开始推导:对于自然图像数据集,什么样的图像表征在数学上是对比学习损失函数的最优解?
他们首先考虑一组相对简单的数据变换:循环裁剪(在周期性边界条件下随机平移图像)、线性亮度对比度调整、以及理想低通滤波(把高于某个频率的成分全部清除,模拟模糊效果)。这三种变换都在现实的对比学习中被广泛使用。
推导结果让人大吃一惊:在理论上,最优的图像表征不是任何复杂的深层特征,而是对图像做傅里叶变换之后,测量若干个特定频率的功率(即该频率成分的强度的平方),然后对这些测量值按照该频率在数据集中的平均功率进行反比例缩放(高功率频率缩小、低功率频率放大),最后归一化到单位球面上。
用一个更直观的比喻来理解:把图像看成一首由无数个音符组成的"视觉乐曲",傅里叶变换就是把这首曲子分解成各个音符。自然图像这首曲子里,低音(低频)总是比高音(高频)响得多。最优的表征方式是:从这些音符里挑出若干个来记录,但记录时要对原本响的音符"调低音量"、对原本轻的音符"调高音量",让所有被记录的音符响度均衡——这个操作有个正式名称叫"部分白化"(partial whitening)。
为什么这样做是最优的?因为对比学习需要同时实现两个目标:第一,同一张图的两个变体在表征空间里要靠近(对齐损失);第二,不同图片的表征要尽可能均匀分散,不能全部挤在一起(均匀性损失)。对于上述三种变换,傅里叶功率谱天生对这些变换不敏感(因为这三种变换都不会改变图像的功率谱),所以对齐损失自然为零。而"均匀性"的最优解,恰好就是让表征的协方差矩阵是单位矩阵——也就是每个方向的方差相等,这正是"白化"的含义。
**四、一个简单的神经网络架构就够了**
这个理论上的最优表征可以用一个极其简单的神经网络来实现,研究团队将其描述为:一层卷积滤波器(负责分解频率),接一个逐点非线性函数(平方函数或ReLU),再接全局平均池化,最后是一个线性投影层(负责白化)。
这里的卷积滤波器,理论上应该是正弦波形状的(数学上叫"正弦滤波器"),而正弦波恰好就是傅里叶变换的基础构件。换句话说,一个在自然图像上做对比学习的最优神经网络,其第一层滤波器应该长得像各种不同方向和频率的斑马纹或百叶窗——这正是正弦波在图像里的样子。
更关键的是,选择哪些频率、给每个频率赋予多大的权重,可以用一个叫"注水算法"(waterfilling)的方法来计算。这个算法的名字来源于信息论里的经典问题:假设你有一桶水要倒进一排高低不平的容器,水总是先填满最低的容器,再溢出到次低的——注水算法的逻辑与此类似,把有限的"表征容量"优先分配给能带来最大收益的频率分量。具体来说,算法会反复找出当前"性价比"最高的频率(即增加一点点功率分配能带来最大损失减少的频率),把资源分配给它,直到总预算用尽。由此得出的最优解通常是稀疏的:大多数频率分配到零功率(被忽略),只有一小部分频率得到非零分配——这意味着最优的投影矩阵是低秩的,AI学到的表征维度远小于图像的像素数量。
**五、更复杂的数据变换,结论依然成立**
研究团队随后把分析扩展到更复杂的场景:不再是干净的循环裁剪,而是循环裁剪加上随机噪声(更接近真实的随机裁剪),以及任意形状的模糊滤波器。
在这种情况下,一个简单的神经网络已经无法找到使对齐损失精确为零的表征(因为添加噪声意味着再精确的降噪也会有误差),但研究团队证明,对于这个简单的神经网络架构,最优的权重仍然是:第一层滤波器为正弦波,投影层执行部分白化。具体来说,不同频率的"重要性"(广义特征值)由以下几个因素共同决定:噪声强度(噪声越大的频率越难对齐,因此特征值越大,被选中的优先级越低)、模糊核对该频率的衰减程度(被模糊严重的频率也难以对齐)、以及该频率在数据集中的原始功率(功率越高的频率,其上的噪声在绝对量上也越大)。
对于含噪声的随机裁剪,每个频率k对应的广义特征值可以写成(16σ?g[k]+8σ?)/g?[k]的形式,其中σ是噪声标准差,g[k]是该频率的期望功率。这个公式揭示了一个微妙的平衡:低功率频率的特征值大(难以对齐,容易被忽略),高功率频率的特征值也相对较大(因为绝对噪声量大)。因此,被选中的频率往往是那些功率"适中"的中间频率——在图像的频率空间里,这些频率分布在一个"环"的形状上(对于分形噪声图像)或一个"菱形"的形状上(对于像CIFAR10这样的真实图像)。这正是"部分白化"在频率域的直观体现:AI学会了测量那些"信噪比最佳"的频率成分。
**六、实验结果:理论与现实高度吻合**
理论预测只是纸上谈兵,关键在于现实中的神经网络是否真的会学到这些东西。研究团队设计了一系列对照实验,用随机梯度下降(SGD,一种标准的神经网络训练方法)训练具有256个11×11滤波器的单层卷积网络,在六种合成数据集(不同功率谱的分形噪声和"死叶子"图像)以及三种真实数据集(CIFAR10、CIFAR100、ImageNet)上进行测试,并对比了平方非线性和ReLU两种激活函数。
结果与理论预测高度一致。无论是哪种数据集,无论是哪种激活函数,训练后的第一层滤波器都收敛为正弦波。更具体地说,网络的频率灵敏度(对各个频率的响应程度)与理论预测的注水算法结果在形状上非常吻合:1/f?数据集对应较小半径的"环",白噪声数据集对应较大半径的"环",CIFAR10对应"菱形"分布。网络的灵敏度乘以该频率的期望功率,结果近似为常数——这正是"部分白化"的数学特征,即灵敏度与功率的平方根成反比。
在颜色图像的实验中,结论同样成立。由于自然图像的红、绿、蓝三个颜色通道之间存在相关性,网络会先隐式地学习对颜色通道进行"去相关",把RGB转换成大约等效于"亮度、红绿色差、蓝黄色差"三个独立通道(这与人类视觉系统中颜色对抗细胞的发现不谋而合),然后在每个独立通道上学习各自的正弦滤波器。
研究团队还用CelebA人脸数据集测试了非平稳数据集(人脸图像在统计上是位置相关的——眼睛总在上方,嘴总在下方)。结果显示,即便在非平稳数据集上,由于全局平均池化的存在,网络仍然学到了正弦滤波器,因为全局平均池化使得网络无法利用位置信息。
**七、数据集类型对最终识别性能的影响**
研究团队还做了一个很有启发性的实验:用不同类型的图像数据集训练对比学习模型,然后测试在CIFAR10上的KNN识别准确率(K近邻分类——把测试图片的表征与训练图片的表征比较,用最相似的几张图片的类别来投票)。
结果清楚地显示了一个规律:用于训练的合成图像的功率谱越接近CIFAR10真实图像的功率谱,学到的表征在CIFAR10上的识别准确率就越高。具体数字如下:随机初始化权重(未训练)得到约33.5%的准确率,白噪声图像(功率谱均匀,与CIFAR10差异最大)得到约34.2%,1/f?噪声得到约35%,1/f?噪声得到约35.8%,1/f噪声(与自然图像功率谱最接近的分形噪声)得到约37.2%,"死叶子"图像得到约39.8%,CIFAR100(真实图像但类别不同)得到约45.1%,CIFAR10本身(同域训练)得到约45.1%。
这个梯度清楚地表明:对比学习本质上是在学习一种基于数据集功率谱的"频率测量方案",而这个方案的有用性取决于训练数据的频率分布与测试数据的频率分布的匹配程度。这也从根本上解释了为什么用分形噪声训练出来的模型可以在真实图像上取得不错的效果——因为分形噪声和自然图像都遵循类似的1/f功率谱规律。
**八、部分白化是"幕后功臣",而增强方式决定了细节**
研究团队还做了一个颇具说服力的对比:把对比学习训练出来的模型与一个纯粹的"线性部分白化"方法(对图像做PCA,然后按照特征值的平方根反比缩放,取前32个主成分)进行比较。
结果发现,对于大多数简单的数据增强方式(如随机裁剪、循环平移、对比度翻转、图像模糊),经过对比学习训练的CNN的识别准确率与线性部分白化几乎持平,有时候后者甚至略高。这意味着,对于这些简单的增强方式,对比学习的"贡献"主要在于引导网络去做部分白化,而不是学习任何更高层次的不变性。这与直觉不符——难道让AI反复练习"把同一张图的两个裁剪版本认成一个",最终学到的只是"调整频率响应的强弱"?答案基本上是肯定的。
不过,当使用SOTA(当前最优)增强方式——包括随机裁剪时同时随机化裁剪大小和纵横比、以及非线性颜色抖动——时,情况发生了变化。这种更复杂的增强方式迫使网络学习更加局部化(在空间上有局限性)的滤波器,而不仅仅是全局正弦波,从而捕捉了更多与局部纹理和物体边缘相关的特征。使用SOTA增强方式时,对比学习的准确率(约57.5%)显著高于线性部分白化(约46-47%),表明更复杂的增强方式确实引导网络学到了超越部分白化的、更有判别性的特征。
**九、关于解的非唯一性和梯度下降的隐含偏好**
研究团队还注意到一个理论上的微妙之处:最优表征在数学上并不唯一。对于简单增强方式,任意一组频率的功率谱测量加上白化都是最优的;将最优表征乘以任意一个正交矩阵(一种"旋转"变换),仍然得到最优表征。
在实验中,他们发现梯度下降(训练过程)会影响网络找到哪个具体的最优解。一个有趣的现象是:随着训练轮数(epoch)增加,网络倾向于学习越来越高频的正弦滤波器。在早期训练阶段(约100轮),网络已经学到了低频到中频的正弦波,此时CIFAR10的识别准确率达到峰值(约39%);随后继续训练,虽然损失函数还在下降,但识别准确率反而开始下滑,因为网络开始过度拟合噪声和高频细节。这提示我们:在对比学习中,"什么时候停止训练"也是一个值得关注的问题,而不仅仅是"损失是否还在下降"。
研究团队还从理论上证明了:当投影层的权重被固定为随机正交矩阵时,最优的第一层滤波器"只能"是正弦波,而不能是其他形状。这个定理(论文中的Theorem M.1)提供了一个更强的唯一性保证:在特定的权重固定条件下,正弦滤波器是达到最优解的唯一途径。
**十、局限性与未来方向**
研究团队对自己工作的局限性非常坦诚。这套理论分析只适用于非常简单的单层CNN架构,而现代对比学习实践(如DINOv2等)使用的是深层残差网络,理论结论能否直接迁移到深层网络尚不清楚。此外,理论分析中用到的LGUPA损失函数与InfoNCE的等价性严格来说只在表征服从高斯分布时成立,而深层网络的表征分布更为复杂,尽管有其他研究发现对比学习确实倾向于产生近似高斯的分布。
另一个值得继续探索的方向是:在非平稳数据集(如人脸图像)上,如果网络架构没有全局平均池化的限制,会学到什么?这可能需要将理论从平稳统计扩展到位置相关的统计,这是一个更困难的数学问题。此外,如何将注水算法的结论扩展到随机纵横比裁剪等更复杂的增强方式,也是留给未来研究的重要问题。
归根结底,这项研究最有价值的贡献在于:它给了我们一把钥匙,能够从数学上理解为什么对比学习有效,而不仅仅是观察到它有效。当你知道一个简单的1/f功率谱就能大致解释AI视觉表征的核心结构时,"视觉理解"这件事本身似乎也不再那么神秘——或许自然界的图像统计规律本身,就已经为如何高效表征视觉信息指明了方向。这不是说深度学习没有价值,而是说:好的理论能够帮助我们更明智地设计和使用工具,而不是在黑盒子面前茫然地调参数。
---
Q&A
Q1:对比学习为什么用噪点图训练也能提升真实图片的识别能力?
A:因为分形噪点图(如1/f噪声)的功率谱规律与自然图像非常相似,都遵循低频能量高、高频能量低的1/f衰减规律。对比学习本质上是在学习基于功率谱的"频率测量方案",只要训练数据的功率谱接近测试数据,学到的表征就能迁移。用功率谱差异更大的白噪声训练,效果就明显更差,这一点在实验数据中得到了清楚的验证。
Q2:对比学习训练出来的神经网络第一层滤波器为什么是正弦波形状?
A:因为对于满足平稳性的图像数据集,傅里叶变换的各频率系数之间统计独立,而正弦波恰好就是傅里叶变换的基本构件。理论推导表明,要同时最小化对齐损失和均匀性损失,最优的滤波器必须能够分别测量各个独立频率的功率,而能做到这一点的滤波器正是各种方向和频率的正弦波。实验结果与这一理论预测高度一致。
Q3:部分白化在图像识别中具体起什么作用,为什么它这么重要?
A:部分白化是指把图像中各个频率成分的响应强度调整到大致相等的水平——原本能量强的低频成分被"调低音量",原本能量弱的中高频成分被"调高音量"。这样做的好处是消除了冗余信息(低频成分本来就强,不需要过度强调),同时保留了真正有判别性的中频信息,并对噪声有一定的鲁棒性。实验表明,对比学习在简单增强下的主要贡献几乎等同于部分白化,说明这是AI视觉表征的一个基础性有效操作。