金融大模型新范式:告别“单打独斗”,用一个基础模型读懂1亿客户的“多模态人生”
“A Foundation Model for Multimodal Event Sequences in Financial Applications”
想象一下,你是一家服务超过1亿用户的大型银行。每天,海量的数据如潮水般涌来:客户在ATM机上的取款、在手机App上的点击、与客服的聊天记录、收到的营销短信……这些来自不同渠道、不同格式的数据,传统上被切割成无数个孤立的“表格”,送往不同的模型去完成“反欺诈”、“推荐理财”、“预测流失”等特定任务。这种“单打独斗”的模式,不仅导致开发工作的重复与低效,更让模型之间无法共享从数据中挖掘出的洞察,造成了宝贵信息的巨大浪费。
来自东欧最大银行Sber的科研团队,在近期发表的论文中,提出了一种全新的解决方案:一个能读懂用户“多模态人生”的金融基础模型。该模型的核心思想,是将用户所有行为——无论是转账、贷款申请,还是浏览App页面、接听客服电话——都视为一条统一的、时间线上的“事件序列”。通过一个强大的Transformer架构,模型在无监督状态下自我学习,目标只有一个:预测用户的下一个行为。
这个看似简单的“猜谜”游戏,迫使模型去捕捉隐藏在杂乱数据背后,人类专家也难以察觉的复杂行为模式。它不再需要为每个任务单独设计特征,而是将所有金融和非金融信号“早期融合”,构建一个通用的、深刻的用户画像。这个画像,就像一个“数字孪生”,可以被银行内部所有业务部门免费调用。
在Sber的实践中,这个基础模型被证明是一个强大的“粘合剂”。它能够与银行已有的、经过多年打磨的工程化特征完美结合,在四个关键业务任务上,平均预测准确率(ROC AUC)提升了0.009。更重要的是,在一个涉及数个核心产品、为期两个月的在线A/B测试中,该模型为客户沟通策略带来的净现值(NPV)提升了1%。这看似微小的数字,在服务亿级用户的系统上,转化为了巨大的商业价值增量。
这篇论文不仅展示了人工智能在金融领域的最新突破,更预示着一个新的时代:从“烟囱式”的模型开发,迈向“基础模型+轻量应用”的工业化生产范式。它意味着,金融科技的未来,不在于构建更多更复杂的模型,而在于打造一个能深刻理解用户的、统一的“智能底座”。
【 扫描文末二维码加入星球获取论文 】
摘要
预测建模是现代金融服务的核心组成部分。传统上,金融领域的各种任务(如风险评估、欺诈检测、产品推荐和客户分析)都依赖于针对特定任务训练的独立模型,这些模型基于人工构建的表格特征。这种“任务特定”的方法限制了模型的重用性,并且难以充分利用交易历史和数字交互信号等异构数据源。
本文提出了一种基于在用户多模态事件序列上预训练Transformer基础模型的方法。来自多个数据源的事件被统一到一个单一的、按时间顺序排列的序列中,从而实现了异构模态的早期融合,并通过“下一事件预测”目标学习通用表示。这些表示与现有的工程化用户特征相结合,在其之上训练轻量级的神经网络模型以完成多个下游任务。所提出的系统在降低开发开销的同时,超越了传统的任务特定模型。该方法已在东欧最大的银行之一投入生产,带来了可衡量的业务指标提升。
简介
在大型金融机构中,机器学习广泛应用于各种预测任务,如风险、欺诈、推荐和客户分析。传统上,这些任务通过为每个用例构建独立模型来解决,这些模型基于从用户交易历史和数字交互数据中手动提取的特征。尽管这种方法在特定应用中表现良好,但它导致了大量的重复工作,限制了学习表示的重用性,并随着预测任务数量的增加而增加了系统复杂性。
该范式的一个关键局限性在于无法充分利用现有数据的规模和丰富性。用户行为记录在多个异构来源中,包括金融交易、在线交互、通信和其他行为信号,每种信号都具有不同的结构和时间动态。大型金融机构在很长的时间跨度内收集了海量的事件级数据。将这些多模态事件流转换为特定任务的表格特征需要大量人工工作,并且常常导致信息丢失。因此,只有一小部分可用数据被有效利用,而为一个任务学习到的见解很难转移到其他任务或跨任务重用。
为了解决这些挑战,本文探索了一种基于在用户事件序列上预训练Transformer基础模型的方法。该模型以自监督方式训练,从大规模异构数据中学习通用表示,这些表示可被多个下游任务重用。来自不同数据源的事件被统一到一个单一的按时间顺序排列的序列中,实现了多模态信号的早期融合,模型使用“下一事件预测”目标进行预训练。预训练模型作为共享的表示骨干:其嵌入被冻结,并与现有的工程化用户特征结合,在此基础上为各个应用训练轻量级的、特定任务的表格神经网络模型。
该方法在Sber(东欧最大的银行之一,服务超过1亿客户)的多个真实金融预测任务上进行了评估。实验表明,自监督预训练和多数据模态的使用相比于传统任务特定模型,持续提升了预测性能。文章还分析了不同融合策略的影响,并在工业推理约束下研究了模型规模和序列长度的扩展行为。该系统已部署到生产环境中,在减少模型开发时间和整体系统复杂性的同时,带来了可衡量的业务指标改进。
相关工作
用户行为建模和推荐系统的基础模型
近期一些工业界的工作探索了用于用户行为建模的预训练Transformer模型。例如,Pinnerformer 和 TransAct 在Pinterest上使用Transformer学习用户表示。PinFM 明确采用了基础模型范式,在跨多个应用的用户活动序列上预训练模型,下游模型通过微调重用预训练组件。ARGUS 研究了自回归预训练Transformer在推荐系统中的可扩展性。DV365 专注于将极长的用户历史编码为紧凑的用户嵌入,这些嵌入被共享给大量下游模型。2025年的RecSys挑战赛也聚焦于通用行为建模,出现了多种解决方案,如使用对比学习的Transformer、基于下一事件预测的模型以及序列自编码器。
金融应用中交易序列的表示学习
自回归预训练和对比学习是交易数据表示学习中最常用的方法。早期工作如CoLES使用对比学习,NPPR使用自回归预训练,都基于RNN。近期工作如TREASURE和nuFormer则应用Transformer进行自回归预训练。nuFormer 引入了将每个交易表示为多个token的机制,并提出了端到端微调方法,将学习到的用户嵌入与现有表格特征结合。此外,还有工作探索使用大型语言模型处理交易数据。
总结来说,现有工作展示了预训练序列模型在用户行为建模和金融应用中的有效性,但要么聚焦于非金融用户交互数据,要么孤立地建模交易序列。本文的工作则针对大规模金融系统的实际场景,其中数据是内在多模态的。
问题建模
本文考虑从大规模、异构的行为数据中学习通用用户表示的问题。用户行为通过多个数据源记录,每个数据源捕捉用户活动的不同方面。对于用户 u,每个模态 m 产生一个事件的时间序列:
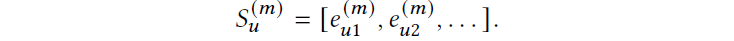
不同模态的事件在结构和属性上是异构的,但共享一个公共的时间线。关键挑战是将这些异构序列集成到一个统一的表示中。现有方法要么依赖晚期融合(每个模态独立建模),要么依赖早期融合(将所有模态的事件合并到一个序列中)。除了原始事件序列,生产系统还依赖丰富的工程化用户特征 f_u ∈ R^K,这些特征编码了领域知识,具有很强的预测价值。因此,一个实用的解决方案应该补充而不是取代它们。
学习到的表示应适用于多种下游业务任务,而无需针对特定任务进行调整。目标可以概括为学习一个通用的用户嵌入函数 Φ_core,使得:
嵌入向量 z_u 捕捉所有模态中的行为模式和时间动态。
该嵌入是任务无关的,可以跨多个下游目标重用。
预训练后,Φ_core 可以被冻结,从而允许下游模型在 (z_u, f_u) 上高效训练,而无需对核心模型进行微调。
方法
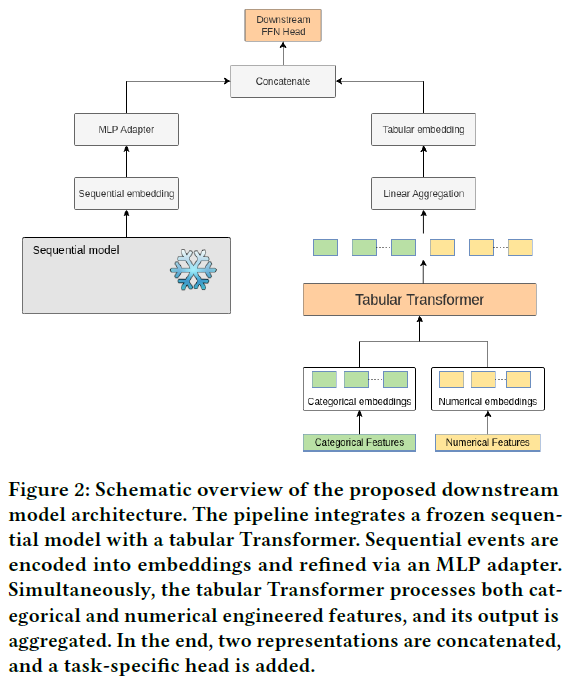
本文采用早期融合策略,以更好地捕捉跨模态的用户行为交互。所有可用数据源的事件被合并到一个单一的时间序列中,并在此序列上使用下一事件预测目标预训练一个基于Transformer的序列编码器。这个预训练编码器作为共享的表示骨干,其参数被冻结并在所有下游任务中重用,无需微调。对于下游应用,序列嵌入 z_u 与现有的工程化特征 f_u 结合。f_u 由一个独立的基于Transformer的表格模型(TabNN)处理,其输出嵌入与序列嵌入拼接,然后通过一个轻量级的MLP头进行最终预测。
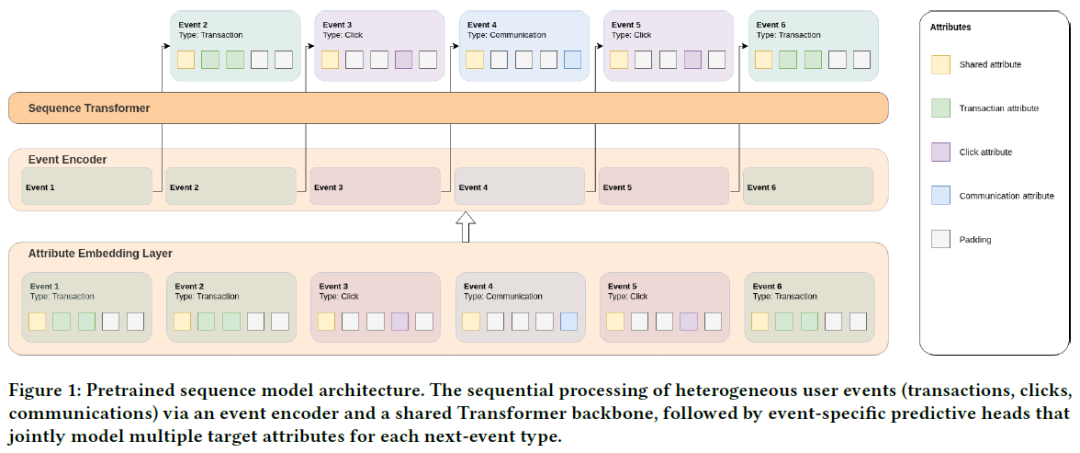
预训练序列编码器
采用三级架构:嵌入层、事件编码器和Transformer骨干网。
嵌入层:将数值和分类属性映射到公共嵌入维度。对于数值属性,先进行z-score归一化 𝑥˜_num=(x_num-𝜇_num)/𝜎_num,然后通过线性变换 a_num = w_num * 𝑥˜_num + b_num 投影到d维空间。分类属性则使用可学习的嵌入表。
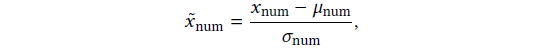
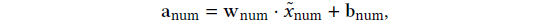
事件编码器(异构属性融合):处理不同事件类型具有不同属性集的问题。首先,将每个事件的属性嵌入填充(padding)到固定的属性维度 N_attr,形成矩阵 A_e=[a_1, a_2 ..., a_{N_attr}] ∈ R^ {N_attr * d},缺失属性被掩码。然后,沿属性维度应用自注意力(Intra-event self-attention),以捕捉属性间的依赖关系。最后,通过平均池化(考虑掩码 m_i)和LayerNorm将精炼的属性表示聚合为单个事件级嵌入 e。所有事件嵌入连接成序列 X = [e_1, e_2, ..., e_T] ∈ R^ {T * d}。
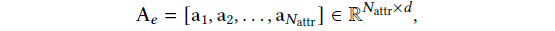
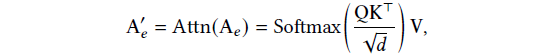
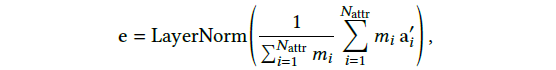
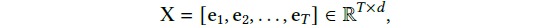
Transformer骨干网:采用类似GPT-2的因果Transformer架构,包含掩码多头自注意力和前馈层。最终的用户表示 z_seq 通过对时间维度进行平均池化得到。
预训练目标(下一事件预测):给定时间步t的隐藏状态 h_t,预测下一个事件(t+1)的属性。对于分类属性,使用线性投影和Softmax得到概率分布 ˆp^(𝑐 )_𝑡+1。对于数值属性,使用线性投影得到标量预测 ˆ𝑦^(𝑛)_𝑡+1
。损失函数为分类属性的交叉熵损失和数值属性的均方误差损失之和,只计算下一个事件实际存在的属性:
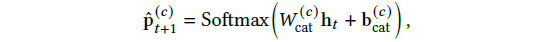
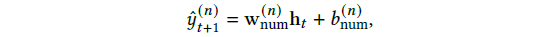
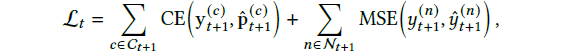
表格模型(TabNN)
使用基于Transformer的神经网络处理工程化用户特征,产生表格嵌入 z_tab。
输入预处理:数值特征先进行对数变换 x' = sign(x) * log(1 + |x|),然后标准化 𝑥˜ = (x' - 𝜇)/(𝜎 +𝜀)。
嵌入层:每个数值特征关联一个可训练向量 w^j_num,缩放后作为嵌入 e^j_num = w^j_num * 𝑥˜^j。分类特征使用可学习的嵌入表。
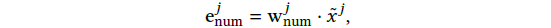
拼接与噪声注入:所有特征嵌入拼接成序列 E_concat,并在训练中注入随机噪声以增强鲁棒性。
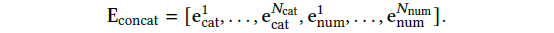
Transformer处理:序列被Transformer编码器处理,学习特征间的交互。
加权聚合:最终Transformer层的特征表示 H 通过带可学习权重的加权和 𝜶 聚合为单一向量 z_tab。
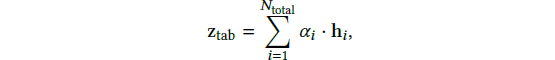
下游管道
最终用户表示通过结合序列和表格模型的嵌入获得。序列嵌入 z_seq 先通过一个轻量级MLP适配器(包含线性层、LayerNorm、SeLU激活函数和Dropout)调整维度,得到 z'_seq。然后将其与表格嵌入 z_tab 拼接:z_u = [z'_seq, z_tab]。最后,z_u 被送入一个任务特定的头部(如线性层或MLP)进行最终预测:𝑦ˆ = Head_task(z_u)。在训练下游任务时,预训练的序列编码器被冻结,只训练TabNN、MLP适配器和任务头的参数。
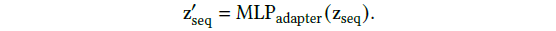
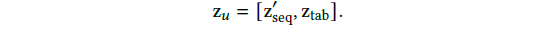
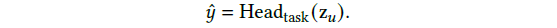
设计选择
预训练目标:选择下一事件预测,因其在从行为序列学习可迁移表示方面效果显著,并通过实验验证优于CoLES、掩码语言建模和DeTPP等替代目标。
表格模型架构:通过大量专有数据集评估,所选架构优于标准前馈神经网络、DCNv2和TabM等模型,与FT-Transformer类似但激活函数和归一化顺序不同。
离线实验
实验设置
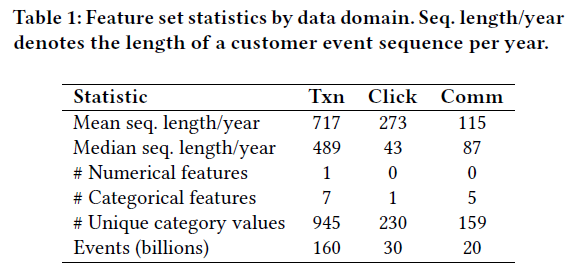
数据集:使用三种行为数据模态进行预训练:交易(Txn)(平均每年717个事件)、点击流(Click)(平均每年273个事件)、通信(Comm)(平均每年115个事件)。所有数据覆盖2年,总事件数分别为1600亿、300亿和200亿。此外,还使用生产系统中已有的工程化表格特征。
任务与评估:四个下游二分类任务(Task 1-4),预测客户对特定银行产品的通信响应,使用ROC AUC评估。
预训练模型配置:三种规模:2M(小,6层,上下文256)、8M(中,8层,上下文1024)、42M(大,12层,上下文2048)。
预训练设置:批量大小32,梯度累积16步,Dropout 0.15,AdamW优化器(学习率 10^-3,权重衰减 10^-2),余弦学习率调度,10,000步预热,训练2-10个epoch。
下游训练设置:批量大小4096,嵌入维度64,3层Transformer,4个注意力头,学习率0.004,40个epoch。
与基于特征的基线比较
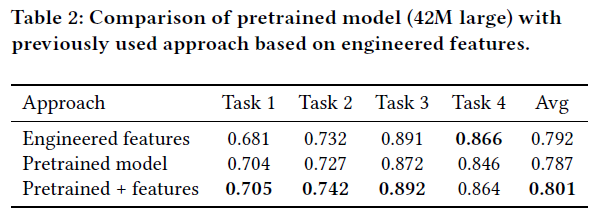
将仅使用工程化特征、仅使用42M预训练模型嵌入、以及两者结合的方法进行比较。结果如表2所示,仅使用预训练嵌入时,性能有时优于、有时劣于工程化特征。但两者的结合在所有任务上始终优于特征基线,平均ROC AUC提升0.009。
扩展性分析
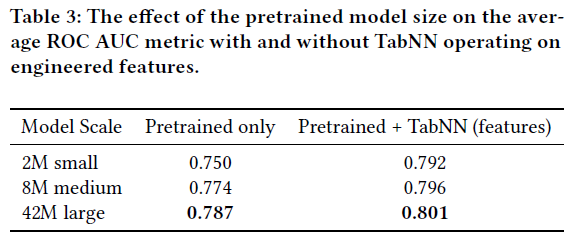
模型容量扩展:比较2M、8M和42M模型。如表3所示,更大模型取得更高AUC,与TabNN结合后均有提升。在结合设定下,从2M到42M,平均AUC从0.792提升到0.801。42M在性能和运营成本之间取得了平衡。
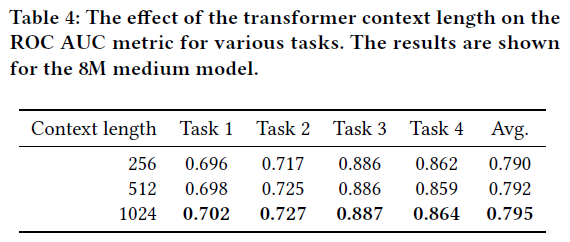
上下文长度扩展:使用8M模型,将最大序列长度从256增加到1024个事件。如表4所示,更长的历史记录持续改善所有任务的AUC,平均AUC从0.790提升到0.795。
预训练的影响
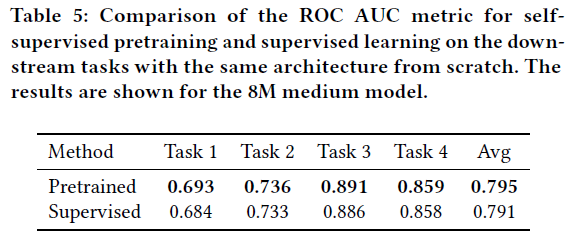
将自监督预训练方法与相同架构的端到端监督学习进行比较。如表5所示,自监督预训练在所有四个下游任务上持续优于监督训练,平均ROC AUC提升0.004。
多行为模态的贡献
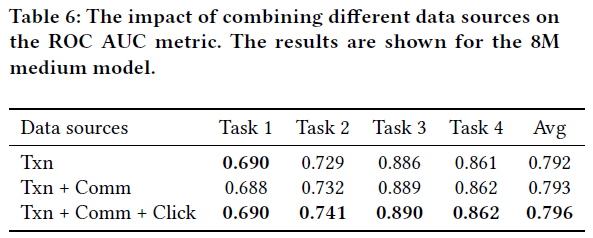
以仅交易(Txn-only)模型为基线,逐步添加通信(Comm)和点击流(Click)数据。如表6所示,多模态模型匹配或优于仅交易基线,在Task 2上提升最显著(超过0.01 AUC),平均AUC从0.792提升到0.796。
融合策略比较
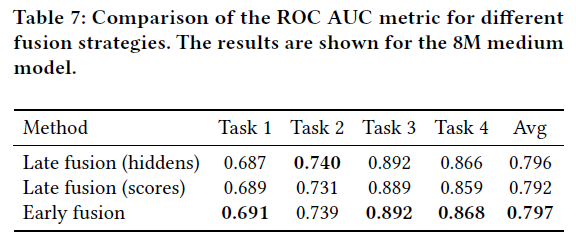
比较早期融合与两种晚期融合变体(拼接隐藏层、拼接分数)。如表7所示,早期融合在三个任务上取得最高AUC,平均AUC为0.797,优于晚期融合方法。
在线测试
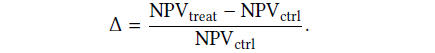
在核心银行产品的A/B测试中进行了评估,渠道包括推送通知、短信和电话营销。目标在线指标为净现值(NPV),报告处理组相对于对照组的相对提升 Δ。对照组的模型为生产中的梯度提升决策树(GBDT)。处理组使用本文提出的架构(42M预训练模型+TabNN),所有其他业务规则和约束保持不变。约10%的客户被随机分配到处理组,实验持续2个月。结果,处理组在所有产品和渠道上,总NPV相对于GBDT基线平均实现了+1%的提升。该提升在统计上显著,对应于系统规模下可观的绝对收入增长。A/B测试成功后,该方案已作为默认评分模型投产。
总结
本文介绍了一个针对多模态行为数据的基础模型,它联合利用了交易历史、点击流信号和通信事件。该方法基于在统一事件序列上预训练Transformer序列编码器,并将其作为冻结的共享表示骨干,用于多个下游任务。广泛的离线实验证明了该方法的有效性。该系统已成功部署到生产环境,并通过在线A/B测试验证,带来了可衡量的业务指标提升,确认了基础模型在大规模金融应用中的实用价值。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
