字节发布 UniVR|模型不看文本也能学会“打结叠衣”?
我们似乎一直被困在一个循环里:让AI看世界,却逼它用语言思考世界。
这就像一个画家被要求用说明书来描述如何画出一幅杰作。当前的顶尖模型,比如Gemini 3 Pro或GPT-5,即便拥有强大的文本推理能力,当它们试图通过文本链条去指导图像生成器完成“系鞋带”或“叠衣服”这种任务时,还是常常翻车。因为文字根本无法捕捉物体间细微的摩擦力、衣物的柔性形变或者动态过程中的空间逻辑。
而今天我们要深挖的这篇技术报告,提出了一个有点“反骨”的思路——UniVR。它背后的团队认为,既然视觉是最直接的物理世界载体,那为什么不直接让AI在视觉空间里进行推理和规划呢?这不仅仅是换了个“思考场所”,更是试图绕开语言这条“抽象中介”,去触碰更底层的世界模型。
核心痛点:当“最强大脑”遇上“物理世界”
我们先来看一张图。
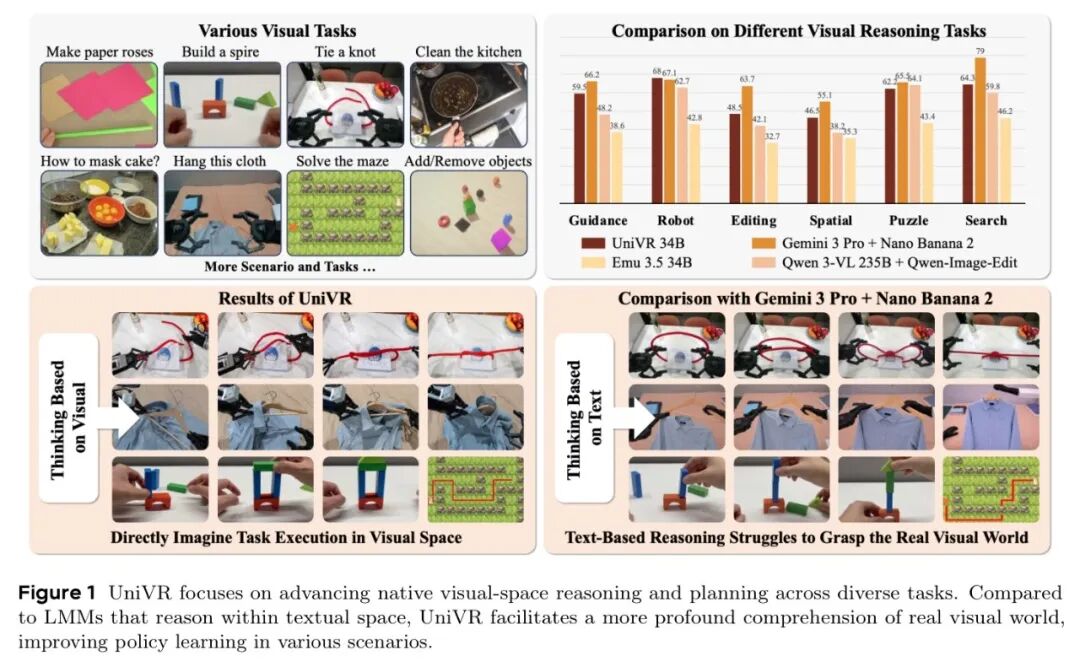
这张图的信息量不小。左上角展示了各种复杂的视觉任务,从手工折纸到厨房清洁,都是真实世界的挑战。但真正有意思的是下半部分。
大家注意左下角,这是UniVR的推理方式。它在看到“将绿色球引向红色目标”的迷宫图时,直接在视觉空间里“想象”出了球的运行轨迹——没有中间文本,输入输出全是图像。而右下角呢?那是目前主流的“文本中介流”做法(Gemini 3 Pro + Nano Banana 2)。文字给出了指令,但生成的图片序列却让球穿墙而过了。
这揭示了一个残酷的现状:语言模型再强,也是物理世界的“局外人”。文本描述无法穷尽物理细节,就像你无法用语言让一个从没喝过咖啡的人精准复现拉花手法一样。UniVR想要解决的,正是如何在无文本标注的情况下,直接从原始视觉数据中学习到复杂的推理能力和物理规律。
为了验证这个目标,作者没有用现成的、偏向娱乐生成的基准,而是自己撸起袖子造了一个——VR-X。
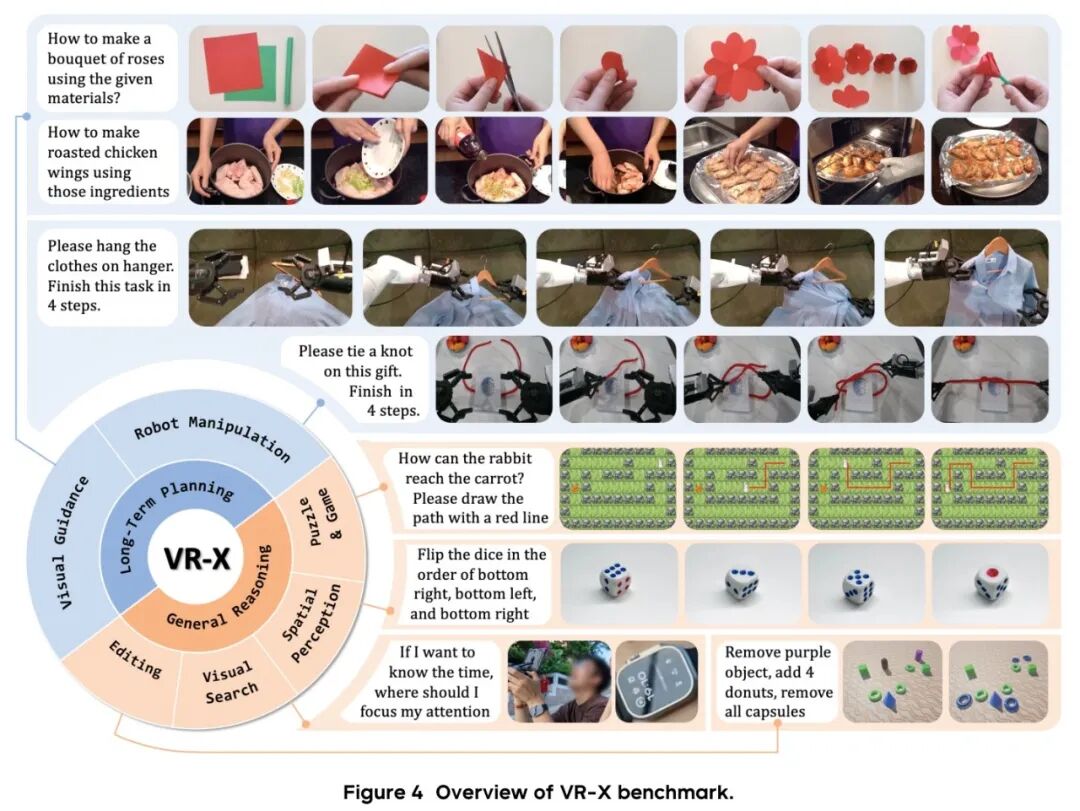
VR-X里塞满了各种“反常识”的任务。它不仅有传统的机器人操作,还涵盖了对空间感知要求极高的拼图、视觉搜索甚至迷宫。它的核心评估点在于逻辑连贯性和物理一致性,而不是简单的“画面像不像”。这意味着,模型在这里没法靠记住几张纹理蒙混过关,它必须真的“懂”空间和因果。
原理拆解:把视觉空间变成“思维沙盘”
UniVR究竟是怎么做到在视觉世界里直接“开悟”的?这就要拆解它的核心架构和那个精妙的训练方法——VR-GRPO。
🏗️ 整体架构:一切皆为Token的预测
先来看一下UniVR的整体框架。
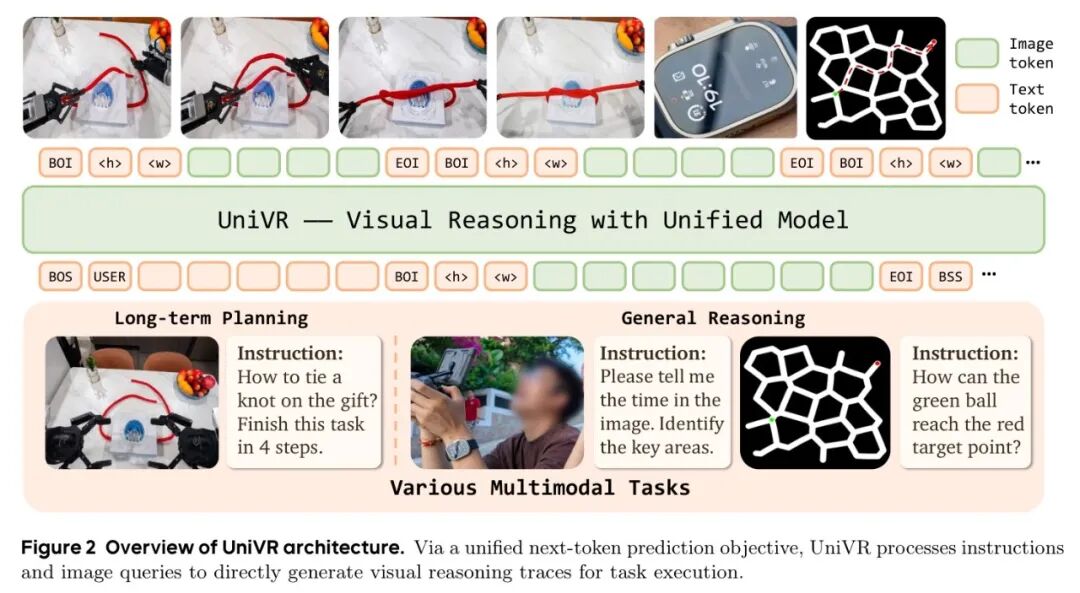
从图2可以看到,UniVR本质上是一个自回归生成模型。它把图像和文本都看成离散的Token。当收到一张任务起始图片(比如一块包装布和一个礼盒)和一句“如何包装礼物”的指令时,它不会去写小作文,而是直接开始“画”出后续的步骤帧。
这种“图像进,图像出”的设计,让模型被迫去学习状态转移和底层策略,而不是把视觉信息当作文本转述的附属品。这里面有一个很取巧的基础:它基于Emu3.5这类统一生成模型作为底座。但底座的问题是,虽然很会画画,但在复杂的物理逻辑上像个新手。
💡 冷启动:先学会“看图模仿”
要想让模型直接从纯视觉里学会推理,不能一上来就搞高难度的强化学习,容易“学废了”。所以,UniVR先做了一个冷启动(Cold Start)。
这里的关键,在于数据。
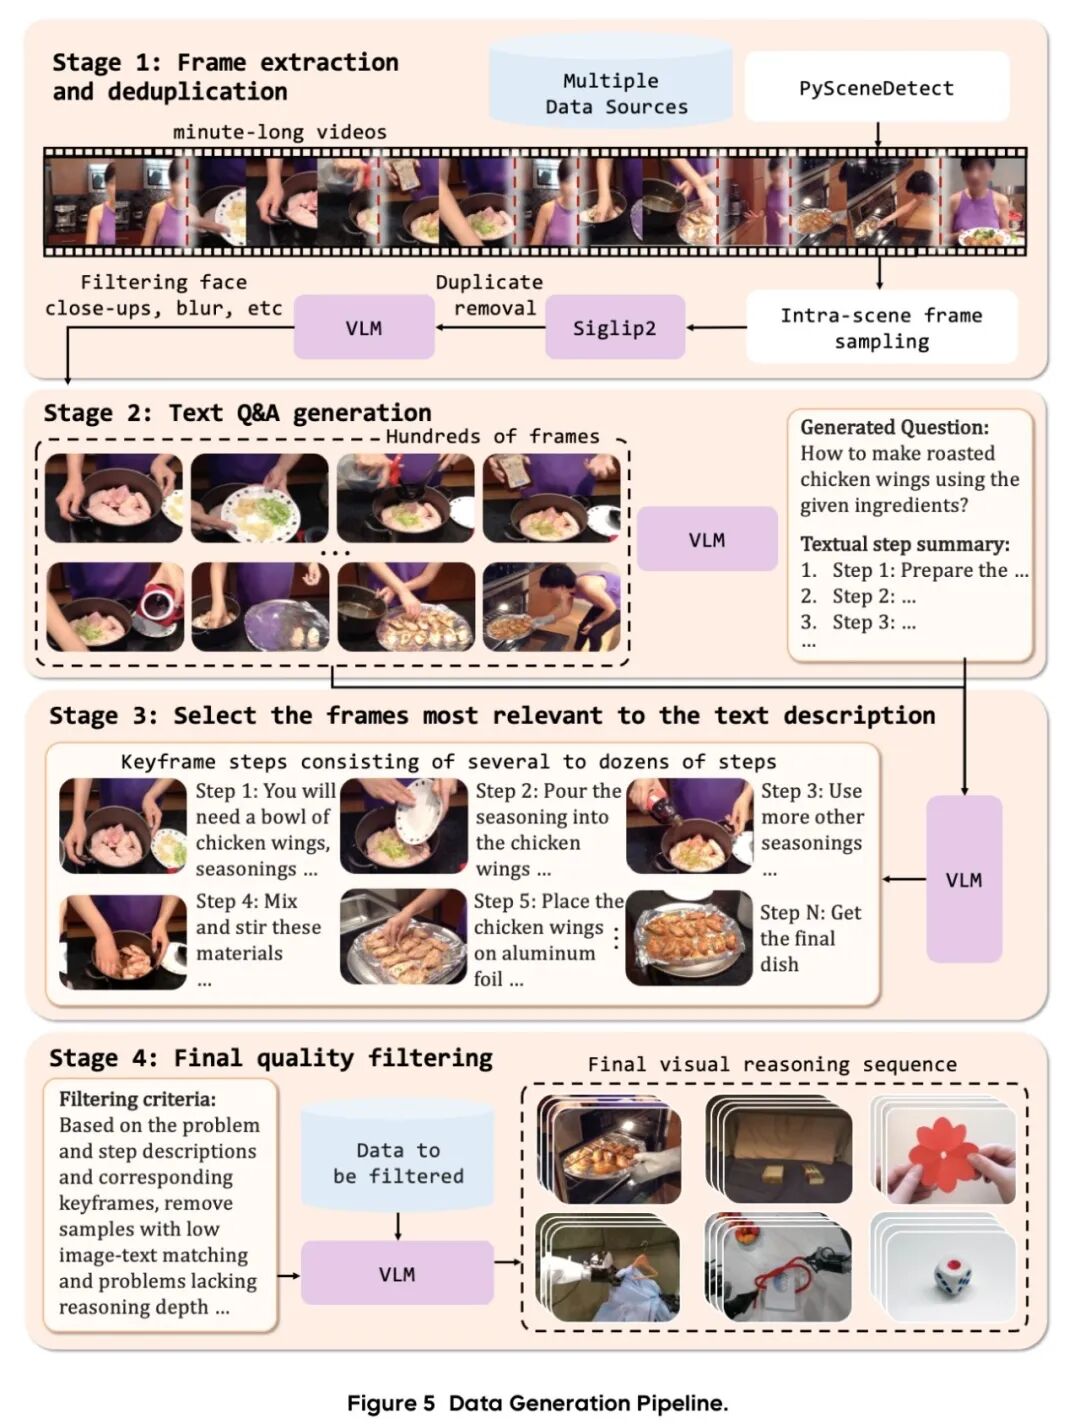
看图5这个数据生成流水线。团队从海量视频里提取帧,经过严格地去重、质量过滤和关键帧筛选,最终整理出了31万条高质量轨迹。这个流程最狠的一步是过滤掉了近80%的候选数据,只留下那些具有明确推理逻辑的序列。
这就像是先给了模型一套“世界名画任务集”,让它通过海量的视觉序列模仿,初步感知“如果这样做,下一步画面会发生什么”。但模仿只能做到形似,要想真正神似,还得有后手。
💡 VR-GRPO:请来一位严苛的“视觉教练”
这是UniVR最硬核的部分,也是它区别于以往所有视觉生成模型的地方。
通常我们训练这种模型,会让一个评估器(VLM)给输出的序列打个分:任务完成没?画面好看不?但问题来了——只看结果不看过程,就是在鼓励作弊。
作者发现,很多长时序任务里,模型会为了拿高分,生成一个结果看起来对的序列,但中间步骤混乱不堪(比如衣架穿模、红酒乱洒)。这被称为奖励黑客(Reward Hacking)。为什么呢?
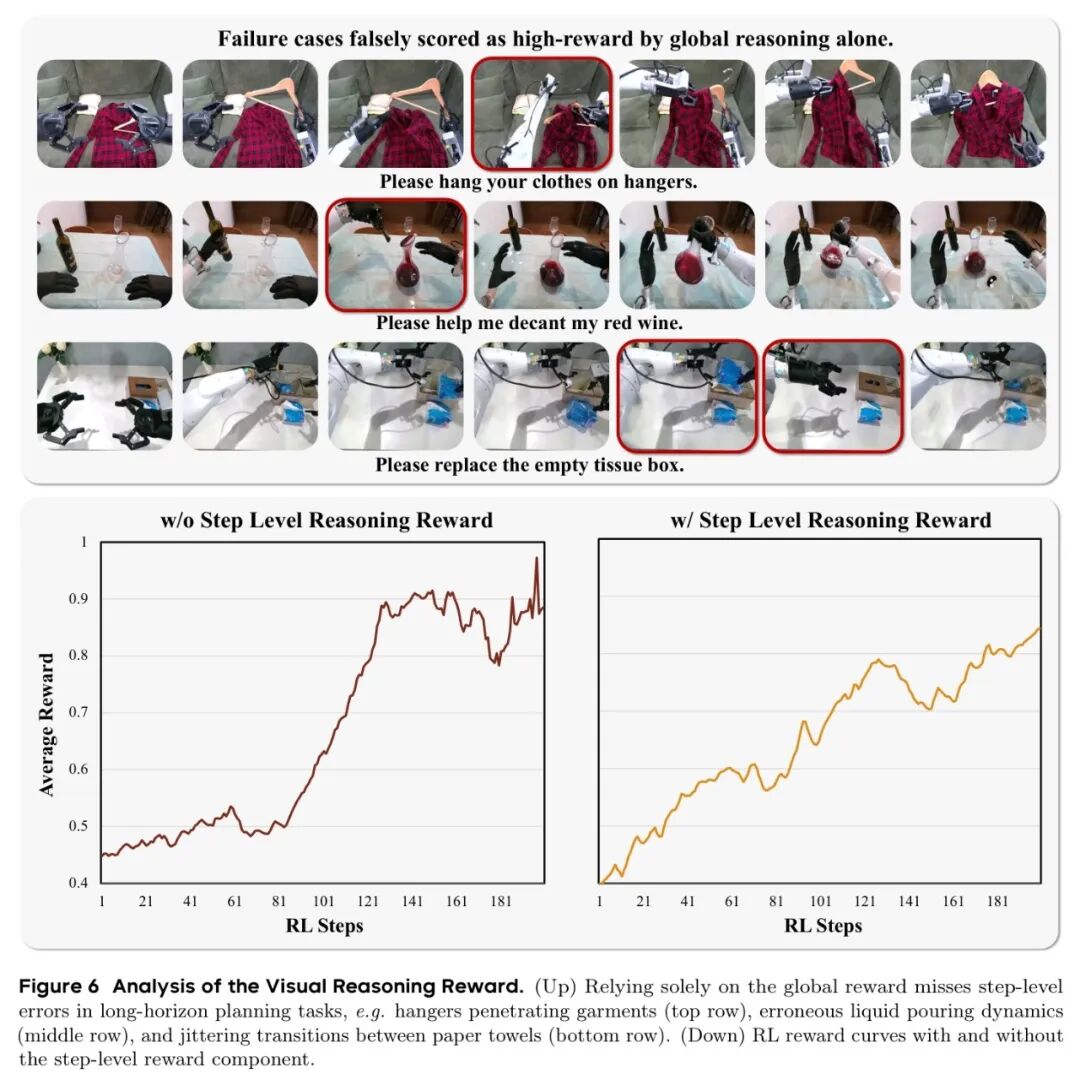
图6的上半部分全是这种“翻车现场”,但这些案例却常常被全局奖励判为高分。因为这些评估模型对物理世界的细节感知是有限的,一不小心就被“金玉其外,败絮其中”的生成结果给骗过去了。
针对这个痛点,作者引入了Step-Focal Reward,也就是步级聚焦奖励。
请看图3的具体做法。
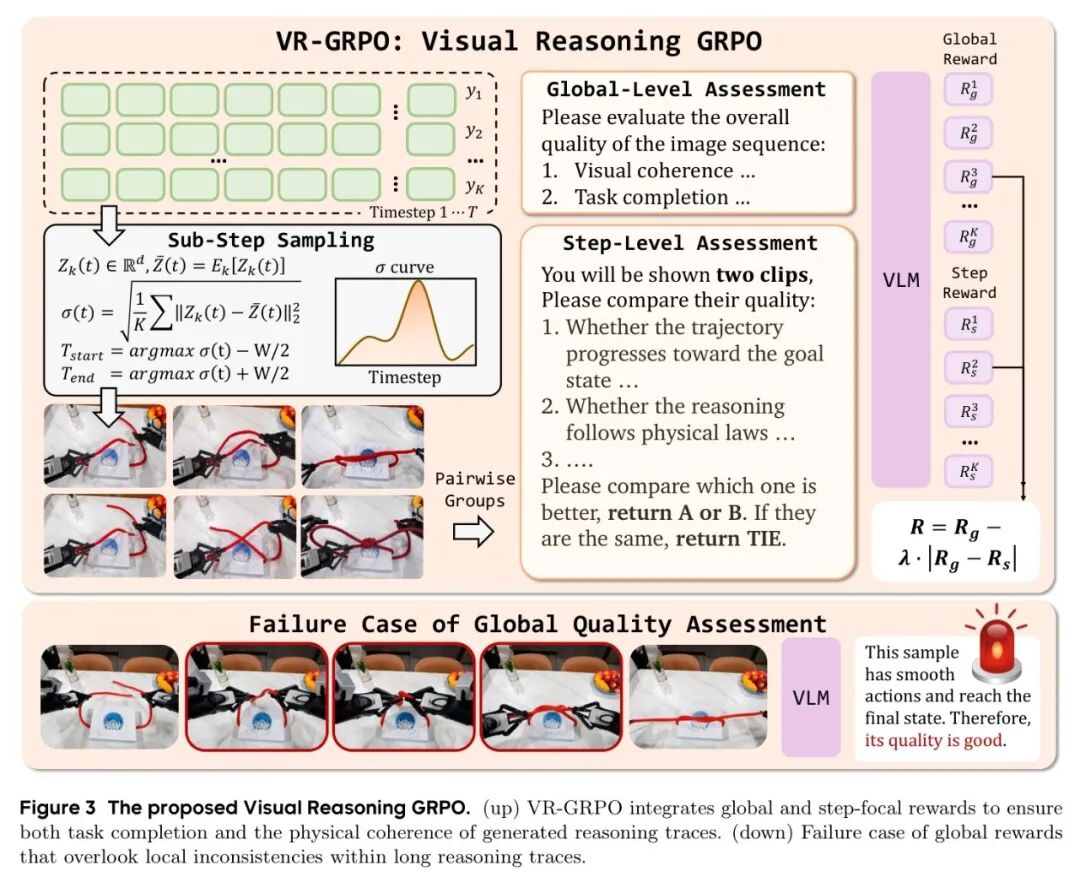
VR-GRPO的精髓在于:它不再只看最后一张图,而是去寻找模型最容易犯错的那个关键子步骤。它在数学上是怎么锁定的呢?看下面这个核心公式:
这个过程就像是找来K个学生(rollout轨迹),让他们在同一个时间点t画同一步骤。如果大家画出来的东西在特征空间里差异巨大(方差大),那就意味着这一步是个“分水岭”,是模型最容易犯迷糊的地方。算法就会特意把这段挑出来,让严苛的VLM教练专门盯这一步。
然后,最终的总奖励公式被设计成:
这里的巧妙之处在于那个惩罚项。如果模型搞定了最终结果(高),却在关键步骤上错了(低),这个差值就会被拉大,导致 被扣得厉害。这逼得模型必须每一步都老老实实走对,没法投机取巧。
这种奖励设计,让长序列推理的连贯性有了质的飞跃。
实验验证:用数据砸碎质疑
模型设计得再好,也得拉出来溜溜。我们有几张必看的核心数据表。
🏆 SOTA对比:34B模型打出了“超神”局
首先直接看终极PK表。
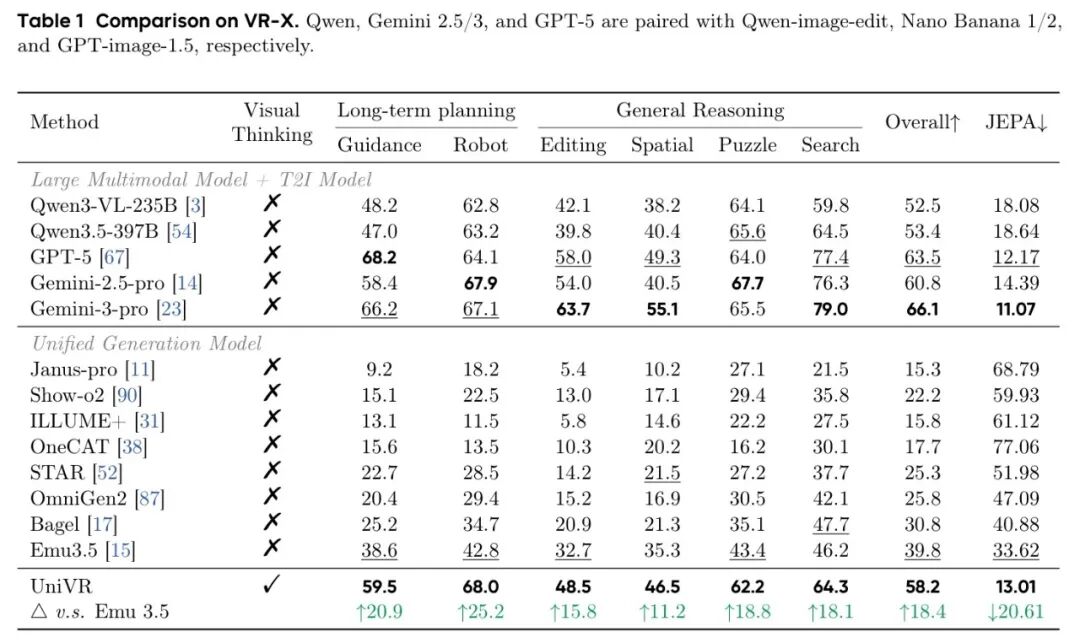
在VR-X这张考卷上,结果很刺激。UniVR只用了34B参数,却拿到了58.2的总分(Overall),把一众“文本大模型+图像生成器”的组合甩在了身后。对比一下,最强的文本流代表Gemini 3 Pro + Nano Banana 2是53.4分。
更关键的是JEPA指标,这是一个用来衡量生成序列是否符合真实物理规律的分数,越低越好。UniVR的JEPA是13.01,而Eum3.5是33.62。这组数据无声地宣告:在物理一致性这件事上,文本中介派被降维打击了。
再来看一下时间维度的碾压证据。
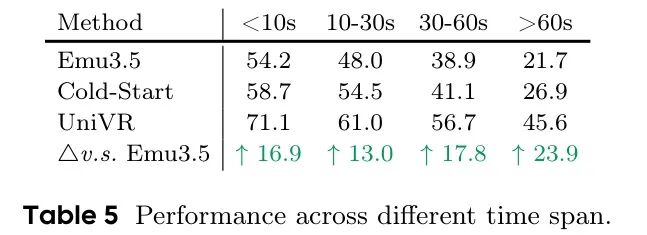
表5揭示了VR-GRPO的真正威力区间。在短于10秒的任务里,提升已经很可观了。但在超过60秒的超长序列任务中,UniVR相对于其底座Emu3.5,性能直接飙升了+23.9。这完美验证了步级聚焦奖励能够有效对抗长时序推理中的复合错误,时间越长,优势越大。
最后,我们再直观感受一下生成效果。
在“给桌上的礼物打结”这种极其考验精细化操作的对比中,Gemini和Emu3.5的操作动作要么造成物体损坏,要么动作不连贯。而UniVR的序列清晰地展示了绳子的正确路径和结的成型过程。这种对比比任何指标都更具说服力。
🔬 消融实验:每一步设计都不是“气氛组”
论证完了结果,我们得看看那些精妙的设计,到底谁才是真大腿。
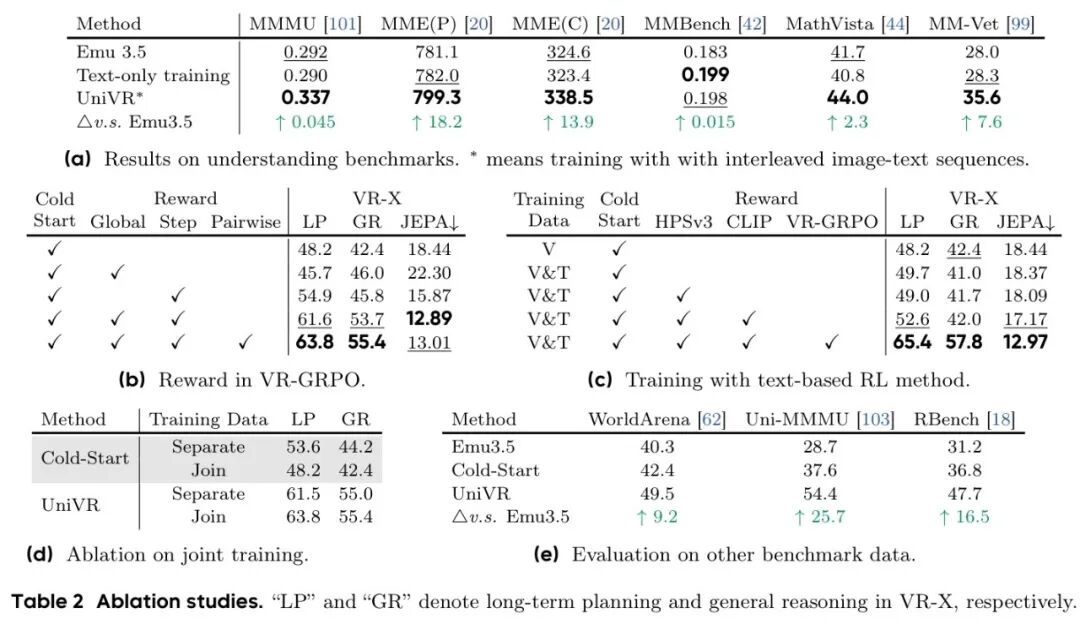
这个表信息量很大,我们拆开看。
在子表(b)的VR-GRPO奖励机制消融中,有个反直觉的发现:如果只加全局奖励,长期规划性能反而会下降(比冷启动还差),这再次实锤了单纯看结果的评估会引发大量奖励黑客行为,逼模型走歪路。必须加上步级奖励 ,才能让性能正向增长。
子表(c)对比了VR-GRPO和其他花哨的图像奖励函数。无论是强调美学的HPSv3,还是强调图文对齐的CLIP,面对需要复杂物理推理的任务,几乎给不出有效反馈。这恰恰说明,推理这事,真不是审美能解决的。
这里有一个意想不到的收获:子表(a)和(d)的数据显示,在视觉空间里把推理能力拉满之后,UniVR回过头去考标准的多模态理解基准(如MMMU、MME),成绩居然也跟着涨了。这意味着,不用死磕文字题,通过在视觉世界里摸爬滚打,模型对真实世界的理解反而更深了,这比多刷几道题管用得多。
客观评价:这条路还远没有到达终点
尽管UniVR走出了跳出文本依赖的关键一步,但按照我们一贯的原则,它的边界在哪,必须说清楚。
首先,资源门槛依然高耸。报告明确指出,在34B规模上训练长视觉序列需要大量计算资源。这是目前限制社区大规模复现和把玩的切实障碍。
其次,也是更深层的局限,评估器依然是“近视”的。作者在原文中坦诚,步级聚焦奖励虽然比全局奖励好得多,但它仍然仰仗于一个通用的VLM来当裁判。而当前的VLM对细粒度物理世界的理解本就是有限的。这就像请了一个眼睛有点散光的教练,他虽然会盯了,但依然会漏掉一些极其微妙的物理瑕疵。未来,或许需要一种生于视觉、长于物理动态的模型来做评估,才能再上一个台阶。
从实验证据往外推,VR-X虽然覆盖了多元场景,但在极度开放、充满噪声的真实长尾环境中(比如户外救援、非结构化厨房),其泛化能力还有待更多检验。作者在部分外部基准上测试了泛化性,这是加分项,但离“扔到任何环境都能干”还有距离。
价值总结与启发
对于研究和工程落地,这篇报告提供了几条非常清晰、可操作的思考路径:
- “视觉原生推理”是条值得押注的赛道 如果你在做具身智能或者复杂物理交互的模拟,可以考虑是否过度依赖文本指令。让视觉信号作为第一性原理去学习策略,可能比设计复杂的语言规划器更高效,也更容易捕捉隐含的物理约束。
- 细粒度过程监督是长程任务的灵魂 VR-GRPO给我们的最大启发是,不要只盯着最终结果。在长序列任务里,设计一种能够自动定位困难子步骤、并施加强过程约束的机制(就像这里的方差分析),是防止模型偷懒的必备手段。
- 视觉训练可能反哺认知能力 UniVR在MMMU等纯认知类任务上的提升,揭示了“具身”和“认知”之间存在一条隐秘的通道。多模态理解不一定非要从文本中提取,从大量物理交互的视觉推理中,模型也能涌现出更强的常识。
- 奖励函数的信用依然脆弱 在你看不到完美评估器之前,必须时刻警惕奖励黑客。你的模型生成的东西,到底是真正理解了任务,还是巧妙地迎合了评分机制?这是每个使用RL训练生成模型的人需要反复拷问自己的。
🤔 深度思考:虽然UniVR证明了纯视觉推理的巨大潜力,但随之而来的是一个更棘手的问题——当模型在视觉空间里“无声”地完成复杂推理时,我们该如何穿透那黑箱般的像素序列,去真正理解它的内在逻辑和决策链?这或许会成为可解释性研究的下一座高山。
💝 支持原创:如果你觉得这篇硬核拆解让你对视觉推理有了新的认识,不妨把它分享给同样在探索世界模型边界的朋友,让深度思考的火花碰撞得更多一些。
🔔 关注提醒:我们会持续追踪类似UniVR这样试图跳出文本框架的研究,不想错过的话,记得把本号加个星标。
#AI技术 #深度学习 #模型优化 #技术干货 #论文解读
参考
UniVR: Thinking in Visual Space for Unified Visual Reasoning