ICML26杰出论文:越自由越笨?扩散模型解题指向一个灵活性陷阱
当一个AI拥有了"想怎么写就怎么写"的自由,它真的会变得更聪明吗?清华和阿里最新论文给出了一个反直觉的答案:对于推理任务,自由越多,能力越弱。
ICML26的杰出论文颁给了扩散语言模型的实验分析论文《The Flexibility Trap: Rethinking the Value of Arbitrary Order in Diffusion Language Models》。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
扩散语言模型(Diffusion Language Models)是一个相对比较新的概念——AI不只是一个字一个字从左到右"念"出答案,而是像画画一样,先打轮廓、再补细节,甚至可以"想写哪句写哪句"。
听起来很酷?毕竟人类思考也不是线性的——我们经常先想到结论,再去补中间的推导过程。
但当我第一次看完这篇论文的实验结果时,第一反应是:"这不可能吧?"
为什么"自由"反而成了陷阱?
先讲清楚一个问题:扩散语言模型到底有什么不同?
传统大模型(像GPT、Claude这些)生成文字时,必须遵循一个铁律——从左到右,一个字接一个字,没有回头路。这叫做自回归(Autoregressive, AR)生成。
而扩散语言模型打破了这个约束。它允许模型先生成中间的几个字,再回头补开头,或者先写结尾再写中间。理论上,这等于把AI的思考空间从一个单向车道变成了一个能随意穿梭的开放广场。
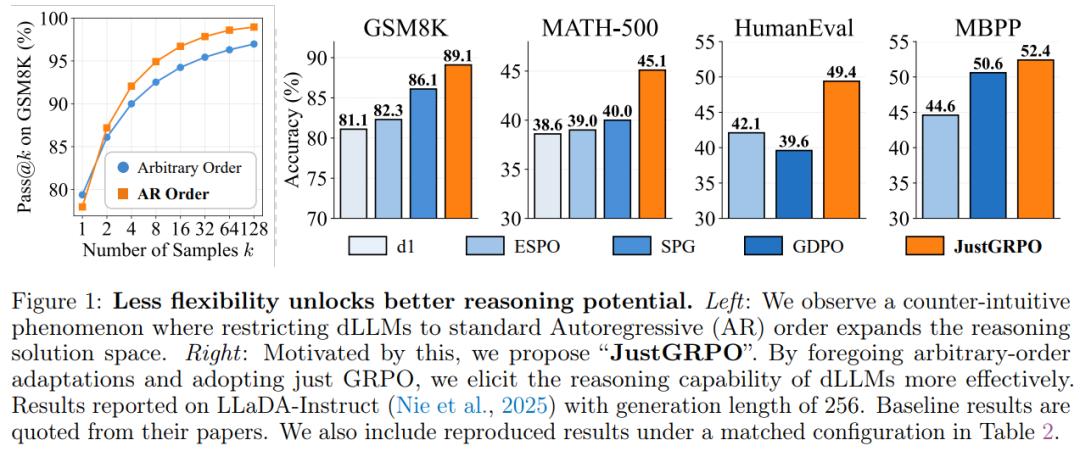
直觉是:更大的灵活度 = 更大的解题空间 = 更强的推理能力。
但论文的实验结果给出了完全相反的结论。
我特别喜欢论文里的一个可视化实验。研究员让扩散语言模型(LLaDA-Instruct)分别用"随意顺序生成"和"严格从左到右生成"两种方式做编程题(HumanEval),采样1024次,看哪些题目被解开了。
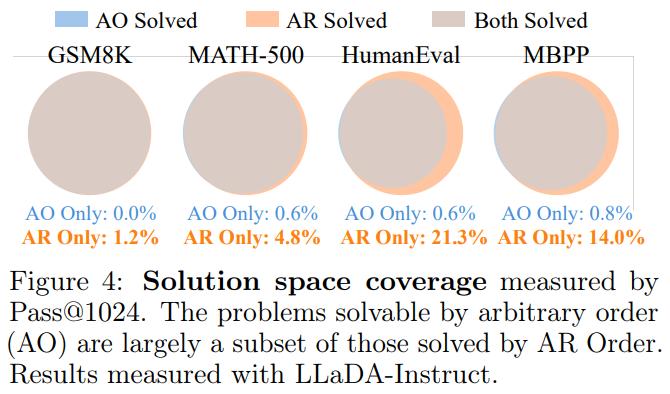
结果令人震惊:
• 只有0.6%的题目是"随意顺序"模式独有解开的
• 而21.3%的题目只有"从左到右"模式才能解开换句话说,所谓"更大的解空间",在大部分实际场景中根本发挥不出来。
"先易后难"的陷阱——AI版的"舒适区"
这就引出了论文最核心的发现。
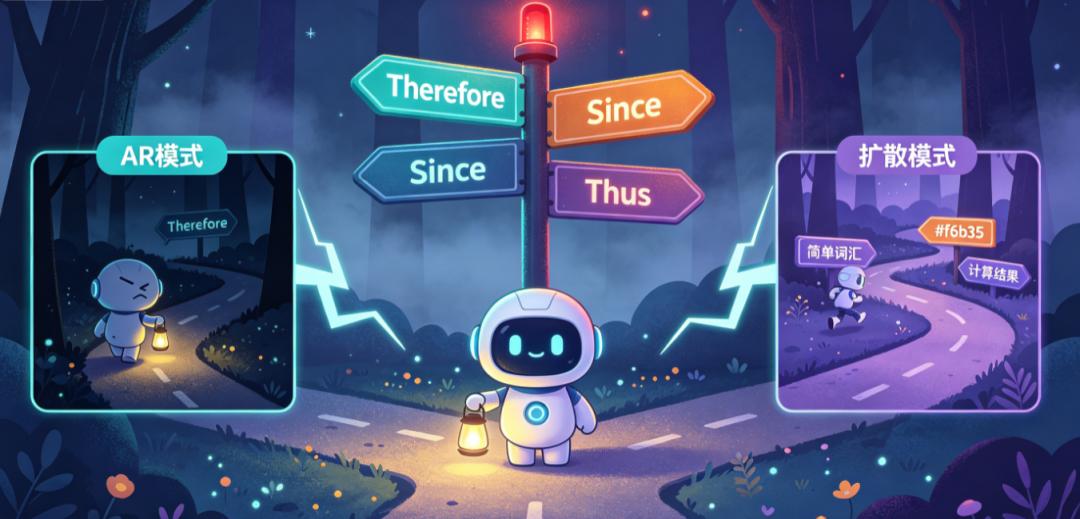
跟人类解题一样,AI在推理过程中也会遇到"岔路口"——比如"Therefore"、"Since"、"Thus"这些逻辑连接词。在英语数学题中,这些词往往决定了解题方向:是继续推导还是得出结论?是引入新条件还是综合已有信息?
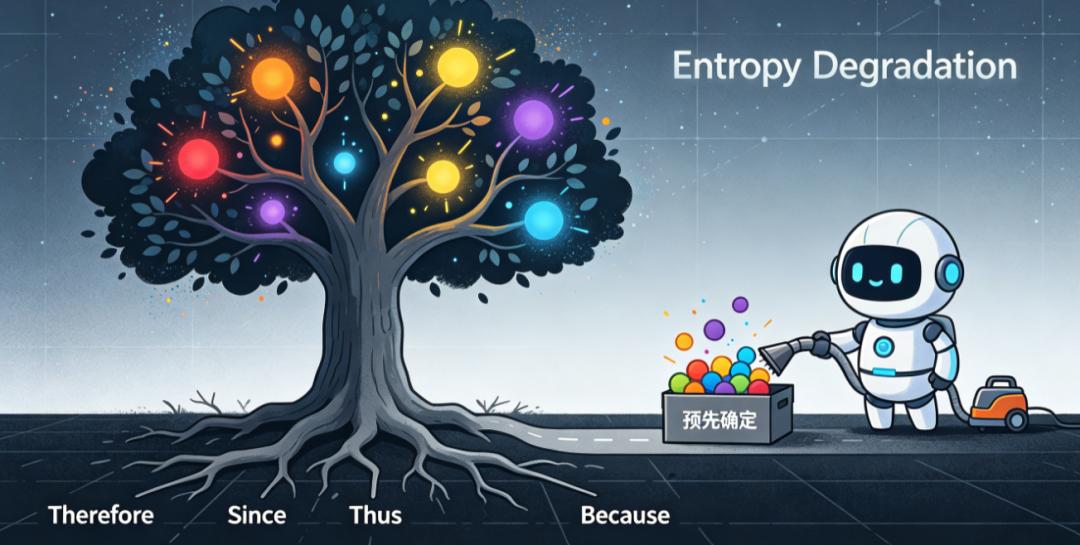
这些词在论文中被称为"逻辑分叉点"(Logical Forks)。
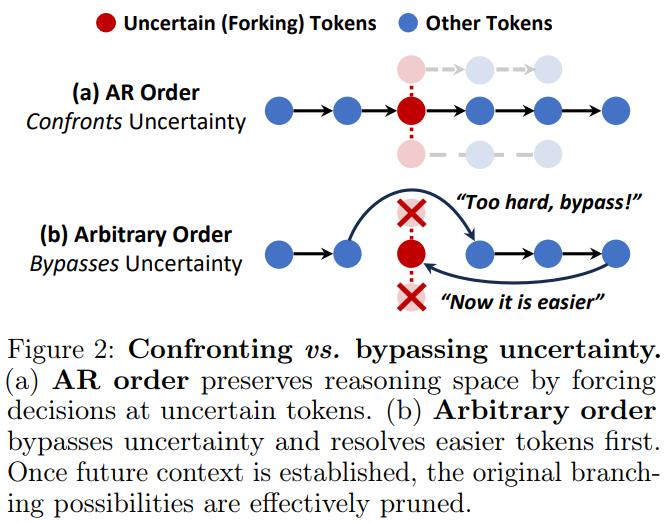
在传统的从左到右生成中,模型被逼着在岔路口做选择。它必须决定"因此"后面接什么,哪怕这个选择可能是不确定的、高风险的。
但在"自由顺序"模式下,模型可以做一件很狡猾的事:先挑简单的写。
这让我想起一个生活中的场景——考试的时候,你是不是也会先把会做的题写完,再去啃那些难题?听起来很合理对吧?但论文发现,AI的这种"先易后难"策略,恰恰摧毁了它的推理能力。
为什么?
当一个AI先写完了所有"容易"的部分——比如题目条件、计算结果——再回来补"Therefore"后面的逻辑连接时,这个连接的上下文已经被预先确定了。它不再是做一个真正的抉择,而是在已知结果的情况下,找一个最合适的词来"填空"。
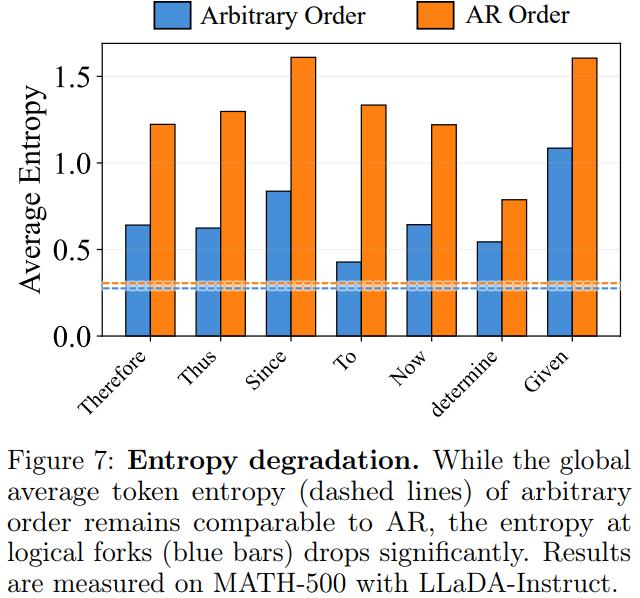
论文把这种现象叫做"熵降级"(Entropy Degradation)。简单说就是:本该是充满可能性的岔路口,变成了没有悬念的单行道。
一个极简主义的解决方案:JustGRPO
基于这个发现,论文提出了一个几乎是"反潮流"的方案:既然自由顺序在推理任务中是有害的,那就别费力去维护它了。
他们直接对扩散语言模型套用了标准GRPO强化学习框架——但有一个关键改动:在训练阶段强制模型从左到右生成。
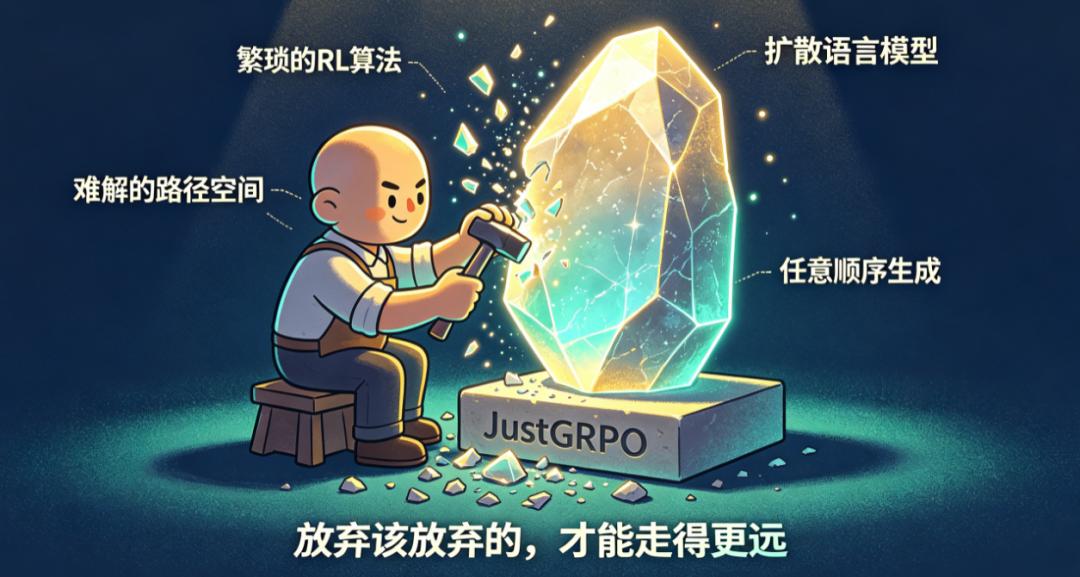
这个方案就叫JustGRPO。名字取得很有意思,像是在说:"别整那些花里胡哨的,直接用GRPO就行了。"
你可能要问:"那训练完的模型,推理时也得按顺序生成吗?那扩散模型并行解码的速度优势岂不是没了?"
这就是这篇论文最巧妙的地方。
JustGRPO只在训练阶段施加"从左到右"的约束——把它当作一个"脚手架"(scaffold),一种帮模型更好地探索解题空间的训练策略。训练完成后,模型架构本身没有任何改变,没有因果掩码(Causal Masking),没有结构约束。推理时,模型完全可以恢复并行解码的能力。
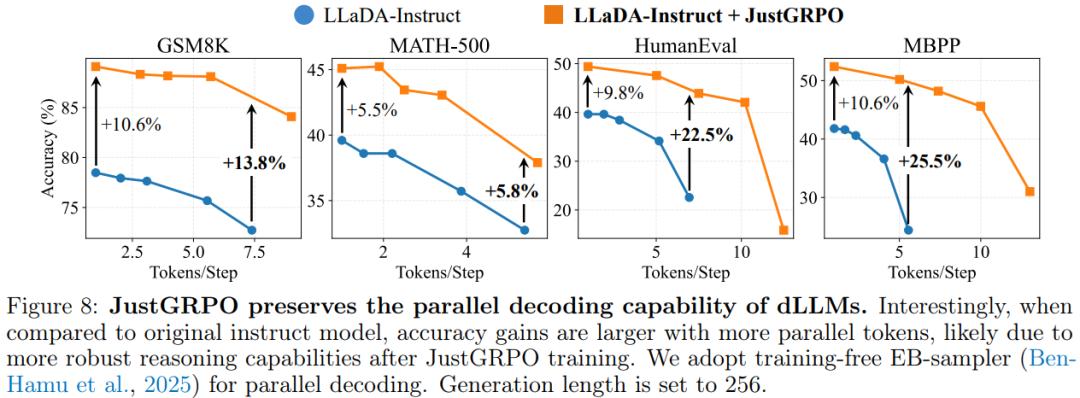
论文用实验验证了这一点。当使用并行解码时,JustGRPO训练后的模型表现甚至比原始模型更稳定——在MBPP编程题上,高并行度下的精度提升从10.6%扩大到了25.5%。
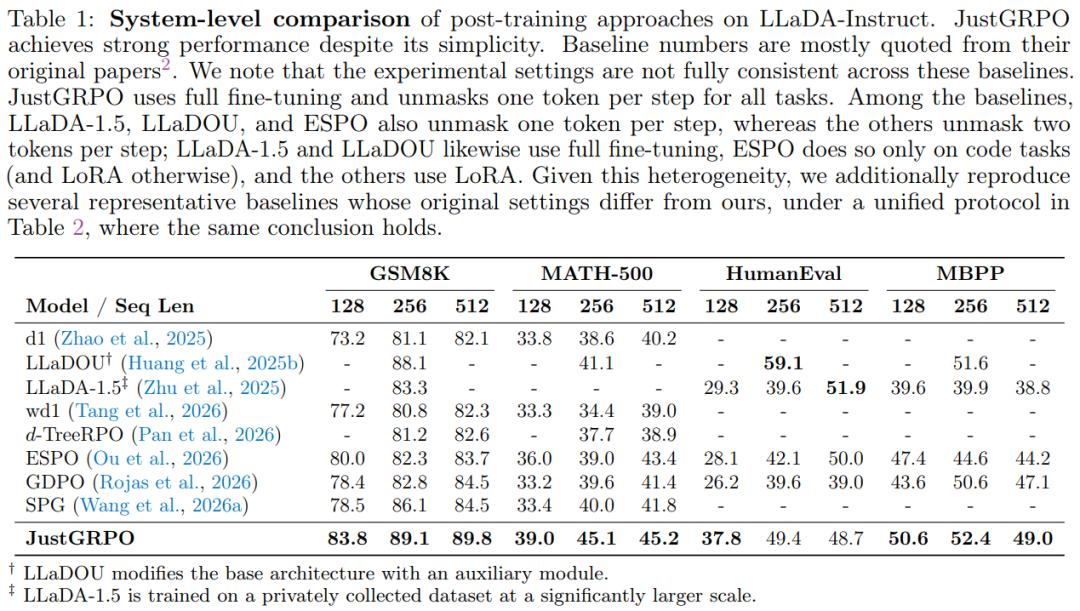
结果也是硬核的:GSM8K数学题上达到89.1%准确率,MATH-500上达到45.1%,在多项基准上超越了那些依赖复杂扩散强化学习适配的方法。
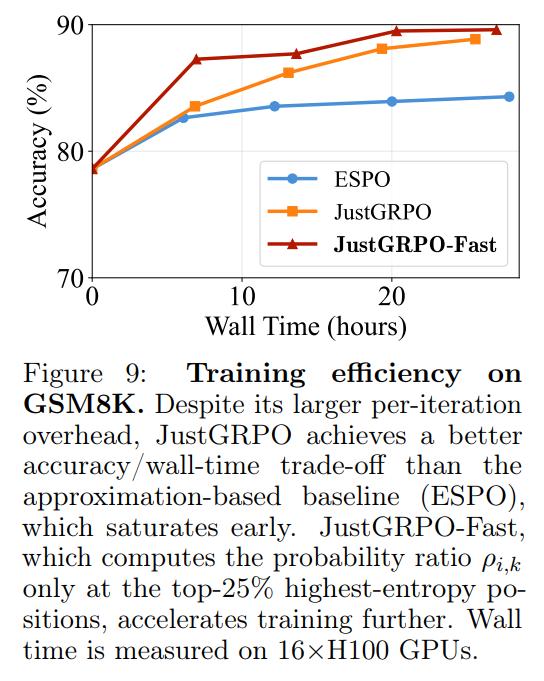
最让我觉得有意思的是JustGRPO-Fast这个变体。它只在"熵最高"的25%位置计算概率比,跳过了剩下75%的计算,训练速度更快,精度却不降反升。这进一步印证了论文的核心观点——推理的关键不在于每步都想得很清楚,而在于那几个真正重要的"岔路口"想清楚了。
这让我想到的
这篇论文戳中了我对一个更深层问题的思考。
我们总习惯性地认为"越自由越好"——给AI更大的生成自由度,给它更多的选择空间,它就能找到更好的解决方案。但事实上,"自由"和"能力"之间,从来不是简单的正相关。
这其实像极了我们自己的学习方式。你有没有发现,最有创造力的艺术家往往是在掌握了严格的技术规范之后才"打破规则"的? 最深刻的思考者往往是先学会了一套严谨的逻辑框架,才能做出真正的创新?
巴里·施瓦茨(Barry Schwartz)在《选择的悖论》(The Paradox of Choice)里讲过一个类似的观点:过多的选择并不会让人更幸福,反而会造成决策瘫痪。AI的推理过程似乎也在经历类似的困境——当模型面对太多"选择"(可以随意决定生成顺序),它反而会做出次优的"省力"选择,而不是最优的"探索"选择。
尚未回答的问题
当然,这篇论文也有它的边界。这项发现在数学和编程这类"通用推理"任务中成立,但某些特殊场景——比如数独或逻辑谜题——非顺序生成反而表现更好。
这让我很好奇:到底什么样的推理任务需要灵活的顺序?什么样的任务反而需要严格的自回归顺序?是否存在一个通用的判断标准?
另外,论文的结论主要基于LLaDA系列的扩散模型。对于其他架构的扩散模型(比如Mercury、Dream系列),这个"灵活性陷阱"的严重程度是否一样?我觉得这可能是后续研究的一个有趣方向。
最后
这篇论文给我的最大启发不是某个技术细节,而是它提醒了我一件事:在AI的每一次"进步"中,我们面对的最大挑战往往不是"如何做更多",而是"如何知道该放弃什么"。
扩散语言模型为了"任意顺序生成"这个能力付出了复杂的代价——繁琐的强化学习算法、难解的路径空间、以及潜在的推理能力损失。JustGRPO告诉我们的就是:有时候,放弃这个吃力不讨好的灵活性,反而能让你走得更远。
所以下次当你听人说"这个AI能自由生成,不受顺序限制"的时候,也许可以问一句:这种自由,到底是通往更聪明的路径,还是一个精致的陷阱?
参考资料
• The Flexibility Trap: Rethinking the Value of Arbitrary Order in Diffusion Language Models. ICML 2026. https://arxiv.org/abs/2601.15165