商汤开源 SenseNova-Vision|专用模型有专攻,是上个CV时代的执念
看到这个标题,你可能会觉得有点疯狂。毕竟在过去十年,计算机视觉领域已经习惯了“专人专用”——目标检测一个模型,语义分割一个模型,深度估计再来一个模型。每个任务都有自己定制的架构、特定的损失函数和单独的解码规则。
但今天这篇文章,要介绍的工作正在试图打破这一范式。它告诉我们:计算机视觉的几乎所有任务,都可以被塞进同一个粉笔盒子里,通过“对话”的方式来完成。
更惊人的是,这个名叫 SenseNova-Vision 的单一模型,不仅能在多个核心指标上与那些专精的专家模型打得有来有回,甚至还展现出了训练数据之外的新能力。这到底是怎么做到的?
核心痛点:为什么我们亟需“统一”?
如果你是一位 AI 开发者,你一定对那种“切图-拼结果”的开发模式深恶痛绝。想要让机器看懂图片,不仅要识别物体(检测),还要理解它们的位置关系(分割),甚至要感知深度和几何结构。
这会带来三个棘手的问题:
- 碎片化的架构每个任务设计一套模型,维护成本高,且难以联合优化。
- 监督信号的浪费不同任务之间存在大量的共通知识(比如物体的轮廓),但在独立训练中,这些知识无法流通和复用。
- 交互的鸿沟传统的视觉系统很难理解复杂的自然语言指令,更别提像“把所有红色的、用来盛液体的容器涂成蓝色”这种组合式的任务了。
虽然之前有 GPT 将 NLP 任务大一统的先例,但在视觉领域,由于输出模态实在过于复杂(有文本、有像素级别的图像、有三维点云),导致很长一段时间内,统一模型只是个遥不可及的目标。但 SenseNova-Vision 的团队决定稍微换个思路:如果我把所有的计算机视觉任务,都重新表述成“统一的多模态生成”呢?
原理拆解:一个能画、能写、能感知的超级生成器
SenseNova-Vision 的实现逻辑,其实有着异曲同工之妙。它本质上是一个 统一多模态模型(UMM),但它打破了传统 UMM 只能“讲段子、画整图”的局限,让模型学会了输出视觉专家才懂的“黑话”。
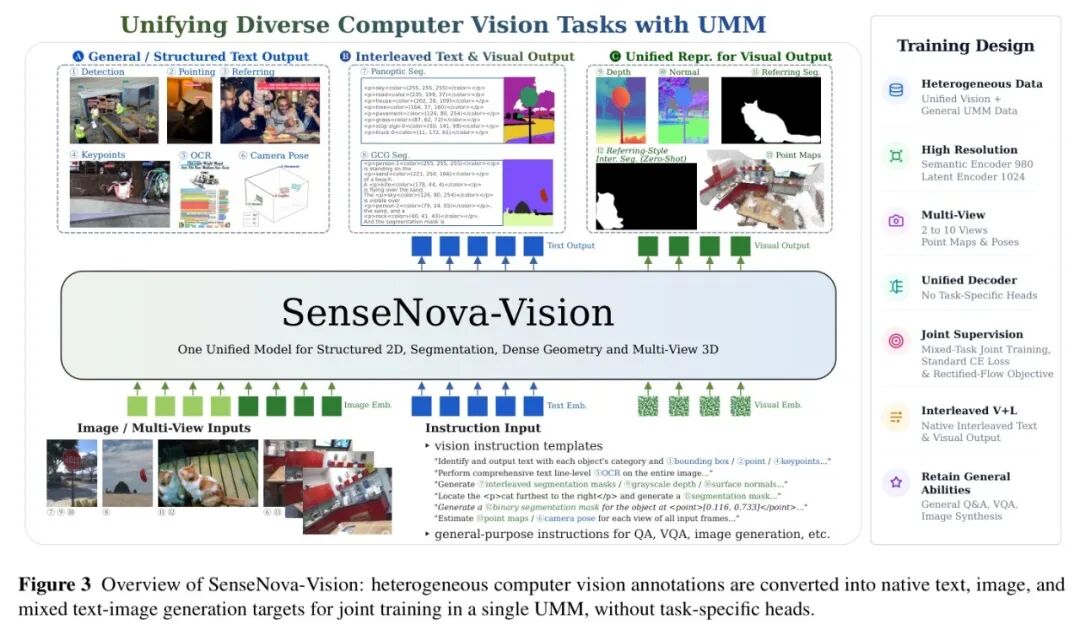
💡 设计直觉:视觉任务的三种“语言”
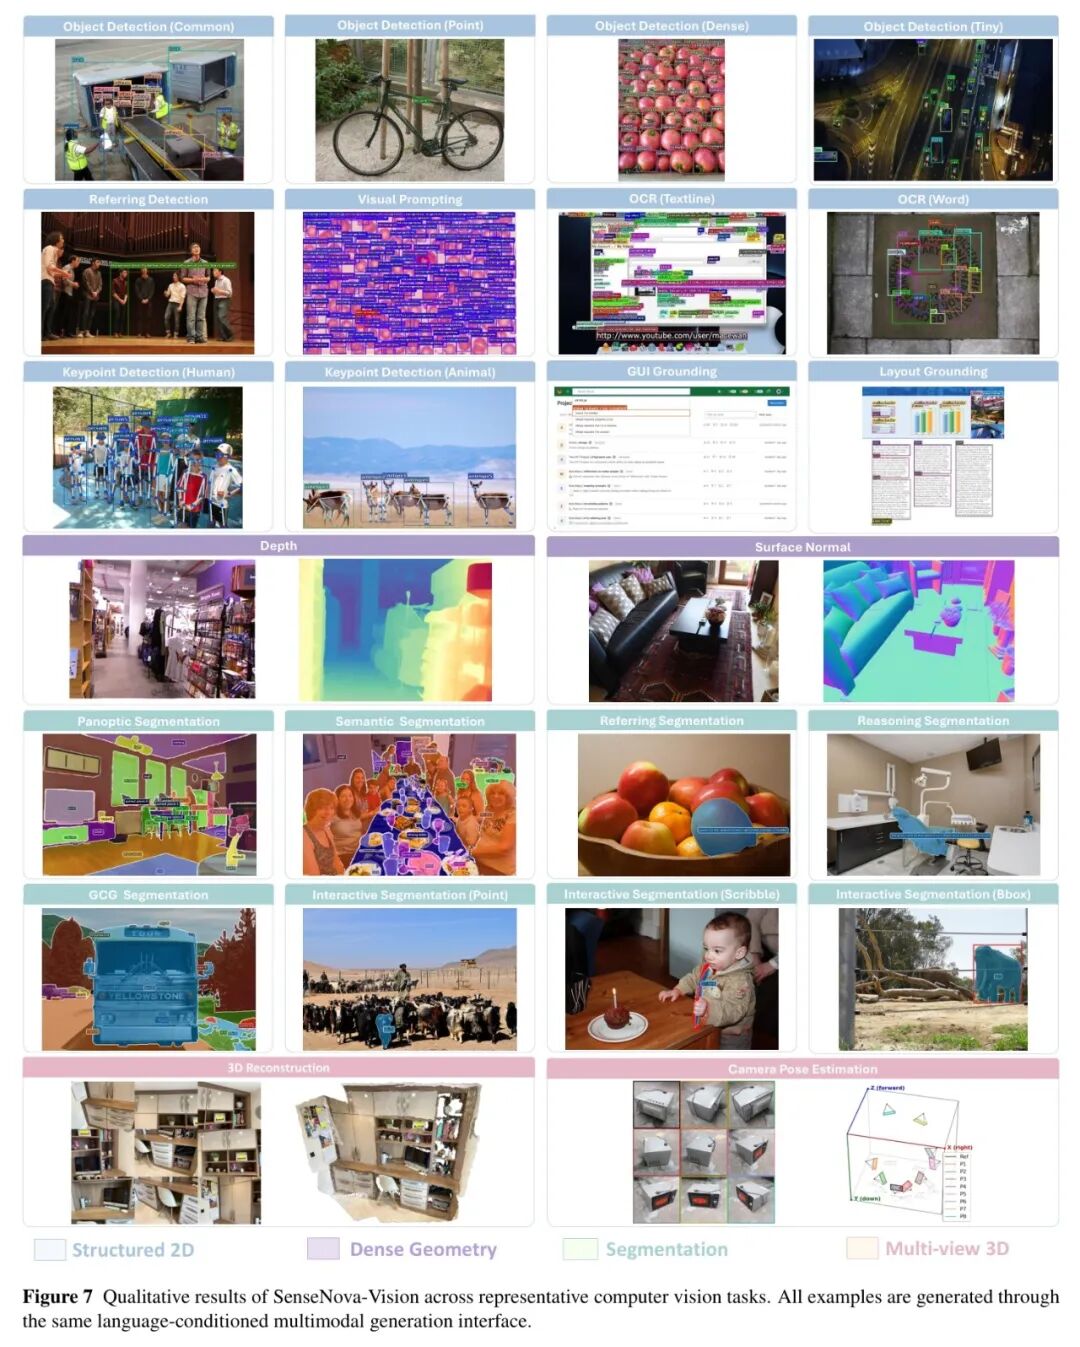
你可以把计算机视觉的各类任务,想象成三种不同的回应方式,而 SenseNova-Vision 通过巧妙的协议设计,把它们一并整合进了原生生成空间:
- 文字产出(结构化感知)
当我们做目标检测、OCR 或者关键点识别时,模型不说“左上角有个狗”,而是用精确的数学语言回复。它会吐出一串带有特殊标记的文本,例如:狗 <bbox>[0.312, 0.708, 0.726, 0.974]
通过这种轻量级的生成结果,模型用文本生成能力就能精准表达物体在画面中的位置,直接替代了复杂的回归头网络。 - 图像产出(密集几何预测与分割)
如果让模型去写坐标描述深度图,那就会彻底崩溃,因为一张图有几百万个像素。对于深度图,模型直接利用其图像生成能力,把深度信号渲染成一张灰度图——距离越近越亮,越远越暗。同理,对于法线图,模型生成一张代表空间朝向的彩色图像。
这就像是在写一本图像小说,遇到视觉化的信息,直接用插图表达,远比文字高效。 - 混合产出(复杂分割)
面对全景分割这种需要“指认现场”的场景,模型会自己先列一个图例:“天空<color>(173,216,230),树木<color>(34,139,34)...”,然后立刻生成一张根据该图例着色的分割图!当有人问“把坐在椅子上吃红色苹果的人找出来”时,模型会先推理出谁是符合描述的人,再给他附着特定颜色的掩码。
数据引擎:5000万样本的魔术
为了训练出这种统一接口,光是靠公开的现存数据是不够的,因为大多数公开数据不具有这种“图文交错”的格式。为此,作者团队构建了一个庞大的 SenseNova-Vision 语料库(SN-VC)。
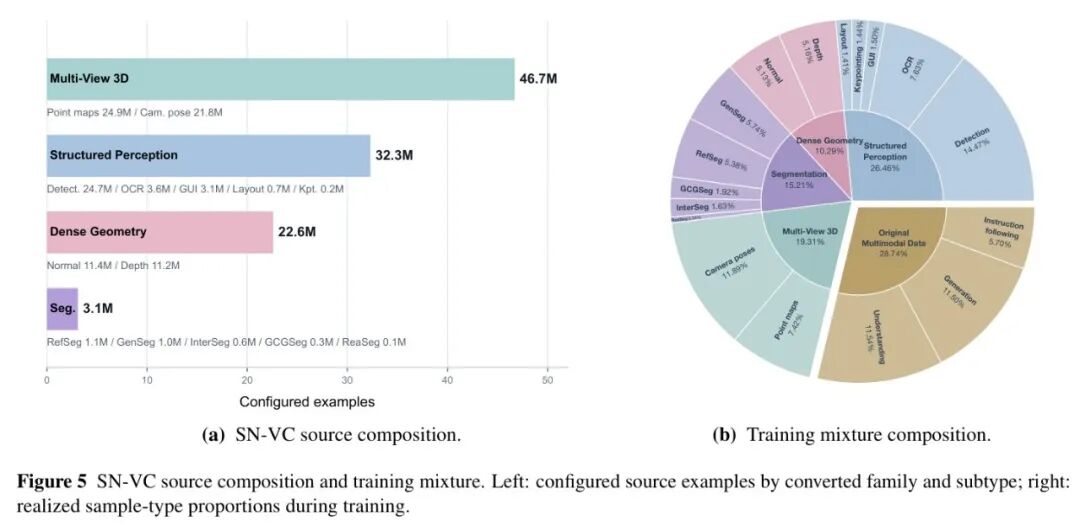
他们设计了四个庞大的数据引擎,系统性地将异构标注改造成对话格式:
- • 检测/指针数据引擎:利用现有的强大视觉模型(如 Grounding DINO)去扩充检测框和精确坐标点,将传统数据集转化为文本指令。
- • 几何数据引擎:利用 MoGe-2 对不完整的深度数据做稠密化处理,喂给模型更干净的几何真值。
- • OCR数据引擎:针对文字的特殊属性进行清洗和重标注。
- • 引用数据引擎:负责将区域描述精准对齐到像素级分割。
这些由数据引擎合成并验证过的样本,被开源为 SN-VC-50M,覆盖了结构化感知、分割、几何到三维重建的所有领域。训练时,SenseNova-Vision 并没有抛弃原有的多模态能力,而是在其基础模型上进行混合任务微调。简单来说,就是同一批数据里,夹杂着做 VQA 的、做深度估计的、做图片生成的,让模型在通用的理解与生成能力不退化的情况下,学会视觉专家的本领。
实验验证:数据不说谎,统一模型能有多强?
如果只是理论花哨,实验一塌糊涂,那也没意义。我们直接看一看它在几个核心领域的表现。
🏆 结构化理解力:专注重写
在目标检测和 OCR 这种需要精确输出坐标和文字的任务上,SenseNova-Vision 展现出惊人的压制力。
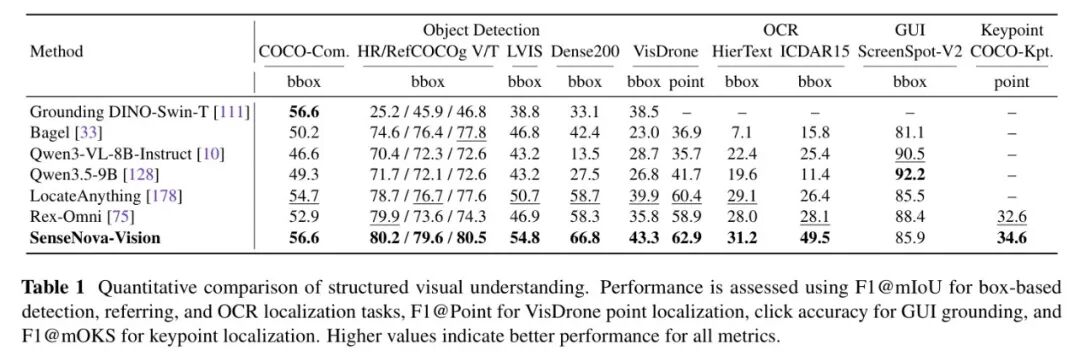
从表1中可以清楚地看到,在 COCO 通用目标检测、以及 RefCOCO 系列这样精细的指代定位中,它大幅超越了像 Grounding DINO、Qwen3-VL 等一众强手。特别是在密集场景(如 Dense200 拥挤鱼群)和小目标定位(如 VisDrone 无人机航拍点)里,模型显露出其对细粒度对齐的深刻理解。这在统一模型中意义重大,说明只靠生成序列化文本,也能媲美甚至超越专用的回归检测器。
🏆 二维密集感知:像专用模型一样精确
深度估计和法线预测是衡量模型“眼力”的重要标准。
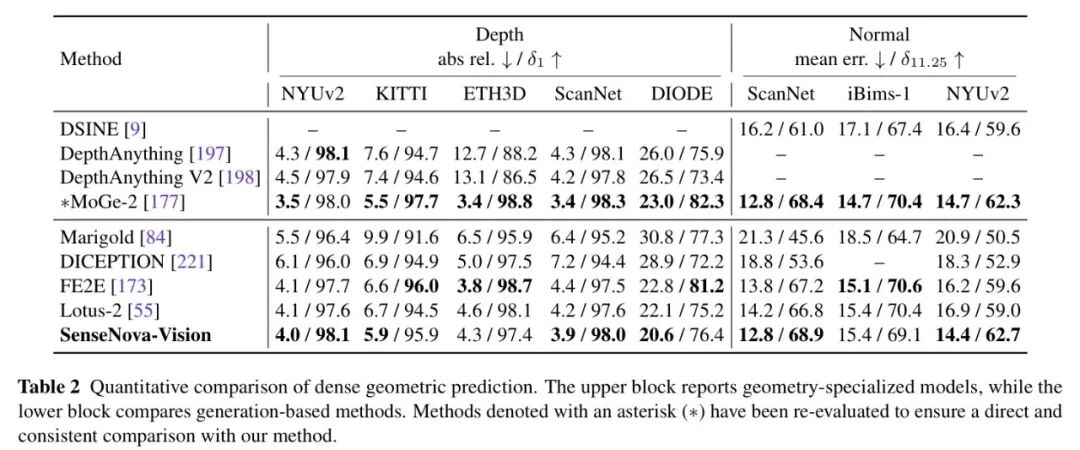
这项任务传统上被像 Depth Anything 和 Marigold 这样的几何或扩散模型统治。而 SenseNova-Vision 通过生成“灰度深度图”的方式,居然在这个领域打进了第一梯队。从表2中可以看出,在 DIODE 室外深度估计和 ScanNet 表面法线预测上,它的关键误差指标(AbsRel 和 Mean Error)甚至击败了多数专用生成方法。这验证了一个关键假设:生成式模型确实能从像素层面理解物理世界的几何结构。
🏆 多视角 3D 重建:迈过二维到三维的门槛
如果给模型多张不同角度的照片,它能否在脑海中构建出这个世界的三维立体结构?
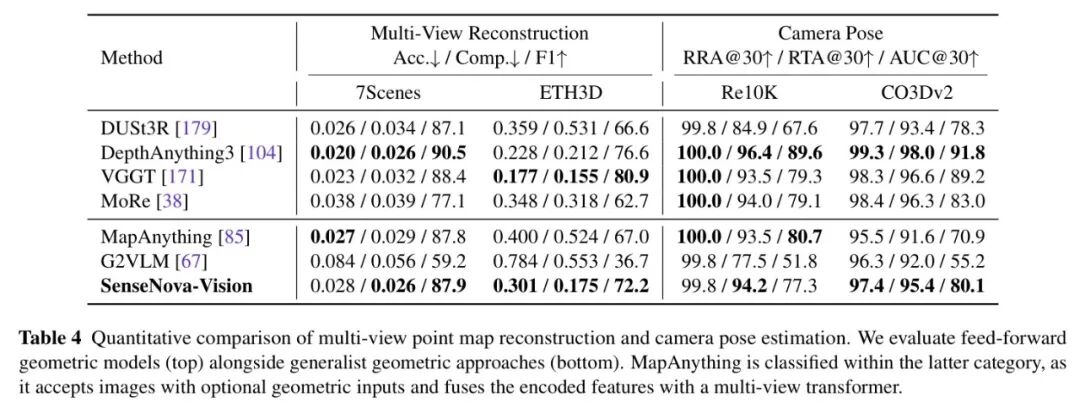
SenseNova-Vision 的做法也很巧妙。它把相机位姿参数作为字词序列输出(四元数和偏移量),而把稠密的重建结果直接渲染成像素级对齐的 XYZ 点云图(以RGB图像形式)。在多视角几何任务中,它在通用方法中摘得桂冠,甚至在 ETH3D 多视角重建中,已经非常接近像 VGGT 和 DepthAnything3 这样经过残酷几何特训的专家模型。
意料之外的惊喜:涌现出的“超能力”
如果说上述都是监督学习范围内的“复现”,那接下来的内容,就真的有点科幻了。
由于所有的能力——框坐标检测、语义指代、掩码生成——都被挤在了同一个参数空间中,当 SenseNova-Vision 看到前所未有的指令时,它会尝试重组这些技能。
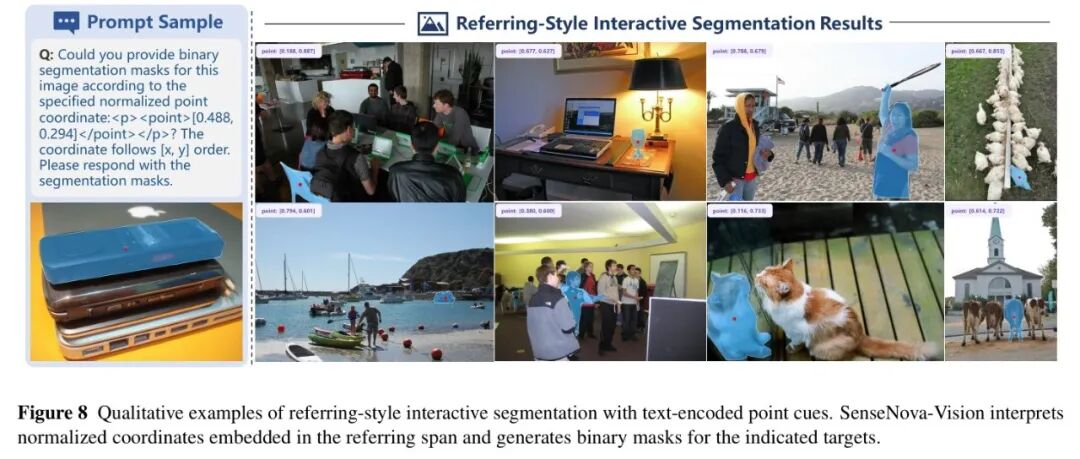
比如引用式交互分割。研究人员仅仅在文本里写了一个坐标点 (0.488, 0.294),没有提供任何视觉框或涂鸦,要求模型去分割这个位置上的物体。这个技能没有在训练集中显式出现过,但模型竟然做到了,因为它重组了“读懂点坐标”和“画二值掩码”这两个技能。
更疯狂的是密集实例分割与自由格式颜色控制。面对密密麻麻的鱼群和航拍小车,你可以直接给它下命令:“给每一条鱼涂上不同的颜色!”它就会生成类似调色盘的文本,并输出对应的多彩分割图。哪怕你任性地要求:“猫涂绿色,行李箱涂蓝色,墙壁涂橙色”,它也能大致依从——这在以前需要写复杂脚本去控制物体ID和颜色映射,而现在,你仅仅是和它说了句话。
你可能会好奇,在多任务训练下,模型是怎么学会开车不翻下悬崖的?对不同任务的学习速度一样吗?通过收敛性分析图表我们可以发现,有些任务如目标检测,收敛得非常快;而长尾的密集小目标检测,则需要学习更久才能建立跨模态的对应关系。这也是为什么千亿级 Token 的训练至关重要——它给了模型充足的时间去反刍那些困难的视觉词汇。
客观评价与局限性
当然,SenseNova-Vision 并非全能的神。
- 细粒度与颜色忠实度虽然能理解“红色”,但在要求输出精确到(#FF0000)的十六进制颜色分割时,还是可能会出现微小的 RGB 偏差或不精确边缘。
- 极度密集场景的遗漏在成百上千个拥挤对象(如极度密集的羊群)中,如果语言提供的颜色槽不够,模型会有将同类且空间相近的物体合并的倾向。这可以通过在生成时提供更明确的分离提示来解决。
- 专业性极限在面对最顶级的几何专用模型(如 VG GT 巨无霸)时,SenseNova-Vision 在多视角 3D 上仍有细微差距,表明专门的归纳偏置和领域特定编码依然在精度的极致上占有优势。
但别忘了,它是一个唯一不需要任何任务专属头的模型。这种量级的通用性,足以掩盖它微小的瑕疵。
总结:感知正在成为一种“可编程、可生成”的能力
SenseNova-Vision 的出现,本身传递了一个非常强烈的技术信号:视觉感知不再是一种需要逐任务精心手雕的工艺,而正在变成通用基础模型的一种原生生成能力。
告别那些繁杂的后处理 NMS、解耦损失函数和解码器映射,我们只需要通过语言向基础模型下达指令,就像让 GPT 写一首诗那样简单。当视觉模型真正掌握了“语言+图像”的本能反应,开发者只需要通过设计巧妙的指令模板,就能“创造”出从未标注过的全新视觉任务。
这项技术的开源和语料库的公布,或许会开启一种全新的研究范式——未来的计算机视觉研究方向,将从“设计一种新架构来提点”,转向“如何设计更精妙的视觉指令让大模型涌现出更复杂的理解与推理能力”。
🤔 深度思考:设想一下,如果你的应用只需要一个模型权重、统一的服务接口,就能实现从检测、分割到 3D 重建的全部功能,你最想把它落地在哪个前沿场景?欢迎在评论区碰撞想法!
💝 支持原创:如果这篇从底层逻辑到最新实验的硬核解读对你有启发,请点个在看、点个赞,并分享给你的技术伙伴们,让更多人看到统一视觉模型的强大!
🔔 关注提醒:不想错过 AGI 在视觉领域的最新进化?点击关注并星标,这里的每一篇解读,都为了带你领略真正的“技术之美”。
#AI视觉#多模态大模型#统一感知#3D重建#预训练模型#技术干货
参考
Vision as Unified Multimodal Generation