破解量化投资的“不可能三角”:FactorMoE如何让Alpha因子同时具备可解释性与高收益
“FactorMoE: a framework with mixture-of-experts and attention to dynamically combine alpha factors in quantitative investment”
在量化投资的世界里,存在着一个经典的“不可能三角”:公式化Alpha因子逻辑清晰、可解释性强,却往往因静态、僵化而无法适应瞬息万变的市场;基于深度学习的黑箱模型预测精准,却又让投资者望而却步,难以理解收益来源。如何同时拥有两者的优势,成为业界和学界长期追逐的圣杯。
这篇由浙江大学研究团队发表于《Complex & Intelligent Systems》的论文,提出了一种名为FactorMoE的创新框架,试图打破这一僵局。该框架巧妙地借鉴了混合专家模型(MoE)与注意力机制,让机器学会像一个经验丰富的基金经理那样——既关注市场当前的整体“气候”(市场状态),又审视每个因子近期的“发挥”(表现绩优),从而动态地激活和组合最合适的Alpha因子。
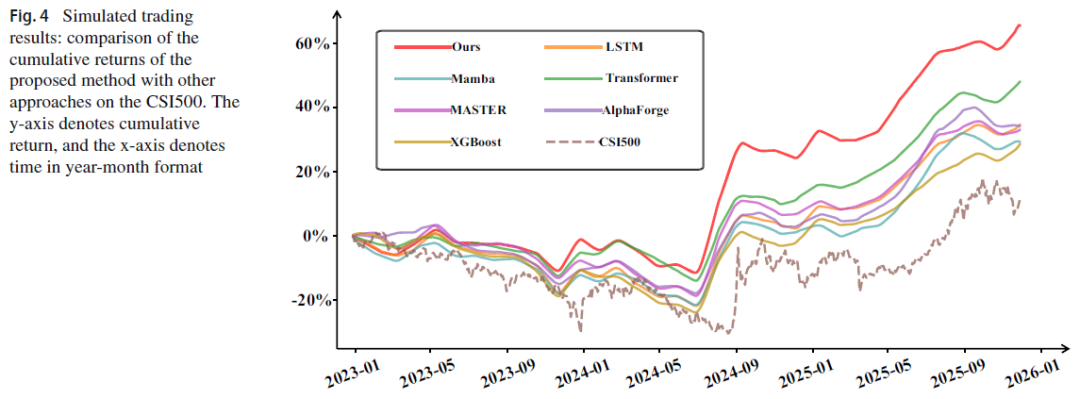
实验数据令人振奋:在沪深300、中证500和中证800等真实数据集上,FactorMoE不仅在IC、RankIC等选股能力指标上大幅超越XGBoost、LSTM、Transformer等传统方法,在长达数年的模拟交易回测中,其累计收益更是碾压所有对比模型,达到了65%,而同期中证500指数仅为10%
【 扫描文末二维码加入星球获取论文,源码 】
摘要
金融市场具有高波动性和低信号噪声比的特点,这对量化投资方法提出了严苛的要求。公式化Alpha因子因其可解释性而受到重视,但往往缺乏适应性;而基于机器学习的Alpha因子虽然提供了更强的预测性能,却牺牲了透明度。在此,我们介绍FactorMoE,一个用于动态组合公式化Alpha因子的深度学习框架,它调和了这种可解释性与性能之间的权衡。FactorMoE基于市场状态指标和近期因子表现来调节可学习的门控网络,从而动态激活和加权候选Alpha因子。一个链式混合专家模型(Chained Mixture-of-Experts)架构与多头注意力机制相结合,实现了专家的顺序优化以及因子间非线性协同交互作用的建模,使得该框架能够在市场条件变化时优先选择稳健的因子组合。
简介
本文指出,金融市场具有高波动性和低信噪比的特点,对量化投资方法提出了严苛要求。传统的公式化Alpha因子虽因其可解释性而受到重视,但往往缺乏适应性,即它们是静态的,难以适应市场结构和频率的变化,且一旦被广泛使用,其预测能力会迅速衰减。相反,基于机器学习的Alpha因子虽然预测性能更强,但其“黑箱”特性降低了策略的透明度。
为了平衡可解释性与适应性,研究者们转向了自动因子发现方法,例如基于遗传编程的算法。然而,这些方法受限于其搜索空间和表征能力。近期,AlphaForge提出了一个用于Alpha因子生成和组合的两阶段框架,但
现有的线性组合方法在表达能力和捕捉非线性关系方面存在局限性。
针对上述问题,本文提出了FactorMoE框架。该框架受AlphaForge两阶段架构的启发,旨在调和公式化Alpha因子的可解释性与机器学习因子的高适应性。其核心组件包括:链式混合专家模型 (CoE)、多头注意力机制 (Multi-Head Attention)、评分专家 (Scoring Experts) 和动态门控机制 (Dynamic Gating Mechanism)。该框架通过联合分析市场状态指标和Alpha因子表现,计算出每个因子的综合得分,并据此决定因子重要性,随后通过线性投影聚合被选中的因子。
本文的主要贡献如下:
提出的框架融合了深度学习模块,能在复杂市场条件下发现具有更强适应性和协同交互作用的Alpha因子组合。
引入了动态门控机制,不同于传统的静态选择和线性组合方法,该方法通过新颖的得分加权步骤实现Alpha因子的动态激活。
在当代数据集上进行了一系列综合实验,与基线模型和最先进模型进行了比较,结果证明了该方法的优越性。
相关工作
公式化Alpha因子
早期工作通过遗传编程[16]和互信息度量来挖掘因子。随后,AlphaEvolve[3]能组合更复杂运算,AlphaGen[30]利用强化学习训练生成器,AlphaForge[24]提出基于GAN的两阶段框架,AlphaAgent[25]则借助大语言模型并引入正则化机制以缓解因子衰减。然而,这些方法在组合阶段通常依赖静态策略,无法同时适应市场波动和因子表现的时序变化。
基于机器学习的Alpha因子
深度学习的进展催生了股票收益预测新方法。早期工作应用了LSTM[10]、Transformer[26]和XGBoost[2]等模型。近期研究如MASTER[15]引入市场引导门控机制,Samba[17]采用双向Mamba[11]结合图卷积处理跨股票关系。这些方法预测灵活性更高,但可解释性有限。
预备知识
Alpha因子:在一个长度为 T 的交易期内,总股票数为 N。将Alpha因子定义为一个映射函数 f,它将第t天所有股票的特征向量集合 Xt ∈ R^N×mτ 映射为Alpha值 v_t = f(X_t) ∈ R^N。本文使用六个原始特征:开盘价、收盘价、最低价、最高价、成交量和成交量加权均价(VWAP)。框架的输入即为这些Alpha值。
Alpha因子组合:从一个大小为 K 的Alpha因子池出发,对于第t天的特征矩阵 X_t,通过映射函数得到所有 K 个因子的Alpha值 v_{Kt} = f_{1,......,K}(X_t) ∈ R^NxK。然后计算 S(v_Kt),其中 S 是Alpha因子的评估函数。根据评估结果,选择一组综合表现优异的Alpha因子子集,利用因子间的互补性来降低单一因子的风险。
混合专家模型 (MoE):一种动态地将多个专家子网络分配给不同输入方面的机器学习架构。假设专家总数为 I,第 i 个专家的映射为 E_i,门控网络映射为 G。其核心思想是将输入 x 路由到最相关的专家子网络,最终输出 y 是专家输出的加权和,权重由门控网络给出:
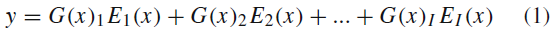
方法
FactorMoE框架包含四个组件:
A) 公式化Alpha因子挖掘模块
B) 市场引导的注意力链式专家模型(MACoE)
C) 表现引导的注意力链式专家模型(PACoE),
D) 因子组合模块
市场引导的注意力链式专家模型 (MACoE)
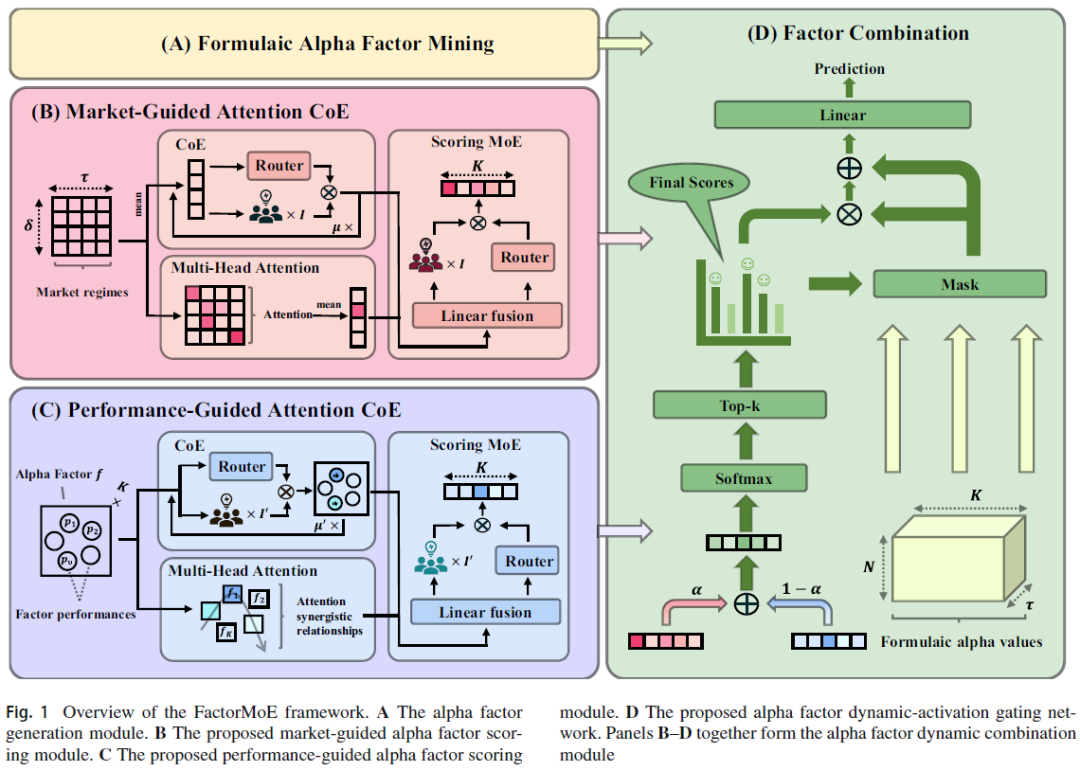
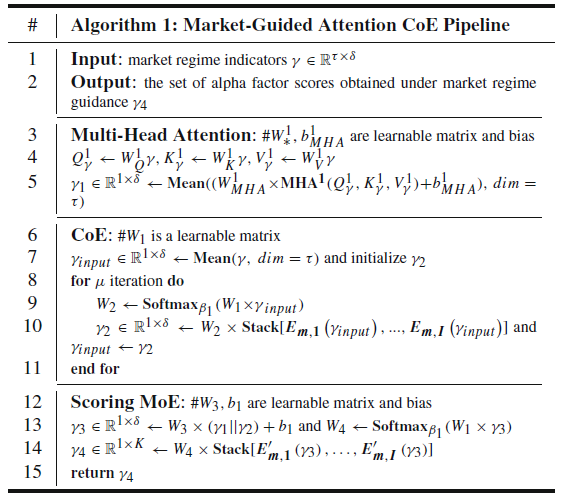
首先,构建一个描述市场状态指标的向量 γ ∈ Rτ×δ,其中 τ 是滚动窗口大小(本文设为40),δ 是市场状态指标数量(包括54个技术指标和18个市场广度与情绪指标)。该向量随后被送入以下两个并行模块:
多头注意力模块:处理 γ,捕捉市场中的复杂跨时间依赖关系,输出经线性投影后在 τ 维度上取平均,得到 γ_1。
链式专家模型 (CoE):将 γ 在 τ 维度上取平均得到 γ_input。随后经过一个路由器(Router)产生专家权重 W_2 ∈ R^1xI(I=8),并由系数 β_1=0.5 缩放。同时,γ_input 并行送入每个专家 E_m,专家输出使用权重聚合。经过 μ=4 次迭代的链式处理后,得到 γ_2。该模块通过模拟层次抽象和渐进特征提取,捕捉复杂非线性关系。
随后,通过一个线性层融合 γ_1 和 γ_2 得到 γ_3。最后,一个评分专家模型(Scoring MoE)将 γ_3 映射并通过新的专家权重聚合,输出市场引导下的Alpha因子得分向量 γ_4 ∈ R^1xδ。
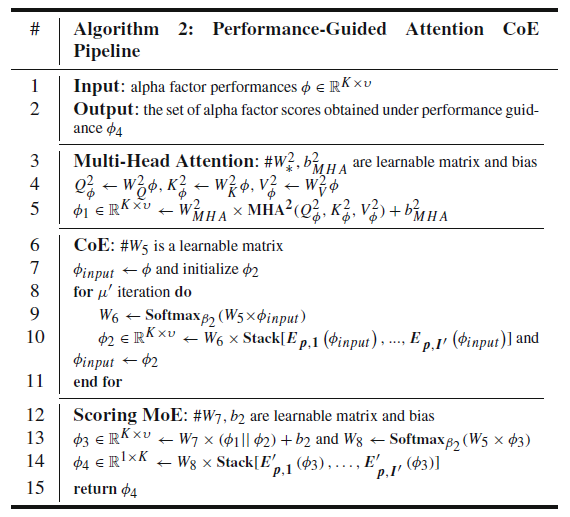
表现引导的注意力链式专家模型 (PACoE)
对于每个Alpha因子,使用滚动窗口计算其表现指标,包括:信息系数(IC)、排名信息系数(RankIC)和横截面回归斜率。通过平均得到代表向量 φ ∈ R^Kxv,其中 K 是因子数量,v 是每个因子的表现指标数量(本文为9个,由均值、标准差等统计量构成)。该向量同样送入两个并行模块:
多头注意力模块:输出 φ_1,用于发现具有协同交互作用的潜在Alpha因子组合。
链式专家模型 (CoE):专家数量 I'=2,链式深度 μ'=2,缩放系数 β_2=2。经过迭代处理,得到 φ_2,用于渐进地精炼因子表现的表示。
融合 φ_1 和 φ_2 得到 φ_3。评分专家模型 E'_p 将其映射为 φ_4,即表现引导下的Alpha因子得分向量。
因子组合
该模块动态融合MACoE和PACoE输出的得分向量 γ_4 和 φ_4。融合方式是通过一个可学习参数 α(初始化为0.5):
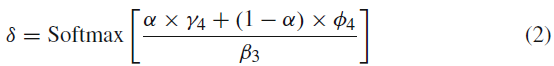
其中,δ ∈ R^1xK,β_3=3 是缩放系数。
为了在早期训练中促进探索,在融合得分向量 δ 上添加Gumbel噪声。然后执行 Top-k 操作(k值在因子池总数的0.6到1.0之间),选择最具代表性的 k 个因子,并生成一个one-hot掩码。随后,对 δ 进行掩码和归一化,得到归一化融合向量 δ_1 ∈ R^1xK:
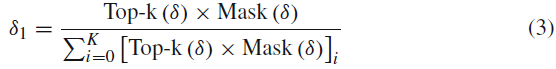
接着,δ_1 被扩展到与Alpha值向量 v ∈ R^τxKxN 相同的维度,并作为选择器实现Alpha因子的动态组合,同时应用残差连接:
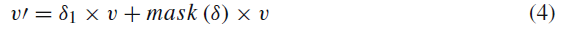
最后,输出 v' 被送入一个由单线性层实现的预测器 P(.) 进行标签回归,预测质量通过MSE损失评估。在每个滚动窗口,通过MSE损失反向传播更新可学习参数。
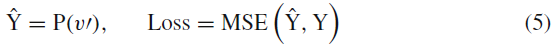
实验
实验旨在回答四个问题:
Q1: 框架是否优于最新方法?
Q2: 性能如何随Alpha因子池大小变化?
Q3: 框架各组件是否有效?
Q4: 框架在更现实的交易条件下的鲁棒性如何?
实验设置
数据集:在CSI300、CSI500和CSI800三个数据集上评估。训练、验证和测试集分别覆盖2012-01-01至2022-12-31、2023-01-01至2023-12-31和2024-01-01至2024-12-31。标签定义为“Ref(close, -20)/close - 1”,即未来20个交易日的收益率。
对比方法:与XGBoost、LSTM、Transformer、Mamba、MASTER等方法比较。为验证通用性,还使用AlphaGen (RL)、AlphaAgent (LLMs)和AlphaForge (GANs) 生成的因子池进行评估。
评估指标:使用排名指标IC、RankIC、ICIR、RankICIR,以及组合指标超额年化收益(AR)和信息比率(IR)。AR是策略年化收益减去基准年化收益,IR是AR均值除以其标准差。
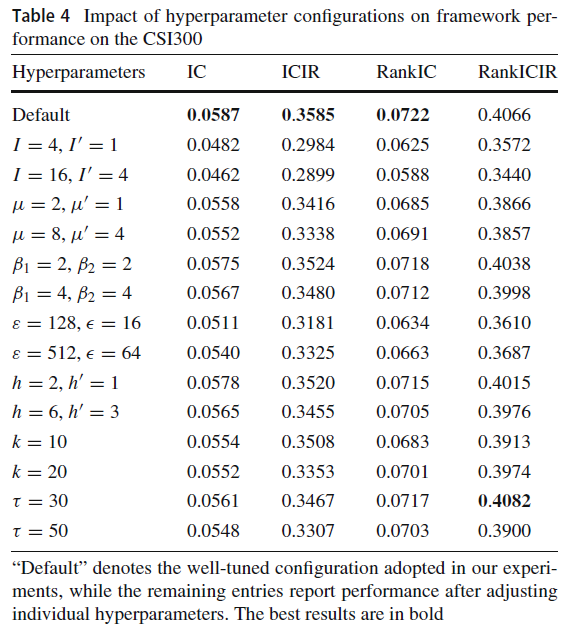
训练细节:滚动窗口 τ=40。MACoE隐藏维度 ε 从{128,256}中调优,专家数 I=8,链深度 μ=4,注意力头数从{3,4}中调优,β_1=0.5。PACoE隐藏维度 ε=32,专家数 I'=2,链深度 μ'=2,注意力头数3,β_2=2。融合部分 β_3=3。初始学习率 2 x 10^-4,训练上限20个epochs并早停。
回测设置:基于CSI 500,在2023-01-01至2025-12-01期间模拟交易。最多持有50只股票,每只股票最短持有20个交易日。每日买入排名前5的股票,卖出持仓中排名后5的股票。交易成本设定为买卖各5个基点。
总体表现
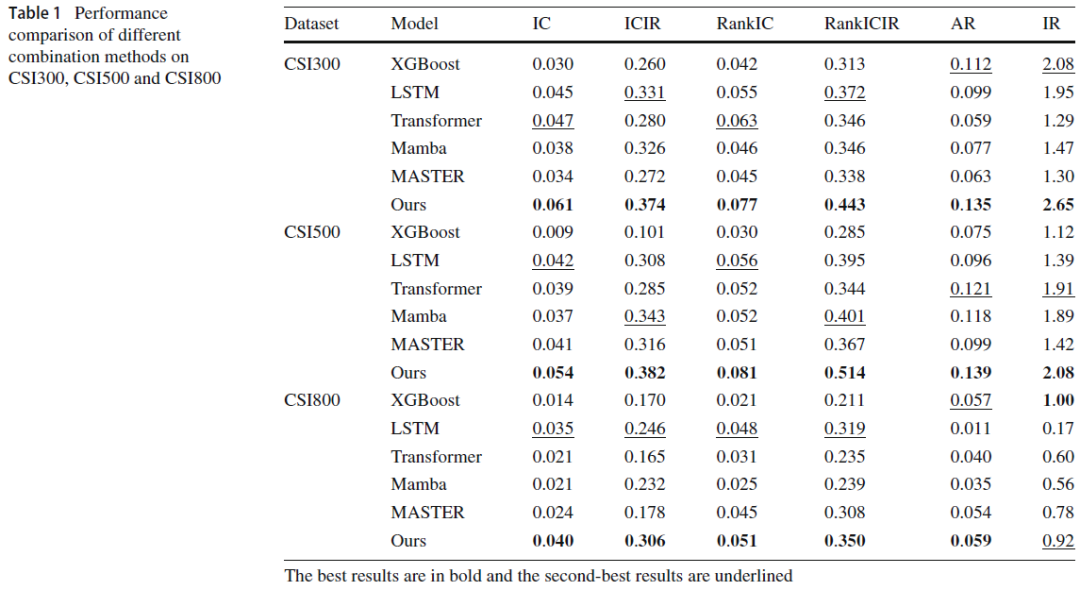
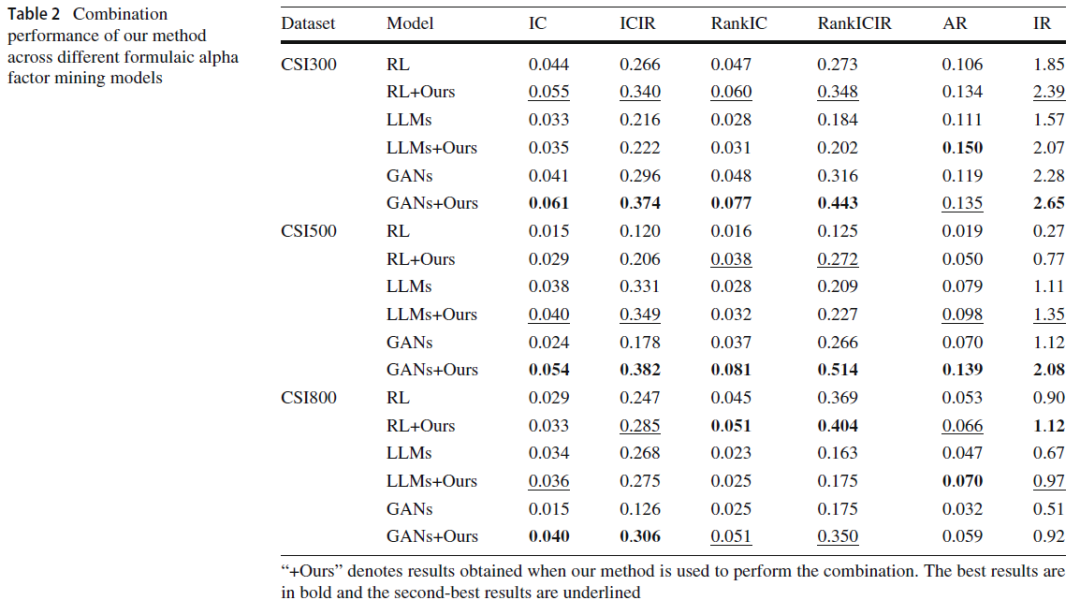
表1和表2的结果显示,在所有数据集和多种评估指标上,FactorMoE普遍优于对比方法。例如,在CSI300上,FactorMoE的IC为0.061,ICIR为0.374,RankIC为0.077,RankICIR为0.443,AR为0.135,IR为2.65,均优于其他模型。这表明该方法具有很强的因子组合能力,并能很好地泛化到不同的Alpha挖掘流程。这回答了Q1
因子池大小的影响
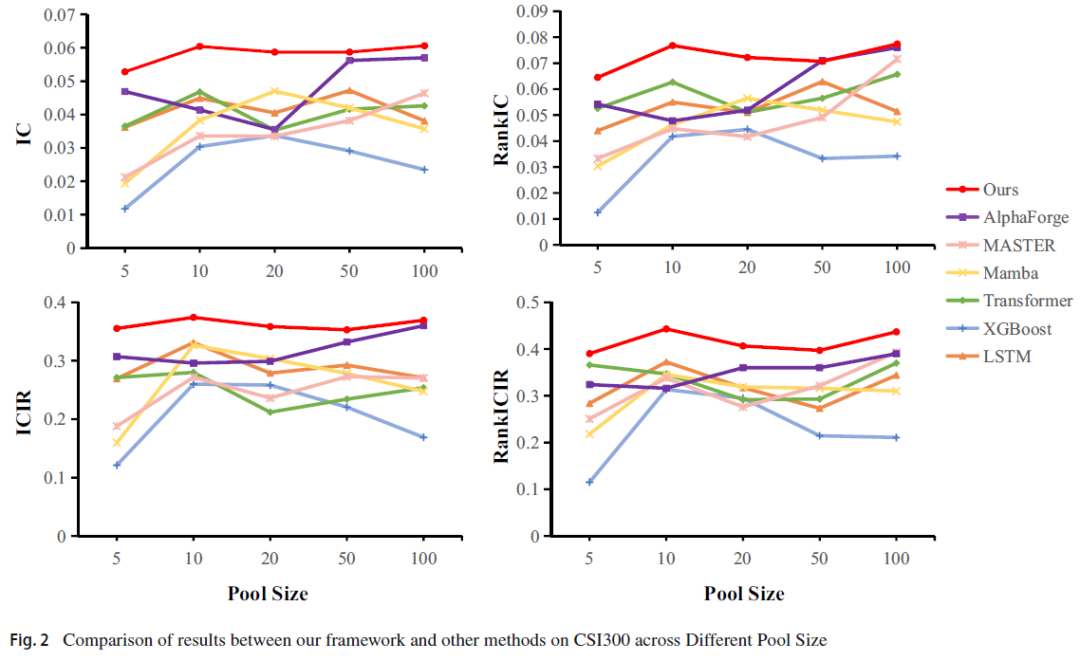
实验在因子池大小为{5,10,20,50,100}时进行评估。图2显示,性能与池大小并非单调关系。由于方法动态加权因子,它在高波动市场条件下也能稳定地选择协同性和鲁棒性强的Alpha因子,因此在不同池大小下均表现出稳定的性能,甚至在因子池较小时也表现优异。这回答了Q2。
消融实验
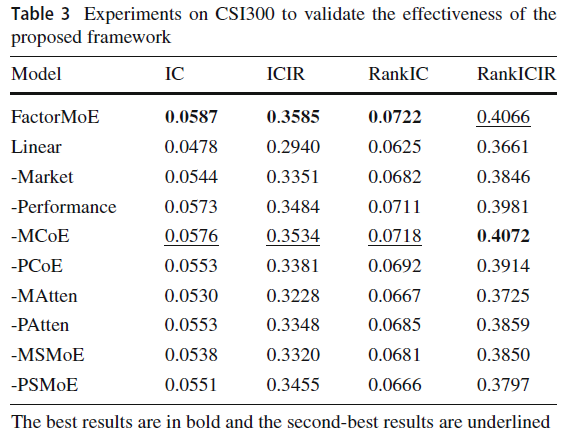
通过9种消融设置来验证各组件贡献,包括移除MACoE、PACoE、CoE子模块、多头注意力子模块和评分MoE子模块等。表3的结果显示,移除任何组件都会导致性能下降,只有保留所有组件时模型性能最佳。例如,完整的FactorMoE模型IC为0.0587,ICIR为0.3585,RankIC为0.0722,RankICIR为0.4066,均高于任何消融版本。这回答了Q3。
案例研究
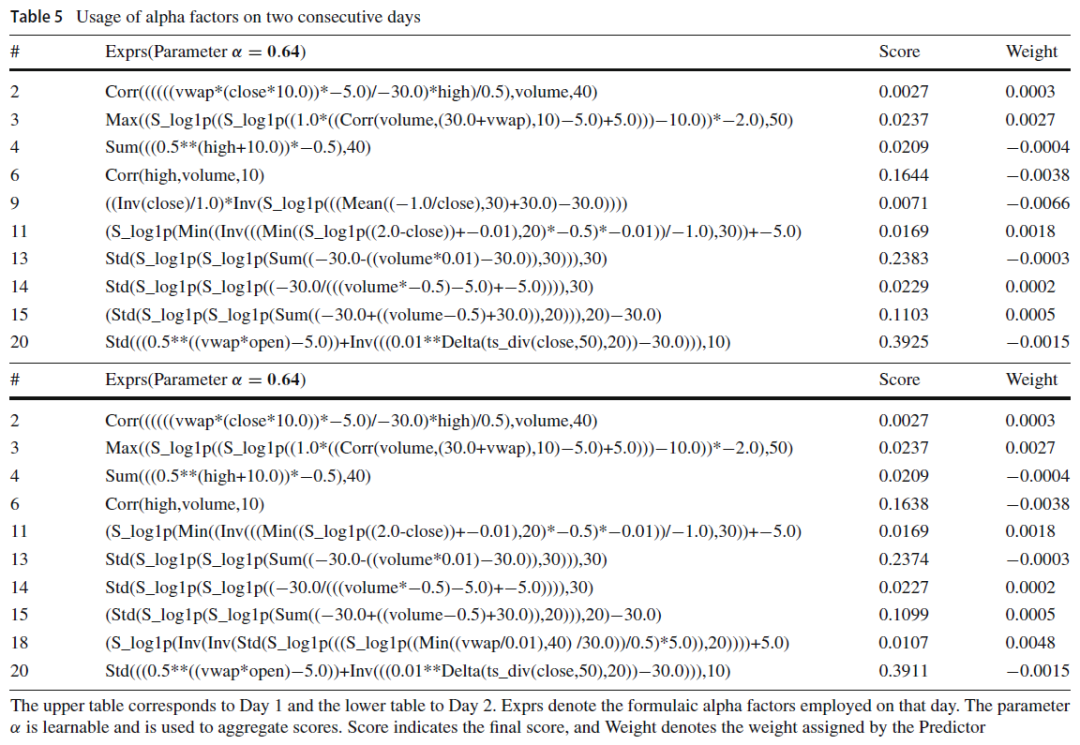
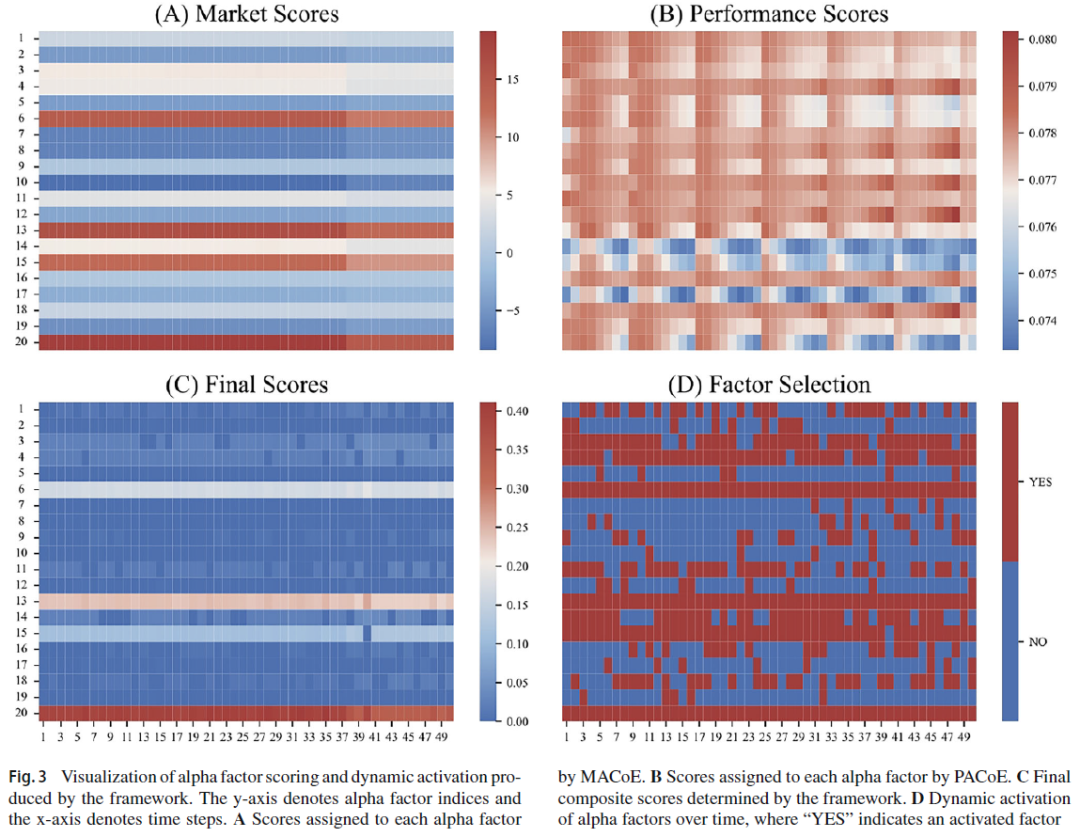
表5展示了在连续两个交易日中,框架如何动态选择因子并分配权重。例如,“Corr(high,volume,10)”这个因子的得分和权重会发生变化。图3通过50个交易日的可视化,展示了MACoE、PACoE分配的得分、最终得分以及因子的动态激活状态。这证明了框架的动态性,并增强了可解释性。
投资模拟
图4展示了模拟交易的结果。与CSI500指数以及其他模型相比,FactorMoE在回测期间表现出最佳的整体收益,尤其是在市场下跌时能有效降低下行风险,在上涨时能获取可观收益。例如,到2026年1月,Ours的累计回报约为65%,而LSTM约为30%,CSI500指数约为10%。这证明了其在实际市场中的稳健适应性,回答了Q4。
总结
本文介绍了FactorMoE,一个用于组合Alpha因子的新颖框架,为投资者提供了一个实用的选股工具。FactorMoE引入了链式专家模型、注意力机制、评分专家模型和门控网络。通过将市场状态指标和Alpha因子表现整合到因子表示中,该框架实现了Alpha因子的动态组合。大量实验表明,FactorMoE在保留公式化Alpha因子可解释性的同时,达到了与深度学习模型相当的性能。在模拟交易中,FactorMoE能有效适应市场波动,并获得卓越的回报。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
