阶跃发布端侧全家桶,1加N架构100毫秒本地调用
阶跃刚刚发布 Step Edge 系列模型。
Step Edge 将文本视觉基础模型、音频理解与 ASR、GUI 理解与操作、图像生成与编辑四个领域,打包成了 1 加 N 的端侧全家桶。
本地工具调用最低跑到 100 毫秒,简单任务留在端侧,复杂任务交回云端,真正实现实时响应、数据隐私和推理成本兼得。
整套 Step Edge 由一个文本加视觉的基础模型 Step Edge 担纲,向外挂载 Step Edge Audio、Step Edge GUI、Step Edge Gen 三个多模态专项模型,配合自研 Step Inference NPU(神经网络处理单元)引擎,覆盖手机和车载场景下的文本、视觉、语音、GUI 和图像生成需求。
基础模型在 GUI 定位、工具调用、App 代理多个端侧关键基准上拿到同体量第一。
音频模型在 MMSU、MMAR、WildSpeech 等基准上全面超过同尺寸 MiniCPM-o-4.5 和更大尺寸 Gemma-4-12B。
图像模型在 W8A16(8 位权重 16 位激活量化)下文生图约 3 秒、图像编辑约 4.5 秒,端到端延迟和 prefill(预填充)吞吐对比同体量开源模型普遍领先 1.47 到 5.29 倍。
1 加 N 的全家桶
阶跃给 Step Edge 的整体设计取名 1 加 N 架构。
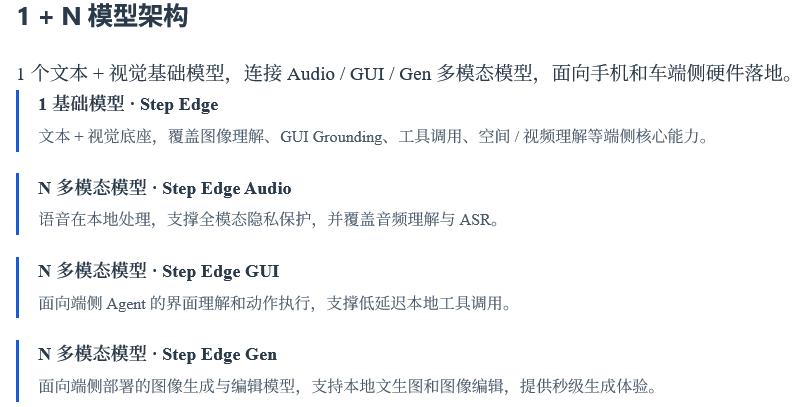
1 是一个文本加视觉的基础模型 Step Edge,覆盖图像理解、GUI 定位、工具调用、空间推理、视频理解等端侧最常用的能力。
N 是若干个多模态专项模型,目前包括 Step Edge Audio、Step Edge GUI、Step Edge Gen 三个,分别处理语音、界面操作和图像生成。
整套架构面向手机和车机两类硬件设计。阶跃把端侧模型的价值归纳成三条,实时本地响应、数据隐私保护、推理成本优化。模型从云端搬到本地,响应不用等网络,数据不出设备,弱网下助理不卡顿,敏感照片不必上传,频繁调用的简单任务不烧云端 token。
本地工具调用最低跑到 100 毫秒,文本、视觉、语音全部端上处理。简单任务留在本地,复杂任务交回云端,端云协同分工。手机助理、车载交互、本地自动化场景都能从中受益。
1 加 N 的好处在于扩展性。底座模型负责通用感知和推理,专项模型负责长板能力,可以独立升级。
音频、GUI、生成三个方向的技术栈和训练数据差异较大,分开训练比硬塞进一个模型更高效,部署时也方便按场景裁剪。1 加 N 的拆分让每个模型保持小体量,又能在需要时协同工作。
基础模型打硬仗
Step Edge 是整个系列的基础模型,文本加视觉,定位手机、车机和其它端侧场景。
能力覆盖图像理解、GUI 定位、工具调用、空间推理、视频理解。模型可以理解屏幕内容,定位 UI(用户界面)元素,提取文本和视觉信息,做空间推理,本地执行多轮工具调用,支持端侧助理、车载交互和本地自动化,在低延迟、隐私敏感或弱网条件下都能用。
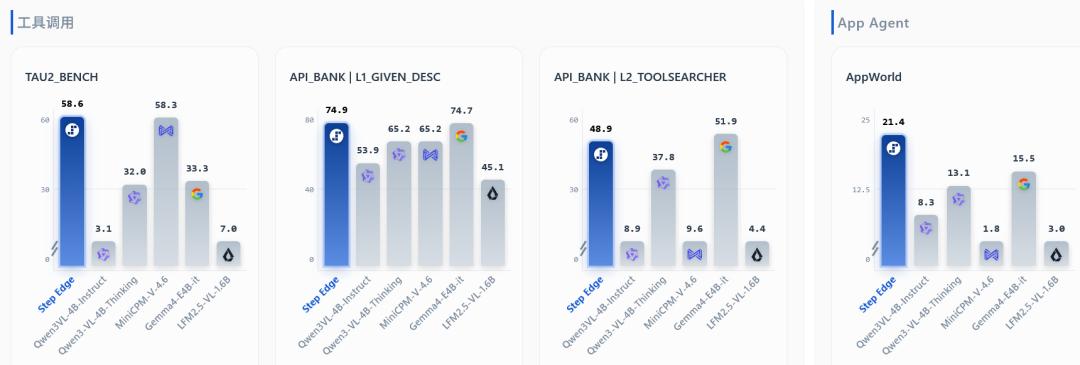
阶跃在内部平台对 Step Edge 和 5 个同体量开源模型做了横向对比,包括 Qwen3VL-4B-Instruct、Qwen3-VL-4B-Thinking、MiniCPM-V-4.6、Gemma4-E4B-it、LFM2.5-VL-1.6B,覆盖图像理解、GUI 定位、OCR(光学字符识别)、视频理解、空间推理、工具调用、App 代理 7 个大类共 16 项基准。
16 项基准里 Step Edge 在 OSWORLD_G、SCREENSPOT_V2、MVBenchMP4、MINDCUBE_MINI、OMNISPATIAL、TAU2_BENCH、API_BANK L1_GIVEN_DESC、AppWorld 等 8 项拿到第一,GUI 定位、工具调用和 App 代理三个端侧关键大类优势明显。
GUI 定位方面,Step Edge 在 OSWORLD_G 拿到 64.71 分,比 Qwen3VL-4B-Instruct 高 1.18 分,比 Qwen3-VL-4B-Thinking 高 8.24 分,比 MiniCPM-V-4.6 高出 32.75 分。SCREENSPOT_V2 拿到 93.08 分,刷新同体量开源模型最佳。两项直接对应端侧 Agent(智能体)能不能准确点中屏幕按钮、找到界面元素。
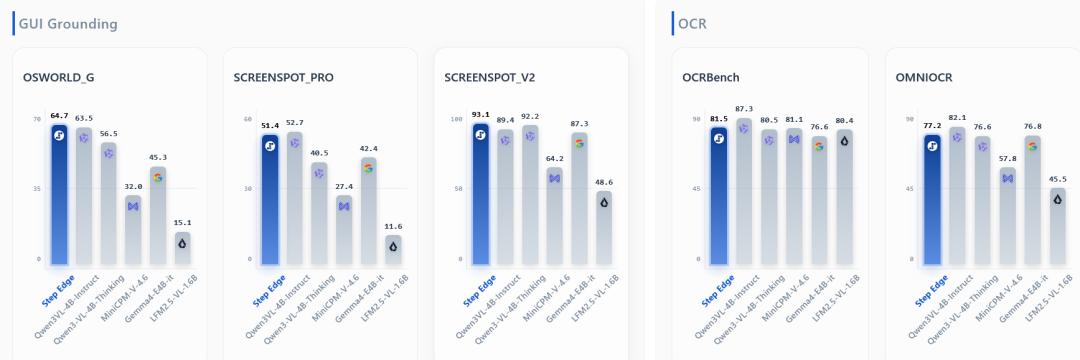
工具调用方面,Step Edge 在 TAU2_BENCH 拿到 58.59 分,Qwen3VL-4B-Instruct 只有 3.07 分,差距悬殊。API_BANK L1_GIVEN_DESC 上 Step Edge 拿到 74.94 分,L2_TOOLSEARCHER 上拿到 48.89 分居第二,仅落后 Gemma4-E4B-it 的 51.85 分。AppWorld 上 Step Edge 拿到 21.43 分,是同体量开源模型的 1.4 到 12 倍。
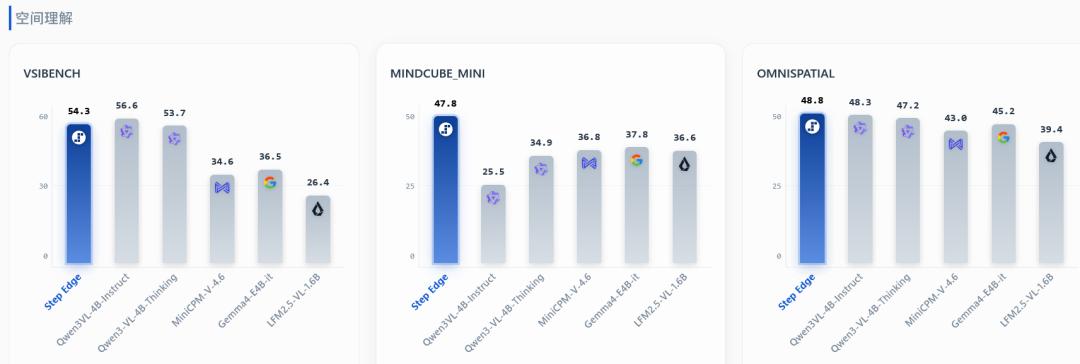
空间推理方面,Step Edge 在 MINDCUBE_MINI 拿到 47.83 分,比第二名 Qwen3-VL-4B-Thinking 高 12.91 分。OMNISPATIAL 拿到 48.79 分居首。VSIBENCH 略低于 Qwen3VL-4B-Instruct,整体仍处于同体量第一梯队。
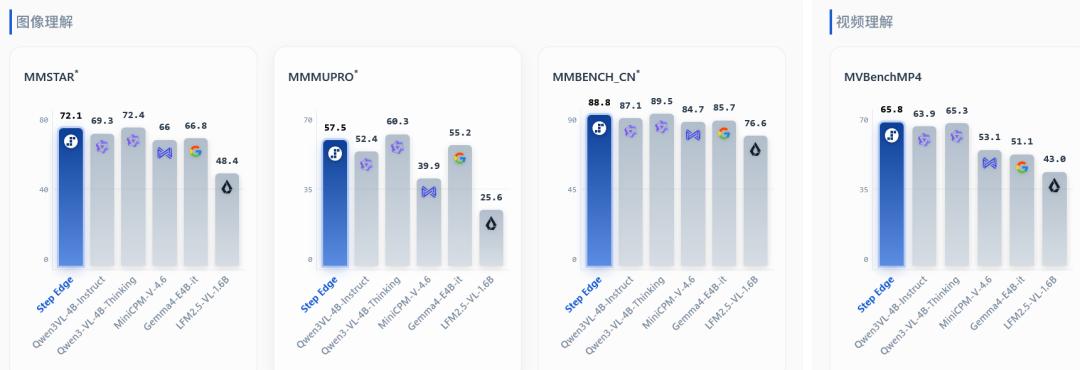
OCR 和图像理解两项,Step Edge 排名中游。OCRBench 81.50 分,OMNIOCR 77.15 分,落后 Qwen3VL-4B-Instruct。MMSTAR 72.09 分,MMMUPRO 57.50 分,MMBENCH_CN 88.79 分,与 Qwen3-VL-4B-Thinking 互有胜负。
视频理解方面,Step Edge 在 MVBenchMP4 拿到 65.80 分,领先所有对比模型。
三位专项选手各显身手
Step Edge Audio 处理语音,覆盖音频理解和 ASR(自动语音识别)。
模型体量紧凑,在音频感知、语音语义推理和通用场景识别上领先同体量。
在 MMSU、MMAR、Step-Caption、WildSpeech 等真正考验模型对声学音频内容理解能力的基准上,Step Edge Audio 全面超过同尺寸 MiniCPM-o-4.5 和更大尺寸 Gemma-4-12B。
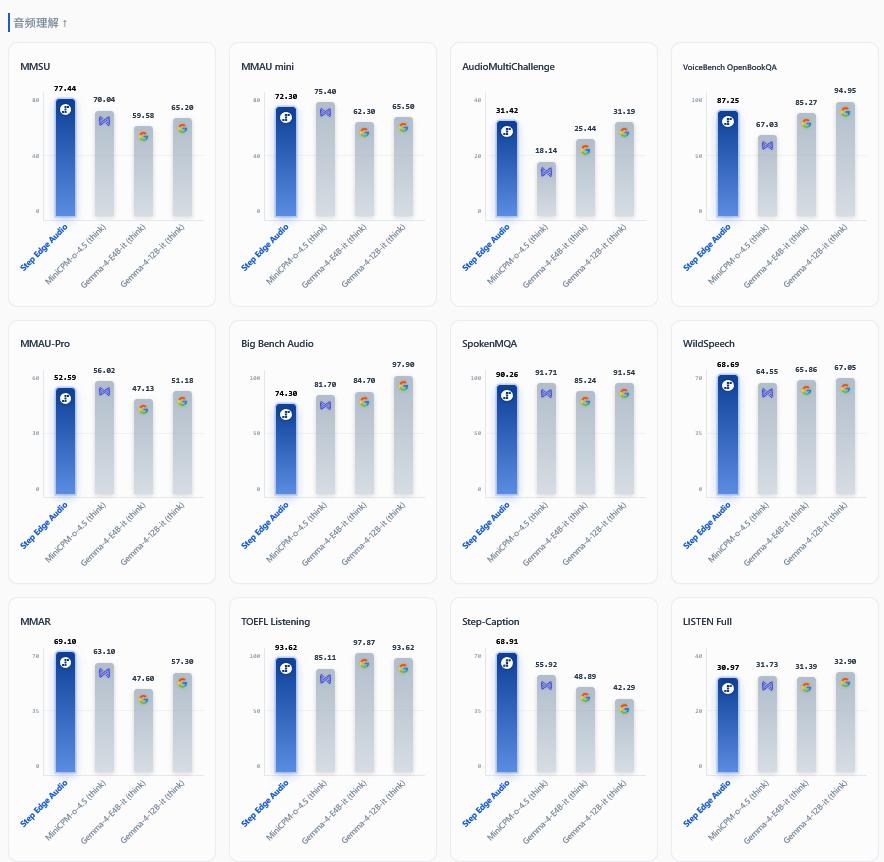
MMSU 衡量通用音频理解,MMAR 衡量音频推理,Step-Caption 测试音频描述能力,WildSpeech 覆盖真实嘈杂语音场景,四项基准把感知、推理、描述、鲁棒性都覆盖到。同体量能全面压住更大尺寸的 Gemma-4-12B,说明 Step Edge Audio 在音频理解上的训练数据和方法有针对性优化。
语音识别覆盖朗读语音、近场语音、网络音频、远场会议、带口音众包语音多个场景。
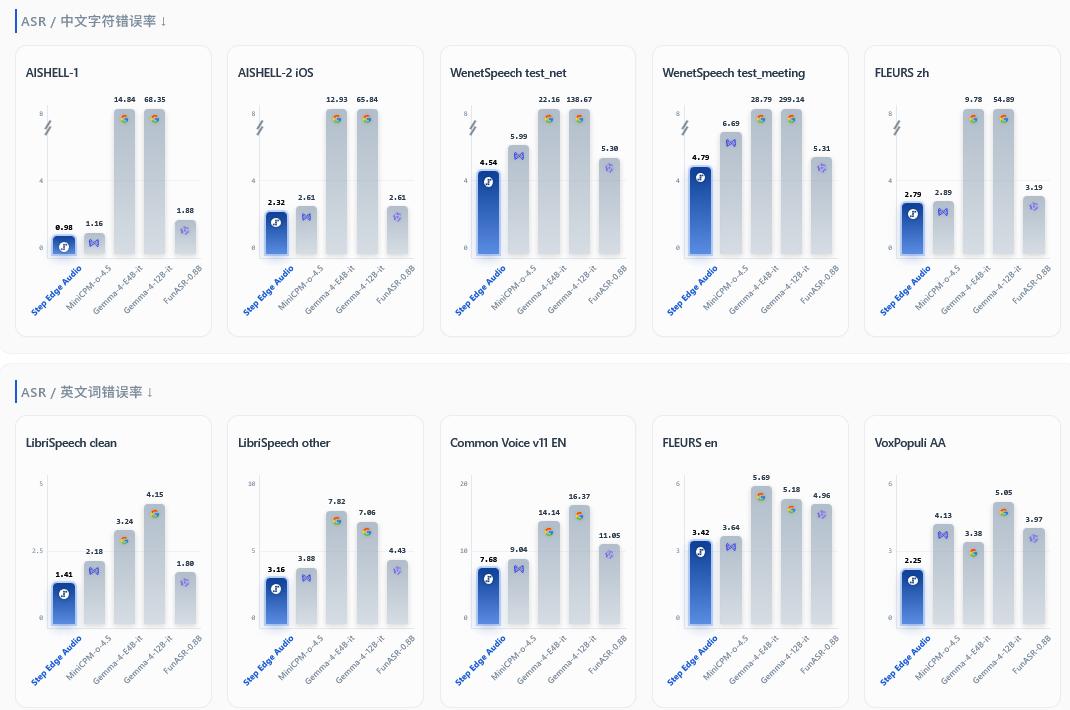
中文 CER(字符错误率)约 3.1%,英文 WER(词错误率)约 3.6%,大幅领先同体量通用模型,达到专用 ASR 模型水平。
Step Edge GUI 面向端侧本地闭环 GUI Agent 任务,支持桌面和移动环境的界面理解、定位和动作执行。
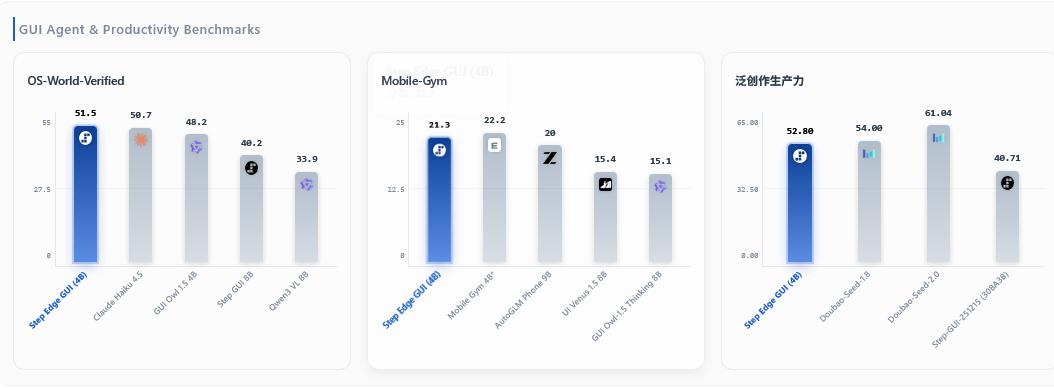
OS-World-Verified 衡量电脑使用能力,要求模型理解屏幕截图、规划操作步骤、生成可执行动作,Step Edge GUI 在同体量模型中领先,超过 Claude Haiku 4.5。Mobile-Gym 模拟微信、小红书等日常 App 环境,Step Edge GUI 在小尺寸端侧模型里保持竞争力。
内部创意生产力基准覆盖小红书、抖音、美图、剪映等 App 的真机工作流,Step Edge GUI 接近 Doubao-Seed-1.8,相对 Step-GUI-251215 大幅提升。
OS-World-Verified 上超过 Claude Haiku 4.5,说明 4B 体量的端侧 GUI 模型已经能跟更大的云端模型掰手腕。
Step Edge Gen 是图像生成和编辑模型,在端侧部署约束下开发。
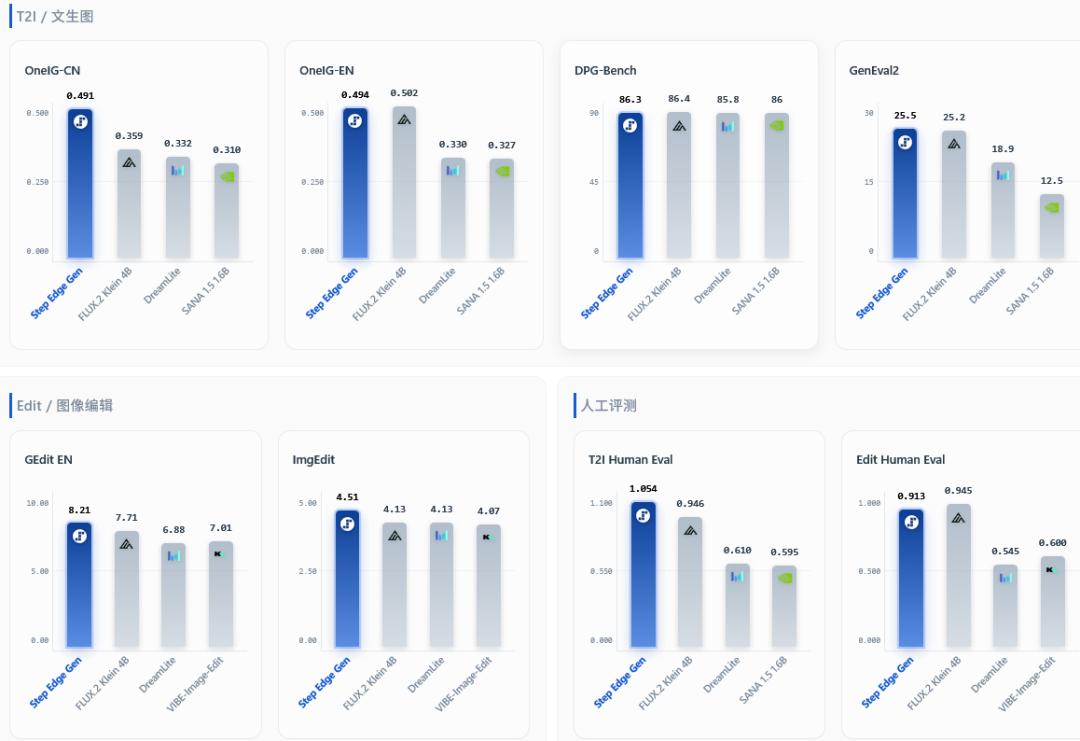
W8A16 量化下,文生图约 3 秒,图像编辑约 4.5 秒。端侧图像生成最大瓶颈是显存和延迟,W8A16 把权重量化到 8 位、激活保持 16 位,平衡精度和速度,3 秒级文生图让端侧生成可用,4.5 秒级图像编辑让局部修改体验流畅。
人工对比 FLUX.2 Klein 4B,Step Edge Gen 在多个评估维度上匹配或超过云端 4B 生成模型。
端侧推理真能跑
阶跃还把 Step Edge 配上自研 Step Inference NPU 引擎,针对终端硬件优化。
文本、视觉、语音三类输入下,Step Edge 把模型能力换算成更低的端到端延迟,1024 token 文本输入约 4.33 秒,768 分辨率图像理解约 5.61 秒,30 秒语音输入约 10.72 秒,prefill 吞吐最高 1395 token 每秒。
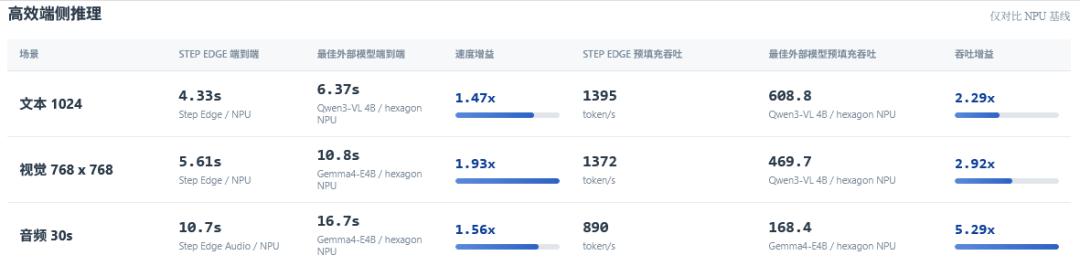
prefill 吞吐反映模型处理输入的速度,token 每秒越高越快,Step Edge 三类输入的 prefill 吞吐都领先同体量模型 2.29 到 5.29 倍,用户等待第一次响应的时间大幅缩短。
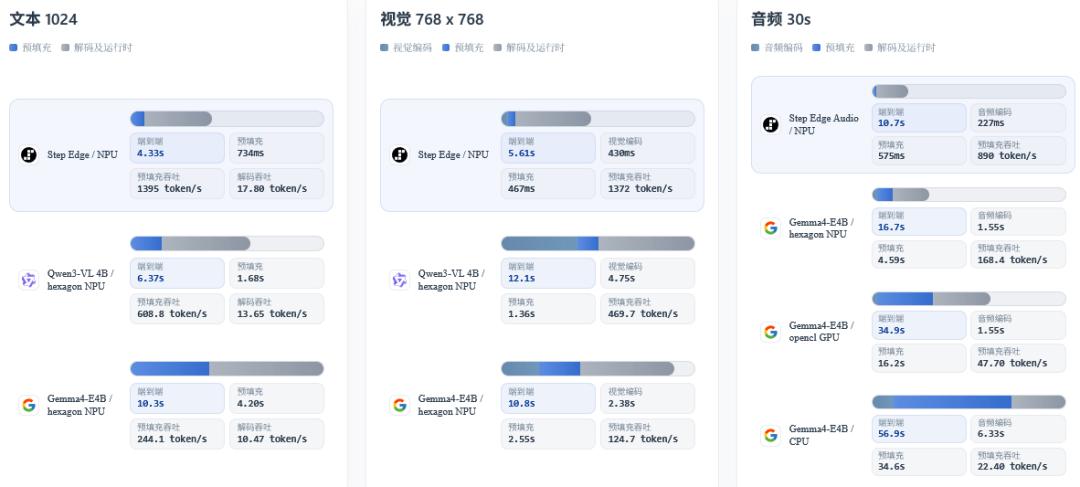
文本 1024 token 场景下,Step Edge 端到端 4.33 秒,其中 prefill 734 毫秒,吞吐 1395 token 每秒,decode(解码)吞吐 17.80 token 每秒。对比 Qwen3-VL 4B 在 hexagon NPU 上端到端 6.37 秒,prefill 1.68 秒,吞吐 608.8 token 每秒,decode 13.65 token 每秒。Gemma4-E4B 在 hexagon NPU 上端到端 10.3 秒,prefill 4.20 秒,吞吐 244.1 token 每秒。
视觉 768 乘 768 场景下,Step Edge 端到端 5.61 秒,其中视觉编码器 430 毫秒,prefill 467 毫秒,吞吐 1372 token 每秒。Qwen3-VL 4B 端到端 12.1 秒,视觉编码器 4.75 秒。Gemma4-E4B 端到端 10.8 秒,视觉编码器 2.38 秒。Step Edge 在视觉编码器和 prefill 两个阶段都明显更快。
音频 30 秒场景下,Step Edge Audio 端到端 10.7 秒,音频编码器 227 毫秒,prefill 575 毫秒,吞吐 890 token 每秒。Gemma4-E4B 在 hexagon NPU 上端到端 16.7 秒,音频编码器 1.55 秒,prefill 4.59 秒,吞吐 168.4 token 每秒。同模型跑在 opencl GPU 上端到端 34.9 秒,跑在 CPU 上 56.9 秒。NPU 路径相对 GPU 加速 3.27 倍,相对 CPU 加速 5.32 倍。
对端侧 Agent 来说,推理引擎给本地响应、屏幕理解、语音交互和工具调用提供了更实用的实时基础。
100 毫秒级别的本地工具调用,加上秒级的图像理解和语音处理,让端侧模型不再只是 Demo 摆设。
端侧硬件潜力,配合模型架构和量化策略,端侧体验已接近实用门槛。
参考资料:
https://static.stepfun.com/blog/step-edge/