具身智能万字综述:从大语言模型到世界模型
具身智能(Embodied Artificial Intelligence, Embodied AI)是实现通用人工智能(Artificial General Intelligence, AGI)的智能系统范式,是各类应用的基石,并驱动着从数字空间到物理系统的演进。近年来,大语言模型(Large Language Models, LLMs)和世界模型(World Models, WMs)的突破引起了具身智能领域的广泛关注。一方面,LLM通过语义推理和任务分解赋能具身智能,将高层次自然语言指令和低层次自然语言动作融入具身认知。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
另一方面,WM通过构建外部世界的内部表征和未来预测赋能具身智能,促进遵循物理定律的具身交互。为此,本文从基础到前沿全面探讨具身智能的研究文献,涵盖LLM驱动和WM驱动的工作。具体而言,我们首先介绍具身智能的历史、关键技术、关键组成部分和硬件系统,并从单模态到多模态的视角讨论其发展历程。
随后,我们审视了具身智能的两个新兴领域,即基于LLM/多模态大语言模型(Multimodal LLMs, MLLMs)的具身智能和基于WM的具身智能,细致地阐述了它们在端到端具身认知和物理定律驱动的具身交互中不可或缺的角色。基于上述进展,文章进一步分享了关于MLLM-WM联合驱动的具身智能架构必要性的见解,阐明其在实现物理世界中复杂任务方面的深远意义。此外,文章考察了具身智能的代表性应用,展示了其在真实场景中的广泛适用性。最后但同样重要的是,文章指出了具身智能值得进一步研究的未来方向。
第一节 引言(I. Introduction)
具身智能(Embodied AI)起源于图灵提出的具身图灵测试(Embodied Turing Test)[1],旨在探索智能体是否能模仿人类智能以实现通用人工智能(AGI)。其中,仅在数字世界(网络空间)中解决抽象问题的智能体通常被定义为非具身智能(disembodied AI),而那些能够与物理世界交互的智能体则被视为具身智能。具身智能建立在认知科学和神经科学的基础洞见之上[2], [3],这些学科认为智能源于感知、认知和交互的动态耦合。
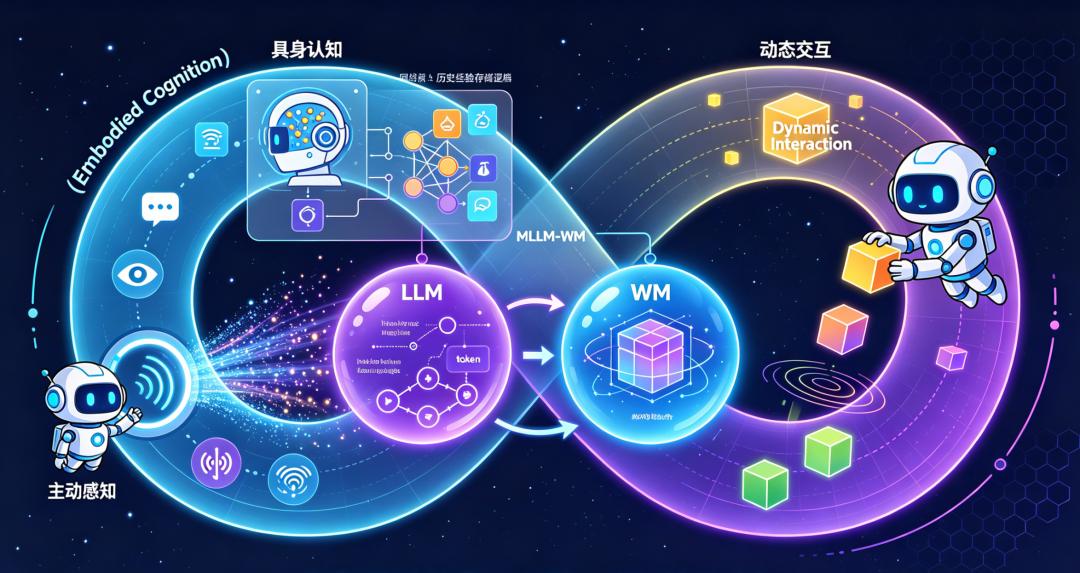
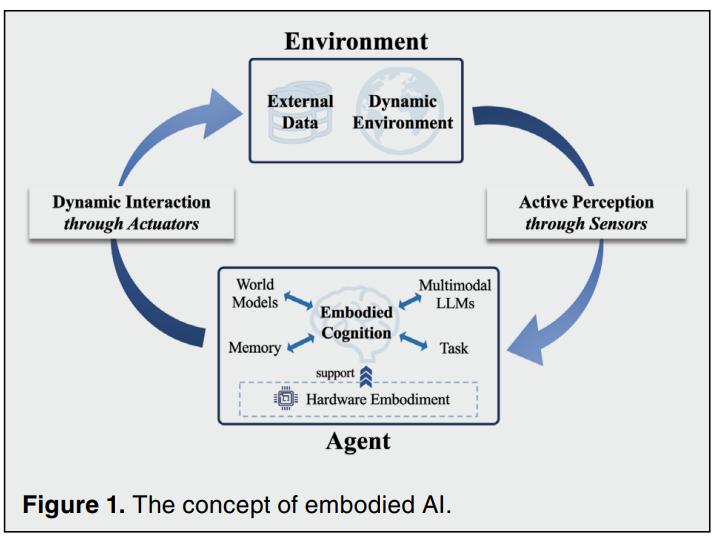
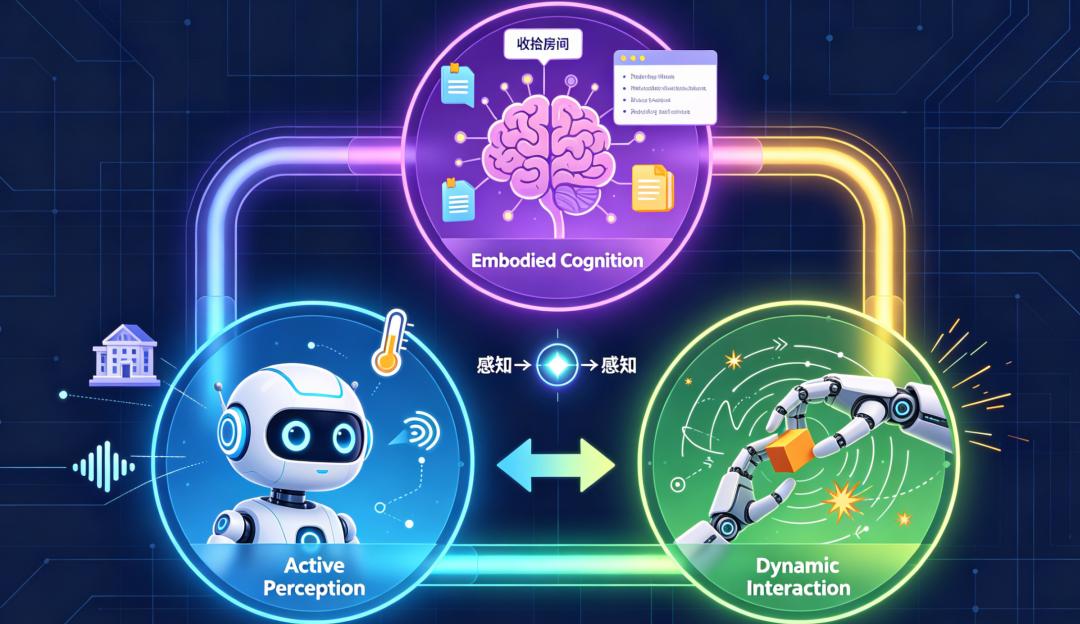
如图1所示,具身智能以闭环方式包含三个关键组成部分:1)主动感知(active perception,传感器驱动的环境观测),2)具身认知(embodied cognition,历史经验驱动的认知更新),以及3)动态交互(dynamic interaction,执行器介导的动作控制)。此外,硬件具身(hardware embodiment)[4], [5], [6]也至关重要,因为计算和能耗需求不断攀升,特别是在真实世界部署场景中设备的延迟和功耗约束下。
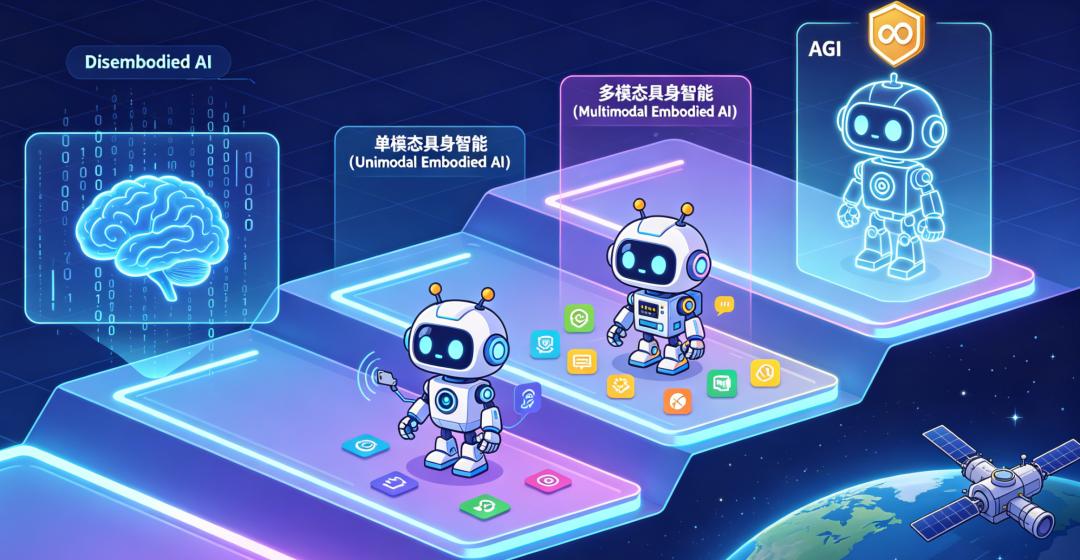
具身智能的发展经历了从单模态到多模态范式的演进。在早期阶段,具身智能主要通过关注单一模态(如视觉、语言或动作)的各个独立组件来研究,其中感知、认知或交互组件由单一感官输入驱动[7], [8],例如,感知往往以视觉模态为主[9],认知往往以语言模态为主[10], [11],交互往往以动作模态为主[12], [13]。虽然这些方法在单个组件内表现良好,但它们受限于每种模态提供的信息范围狭窄以及跨组件的模态间固有鸿沟。具身智能的持续发展见证了单模态方法的局限性,推动了向多感官模态整合的重大转变[14], [15], [16]。因此,多模态具身智能[17], [18]自然应运而生,以创建更具适应性、灵活性和鲁棒性的智能体,能够在动态环境中执行复杂任务。
大语言模型(LLMs)通过语义推理[19]和任务分解[20], [21]赋能具身智能,将高层次自然语言指令和低层次自然语言动作融入具身认知。代表性的LLM驱动工作包括SayCan [22],它i)提供了一个真实世界预训练的自然语言动作库,以约束LLM提出不可行或上下文不适当的动作;ii)使用LLM将自然语言指令转换为自然语言动作序列;iii)利用价值函数验证自然语言动作序列在特定物理环境中的可行性。这些工作表明,LLM对于旨在执行以自然语言表达的高层次、时间上延伸的指令的机器人极为有用。然而,LLM只是整个具身智能系统的一部分(例如具身认知),受限于固定的自然语言动作库和特定的物理环境,使得LLM驱动的具身智能难以实现对新机器人和新环境的自适应扩展。
最近,多模态大语言模型(MLLMs)[23], [24]和世界模型(WMs)[25], [26], [27]的突破开辟了具身智能研究的新前沿。MLLM可以作用于整个具身智能系统,将高层次多模态输入和低层次运动动作序列桥接到端到端的具身应用中。语义推理[28], [29], [30]利用MLLM的跨模态理解能力从视觉、听觉或触觉输入中解释语义,例如识别物体、推断空间关系、预测环境动态。与此同时,任务分解[31], [32], [33]利用MLLM的顺序逻辑将复杂目标分解为子任务,同时基于传感器反馈动态调整计划。然而,MLLM往往难以将预测建立在物理合规的动态之上[34],并表现出对环境反馈的实时适应能力不足[35]。
另一方面,WM通过构建外部世界的内部表征[36], [37], [38], [39], [40]和进行未来预测[41], [42], [43], [44]赋能具身智能。这种WM驱动的具身智能能够在动态环境中促进遵循物理定律的具身交互。内部表征将丰富的感官输入压缩为结构化的潜在空间,捕捉物体动态、物理定律和空间结构,并使智能体能够推理其周围环境中"存在什么"以及"事物如何行为"。同时,未来预测模拟在符合物理定律的多个时间尺度上的动作序列的潜在奖励,从而预先规避有风险或低效的行为。然而,WM驱动的方法在开放式语义推理方面存在困难[45],并且缺乏在没有明确先验的情况下进行可泛化任务分解的能力[26]。
基于上述进展,我们进一步分享了关于开发MLLM-WM联合驱动的具身智能架构必要性的见解,阐明其在实现物理世界中复杂任务方面的深远意义。MLLM使能上下文任务推理但忽视物理约束,而WM擅长物理感知模拟但缺乏高层次语义。MLLM与WM的联合可以将语义智能与基于物理的交互桥接起来。例如,EvoAgent [46]设计了一种具有MLLM-WM联合驱动的具身智能架构的自主进化智能体,能够通过自我规划、自我反思和自我控制,在无人干预的情况下自主完成跨环境的各种长周期任务。我们相信,设计MLLM-WM联合驱动的具身智能架构将主导下一代具身系统,桥接专用AI智能体和通用物理智能之间的鸿沟。
我们总结了具身智能的代表性应用,如服务机器人、救援无人机、工业机器人等,展示了其在真实场景中的广泛适用性。我们还指出了具身智能的潜在未来方向,包括但不限于自主具身智能、具身智能硬件和群体具身智能等。
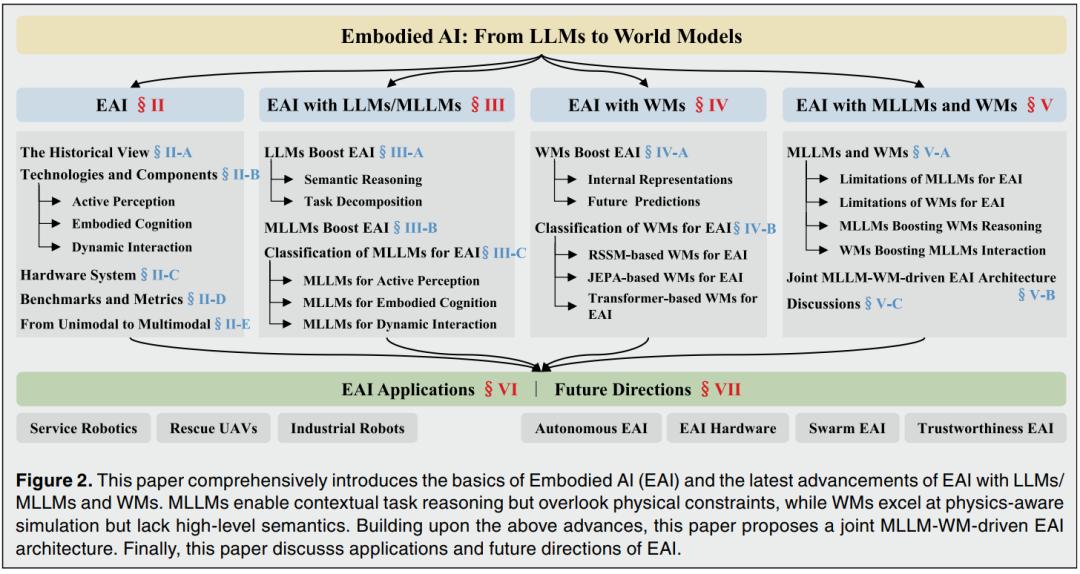
如图2所示,本文其余部分的组织如下:第二节介绍具身智能的历史、关键技术、关键组成部分和硬件系统,讨论具身智能从单模态到多模态的发展。第三节介绍基于LLM/MLLM的具身智能,第四节介绍基于WM的具身智能。第五节介绍我们关于设计MLLM-WM联合驱动的具身智能架构的见解。第六节简要考察具身智能的应用。第七节讨论潜在的未来方向。
第二节 具身智能(II. Embodied AI)
本节提供具身智能的全面概述。我们首先在第II-A节从历史视角介绍具身智能的发展。基于与具身智能相关的五个基础领域的技术进步,第II-B节和第II-C节进一步回顾了软件算法和硬件设计中核心模块的发展轨迹。最后,第II-E节讨论了从单模态到多模态发展方向的整体分析。
A. 历史视角(The Historical View)
具身智能的历史演变反映了从早期哲学基础到机器人技术突破和学习驱动范式兴起的连续转型,而近来LLM和WM的进展正在推动向下一阶段发展的持续转变。
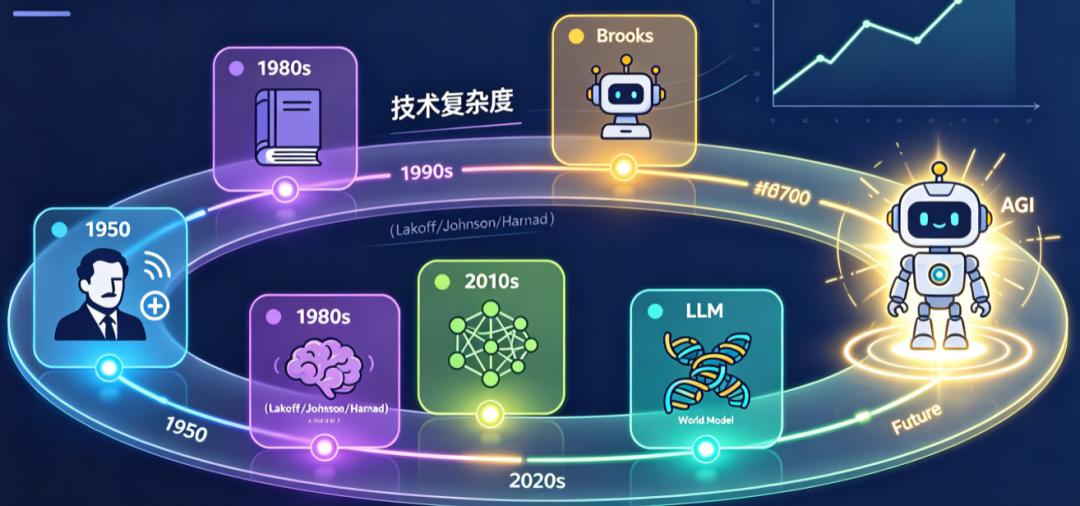
具身智能的理论根源可追溯至1950年,当时图灵提出了智能本质上与物理经验相联系的奠基性思想[1]。在20世纪80年代,认知科学进一步形式化了这一观点。Lakoff和Johnson强调人类认知源于身体经验而非脱离身体的符号计算[47],而Harnad的符号接地问题(symbol grounding problem)强调了将符号表征连接到感觉-运动现实的必要性[48]。20世纪80年代末和90年代机器人技术的进步将这些思想付诸实践。Brooks提出了包容架构(subsumption architecture)[49], [50],通过基于感觉运动回路的分层反应模块推广基于行为的控制。Cog项目[51]通过构建能够发展性学习、模仿和社交交互的仿人机器人推进了这一路线。最近,学习驱动范式的成功推动了具身智能从机器人运动控制向自适应交互的转变[52]。特别是,深度学习的发展使机器人能够学习从原始传感器数据到动作策略的复杂非线性映射,显著改善了导航和操作任务[53], [54]。
虽然具身智能取得了显著进展,但在动态、不确定的环境中实现自我反思智能仍然是一个关键挑战。LLM/MLLM [23], [24]和WM [25], [26], [27]的最新进展逐渐显示出克服这些挑战的潜力。
B. 关键技术与组成部分(The Key Technologies and Components)
在讨论正在发生的变化之前,我们系统地回顾关键技术和组成部分的发展。
1)具身智能的关键技术
具身智能的快速发展与基础技术模型的进步密切相关,如计算机视觉(Computer Vision, CV)模型、自然语言处理(Natural Language Processing, NLP)模型、强化学习(Reinforcement Learning, RL)模型、LLM/MLLM和WM(如图3所示),这些技术可以显著增强智能体在感知、认知和交互方面的能力。
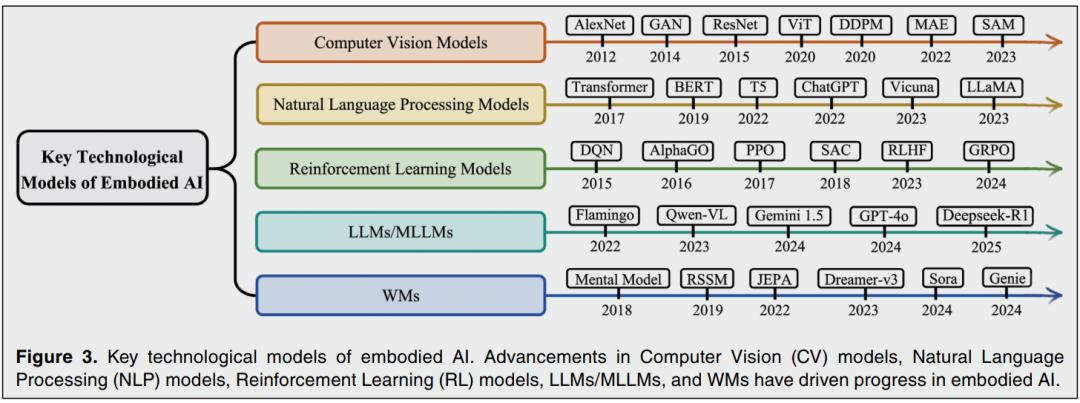
具体而言,经典的计算机视觉模型,如AlexNet [55]、GAN [56]、ResNet [57]、ViT [58]、DDPM [59]、MAE [60]和SAM [61],为具身智能体在复杂环境中解释高维感官输入提供了感知基础。在NLP领域,从基础架构如Transformer [62]、BERT [63]和T5 [64]到大规模系统如ChatGPT [65]、Vicuna [66]和LLaMA [67]的演进,赋予了具身智能体更强的语言理解、任务规划和指令遵循能力。RL为智能体通过与环境的交互学习提供了核心算法框架。代表性方法包括DQN [68]、AlphaGo [69]、PPO [70]、SAC [71]、RLHF [72]和GRPO [73]。
除了这些经典领域,具身智能最有前景的方向之一在于LLM/MLLM与WM的整合。LLM和MLLM(如Flamingo [20]、Qwen-VL [74]、Gemini-1.5 [75]、GPT-4o [76]和Deepseek-R1 [77])为智能体提供了理解指令、对多模态输入进行推理以及跨任务和环境推广的能力。相比之下,WM(如Mental Model [26]、RSSM [78]、JEPA [27]、Dreamerv3 [79]、Sora [80]和Genie [36])使智能体能够建模和预测环境动态,支持基于想象的规划和在动态、不确定环境中的预见性决策。
2)具身智能的关键组成部分
在这些关键技术的驱动下,具身智能经历了快速进展。接下来,我们对三个关键组成部分的发展进行结构化概述。
a) 主动感知(Active Perception): 主动感知是指智能体从环境观测中有选择地获取信息[16], [81], [82]。现有的主动感知方法大致可以分为三类:视觉SLAM、3D场景理解和主动环境探索。为了对主动感知方法提供一个有效的视角,如表1所总结的,我们从三个实用维度分析代表性方法:传感器类型、特征类型和适用场景。
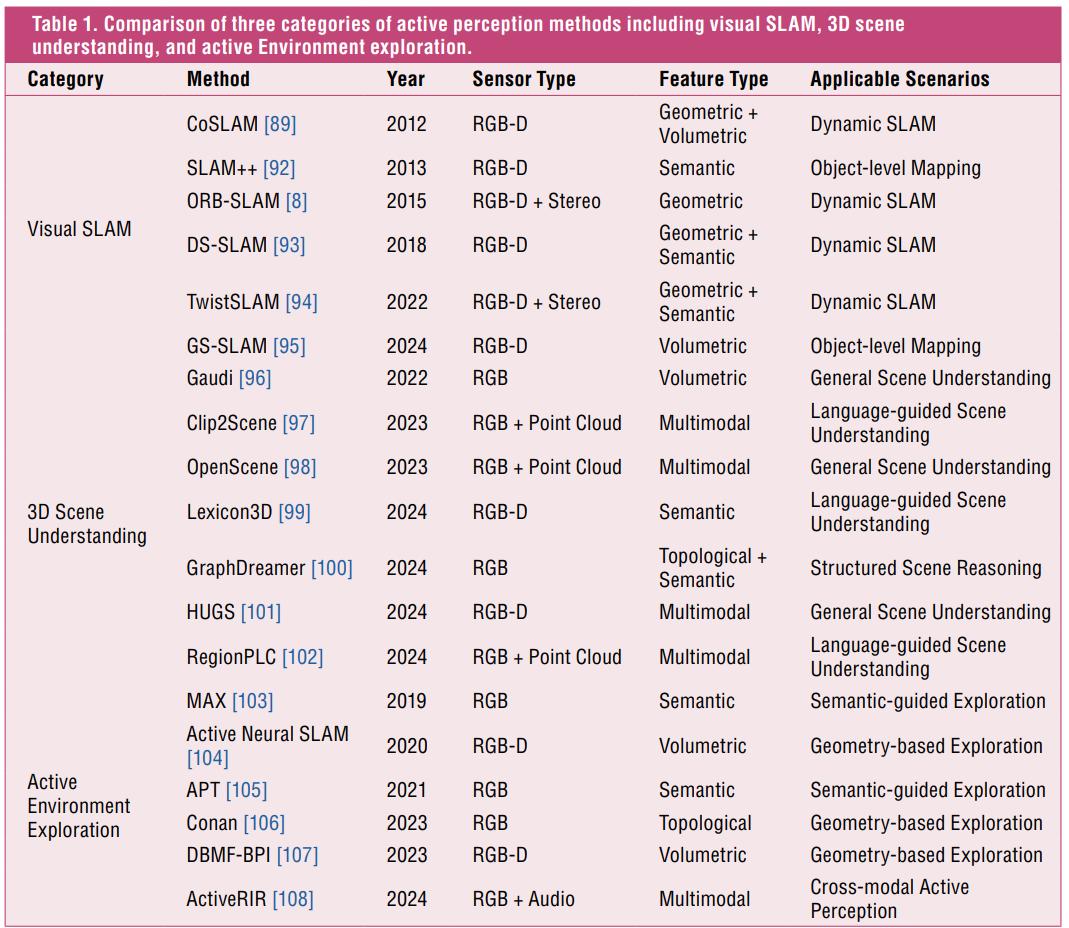
视觉SLAM。 同时定位与建图(Simultaneous Localization and Mapping, SLAM)是使智能体在未知环境中既定位自身又构建环境地图的关键技术[9], [83]。作为主动感知的基础技术,视觉SLAM已被广泛研究[84], [85]。根据Wang等人[86]的研究,现有方法可分为基于几何的方法和基于语义的方法。基于几何的方法利用空间或时间线索[8],如稠密场景流[87], [88]、三角一致性[89]和图结构[90], [91],在静态设置中表现良好,但在动态场景中表现不佳。相比之下,基于语义的方法通过利用高层次信息改善动态环境中的定位和建图。代表性的早期方法包括SLAM++ [92](整合了物体级语义)和DS-SLAM [93](将深度学习应用于动态场景理解)。最近的模型如TwistSLAM [94]和GS-SLAM [95]通过将几何优化与语义或生成式建模相结合,进一步增强了鲁棒性。
3D场景理解。 场景理解侧重于使智能体能够以结构化和语义上有意义的方式感知、分割和推理复杂环境。最近的工作通过整合视觉-语言模型和生成先验推进了这一领域。早期的努力如Gaudi [96]引入了面向3D感知场景合成的生成模型。Clip2Scene [97]和OpenScene [98]利用视觉-语言嵌入促进了标签高效和开放词汇的3D理解。结构化场景理解通过Lexicon3D [99]和GraphDreamer [100]进一步增强,这些方法通过场景图或语义词典等结构化表示建模3D空间中的物体级关系。同时,区域级多模态接地技术(以HUGS [101]和RegionPLC [102]为例)结合提示和空间接地来实现细粒度、目标条件的3D感知。这些方法推进了整体的、语言对齐的3D理解。
主动环境探索。 主动探索侧重于使智能体能够通过与环境的交互自主获取信息丰富的观测。早期方法依赖于构建显式或隐式的环境模型。代表性的基于模型的方法包括MAX [103]和Active Neural SLAM [104],它们利用预测建模和建图支持在未知空间中的高效导航。相比之下,APT [105]和DBMF-BPI [107]专注于通过直接的环境交互实现无模型探索,以减少对显式建模的依赖。最近的努力通过结合多模态感知[108]和语义推理[106]进一步增强探索能力。
b) 具身认知(Embodied Cognition): 具身认知是指在交互过程中,由智能体对其感知和积累经验的自我反思驱动的内部表征和推理能力的涌现[146], [147], [148]。该组成部分构成具身智能的核心,使智能体能够执行任务规划[149]、因果推断[150]和长周期推理[151], [152]。最近的具身认知研究主要集中在三个方面:任务驱动的自我规划、记忆驱动的自我反思和具身多模态基础模型。表2从四个角度分析了代表性方法:输入模态、认知类型、推理模式和输出类型。这些维度反映了具身智能体如何感知信息、形成内部模型和进行推理。
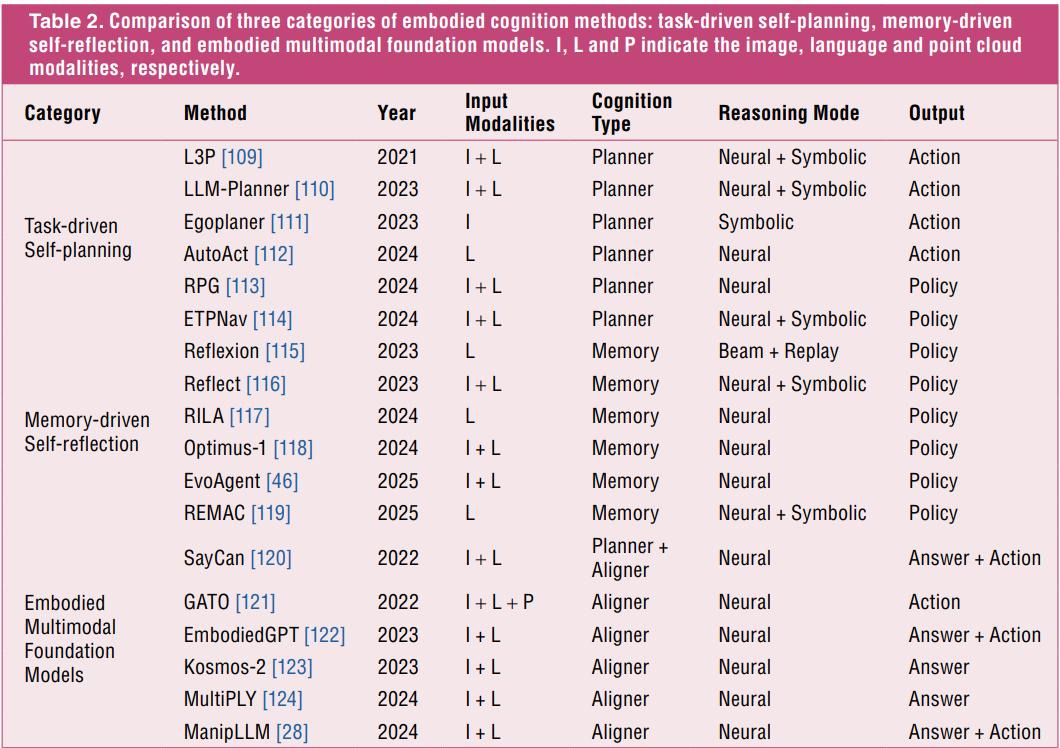
任务驱动的自我规划。 在任务驱动的自我规划中,智能体基于任务目标、环境上下文和内部知识自主生成结构化计划,无需显式的人类指令[153], [154], [155]。结构化学习是一种经典解决方案,它开发潜在规划空间或直接策略映射,在训练分布内实现高效率,但对分布外场景缺乏鲁棒性。代表性方法包括L3P [109]、Ego-planner [111]和ETPNav [114]。最近的进展将LLM或生成式模型纳入自我规划。LLM-Planner [110]和AutoAct [112]通过将语言引导的推理接地到各种任务中,将LLM整合到规划中,而RPG [113]提供了生成式视角,旨在通过多模态推理统一规划和内容创建。
记忆驱动的自我反思。 记忆驱动的自我反思使智能体能够利用过去的经验进行长周期推理、纠错和自我改进[46], [156]。早期研究侧重于记忆处理,包括固定大小的重放缓冲区[157], [158], [159]和可微分记忆架构[160], [161]。最近的进展引入了反思机制,智能体在其中总结或用语言表达过去的经验以指导未来的决策。Reflexion [115]和Reflect [116]使智能体能够通过将语言化反馈整合到动作规划中进行迭代自我纠正,而RILA [117]将反思推理扩展到多模态语义导航。超越个体反思,Optimus-1 [118]和REMAC [119]整合了多模态或多智能体记忆以支持长周期协作。EvoAgent [46]通过将持续世界建模与记忆驱动的规划器相结合,进一步推进了这一方向,实现了跨顺序任务的完全自主进化。
具身多模态基础模型。 在MLLM时代,具身多模态基础模型[162], [163], [164]已成为统一规划、推理和其他具身认知能力的最有前景的解决方案之一。最近的进展由数据构建和模型开发共同驱动。数据工作侧重于构建高质量基准以支持可扩展和认知上有意义的评估,如MuEP [165]、ECBench [166]、MFE-ETP [167]和EmbodiedBench [18]。在模型方面,最近的进展包括:将语言理解与具身动作空间对齐的可供性接地智能体(如SayCan [120]和GATO [121]);促进可扩展具身推理的视觉-语言预训练方法(如EmbodiedGPT [122]和Kosmos-2 [123]);以及增强操作和交互能力的以物体为中心的设计(如MultiPLY [124]和ManipLLM [28])。这些模型共同旨在构建可迁移和可泛化的具身智能。
c) 动态交互(Dynamic Interaction): 动态交互是指智能体通过基于其感知和认知的动作或行为影响环境的过程[168], [169]。现有研究强调了这种能力在使智能体不仅能响应而且能改变其周围环境方面的重要性[170], [171]。动态交互的研究涵盖动作控制、行为交互和协作决策。为了更好地理解现有方法,我们从四个角度分析代表性方法,包括输入模态、交互类型、学习范式和任务类型,如表3所示。这些维度反映了智能体如何感知环境、确定交互的层次和结构,以及在动态多智能体或人在回路场景中生成适当行为。
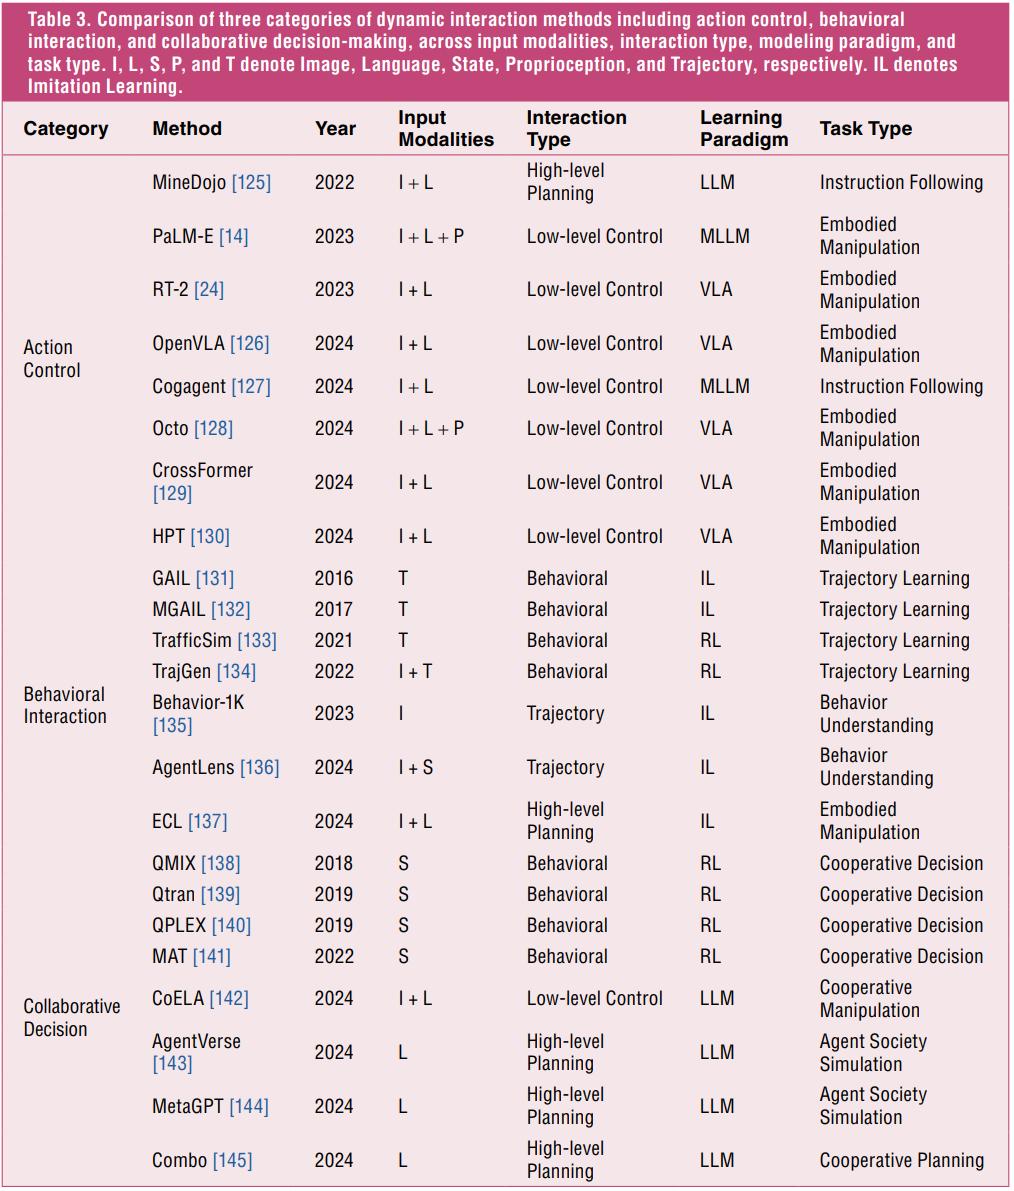
动作控制。 动作控制为具身交互生成运动指令。早期方法基于控制理论的动态系统建模[172], [173]或通过试错的RL [174], [175]。前者对结构化或重复性任务有效,而后者适应高维、非线性问题。最近的进展主要沿着三个方向发展。视觉-语言-动作(Vision-Language-Action, VLA)模型,如PaLM-E [14]、RT-2 [24]、OpenVLA [126]和CogAgent [127],整合了语言引导的推理以实现灵活控制,并已被Ma等人[176]全面综述。开放式框架如MineDojo [125]促进了从开放世界知识中持续获取技能。此外,跨具身学习,包括CrossFormer [129]、HPT [130]和Octo [128],旨在统一跨不同机器人和模态的策略学习。
行为交互。 智能体的行为由一系列动作组成。与动作控制相比,它强调通过有意义的动作模式进行高层次控制,使智能体能够以灵活和目标导向的方式交互。最近的进展主要分为两个方向。模仿学习,包括GAIL [131]、MGAIL [132]、TrafficSim [133]和TrajGen [134],实现了复杂行为的高效获取和模拟。BEHAVIOR-1K [135]提供了一个用于评估1000个具身任务的行为泛化的大规模基准。行为感知增强方法,如AgentLens [136]和ECL [137],提高了策略的鲁棒性和可解释性。尽管有这些进展,在稀疏反馈下实现可靠的长周期行为交互仍然具有挑战性。
协作决策。 协作决策侧重于协调多个智能体以实现共享目标,这对多智能体系统和人机协作至关重要[177], [178], [179]。多智能体RL是一种经典解决方案,如QTRAN [139]、QPLEX [140]和Qatten [138]等方法通过集中训练和分散执行来解决协作问题。MAT [141]将多智能体RL重新定义为序列建模问题,以缓解多智能体RL的可扩展性限制。最近的进展整合了LLM和WM以增强多智能体协作。MetaGPT [144]、CoELA [142]和AgentVerse [143]利用LLM进行任务推理和协调,而COMBO [145]组合模块化WM以支持可扩展的协作具身决策。
C. 硬件(Hardware)
随着具身智能的演进,模型复杂性和规模不断增长,增加了计算和能源需求。具身系统通常在动态、真实世界环境中运行,面临严格的延迟和功耗约束——尤其是在边缘端。因此,开发在保持性能的同时优化效率的硬件友好方向,对于实现响应迅速、能源感知的具身智能体至关重要。具身智能中的硬件优化通常包括四个组成部分:硬件感知模型压缩、编译器级优化、领域专用加速器以及硬件-软件协同设计。
1)硬件感知模型压缩: 量化和剪枝[4]是减少模型大小和计算成本的关键技术。在经常运行于低功耗嵌入式硬件的具身智能体中,这些技术对于实现快速高效的推理至关重要。量化[180]将权重和激活值映射到较低位宽,而剪枝[181]移除冗余参数。为了支持真实世界的具身任务,如机器人控制或视觉导航,功耗、性能和面积(PPA)等硬件效率指标可以指导位宽分配或剪枝比例[182],从而在物理平台上实现准确性和可部署性之间的任务特定权衡。
2)编译器级优化: 编译器桥接高层次具身智能模型和硬件执行。在实时具身系统中,编译器工具链对于传感数据和决策的高效处理至关重要。TVM [5]建立在LLVM [183]和CUDA之上,生成跨平台的优化代码。这些编译器通过算子融合和冗余计算消除来转换计算图[184],实现响应行为。循环重排和分块等映射策略增强了数据局部性、并行性和内存访问[185],所有这些对于在具身智能体中维持低延迟推理都至关重要。
3)领域专用加速器: 随着计算需求的增长,领域专用加速器(Domain-Specific Accelerators, DSAs)是具身智能的一个有前景的解决方案。这些系统,从机器人到AR/VR智能体,受益于为频繁操作量身定制的快速、节能的硬件。Google的TPU [6]通常通过PCIe与CPU和GPU集成,加速关键操作如矩阵乘法。基于FPGA的加速器[186]允许可重构性以适应新任务或变化的工作负载;CGRA加速器[187]改进在感知或控制中常见的结构化、数据流密集型计算。同时,基于ASIC的加速器[188]提供高吞吐量和能源效率,非常适合在真实世界环境中部署高性能具身模型。
4)硬件-软件协同设计: 将算法和硬件设计分离会降低运行时效率。硬件-软件协同设计通过算法-系统和算法-硬件协同优化来解决这一问题。算法-系统协同优化侧重于如何充分利用GPU资源(如张量核和CUDA核)来更好地支持算法[198]。算法-硬件协同优化旨在通过同时调整模型和硬件架构来提高部署效率。例如,我们可以基于网络中算子类型和硬件配置参数进行多目标优化[190]。我们还可以设计不同的数值量化方案以及匹配的硬件加速器来更好地支持具身智能任务[191]。
D. 基准与评估指标(Benchmarks and Evaluation Metrics)
标准化的基准和评估指标对于客观评估具身智能系统的性能至关重要。广泛采用的测试平台包括Habitat [192],提供用于导航和交互任务的光电真实感3D室内环境,以及ManiSkill [193],提供具有多样化物体集的基于物理的操作场景。模拟平台如MuJoCo [194]实现了连续状态空间中的精确控制评估,而EmbodiedBench [18]支持在感知、认知和交互方面对视觉驱动智能体进行全面评估。对于无人机应用,AirSim [195]提供具有动态障碍物的高保真空中环境。这些测试平台的复杂性各不相同:Habitat在视觉真实性方面表现出色,ManiSkill在物体多样性方面优秀,MuJoCo在物理准确性方面突出,EmbodiedBench在多模态集成方面见长。领域特定基准如BEHAVIOR-1K [135]进一步实现了在真实约束下对1000个日常活动的细粒度评估。
关键评估指标涵盖三个关键维度:任务成功率衡量目标导向目标的完成准确性(例如,物体操作或导航)[24];实时响应性量化决策延迟和对环境变化的适应速度[35];能源效率评估部署期间的计算成本(FLOPS)和功耗(瓦特)[4]。其他指标包括用于导航效率的路径长度[104]、用于未见过场景的泛化得分[196]以及用于物理合规性的安全违规[170]。对于多智能体系统,协调效率[177]和通信开销[197]提供了关键见解。MFE-ETP [167]等标准化评估协议确保了公平的跨模态比较,尽管在模拟到真实迁移验证方面仍存在挑战[176]。
E. 从单模态到多模态(From Unimodal to Multimodal)
具身智能的发展已从单模态系统演进到多模态系统,如图4所示。最初,具身智能主要关注单一模态,如视觉、语言或动作,其中感知、认知和交互由单一感官输入驱动[7], [8]。随着领域的成熟,单模态具身智能的局限性变得明显,出现了向整合多感官模态的重大转变[14], [15], [16]。多模态具身智能现在被视为创建更具适应性、灵活性和鲁棒性、能够在动态环境中执行复杂任务的智能体的关键[17], [18]。
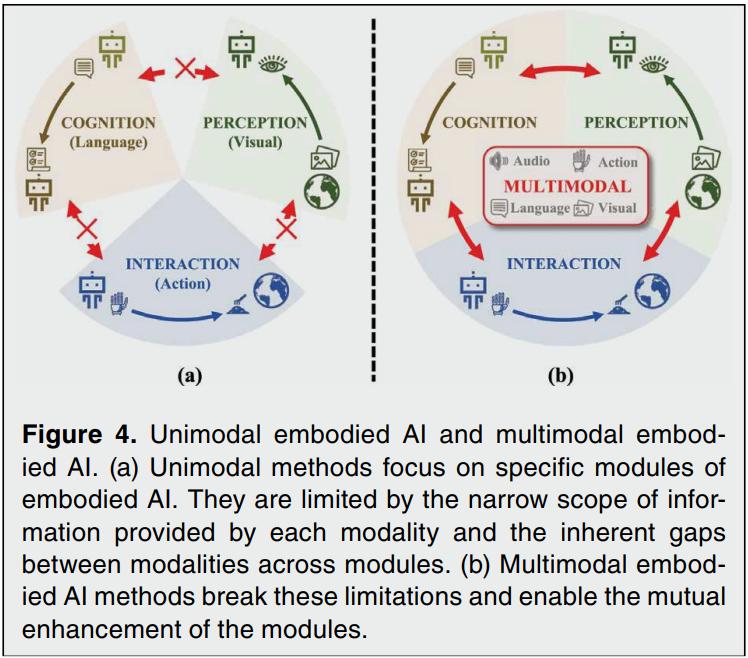
单模态具身智能得益于基础领域的快速发展,如计算机视觉、自然语言处理和强化学习[12], [13]。这些单模态方法在处理具身智能的特定模块方面表现出色。例如,计算机视觉技术推动了主动感知模块中视觉SLAM和3D场景理解的进展[9]。自然语言处理技术,特别是LLM,已成为解决具身认知模块中任务规划和长周期推理的热门方案[10], [11]。虽然单模态具身智能在独立模块中表现良好,但它始终面临两个固有的局限性。一方面,单一模态包含的信息有限,阻碍了感知、认知和交互的性能。例如,纯视觉系统难以理解动态或模糊环境中的环境,而基于听觉的系统在真实世界噪声和信号处理中面临挑战[17], [198]。另一方面,多样且异构的模态阻碍了模块间的信息传递和共享。智能体对环境的感知未能促进其认知的形成,而认知的演化也未能促进与环境的交互。
相比之下,多模态具身智能已成为一种更有前景的范式[18]。通过整合来自多个传感模态的数据,如视觉、听觉和嗅觉反馈,这些方法可以提供对环境更全面和精确的理解。更重要的是,多模态具身智能可以促进感知、认知和交互之间更深层次的整合。MLLM和WM的最新进展使智能体能够更有效地处理多种模态,有望提升具身智能的能力[44], [80], [199]。这些模型的整合被认为是实现在动态、不确定环境中多模态具身智能的关键一步。
第三节 基于LLM/MLLM的具身智能(III. Embodied AI With LLMs/MLLMs)
本节全面概述基于LLM/MLLM的具身智能。我们首先在第III-A节详细阐述LLM如何推动具身智能,在第III-B节阐述MLLM如何推动具身智能。然后在第III-C节讨论用于具身智能的MLLM分类。
A. LLM推动具身智能(LLMs Boost Embodied AI)
LLM通过语义推理和任务分解赋能具身智能,将高层次自然语言指令和低层次自然语言动作融入具身认知。
1)语义推理: 语义推理[19]利用LLM通过分析语言模式、上下文关系和隐含知识来从文本指令中解释语义。通过Transformer架构[62],LLM将输入token映射到潜在表征,实现在句法和语用层面上的层次化语义抽象。它们使用注意力机制加权相关的语义线索同时抑制噪声,促进逻辑推理和类比推理。通过将来自预训练语料的世界知识与任务特定提示相结合,LLM动态构建概念图,将文本输入与预期结果对齐。该过程通过概率token预测支持多跳推理,通过评估上下文连贯性和语义合理性来解决歧义。
2)任务分解: 任务分解[20], [21]利用LLM的顺序逻辑通过层次化分析上下文依赖关系和目标对齐,将复杂目标分解为子任务。通过思维链提示(chain-of-thought prompting),LLM将指令迭代解析为可执行的步骤,在通过语义连贯性检查解决歧义的同时优先处理相互依赖关系。
代表性工作如SayCan [22]首先提供了一个真实世界预训练的自然语言动作库,用于约束LLM提出既可行又上下文适当的动作;然后使用LLM将自然语言指令转换为自然语言动作序列;最后使用价值函数验证自然语言动作序列在特定物理环境中的可行性。这些工作表明,LLM对于旨在执行以自然语言表达的高层次、时间上延伸的指令的机器人极为有用。然而,LLM只是整个具身智能系统的一部分,受限于固定的自然语言动作库和特定的物理环境,难以在新机器人和新环境中实现自适应扩展。
B. MLLM推动具身智能(MLLMs Boost Embodied AI)
MLLM可以作用于整个具身智能系统,并可以通过将高层次多模态输入和低层次运动动作序列桥接到端到端具身应用中来很好地解决LLM的问题(如图5所示)。与LLM相比,语义推理[28], [29], [30]利用MLLM的跨模态理解从视觉、听觉或触觉输入中解释语义,例如识别物体、推断空间关系或预测环境动态。与此同时,任务分解[31], [32], [33]利用MLLM的顺序逻辑将复杂目标分解为子任务,同时基于传感器反馈动态调整计划。MLLM主要包括视觉-语言模型(Vision-Language Models, VLMs)和视觉-语言-动作模型(Vision-Language-Action models, VLAs)。
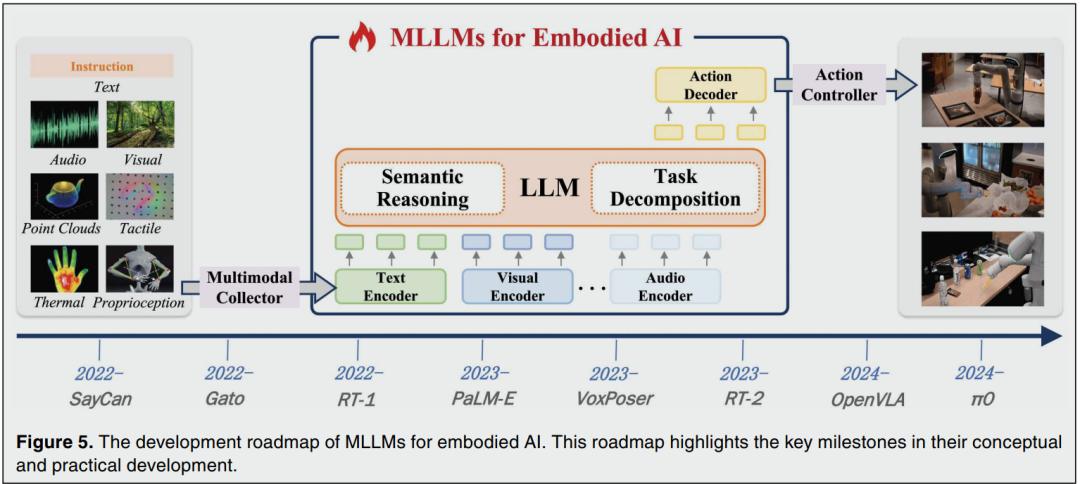
1)用于具身智能的VLM: 用于具身智能的VLM整合了视觉和语言指令理解,使物理或虚拟智能体能够在目标驱动的任务中感知其环境。代表性工作如PaLM-E [14]首先端到端地训练视觉和语言编码,结合预训练的大语言模型;然后将真实世界连续传感器模态编码的结果纳入VLM,建立词语与感知之间的联系;最后,通过固定动作空间映射实现多任务完成。对于导航,ShapeNet [200]对3D空间推理的对比嵌入进行微调,大大减少了路径规划误差。这些工作表明,VLM可以在具身智能中结合感知和推理,以解决具有固定动作空间的大量任务。
2)用于具身智能的VLA: VLA通过可微分流水线整合多模态输入与低层次动作控制。代表性工作如RT-2 [24]首先编码机器人当前图像、语言指令和在特定时间步的机器人动作,并将其转换为文本token;然后使用LLM进行语义推理和任务分解;最后将生成的token去token化为最终动作。Octo [128]在10万个带有语言标注的机器人演示上进行预训练,实现了跨具身的工具使用。对于灵巧操作,PerAct [201]利用3D体素表征达到毫米级的抓取精度。这些工作表明,VLA可以作用于整个具身智能系统,并在新机器人和新环境中实现自适应扩展。
C. 用于具身智能的MLLM分类(Classification of MLLMs for Embodied AI)
MLLM可以赋能具身智能的主动感知、具身认知和动态交互。
1)用于主动感知的MLLM: 首先,MLLM可以增强3D SLAM。通过将视觉观测接地到语义表征,MLLM利用高层次上下文信息(如物体类别、空间关系和场景语义)增强传统SLAM流水线。代表性工作如SEO-SLAM [202]利用MLLM生成更具体和更具描述性的物体标签,同时动态更新多类别混淆矩阵以缓解物体检测中的偏差。其次,MLLM可以增强3D场景理解。基于相机的感知[30]仍然是MLLM驱动的具身智能中的主导设置,因为RGB输入天然地与许多基础模型的视觉-语言预训练对齐[203]。代表性工作如EmbodiedGPT [122]利用这种协同作用将2D视觉输入映射到与基于语言的目标对齐的语义丰富的特征中。最后,MLLM可以增强主动环境探索。MLLM还彻底改变了机器人与环境交互的方式,特别是在反馈驱动的闭环交互中。代表性工作如LLM3 [201]侧重于结构化的运动级反馈,将碰撞检测等信号纳入规划循环,允许模型迭代修改符号动作序列。另一方面,MART [204]利用交互反馈来提高检索质量。
2)用于具身认知的MLLM: 首先,MLLM可以增强任务驱动的自我规划。具有MLLM的具身智能体可以直接将高层目标映射到结构化动作序列[31],也可以采用一种中间规划策略,持续与环境交互以完善其计划[32]。代表性工作如CoT-VLA [33]预测中间子目标图像,描绘子任务的期望结果,帮助智能体可视化和推理复杂任务的每一步。其次,MLLM可以增强记忆驱动的自我反思。MLLM允许智能体使用其固有的记忆模块从经验中学习[128]。代表性工作如Reflexion [115]通过自我生成的语言反馈增强智能体性能,这些反馈存储在情景记忆缓冲区中,用于指导未来规划。最后,MLLM可以增强具身多模态基础模型。MLLM可以通过在具身设置中进行持续预训练或微调来适应物理世界。代表性工作包括QwenVL [74]和InternVL [205],以及支持更广泛模态对齐的模型,如Qwen2.5-Omni [206]。
3)用于动态交互的MLLM: 首先,MLLM可以增强动作控制。MLLM能够将复杂任务分解为可执行的子任务[32]。为了进一步为每个子任务生成连续控制信号,MLLM要么以序列方式自回归地生成动作[126], [207],要么使用辅助策略头进一步处理其内部表征[128]。最近的进展还探索了用MLLM生成可执行代码[208],使机器人能够遵循可解释和可适应的控制策略。其次,MLLM可以增强行为交互。通过与环境交互,MLLM也能够在单步中生成行为动作序列。代表性工作如π-0 [31]将视觉-语言骨干与流匹配解码器结合,生成平滑、时间上延伸的行为轨迹。最后,MLLM可以增强协作决策。一条研究线侧重于旨在实现人类级协调并能快速适应不可预见挑战的多智能体系统[209]。例如,Combo [145]引入了一个新颖的框架,增强了仅使用自我中心视觉观测的去中心化智能体之间的协作。其他工作研究人-智能体协作。VLAS [210]通过语音编码器和LLaVA风格的MLLM [211]将人类口头命令与视觉上下文对齐,实现了流畅和对话式的人-智能体交互,就是这一点的例证。
第四节 基于世界模型的具身智能(IV. Embodied AI With World Models)
本节全面概述基于WM的具身智能。我们首先在第IV-A节详细阐述WM如何推动具身智能。然后在第IV-B节讨论用于具身智能的WM分类。
A. 世界模型推动具身智能(World Models Boost Embodied AI)
WM通过构建外部世界的内部表征和未来预测赋能具身智能(如图6所示),促进在动态环境中遵循物理定律的具身交互。
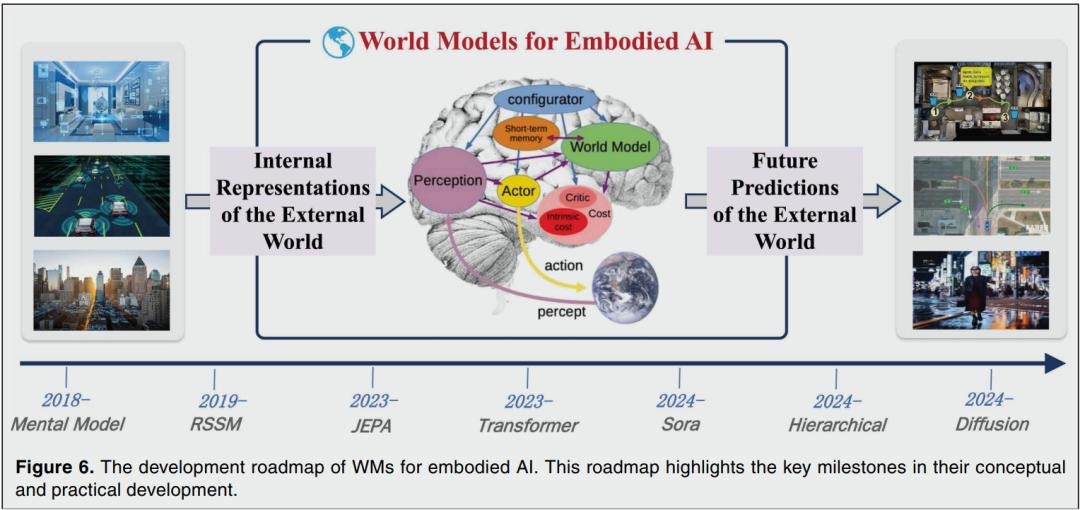
1)外部世界的内部表征: 内部表征将丰富的感官输入压缩为结构化的潜在空间,捕捉物体动态、物理定律和空间结构,使智能体能够推理其周围环境中"存在什么"以及"事物如何行为"。这些潜在嵌入保留了实体和环境之间的层次关系[212],反映了现实本身的组合性本质。这些表征的结构化性质促进了跨环境的泛化,因为抽象的原则(如重力或物体恒存性)超越了具体实例。此外,它们通过维护物体内在属性[38]和外在关系[39]的解耦变量,支持反事实推理[40],实现对单个组件的灵活心理操作。这种解耦还通过学习中的样本效率增强了智能体,因为智能体在任务之间共享潜在因素来迁移知识。具有丰富内部表征的世界模型可以内省自身对环境状态的不确定性,并主动寻求信息来解决模糊性。通过编码时间连续性和空间拓扑[36],这些模型在规划期间自然地强制执行一致性约束,在执行前过滤掉物理上不可行的动作。最终,这种结构化的潜在空间充当构建因果理解[37]的认知脚手架,反映了人类如何通过压缩的感官体验发展关于其世界的直觉理论。
2)外部世界的未来预测: 未来预测模拟在符合物理定律的多个时间尺度上的序列动作的潜在奖励,从而预先规避有风险或低效的行为[41], [42]。这种预测能力桥接了短期动作与长期目标[43],过滤掉违反物理合理性(例如穿墙行走)或策略连贯性(例如过早耗尽资源)的轨迹。长周期预测[44]允许适应性平衡探索-利用的权衡,模拟远期结果以避免局部最优,同时保持对可执行的近期步骤的关注。至关重要的是,这些预测包含了不确定性量化[41], [213],区分可预测的规律(日常模式)和随机事件(突然变化)以优化风险感知规划。模拟预测通过用心理排练替代代价高昂的试错来提高样本效率[39], [214], [215], [216],在安全关键领域如自动驾驶或机器人手术中特别有价值。此外,持续的预测误差最小化驱动迭代模型精化[169], [217], [218], [219],创建了将内部物理模拟器与观测现实对齐的自我纠正系统。这种预见能力最终赋予人工智能智能体类似人类的远见,将被动响应转化为有目的的、面向未来优化的行为。
B. 用于具身智能的世界模型分类(Classification of World Models for Embodied AI)
基于WM的具身智能主要可以分为三种关键结构:基于循环状态空间模型(Recurrent State Space Model, RSSM)的WM、基于联合嵌入预测架构(Joint-Embedding Predictive Architecture, JEPA)的WM和基于Transformer的WM。基于层次结构的WM [220]和基于扩散的WM [221]与其他结构类似,如图6所示。
1)基于RSSM的WM用于具身智能: RSSM构成了支撑Dreamer算法家族的基础架构[41], [42], [43], [44]。该框架通过视觉输入获取时间环境动态,增强了潜在表征中的预测能力,随后通过潜在轨迹优化实现动作选择。通过将隐藏状态正交分解为概率性和确定性组件,该架构显式地考虑了系统模式和不确定性。其在机器人运动控制应用中的有效性激发了许多基于其理论框架的衍生研究。
2)基于JEPA的WM用于具身智能: JEPA [27]为开发自主机器智能系统提供了一种结构。该架构通过表征学习在输入数据和预期结果之间建立映射关系。与传统的生成方法不同,JEPA在抽象潜在空间中运行,而不是生成像素级的重建,从而优先考虑语义特征提取而非低层信号合成。JEPA的一个关键方法论基础[213]涉及自监督训练范式,其中神经网络学习推断遮挡或未观测的数据片段。这种在大量未标注数据集上的预训练使得跨下游应用的迁移学习成为可能,在视觉[222], [223]和非视觉领域[224]都展示了增强的泛化能力。
3)基于Transformer的WM用于具身智能: 源自自然语言处理研究,Transformer结构[62]从根本上依赖于注意力机制,通过并行上下文加权处理输入序列。这种设计允许同时计算元素间的依赖关系,克服了循环神经网络(RNN)固有的顺序处理约束。经验证据表明,在需要持续记忆保持和显式记忆寻址以进行认知推理的领域中表现优异[225],这推动了自2020年以来在强化学习研究中的采用。现有的进展已成功地使用Transformer变体[38], [40], [226]实现了WM,在记忆密集型交互场景中优于RSSM架构[37]。值得注意的是,Google的Genie框架[36]使用时空Transformer(Spatial-Temporal Transformer, ST-Transformer)[227]通过大规模自监督视频预训练创建合成交互环境。这一突破建立了可动作世界建模的新范式,揭示了WM发展轨迹的变革性潜力。
第五节 基于MLLM和WM的具身智能(V. Embodied AI With MLLMs and WMs)
本节全面概述基于MLLM和WM的具身智能。我们首先在第V-A节详细阐述MLLM和WM在具身智能中的局限性,并解释MLLM如何推动WM推理,以及WM如何推动MLLM交互。然后在第V-B节设计一个MLLM-WM联合驱动的具身智能架构。最后,在第V-C节讨论新架构的优势和挑战。
A. MLLM与世界模型(MLLMs and WMs)
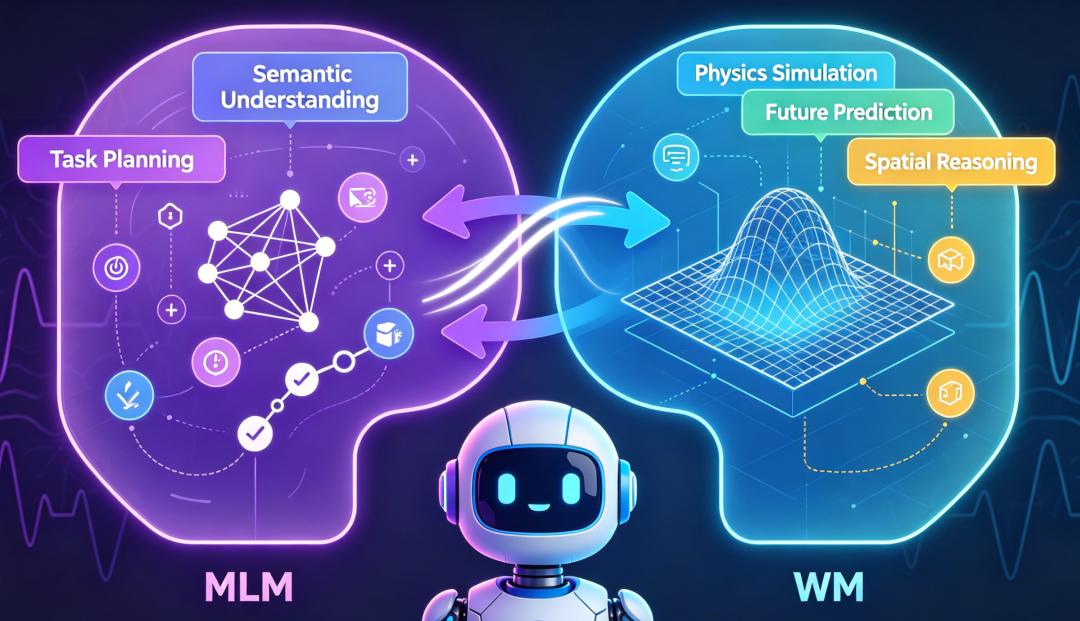
MLLM使能上下文任务推理但忽视物理约束,而WM擅长物理感知模拟但缺乏高层次语义。它们的联合将语义智能与基于物理的交互桥接起来。
1)MLLM在具身智能中的局限性(无WM): MLLM在具身智能应用中表现出两个关键局限性。首先,它们往往无法将预测建立在物理合规的动态之上[34],导致不切实际的计划。例如,在操作物体时忽略摩擦力或材料属性可能导致滑动或任务失败。其次,它们对环境反馈的实时适应能力差限制了响应性[35]。虽然MLLM擅长语义任务分解,但当环境发生剧烈变化时,它们难以自适应地调整动作。这些局限性源于它们依赖于静态的、预训练的知识,而不是持续的物理交互。
2)WM在具身智能中的局限性(无LLM/MLLM): WM在抽象推理和泛化方面面临局限性。由于侧重于物理模拟而非上下文理解,它们在开放式语义任务上存在困难[45]。此外,WM在没有明确先验的情况下缺乏可泛化的任务分解能力[26]。例如,在刚性物体操作上训练的WM模型可能无法适应可变形材料,除非进行大量的重新训练。它们的预测准确性高度依赖于领域特定的交互记录,阻碍了跨多样化环境的可扩展性。
3)MLLM推动WM推理: 通过利用跨模态对齐和语义接地,MLLM使WM能够动态处理复杂环境,改善语义推理、任务分解和人-机器人交互。1)MLLM可以通过将视觉、听觉和文本数据融合为统一的语义表征来丰富WM。例如,基于CLIP的架构[228]使智能体能够将视觉场景与语言线索对齐,减少物体识别中的歧义[229]。2)MLLM可以通过将高层目标分解为可执行的子任务来增强WM的任务分解能力。GPT-4V [65]等模型使用WM中存储的环境上下文生成逐步计划。对于机器人操作,Code-as-Policies [230]将自然语言指令翻译为代码片段,利用WM跟踪中间状态。3)MLLM使WM能够通过人类反馈精化内部表征。RLHF [72]等技术允许智能体基于纠正性输入更新WM先验[115]。本节中的工作都是MLLM推动WM推理的可能方式,在现有工作中尚未实现。
4)WM推动MLLM交互: WM可以通过提供物理定律、时空关系和闭环交互经验,在精化MLLM方面发挥关键作用。WM可以缓解MLLM在时间连贯性和环境接地方面的固有限制,使能动态具身任务中更鲁棒的决策。1)WM可以为MLLM提供物理定律(如重力、摩擦力)和常识规则的显式表征,以约束动作提议。例如,集成WM存储的生物力学模型的Physion++ [231]可用于过滤违反扭矩限制的MLLM生成的机器人运动;RoboGuide [232]将空间占用地图注入MLLM规划器,防止导航期间的碰撞。2)WM可以通过在多模态处理期间维护时空上下文来稳定MLLM推理。例如,MemPrompt [233]可以使用WM缓冲区将视觉物体轨迹与语言描述对齐,解决杂乱环境中的歧义;RoboMem [234]可以利用WM优先注意力过滤无关的感官噪声,改善基于MLLM的场景理解。3)WM可以通过闭环交互实现MLLM输出的迭代精化。Reflexion [115]可以在WM中存储任务执行历史,允许MLLM使用失败模式纠正运动学错误[230]。本节中的工作都是WM推动MLLM决策的可能方式,在现有工作中尚未实现。
B. MLLM-WM联合驱动的具身智能架构(Joint MLLM-WM-Driven Embodied AI Architecture)
我们提出了一个MLLM-WM联合驱动的具身智能架构(如图7所示),阐明其在实现物理世界中复杂任务方面的深远意义。具体工作流程如下,箭头突出显示了数据交换过程。
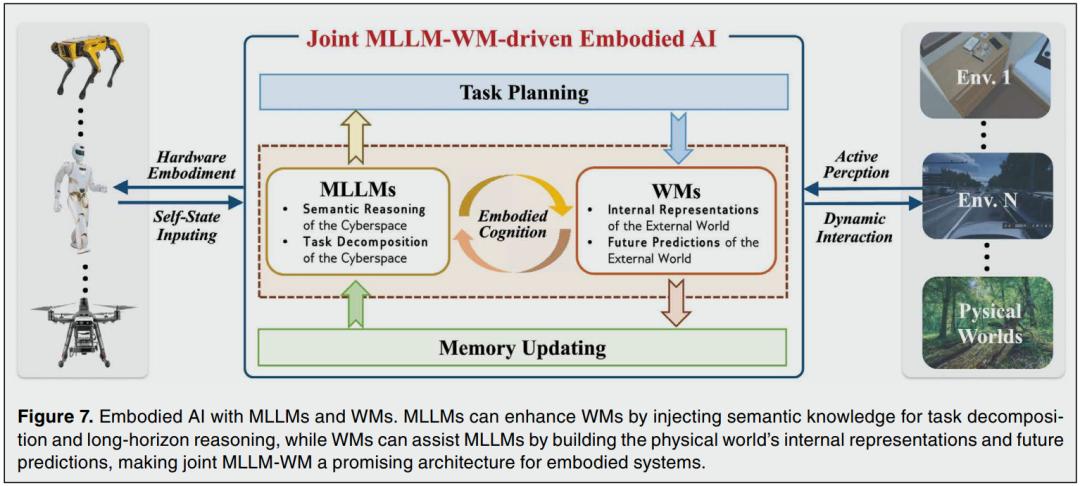
1)机器人 → 自身状态输入 → MLLM/WM → 硬件具身 → 机器人: 该过程始于自身状态输入追踪本体感知指标,如自由度、传感器数量等。这些指标同时输入到WM和MLLM:WM使用它们构建智能体物理状态的内部表征,而MLLM将这些状态上下文化以进行任务对齐。硬件具身侧重于将WM和MLLM实施到物理设备中,以解决模拟到真实的问题。这种双向流动确保动作既尊重机械限制又符合高层目标。
2)MLLM → 任务规划 → WM → 记忆更新 → MLLM: MLLM将抽象指令分解为子任务。前向箭头将此计划传递给WM,WM基于现有的环境建模预测结果。在执行过程中,WM将结果记录到记忆中。垂直箭头将这些日志传输到记忆更新模块,该模块将记忆结构化为经验,表示过去任务记忆的遗忘、当前任务记忆的更新和未来任务记忆的预测。然后这些通过箭头反馈回MLLM,丰富其知识库。这使得终身学习成为可能,过去的失败直接指导未来的规划。
3)环境 → 主动感知 → MLLM/WM → 动态交互 → 环境: WM首先通过预测关键环境变化驱动主动感知。然后多模态输入被用于通过WM构建外部世界的内部表征,并通过MLLM进行语义推理。接着,MLLM的任务分解和WM的未来预测使能动作选择和环境交互。通过持续迭代实现动态环境的自适应感知和交互。
C. 讨论(Discussions)
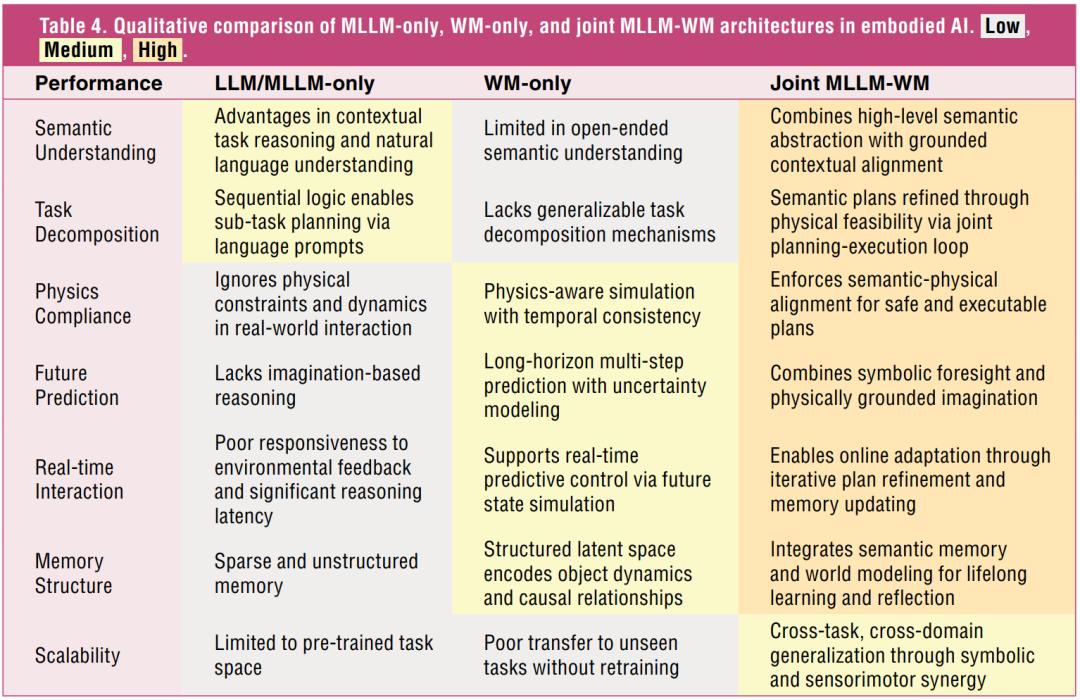
MLLM-WM联合架构为具身智能提供了一个有前景的架构。如表4所示,MLLM在语义推理方面表现出色,通过利用多模态输入实现高层次任务分解、上下文理解和自适应规划。同时,WM提供基于物理的环境模拟,确保动作符合真实世界的约束。这种协同作用使智能体能够在动态设置中平衡抽象推理与实时物理交互,增强决策能力。例如,MLLM可以生成任务计划,而WM验证可行性,实现迭代精化。此外,联合架构支持跨模态泛化,通过桥接符号知识和感觉运动经验,提高在部分可观测或新颖场景中的鲁棒性。
MLLM-WM联合驱动的具身智能架构的挑战包括:1)MLLM的高延迟语义处理与WM的基于物理的表征之间的实时同步,常常导致动态环境中的响应延迟;2)语义-物理不对齐,MLLM生成的计划违反未建模的物理约束;3)可扩展的记忆管理,因为对WM内部状态的持续更新可能会用无关上下文压垮MLLM。此外,训练此类系统需要覆盖罕见边缘案例的大规模多模态数据集,而确保对传感器噪声和部分可观测性的鲁棒性仍然未解决。这些挑战需要轻量级MLLM推理、更紧密的反馈回路和动态上下文过滤机制以最小化延迟。
第六节 具身智能应用(VI. Embodied AI Applications)
本节概述具身智能在服务机器人、救援机器人和其他领域的应用,突出显示MLLM与WM联合推动主动感知、具身认知和动态交互的趋势。
A. 服务机器人(Service Robotics)
具身智能正在成为服务领域的重要技术。它帮助服务机器人超越固定规则,使用不同类型的信息以灵活的方式执行任务。最近的研究突出了其在各个领域的灵活应用。在家庭环境中,RT-2 [207]和SayCan [120]等系统将语言指令与机器人控制相结合,使机器人能够完成诸如叠放餐具或烹饪等任务。AED [235]等少样本学习方法从有限的演示中获取新技能。在医疗保健方面,具有多种输入类型的机器人可以帮助提醒、康复和陪伴[236], [237]。在公共环境中,Habitat [192]和RT-X [238]等平台支持导航和物品递送,即使在变化的环境中,也不需要为每个任务进行专门训练。这使得系统更加通用,在现实生活中更有用。
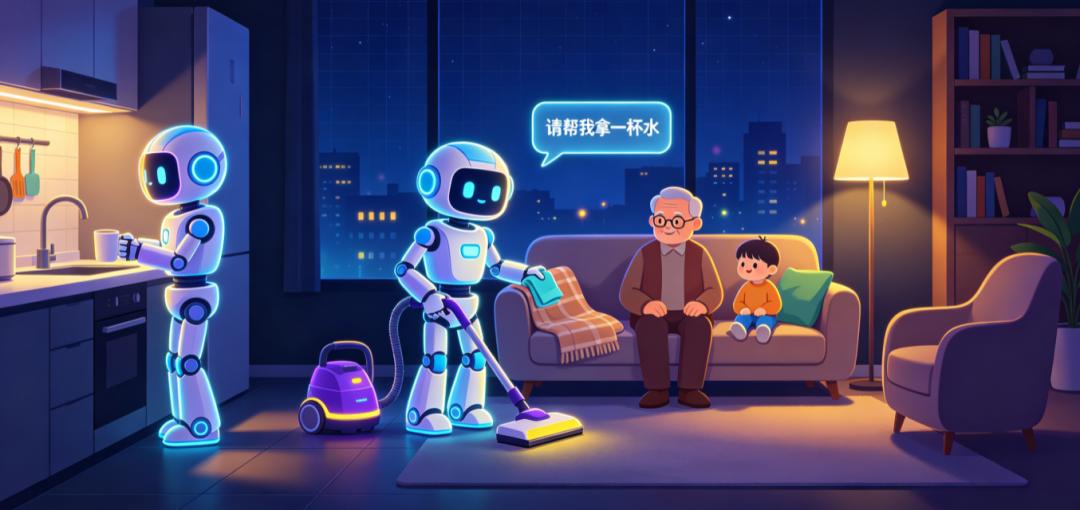
然而,当前方法在处理长周期任务方面仍然有限。如图7所示,WM与MLLM的联合正在成为增强服务机器人自主性和长期推理能力的关键策略。WM维护着用于规划和模拟的不断演进的环境模型,而MLLM将"打扫客厅"等命令接地为自适应的子任务。这种协作支持灵活的推理、目标适应和鲁棒的真实世界执行。
B. 救援无人机(Rescue UAVs)
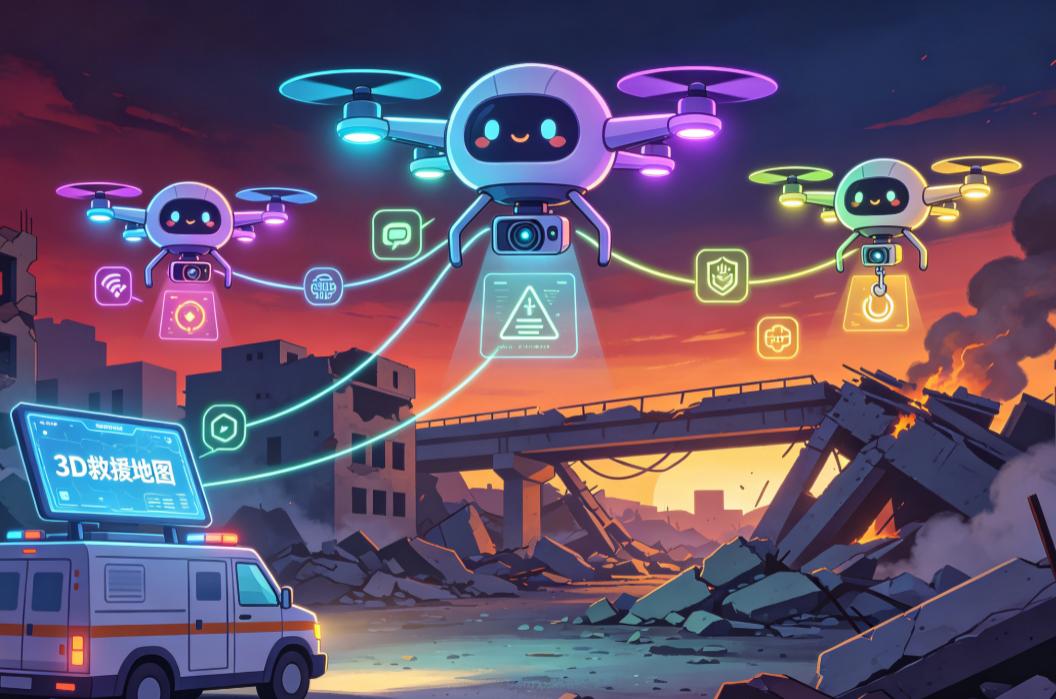
具身智能技术正在改变无人机在灾害情境中的使用方式。传统无人机要么手动控制,要么在使用时依赖预先构建的地图,这导致它们无法独立地适应环境。然而,具身无人机可以实时感知环境并对突发变化作出响应。这种能力使它们在地震区、森林火灾或洪水等危险场所非常有用。最近的研究表明,具身无人机可以执行许多复杂任务。例如,在语言模型的帮助下,它们可以理解和遵循人类语音指令,帮助无人机快速改变其动作并增强在紧急情况下的响应能力,如"在倒塌的桥梁附近搜索"[114], [239], [240], [241], [242]。其次,一些工作使用世界模型模拟危险环境,帮助它们避开危险并规划更安全的路径[243], [244]。其他研究探索了多架无人机如何协同工作以寻找幸存者和绘制受损区域地图[197], [245]。
然而,尽管有这些进展,当前方法在不确定性下的长周期推理和自主决策方面仍然有限。如图7所示,WM与MLLM的联合已成为进一步增强无人机自主性的关键策略。WM维护着持续演进的时空环境表征,支持在GPS不可用条件下的规划和风险预测。MLLM基于无人机的信念状态将命令接地为结构化的子任务。这种协调在任务关键条件下提高了泛化能力、长周期推理和高层自主性。
C. 工业机器人(Industrial Robots)
具身智能正在改变机器人在工厂中的工作方式。有了具身智能,工业机器人可以基于其周围环境做出更智能的决策。传统的工业机器人通常固定在一个地方。它们使用专门的传感器和工具,并被要求以非常高的精度完成任务。因此,它们更擅长做需要重复相同动作的工作。
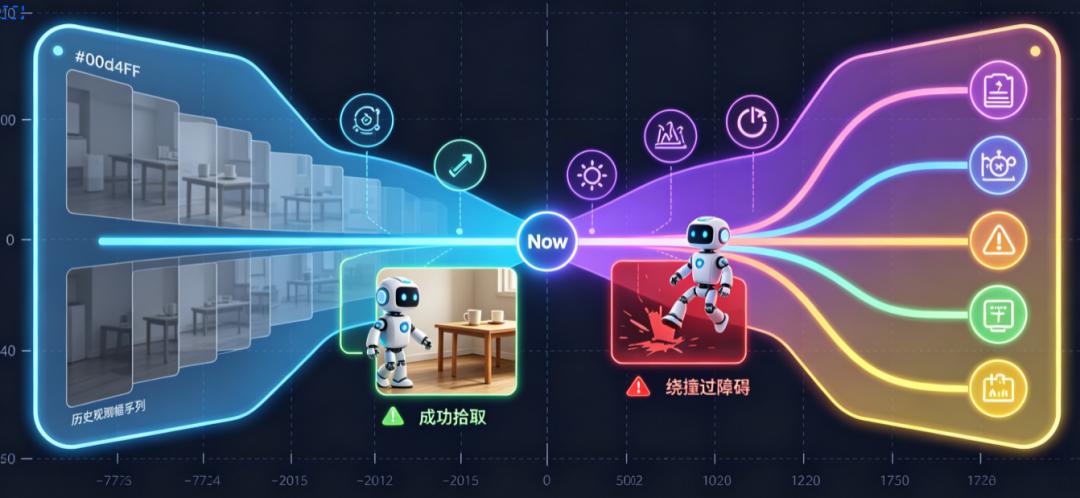
然而,有了具身智能,这些机器人可以做得比重复动作更多。通过结合MLLM和WM,工业机器人可以调整握持易碎物体的力度,或在遇到障碍物时找到新路径。这已经在现实生活中得到应用。例如,Tesla工厂中的机器人可以发现并修复未对齐的零件,无需人工帮助。在京东,机器人[246], [247]使用不同的传感器按尺寸和地址分拣包裹。在天猫的仓库中[248],机器人使用热成像相机、LiDAR和RGB传感器检查库存中的问题,并在出现异常时发送警报。这些例子表明,具身智能正在帮助机器人在工厂中变得更加灵活、可靠和智能。
D. 其他应用(Other Applications)
除了在家庭、医疗保健和救援任务中的应用,具身智能还被应用于教育、虚拟和太空环境。在智能制造中,它支持机器人可以与人类协同工作,执行精确的装配任务,并基于工作空间或人类行为的变化调整其动作。在视觉和触觉反馈的帮助下,这些机器人可以安全地处理易碎物品[249], [250]。在教育方面,具身智能被用于社交机器人,它们根据学生的注意力和情绪调整语音、凝视和手势。这有助于创造更个性化的学习体验,并在学生和机器人之间建立长期信任[251], [252]。在虚拟环境中,具身智能体学习移动、与物体交互以及完成需要多个步骤的任务。它们还随时间发展记忆以提高其性能[253]。在太空探索中,由于条件未知且与地球的通信延迟,具身智能允许机器人自主做出决策并适应新环境[254]。这些例子表明,具身智能在许多领域正变得更加灵活和有用,帮助机器在真实和虚拟世界中看、行动和学习。
第七节 未来方向(VII. Future Directions)
随着具身智能从模拟走向真实世界部署,未来的研究必须在几个核心领域优先发展统一和可靠的系统。关键方向包括自主具身智能、具身智能硬件、群体具身智能和评估基准。
A. 自主具身智能(Autonomous Embodied AI)
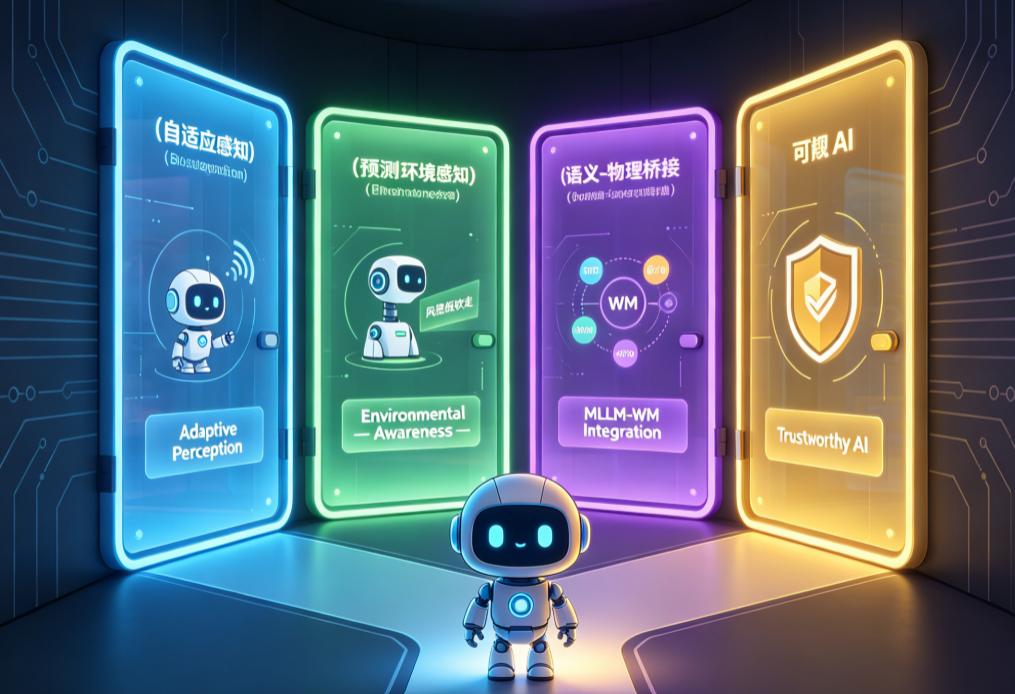
自主具身智能的目的是使智能体能够在动态和开放环境中长时间独立运行。未来的研究预计将沿着几个关键方向发展。首先,自适应感知可以赋予系统自主选择输入数据的能力,这可以通过动态选择和整合来自不同感官模态的信息来实现。其次,在此基础上,构建环境感知至关重要。环境感知帮助智能体快速适应变化,预测其动作的后果,并将其行为迁移到新环境中。这需要能够捕捉时空模式和建模因果关系的记忆架构。第三,未来系统应将MLLM与实时物理交互相结合,这使智能体能够将高层次语言指令与低层次控制桥接起来,并准确地建模真实物理世界。
B. 具身智能硬件(Embodied AI Hardware)
具身智能硬件的未来研究预计将在以下四个方向推进。首先,硬件感知模型压缩将继续将量化和剪枝等技术集成到硬件性能指标中,实现对模型准确性和部署效率之间权衡的精确控制。其次,图级编译优化将在桥接高层次具身模型和低层次硬件执行之间发挥关键作用,这将侧重于更有效的算子融合、调度策略和内存访问效率,以减少执行开销。第三,领域专用加速器将越来越多地针对具身任务的计算特征进行定制。FPGA和CGRA等可重构架构提供了灵活性和适应性,而基于ASIC的设计提供了高效率和性能。第四,硬件-软件协同设计对于消除算法行为和硬件架构之间的不匹配将变得至关重要。模型结构和硬件架构的联合优化对于在具身系统中实现实时、节能执行至关重要。
C. 群体具身智能(Swarm Embodied AI)
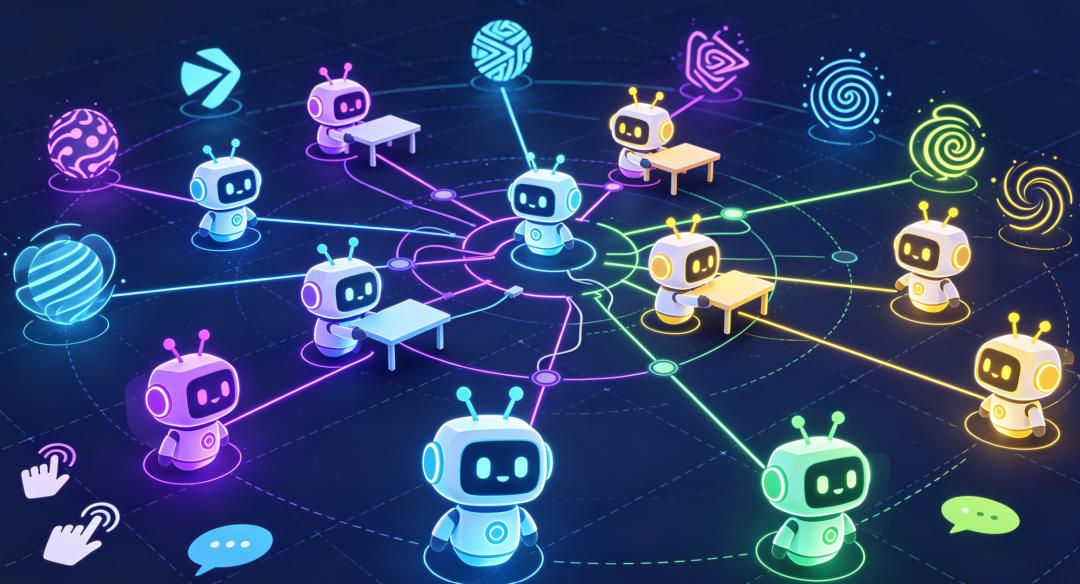
群体具身智能是指多个智能体的协作感知和决策。因为多个智能体在协作时可以表现出比单个智能体更强的能力,这种"集体智能"引起了许多研究者的兴趣,也被视为智能体接近人类的重要一步。首先,为了使多个智能体能够顺畅协作,需要开发协作WM。该模型可以基于每个智能体的观测建立共享和动态的环境表征,形成集体理解的基础。其次,多智能体表征学习非常重要。它可以帮助智能体理解自身状态,也能理解其他智能体的情况。这是智能体之间通信和协作的基础。此外,智能体之间的社会行为建模也至关重要。通过行为建模可以更好地实现角色分配和群体决策。最后,为了无缝融入真实世界应用,设计自然的人-群体交互界面也很重要。它可能包括多模态语言基础和基于手势的控制方法,使人类更容易指挥和引导整个智能体群体。
D. 可解释性与可信赖的具身智能(Explainability and Trustworthiness Embodied AI)
可解释性和可信赖性代表了具身智能的关键前沿,对于智能体越来越多地与人类和动态环境进行物理交互时的安全、合乎道德和广泛的真实世界部署至关重要。未来的研究必须解决几个关键挑战:首先,设计能够为智能体动作提供实时、人类可理解的合理性说明的基准,特别是在意外情况或失败期间,对于用户信任和调试至关重要。其次,建立鲁棒的机制以确保智能体在自主决策过程中遵循道德原则和人类价值观,特别是在救援或医疗保健应用中常见的道德模糊场景中,需要重大进展。第三,为非结构化物理环境中的智能体创建可验证的安全保证和认证标准,缓解与不可预测交互相关的风险,仍然是一个开放问题。最后,增强对对抗攻击、传感器噪声和分布偏移的鲁棒性,确保尽管存在真实世界固有不确定性的情况下仍能可靠运行,是可信赖操作的基础。解决可解释性和可信赖性这些多方面的研究问题至关重要,因为这一方向的进展将通过培养用户信心、赋能负责任的创新和促进监管接受,释放具身智能的全部潜力。
E. 其他方向(Other Directions)
几个新方向可能影响具身智能的未来发展。一个重要方向是终身学习。智能体需要持续学习新技能而不遗忘已学内容。只有这样,它们才能适应动态环境并保持先前完成任务准确性的精确度。另一个关键方向是人在回路学习。人类反馈是非常重要的监督信息。少量反馈可以显著提高智能体的性能并使其更像人类。为实现这一目标,我们需要更好的方法使智能体能够理解人类的目标和偏好。最后,随着智能体变得更加自主,道德决策变得越来越重要。未来系统应该学会仔细识别道德风险并遵循人类价值观。这将有助于确保具身智能既安全又可靠。
作者简介
Tongtong Feng 在北京邮电大学获得计算机科学与技术博士学位。他目前是清华大学计算机科学与技术系的博士后研究员。
Xin Wang(IEEE会员)在浙江大学获得计算机科学与技术学士和博士学位,并在加拿大西蒙菲莎大学获得计算科学博士学位。他目前是清华大学计算机科学与技术系的副教授。
Yu-Gang Jiang(IEEE会士)于2009年在香港城市大学获得计算机科学博士学位。2009年至2011年,他在美国纽约哥伦比亚大学担任博士后研究科学家。
Wenwu Zhu(IEEE会士)于1996年在纽约大学获得博士学位。他曾是微软亚洲研究院的高级研究员和研究经理。他目前是清华大学计算机科学与技术系的教授,以及北京信息科学与技术国家研究中心副主任。