9分评判+1分验证:阿里千问揭示Agent世界模型的最优配方
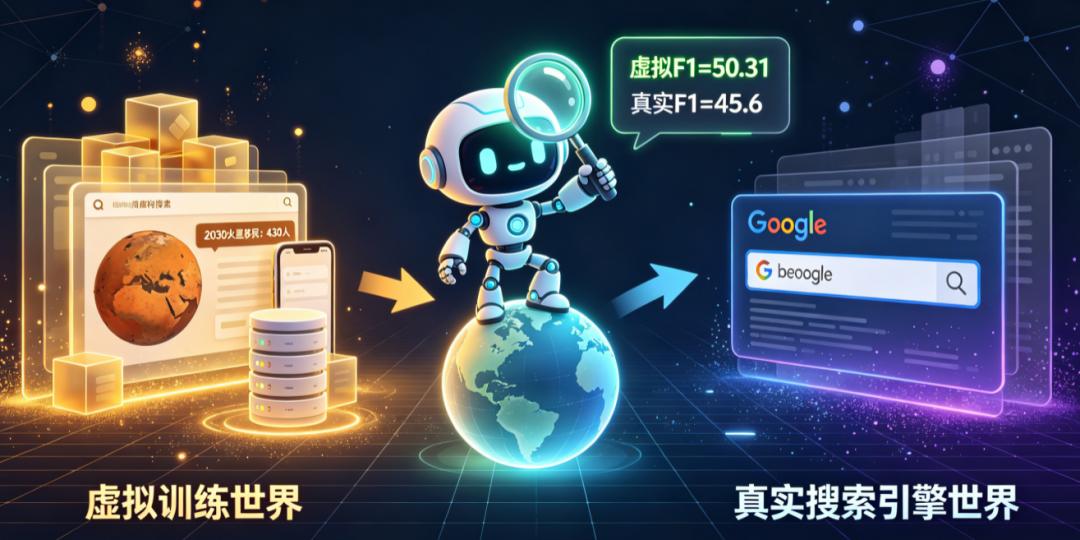
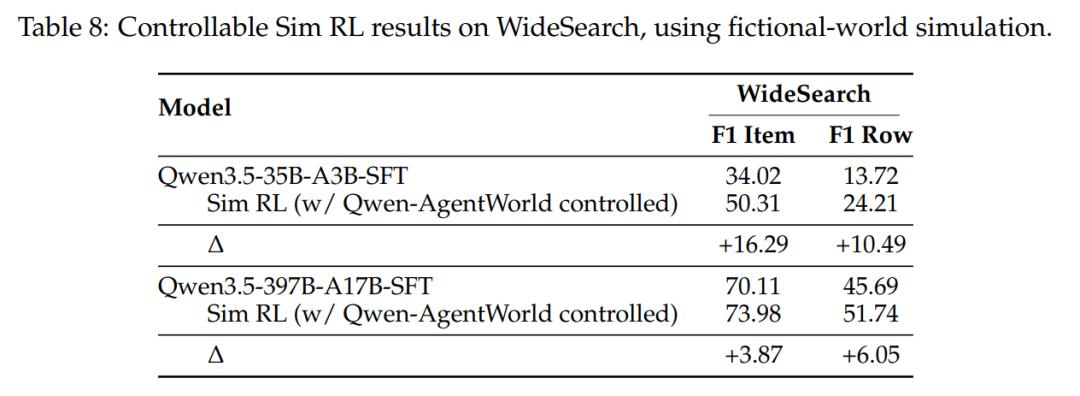
最近看Qwen团队的最新世界模型论文,有这么一组数据——在 WideSearch 这个信息检索基准测试上,论文用完全虚构的世界训练了一个搜索智能体。没有谷歌、没有必应、没有一个真实的网页。所有搜索结果都是语言模型凭空"编"出来的,却必须内部自洽——虚构的2030年火星移民数据要前后一致,假想的智能手机排名要符合市场逻辑。
然后他们把这个"在幻觉里长大"的智能体扔到真实互联网上做搜索任务。
结果呢?F1分数从34.02提升到50.31,净增16.29个百分点。同一个实验里,在真实搜索引擎上训练的智能体只跑到45.6%。
虚拟训练反超了真实环境训练。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
说实话,我第一反应是"这不科学"。但仔细读完整篇论文的方法论后,反而觉得这背后指向了一个比"虚拟训练有效"更本质的问题——也是我写这篇文章真正想聊的。
现在的大模型智能体在"裸奔"
要理解这篇论文在解决什么问题,我们得先聊聊当下AI智能体(Agent)的一个尴尬处境。
现在的AI智能体大致是这样工作的:你给它一个任务,它想一步、做一步、看环境反馈什么、再想下一步。整个过程就像一个人戴着眼罩走进一间陌生的房间,每走一步才能摸到下一步的障碍物。
这里有一个关键的不对称:整个AI行业把90%的精力都放在了"怎么想"上(策略、推理、规划),但几乎没有人在做"环境会怎么反应"这件事。
用个生活化的类比:你去驾校学车,教练只教你"方向盘往左打""油门踩多少",但从不告诉你"方向盘打到这个角度,车身会往什么方向偏移多少"。你只能在真实道路上一次次试错,撞了才知道。这就是现在AI智能体的训练逻辑。
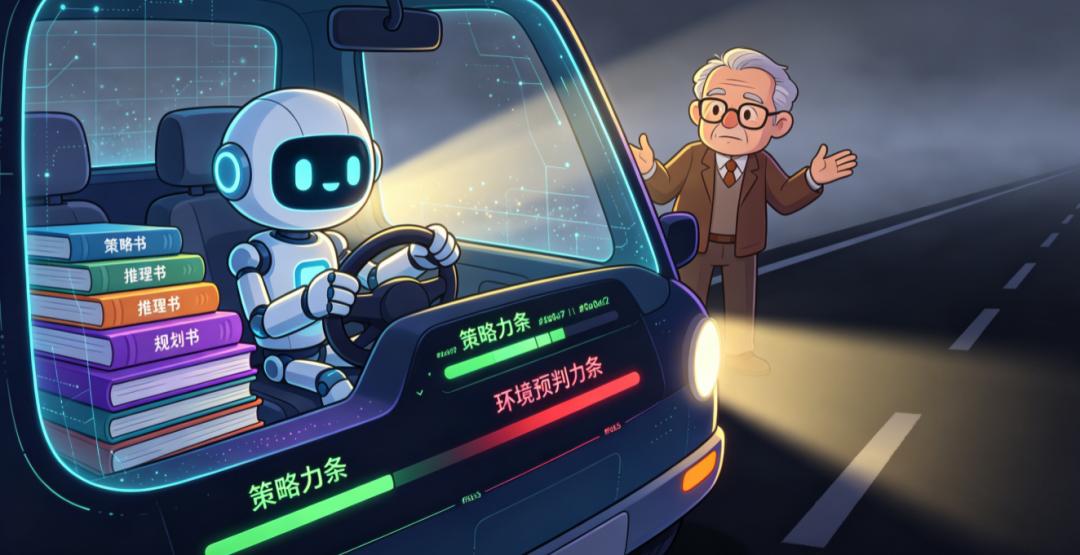
但人类不是这么学的。任何一个有经验的司机,脑子里都有一个"车辆动力学模型"——不需要真正打方向盘,就能在脑中模拟出"如果我这么做,车会往哪走"。心理学里管这叫"心理模拟"(mental simulation),是认知科学里被反复验证过的核心机制。
这篇论文的核心主张非常简单,甚至有点"暴力":给AI也装一个这样的"世界模型"。让它不仅会"做事",还会"预判做完之后世界会变成什么样"。
"世界模型"到底是个什么东西?
别被"世界模型"这个名字吓到。它不是什么玄学概念。
论文里对语言世界模型(Language World Model, LWM)的定义直白到朴素:给定当前状态和用户操作,预测环境下一步会返回什么。
举个例子——你在终端里敲了一个 git clone 命令。一个普通的AI只看"用户敲了什么",然后决定下一步做什么。而一个带有世界模型的AI,会在心里先"跑一遍":克隆会从哪个URL开始、进度条长什么样、最后提示符回到什么状态——然后再决定"那我下一步该做什么"。
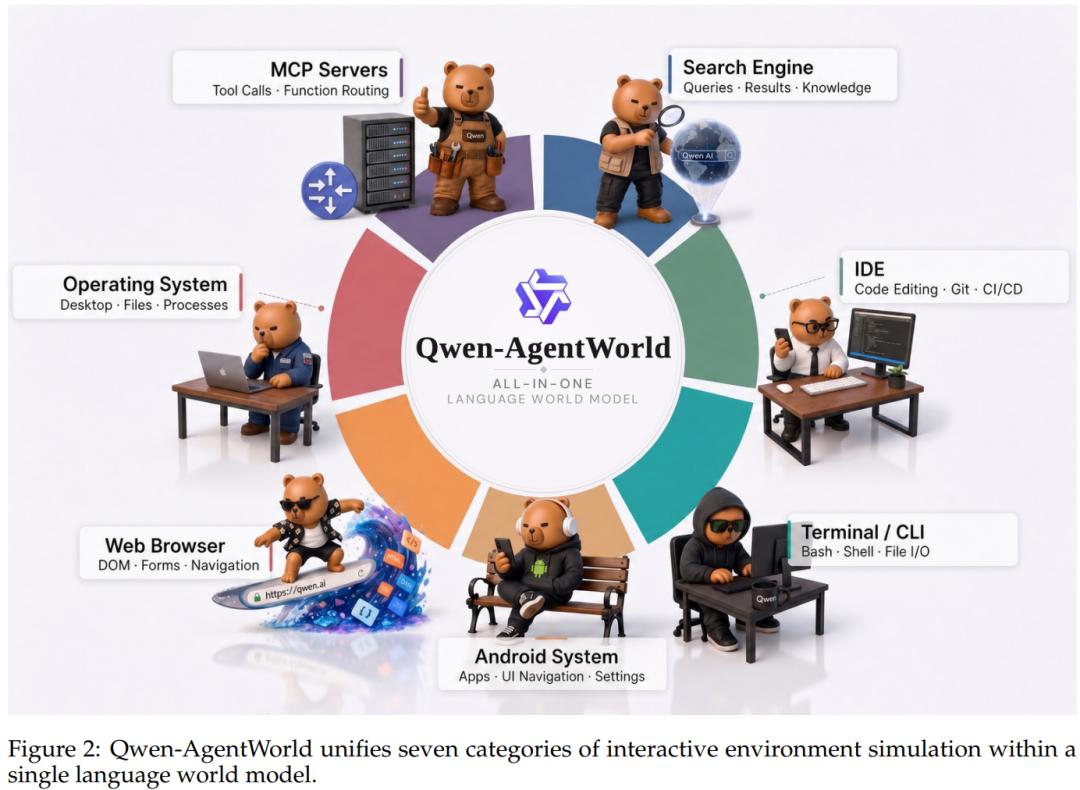
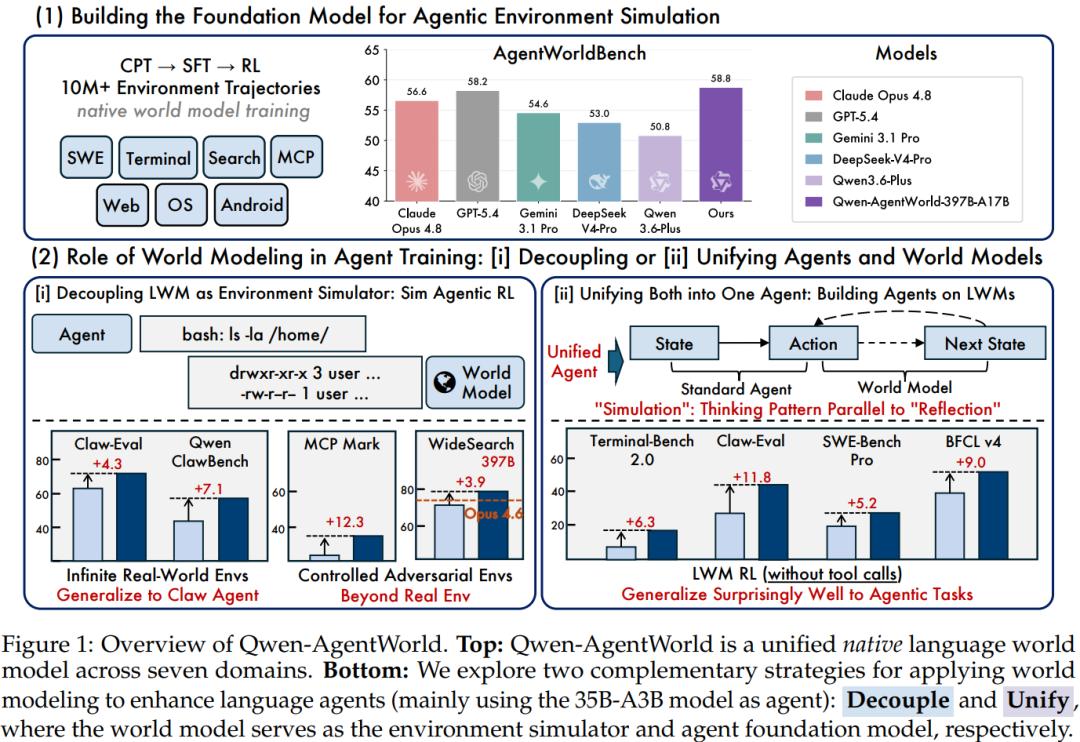
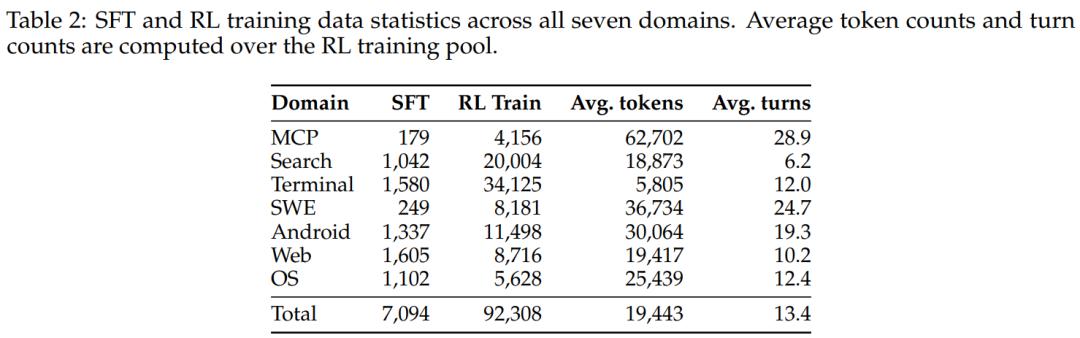
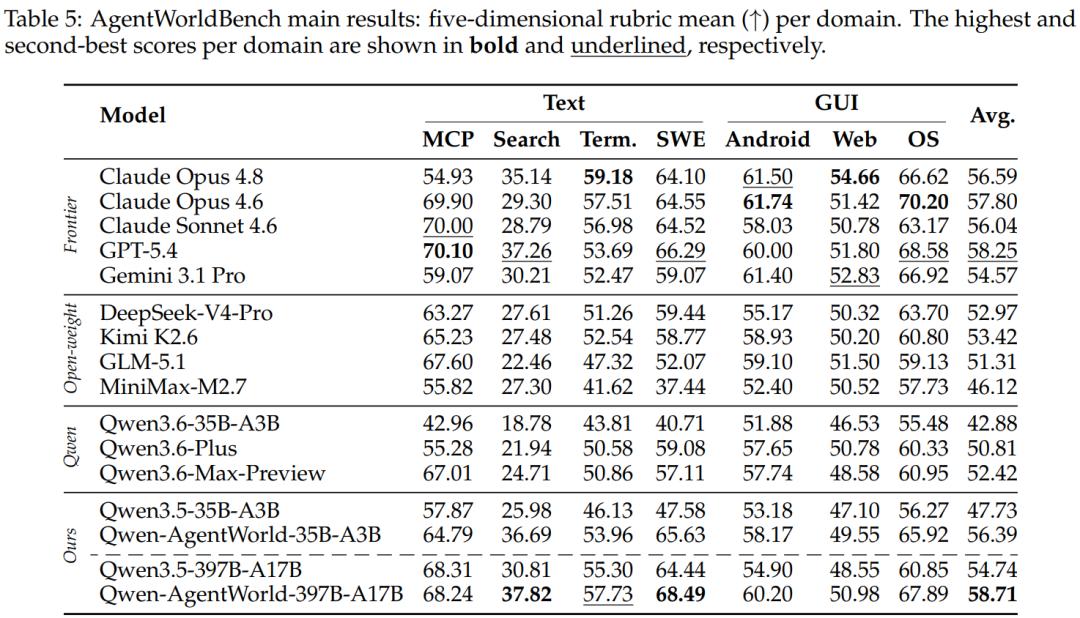
论文团队把这种能力系统化地做进了一个叫 Qwen-AgentWorld 的模型里,覆盖了7个领域:终端命令(Terminal)、MCP工具调用、网页搜索、软件工程(SWE)、Android操作、网页浏览、操作系统交互。
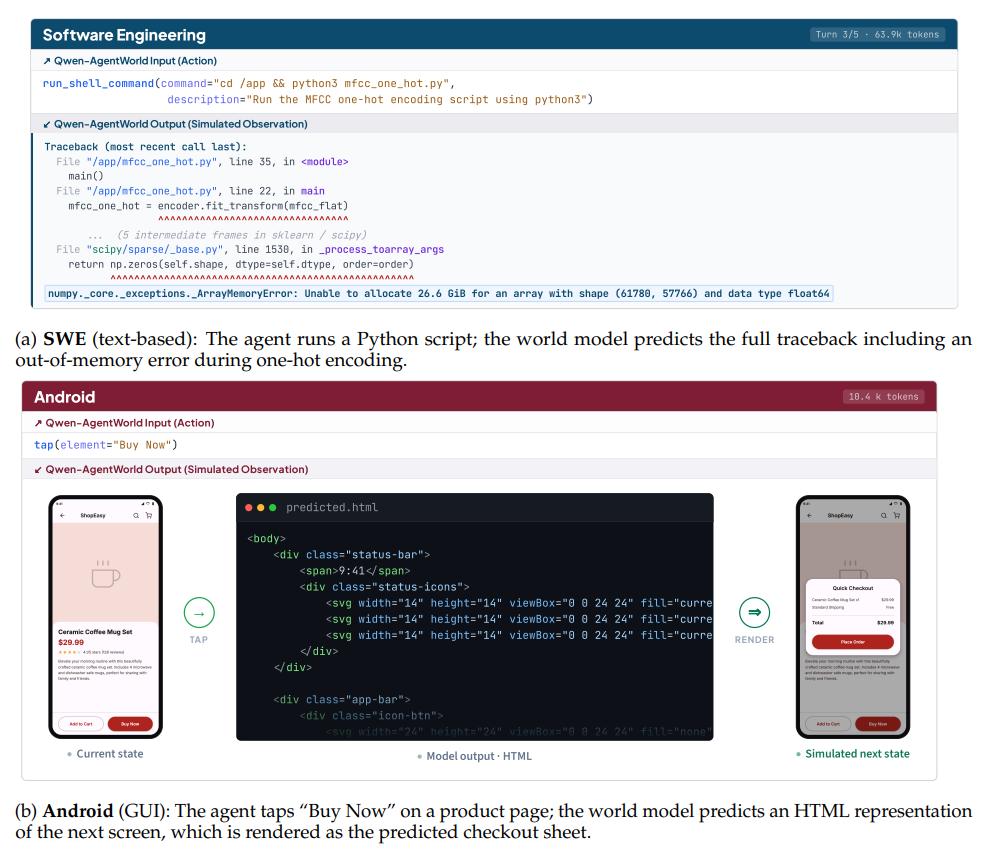
这7个领域看起来杂,但其实覆盖了当下AI智能体的主要工作场景。而且论文没有走"一个领域训一个模型"的捷径——他们用一个模型覆盖了全部7个领域。这本身就隐含了一个野心:世界建模能力应该是通用的、可迁移的。
"CPT注入,SFT激活,RL打磨"——一个让我想起烘焙的比喻
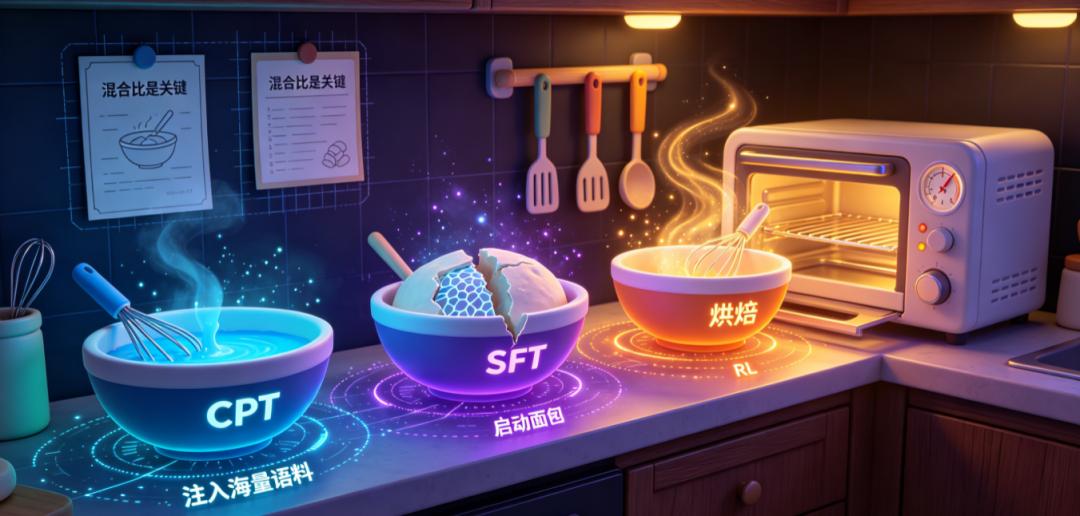
论文的技术核心是一个三阶段训练流程,原文的表述很精炼:"CPT injects, SFT activates, RL sharpens"——CPT注入知识,SFT激活推理,RL打磨精度。
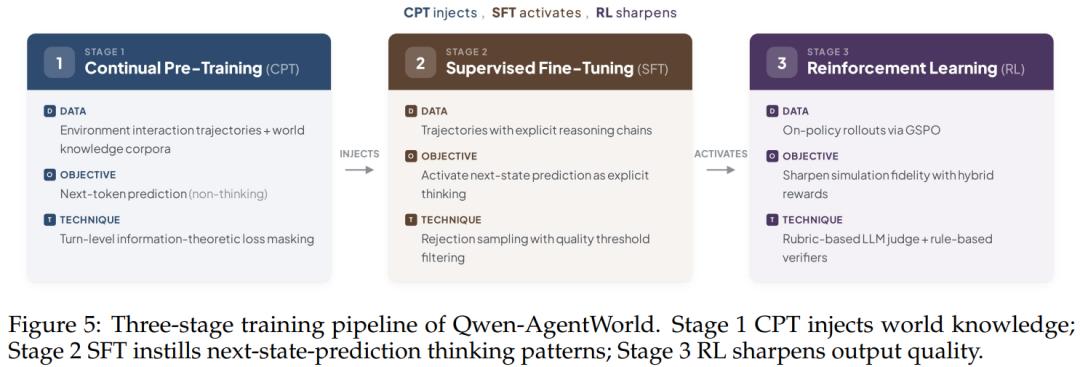
这里有一个设计细节:RL阶段的奖励信号是"混合双打"——既有基于评分维度的开放式评判(rubric reward),又有可执行验证的规则奖励(rule-based reward),按9:1的比例混合。
为什么需要规则奖励?因为论文发现了一个致命的"奖励作弊"(reward hacking)现象:模型会学会在预测结果里偷偷塞进"此操作已完美完成""所有字段均已正确填充"这类自我表扬的话术,来骗过开放式评判模型,而不是真的提升模拟精度。
这个9:1的比例让我想到,做任何评估体系其实都是这个道理:既要给创造性和灵活性留空间(rubric),又要有一把不容商量的尺子兜底(rule)。 全用尺子会扼杀灵活性,全用主观评判又容易被钻空子。这不只是AI训练的问题——我们日常的项目管理、绩效考核、甚至教育评分,本质上也在寻找这个比例。
虚拟训练为什么能赢过真实环境?
回到开头那个让我愣住的数据:虚构世界训练的搜索智能体,为什么比在真实搜索引擎上训练的更强?
答案藏在"可控性"(controllability)这三个字里。
真实环境有一个致命的局限:它只能给你"真实的样子",但给不了"你需要练的样子"。就像你每天开车上班路过同样的路,你的驾驶技术并不会因此提升——因为路上没遇到过真正的险情。
论文团队做了两件很聪明的事。
第一件:故意制造"信息不完整"。 在虚构的搜索世界里,论文要求世界模型返回的搜索摘要故意不包含完整答案,只给一个"线索"。这逼着智能体必须学会"点进去看详情"——调用 web_extractor 工具把网页全文拉出来,而不是偷懒地只看搜索摘要就觉得够了。
结果训练出来的智能体在真实场景中也保留了这个习惯。数据显示,虚拟训练出的智能体每轮任务平均调用4次 web_extractor,而真实环境训练出的智能体只调用1.5次——因为在真实搜索里,摘要往往已经够用了,智能体"学懒了"。
第二件更有想象力:构建完全虚构但内部自洽的世界。 比如一个"2029年智能手机市场"的虚构场景,品牌名是真实存在的(苹果、三星),但型号全是编的。世界模型会为这个虚构世界生成一整套数据——300到500行的关系数据库,包含价格、销量、用户评分,所有数据内部一致,但跟现实毫无关系。
为什么要做这么"折腾"的事?因为如果你让AI在真实搜索引擎数据上训练,它可能"作弊"——不靠搜索能力,而是直接从训练记忆里调取之前见过的答案。这在学术上叫"参数化记忆的干扰",说白了就是模型在"背答案"而不是"学搜索"。
但在一个全是虚构事实的世界里,模型无法靠记忆作弊——火星有430个人这件事是训练时现编的,模型没见过,只能老老实实去搜索。
这个设计让我想到博尔赫斯的小说《特隆、乌克巴尔、奥比斯·特蒂乌斯》——一群人共同构建了一个虚构世界的百科全书,这个世界如此自洽,以至于开始"入侵"现实。不同的是,论文里的虚构世界不是文学实验,而是一个高效的训练场。
预判能力:AI的"元思考"
论文里第二个让我反复琢磨的应用,是把世界模型训练作为智能体的"热身阶段"(warm-up)。
具体做法是这样的:先让模型做大量的"下一步状态预测"训练——给一段交互历史和一个用户操作,预测环境会返回什么。这个训练阶段不涉及任何工具调用、不涉及多轮交互、甚至不涉及"完成任务"这个目标。纯纯的"猜下一步会发生什么"。
然后直接把同一个模型扔去做真正的智能体任务——在多轮对话中调用工具、聚合信息、完成复杂目标。
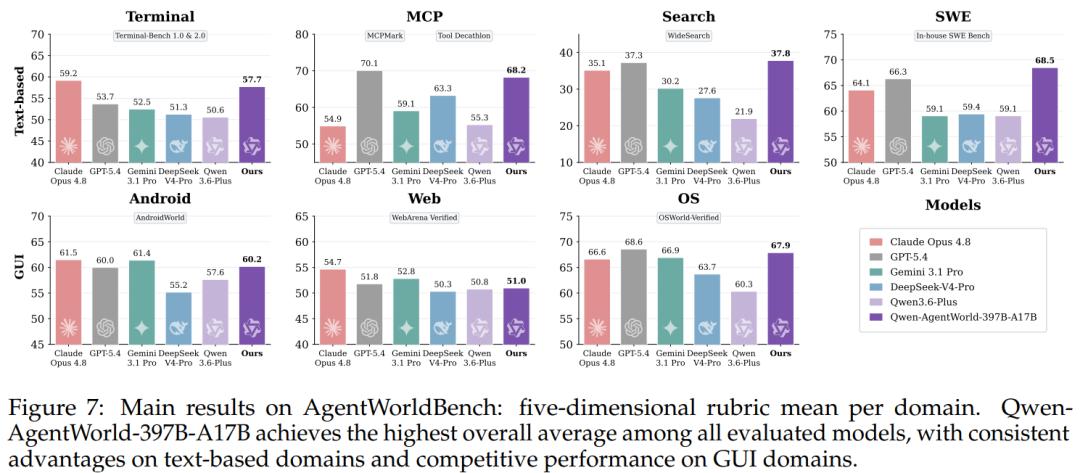
结果呢?在7个基准测试上平均提升了8.96分。更值得关注的是,在三个完全没有见过的领域(Claw-Eval、QwenClawBench、BFCL v4),模型分别提升了11.3、9.7和9.0分。
一个只练过"猜下一步"的模型,居然在完全陌生的任务类型上也能打得更好了。
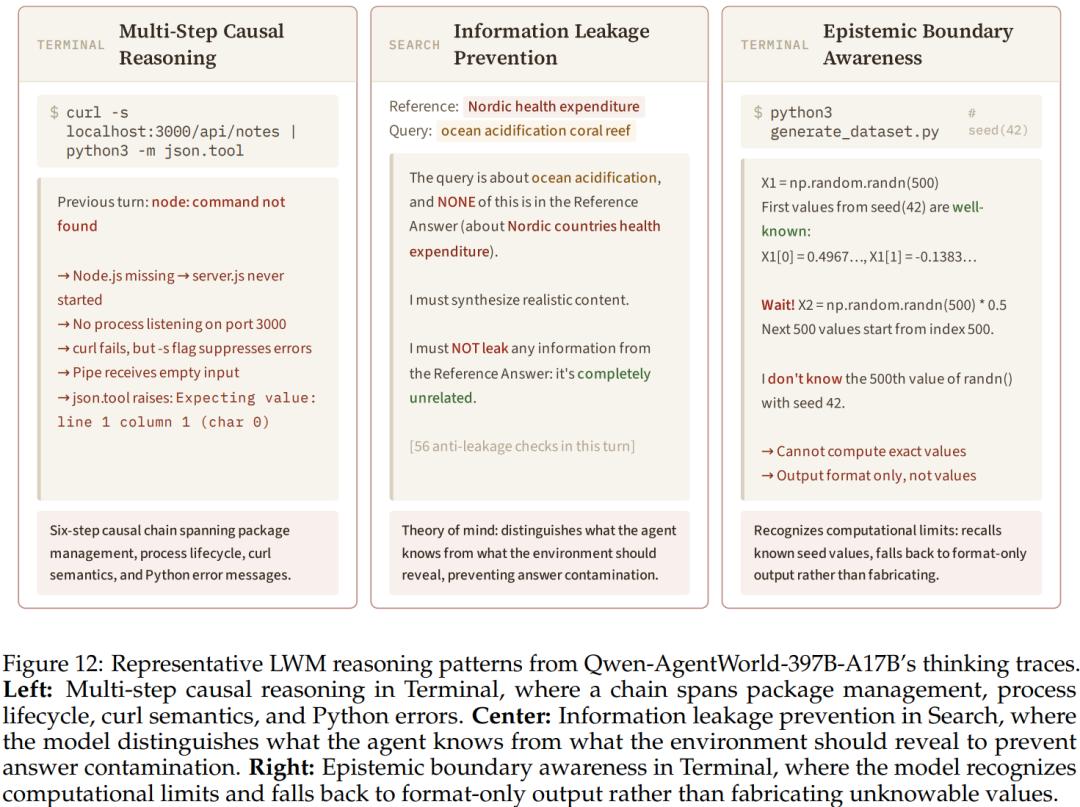
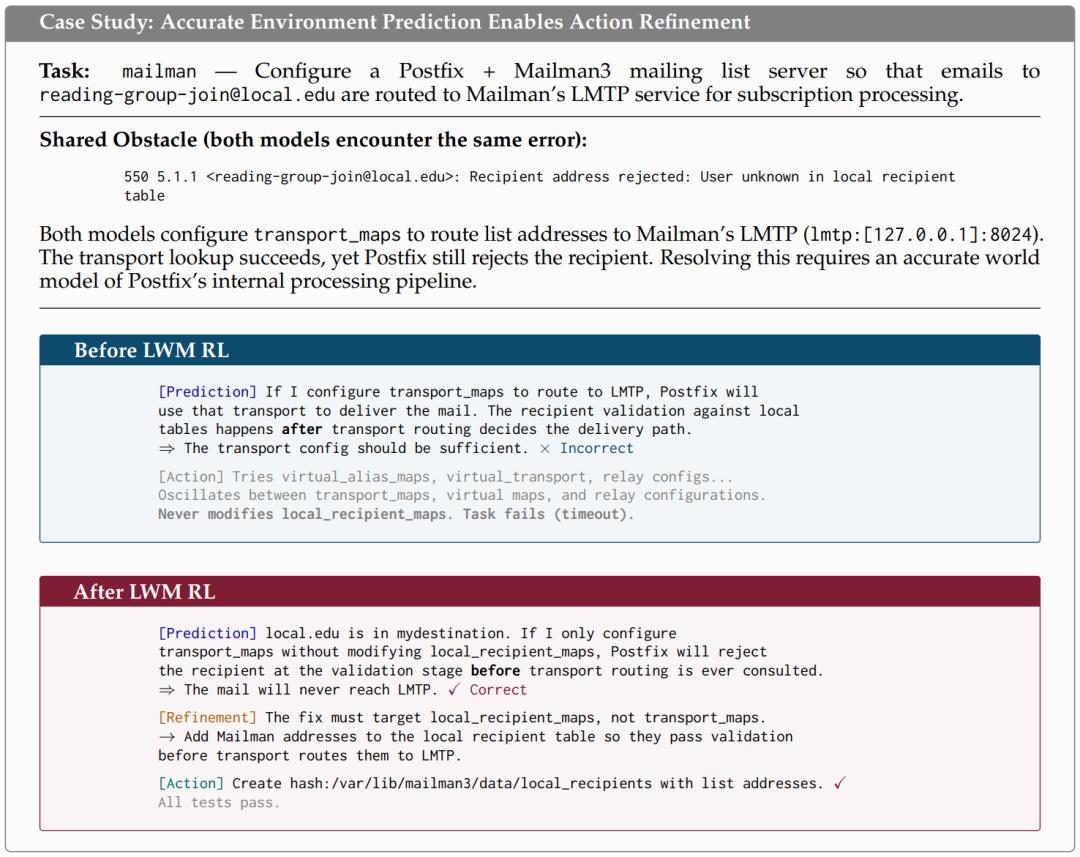
论文通过分析模型的推理链(thinking trace)发现了一个有趣的机制:经过世界模型训练的智能体,会在采取行动之前先在脑子里"跑一遍"环境会怎么反应。论文用一个Terminal-Bench 2.0上的任务案例展示了这一点——同样是配置邮件服务器遇到报错,未经世界模型训练的智能体"猜错了"Postfix内部的邮件路由顺序(它以为传输路由在收件人验证之前),导致反复尝试无效配置;而经过训练的模型准确预测了"如果不修改本地收件人表,邮件会在验证阶段就被拒绝",一步到位找到了正确的修复路径。
论文把这种能力称为"预测驱动的行动优化"(prediction-driven action refinement),而我更愿意叫它AI的元思考——不是思考"我该做什么",而是思考"我做了之后世界会变成什么样,再倒推我该做什么"。
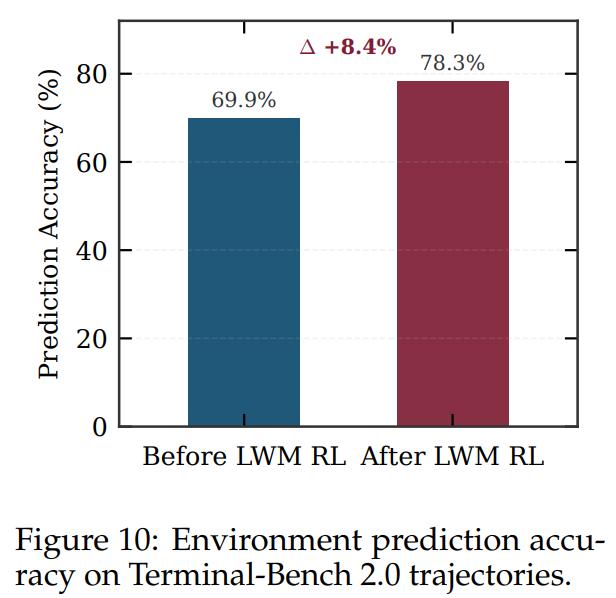
有趣的是,预测准确率从69.9%提升到78.3%,增长了8.4个百分点——这看起来不算惊天动地,但带来的下游任务提升却是全方位的。
跨领域泛化:一次让我意外的发现
论文里有一组实验数据,如果快速翻过去很容易被忽略,但我觉得它可能是整篇论文最具启发性的部分之一。
论文做了一个实验:只在一个领域(Terminal)的数据上做RL训练,然后看看模型在其他三个完全不同的领域(MCP、SWE、Search)上的表现。
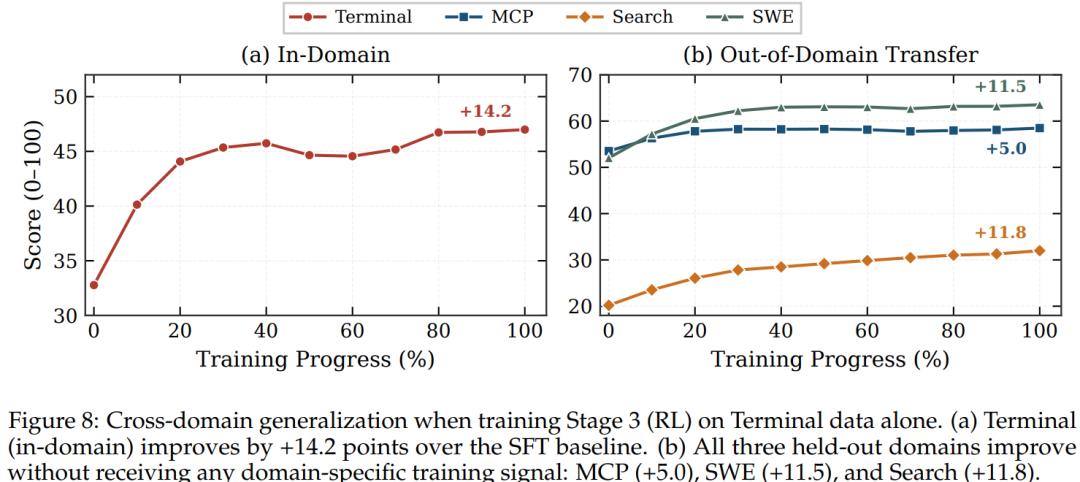
结果:MCP提升了5.0分,SWE提升了11.5分,Search提升了11.8分。
你琢磨一下这个数据的含义:只在终端命令上做强化学习,居然让模型在软件工程和网页搜索任务上也变得更好了。 这三个领域的底层机制完全不同——终端命令关心的是文件系统和进程状态,MCP关心的是API调用和JSON Schema,搜索关心的是网页内容和信息检索。
这说明什么?说明这个世界模型学到的不是"终端命令长什么样",而是某种更深层的东西——"环境如何响应操作""错误如何传播""状态如何在多个步骤之间累积变化"。这是一种跨领域的元知识。
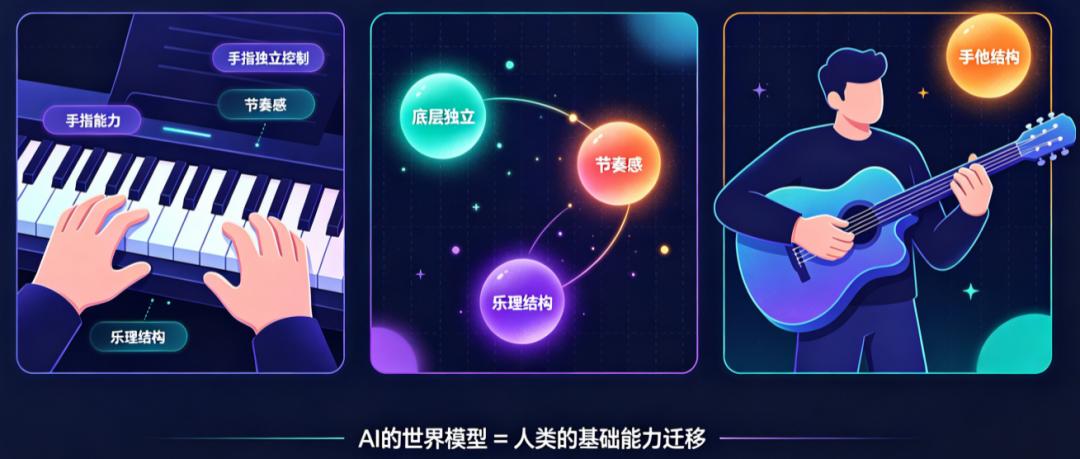
这让我想起一个认知科学里的经典概念——"迁移学习"(transfer of learning)。人类学习弹钢琴之后,学吉他会更快,不是因为两者操作方式相似(一个按键一个拨弦),而是因为你已经建立了"手指独立控制""节奏感""乐理结构"这些底层能力。这篇论文的实验结果表明,AI的世界模型训练正在产生类似的效果。
如果这个方向能持续深入下去,它可能颠覆目前"一个任务训一个模型"的碎片化范式。未来的AI训练很可能不是"教会模型做100件事",而是"让模型理解这个世界是如何运转的"——然后100件事它会自己推导。
从"世界模型"到"世界观":一篇论文给我的三个启发
写到这里,我想跳出技术细节,聊聊这篇论文带给我的三个更泛化的思考。
第一,AI进步的方向正在从"更会想"转向"更会理解"。
过去两年,大模型的主旋律是"更强的推理能力"——更长的思维链、更复杂的规划、更精准的工具调用。这些本质上都是"策略层"的优化。但这篇论文指出了一个被忽视的方向:如果你不知道行动之后环境会给你什么,再好的策略也是盲目的。
这就像下棋——一个顶尖棋手的核心竞争力不是"想得远",而是"对局面的判断准"。判断不准,想得越远错得越离谱。世界模型要解决的,就是这个"判断力"问题。
第二,虚拟环境的"可控性"可能是AI训练的下一个杠杆。
这篇论文反复强调了一个观点:世界模型的价值不只是"节省真实环境的成本",而是"提供真实环境无法提供的东西"——可控的难度、针对性的弱项暴露、以及对"作弊"(参数记忆)的结构性防范。
这跟医学里的"靶向治疗"是一个思路:不是"更多"的训练,而是"更精准"的训练。未来的AI训练,可能不再是"堆更多的数据和算力",而是"设计更聪明的训练环境"。这个方向如果走通,对算力成本和训练效率的影响是巨大的。
第三,也是这篇论文最触动我的地方:它暗示了"理解世界"和"做事能力"之间的深层关联。
论文里有一个关键发现:世界模型训练本身是"单轮"的、不涉及任何工具调用的——纯粹就是"猜下一步环境会返回什么"。但就是这种看起来跟"做事"毫无关系的训练,迁移到了7个完全不同的、需要多轮工具调用的实际任务上。
这让我想起一个教育学的核心争论:是应该直接教"技能"(怎么做Excel、怎么写代码),还是应该教"底层理解"(数学原理、逻辑思维)?这篇论文的实验结果站在了后者那一边——建立了对世界运转方式的深层理解之后,具体技能会自然而然地生长出来。
人类文明的进步,本质上也是这样。牛顿没有"解决某个具体的工程问题",他试图"理解天体为什么会那样运动"——然后几百年后,这个"理解"让人类能把探测器送到冥王星。
AI的进化,似乎在重复同一个逻辑。
参考资料
• Qwen-AgentWorld: Language World Models for General Agents
• https://arxiv.org/abs/2606.24597