二维已穷,三维当立|武大开源首个3D视觉查询定位基准3DVQL,正式开启升维打击
“给我一张咖啡杯的图片,在长达3分钟的第一人称视频里找到它最后一次出现的位置”——这个要求对人类来说很简单,但对AI视觉系统却是个巨大的挑战。传统2D视觉查询定位(VQL)虽然能处理平面图像间的匹配,却无法理解真实世界的3D空间结构——遮挡、视角突变、尺度变化都会让系统瞬间失效。更棘手的是,此前连一个专门支持3D空间查询定位的数据集都没有。现在,一项新研究首次将VQL从2D平面推向3D多模态世界,不仅构建了首个3DVQL基准数据集(2002个序列、17万标注帧、38类物体),更提出名为LaF的“提升与融合”算法,在几乎所有指标上甩开现有方法一大截。读懂这篇工作,你就能把握3D视觉查询定位从0到1的核心逻辑。
❓ 为什么2D视觉查询定位注定触达天花板?
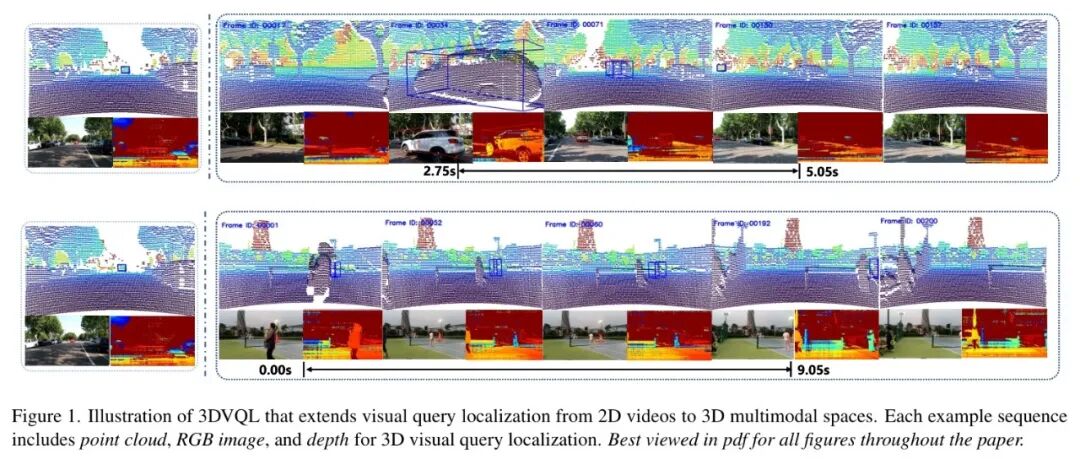
现有的2D VQL方法依赖单目RGB图像,在长视频中定位目标时,一旦遇到目标被遮挡、剧烈运动模糊或视角大幅变化,特征匹配就会迅速退化。本质上,2D平面无法编码物体的真实3D姿态、尺度和空间关系——而人类感知世界的底层就是3D的。研究团队敏锐地指出:只用RGB图像做VQL,性能瓶颈不在于网络深度,而在于模态本身的维度缺失。点云、深度等3D传感器数据才是破解遮挡和视角歧义的关键。下图清晰地展示了3DVQL任务的输入输出——左侧是包含点云、RGB和深度图的查询参考帧,右侧是连续帧序列中带3D边界框的点云与RGB对齐视图,目标是在时空连续体中定位物体的最新出现位置。
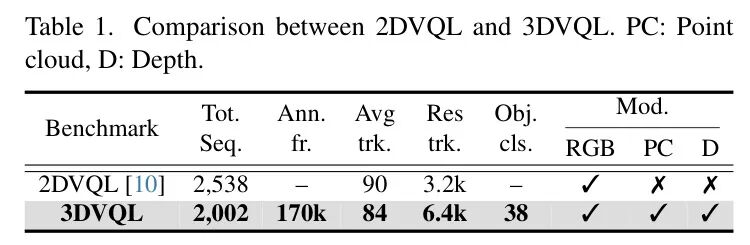
那么,为什么学界此前迟迟没有3D VQL数据集?因为3D数据采集和标注的难度远超2D。研究团队历时数月,在18个不同环境(街道、市场、走廊、校园等)中,使用搭载LiDAR、深度相机和RGB相机的移动机器人采集数据,并逐帧手工标注9自由度3D边界框(位置、尺度、横滚/俯仰/偏航)。最终得到的3DVQL数据集,序列数量与领先的2D基准Ego4D VQL相当,但轨迹片段数量几乎翻倍——这还是在3D标注成本高出数倍的情况下实现的。下表展示了3DVQL与2DVQL的模态对比,可以看出3DVQL提供了三种模态(RGB、点云、深度),而2DVQL只有RGB。
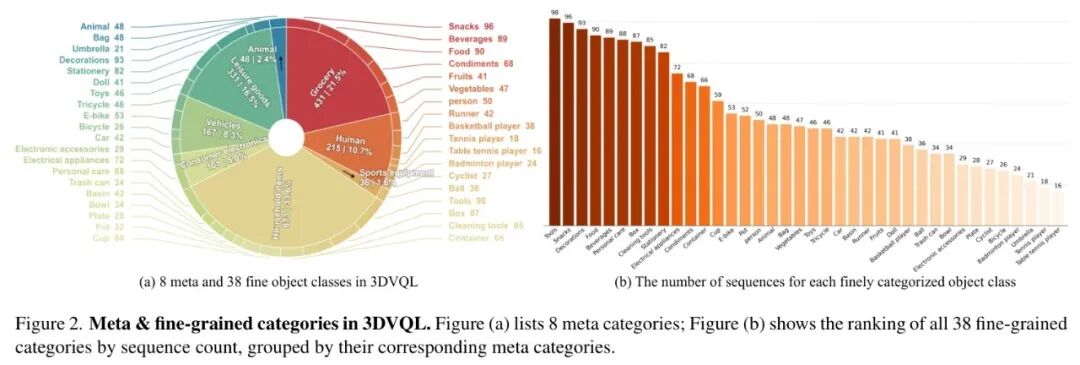
数据集的类别分布还揭示了一个重要特性:长尾分布。38个细粒度物体类别中,排名靠前的类别(如瓶子、椅子)序列数极多,而大量类别仅有少量样本。这种分布极好地模拟了真实场景的稀疏性,也对模型在尾部类别上的泛化能力提出了更高要求。
有了数据,还要有能打的方法。研究团队基于2D VQLoC架构构建了多种基线模型,并发现了一个反常识现象:加深单模态网络的层数,在3DVQL上反而可能导致性能下降。这说明核心瓶颈不是单模态特征的判别力,而是跨模态的可观测性与时空对齐。RGB图像易受运动模糊和遮挡影响,点云在远处稀疏且缺乏纹理细节——单一模态都无法稳定完成长时程定位。于是,作者提出了LaF(Lift and Fusion),一种将2D特征“提升”到3D空间中、再通过精心设计的时空Transformer进行融合的端到端方法。
🧠 思考时刻:你是否也在多模态融合项目中遇到过“加深网络反而效果变差”的情况?欢迎在评论区分享你的踩坑经历~
🚀 原理拆解:LaF如何将2D特征“提升”到3D空间?
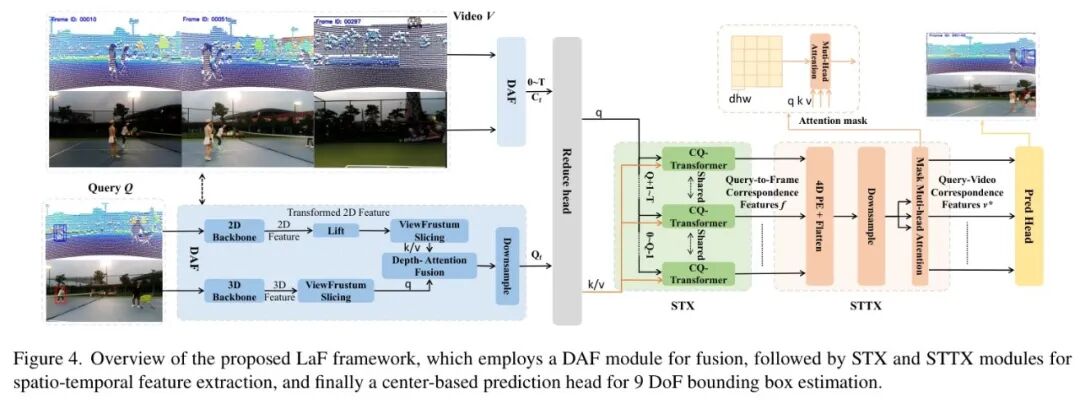
LaF的整体架构如下图所示。输入是查询图像Q和视频序列V,经过DAF(深度注意力融合)模块实现2D/3D特征提取与跨模态对齐,再由Reduce Head生成紧凑的查询特征,然后通过STX(共享CQ-Transformer)提取查询到每一帧的对应关系,STTX(时空Transformer)聚合时空信息,最终由Pred Head输出9自由度3D边界框。
💡 核心创新一:DAF——将2D像素提升到3D视锥体
DAF(Depth-Attention Fusion) 是LaF的第一个关键模块。它的目标是将2D图像特征与3D点云特征对齐并融合。具体思路借鉴了自动驾驶中的BEV感知思想:对于2D图像上的每个像素token,沿着该像素在3D空间中的视线方向扩展为一条射线,并只在相机视锥体内的3D体素中执行跨模态注意力。这样既保证了相关性,又极大降低了计算量。
DAF的实现分为三步:
- 视锥体切片根据相机参数,将3D空间划分为沿深度轴的多个切片(类似栅格化),每个切片对应一个深度区间。
- 2D特征采样将3D体素中心投影到2D图像平面,通过双线性插值采样对应的图像特征。
- 深度注意力融合沿深度轴对采样得到的2D特征与3D体素特征执行多头注意力,其中3D特征作为Query,采样2D特征作为Key和Value。这样可以在每个深度位置上动态权衡两种模态的贡献。
为什么这样设计? 直接逐元素加法或简单拼接无法处理跨模态的几何不对齐问题——3D点云中的某个体素可能对应2D图像中的多个像素(因为遮挡),反之亦然。DAF通过注意力机制让模型学习从2D图像中“挑选”出与3D体素最相关的视觉信息,同时沿深度轴保持几何连续性。
💡 核心创新二:STX与STTX——时空对应与聚合
在DAF得到对齐的多模态体素特征后,Reduce Head将整个时空体素特征压缩为一个紧凑的查询特征,作为后续Transformer的输入。
STX(Spatial Temporal Cross-Attention) 模块负责将查询特征与每一帧的特征进行对应。它使用共享的CQ-Transformer(CQ代表Cross-Query),让查询特征与每帧的体素特征进行交叉注意力,提取出“查询目标在每一帧中可能的位置激活图”。
STTX(Spatial Temporal Transformer) 模块则负责在连续的帧之间传递和聚合信息。它使用了4D位置编码(3D空间+时间),经过下采样降低分辨率后,通过带局部时间窗口掩码的多头注意力来建模帧间的依赖关系。这个掩码非常关键——它限制注意力只在时间窗口内的相邻帧之间计算,避免了全序列注意力带来的巨大计算开销,同时捕捉了物体运动的连续性。
最后,特征被上采样到固定分辨率,由3D预测头直接回归目标物体的9自由度姿态(中心坐标、尺度、偏航角、俯仰角、滚动角)和置信度分数。
💡 实战思考:DAF的设计其实隐含了一个重要直觉——在3D空间中,2D图像特征只有在正确的深度位置才有意义。如果直接把2D特征投射到所有体素,会产生大量噪声。DAF通过沿深度轴的注意力,让模型学会在哪个深度上信任2D特征,这比硬性投影或简单加法要灵活得多。
📊 实验验证:数据说话,LaF全面领先
🏆 SOTA对比:六项指标全部碾压
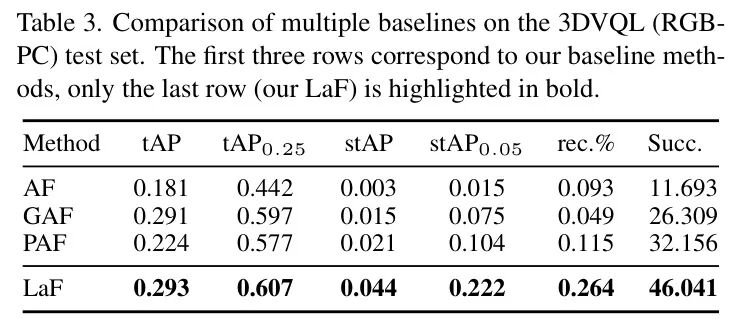
研究团队在3DVQL(RGB-PC)测试集上对比了三种基线方法(AF、GAF、PAF)与LaF的性能。下表展示了定量结果:
解读关键数据:
- • tAP(时空平均精度):LaF达到0.293,而最好的基线PAF只有0.181,提升62%。
- • tAP₀.₂₅:LaF达到0.607,PAF为0.387,提升57%。
- • Succ.(成功率):LaF达到46.041%,PAF为25.189%,接近翻倍。
- • Rec.%(帧级恢复率):LaF为59.997%,PAF为31.668%,同样大幅领先。
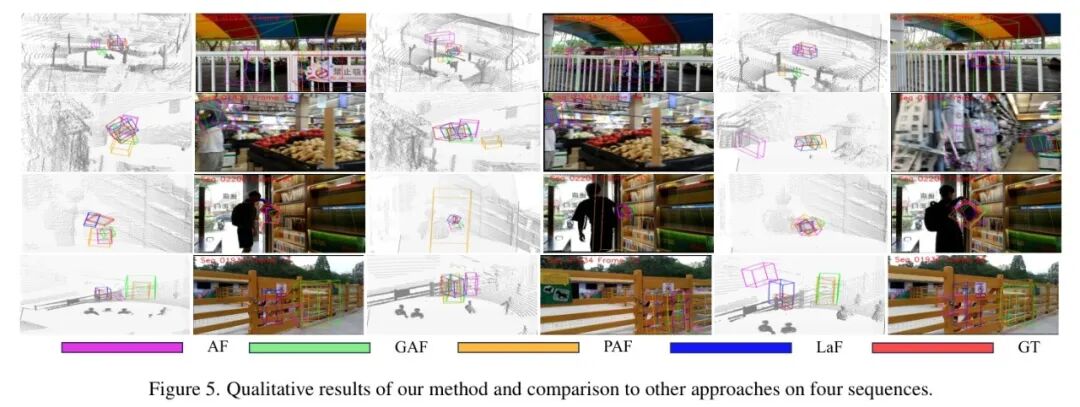
这些数字意味着什么?在真实场景中,LaF不仅能更准确地定位最新出现的3D目标,还能更完整地恢复目标的整个轨迹(Rec.%体现),并且定位的一致性更高(stAP体现)。以下是四个典型场景的3D边界框可视化对比:
🔬 消融实验:DAF模块是性能支柱
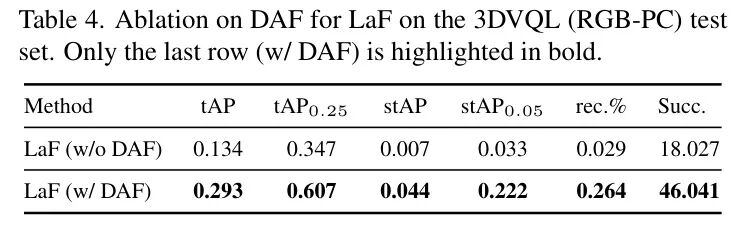
LaF的核心创新是DAF模块,表4的消融实验直接证明了它的关键作用:
指标变化触目惊心:
- • tAP:移除DAF后从0.293暴跌至0.134,降幅54%。
- • Succ.:从46.041%跌至18.027%,降幅61%。
- • Rec.%:从59.997%跌至24.042%,降幅60%。
这说明,如果没有DAF将2D特征正确提升到3D空间并进行几何对齐,模型几乎无法完成有效的3D定位。这也呼应了前文的核心观点——跨模态融合比单模态特征优化重要得多。
🔬 模态消融:多模态融合的胜利
表6进一步验证了不同模态组合的效果:
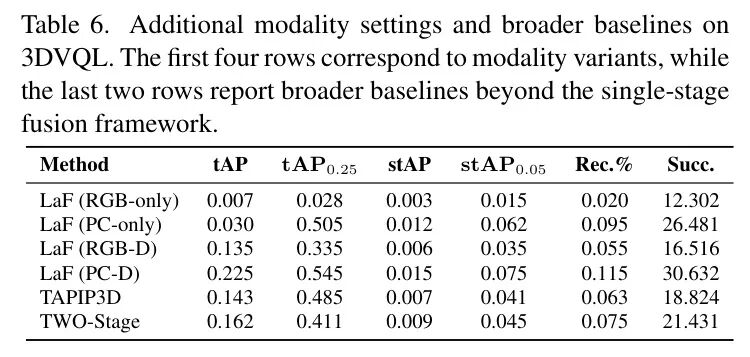
关键发现:
- • 仅RGB:tAP仅0.071,Succ.仅11.799%,远低于多模态变体。
- • 仅点云:tAP 0.152,Succ. 18.893%,比RGB好但仍有提升空间。
- • RGB-D:tAP 0.167,Succ. 22.091%,引入深度后RGB有一定提升。
- • PC-D(点云+深度):tAP 0.323,Succ. 49.529%,为所有模态组合中最高,甚至优于RGB-PC(0.293)。这说明点云与深度在几何结构上互补性更强,点云提供稀疏但精确的3D位置,深度提供密集但相对粗糙的距离信息,两者协同效果最佳。
此外,与TAPIP3D(点跟踪基线)和TWO-Stage(两阶段融合)的对比也进一步确认了LaF在单阶段端到端融合上的优势:TAPIP3D的tAP仅0.065,TWO-Stage为0.110,均远低于LaF。
🤔 深度思考:PC-D组合竟然优于RGB-PC,是否说明在3D定位任务中,几何信息(点云+深度)比外观信息(RGB)更重要?如果换成带纹理的点云(如RGB-D融合传感器),结果会不会更优?欢迎在评论区留下你的观点!
🌍 更多场景定性展示
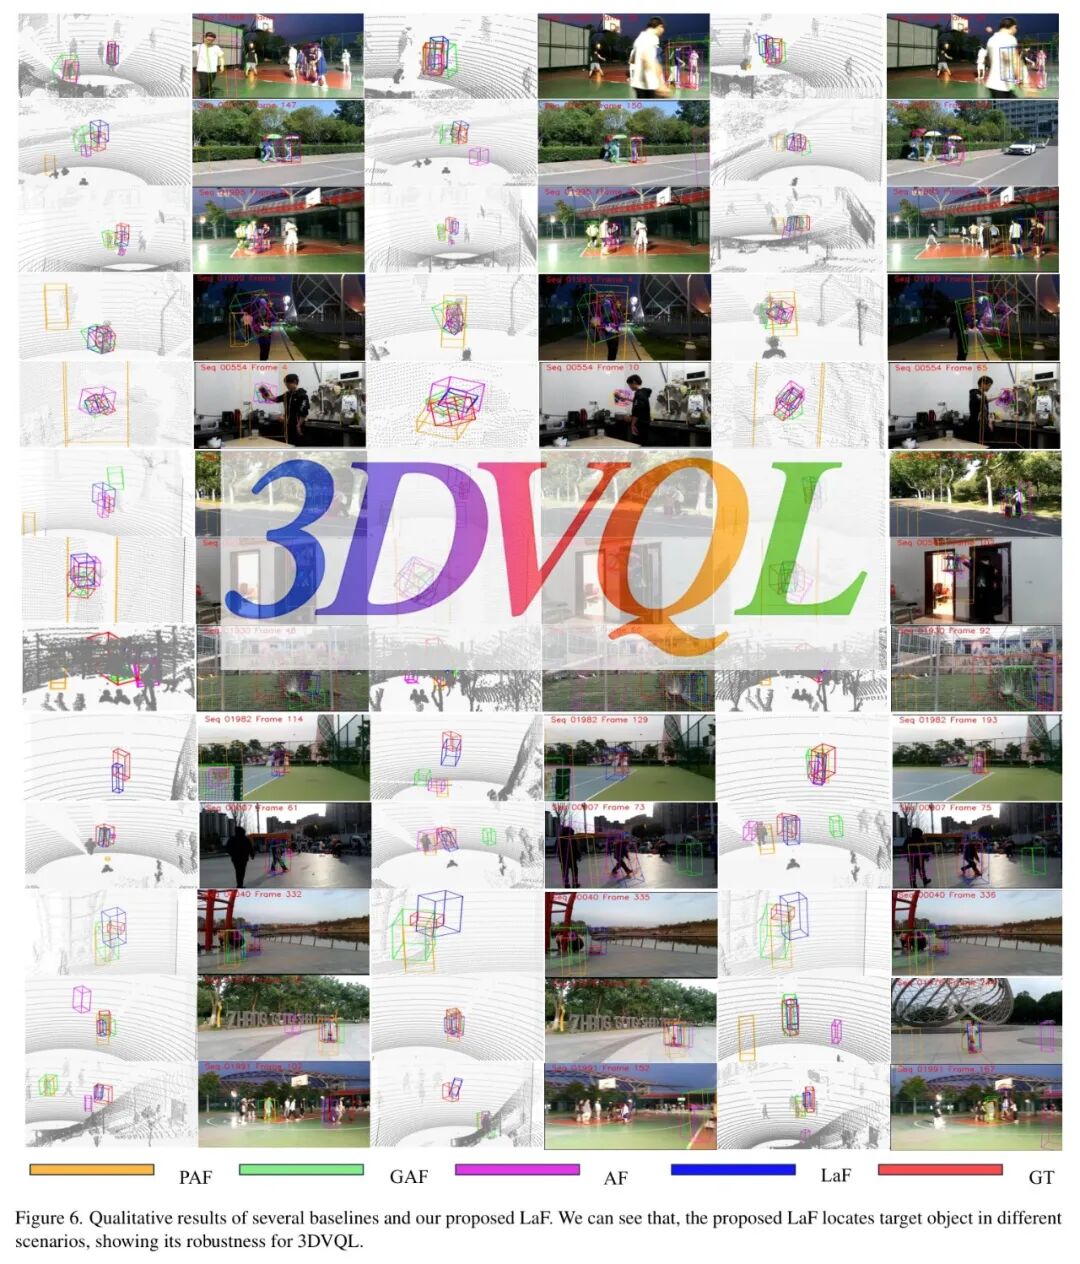
研究团队还提供了在更丰富场景(篮球场、街道、广场、建筑入口等)下的定性对比结果,进一步验证LaF的鲁棒性:
⚖️ 客观评价:局限性在哪里?
尽管LaF在3DVQL上取得了显著优势,但仍存在一些可改进之处:
- • 计算开销:DAF模块中的视锥体切片和沿深度轴注意力涉及大量跨模态计算,虽然相比全空间注意力已经高效,但在移动机器人等资源受限平台上仍有优化空间。
- • 对传感器标定的依赖:DAF需要精确的相机-LiDAR标定参数,实际部署中标定误差可能会影响融合效果。未来可以探索自标定或在线校准方法。
- • 长尾类别表现:虽然整体指标领先,但论文未单独分析长尾类别上的性能。从数据集分布看,尾部类别样本极少,模型在这些类别上的泛化能力可能需要更多数据增强或few-shot学习策略。
🌟 价值升华:为什么这项工作是里程碑?
总结三个核心收获:
- 首个3D VQL基准数据集3DVQL为研究者提供了从2D迈向3D的标准化测试平台,填补了空白,并公布了全部代码和数据集链接(https://github.com/wuhengliangliang/3DVQL),极大降低了研究门槛。[1]
- 跨模态融合的新范式LaF的DAF模块将2D特征“提升”到3D视锥体,是几何先验与注意力机制的巧妙结合,为多模态3D感知提供了新思路。
- 数据驱动的发现该工作用大量实验证明,跨模态融合比单模态网络深化更重要——这一反常识结论值得所有从事多模态研究的同行深思。
💝 互动时间:你认为LaF最可能落地的场景是什么?是机器人抓取、增强现实,还是自动驾驶?点赞+在看支持原创技术解读,分享给更多需要的同行!设为星标,第一时间获取深度技术干货!
#AI技术 #3D视觉 #多模态融合 #数据集 #论文解读
参考
Towards Visual Query Localization in the 3D World
引用链接
[1]: https://github.com/wuhengliangliang/3DVQL),极大降低了研究门槛。