LLM金融分析师竟能击败人类专家?揭秘SpaceX IPO背后的AI“超脑”革命
“IPO Finance Agent: Evaluation of LLM Financial Analysts beyond Finance Agent v2, with Automated Rubric Generation - the Case of the SpaceX (SPCX) IPO”
SpaceX的S-1文件长达数百页、交叉引用如迷宫般复杂时,就连最前沿的AI模型也曾彻底“罢工”——Finance Agent v2的朴素分块检索压根无法输出结果。然而,一项名为IPO Finance Agent的新研究彻底改写了格局:通过引入“上下文检索”技术,研究人员构建了一套自动化评分流水线,让Qwen 3.7 Max以79.4%的准确率、单次查询仅0.30美元的成本,碾压了Finance Agent v2天花板(57.9%)。更令人震惊的是,MiMo-2.5 Pro以0.05美元成本达到76.8%准确率,成本效率碾压所有竞品。这不仅是技术突破,更是一场金融分析民主化的开端——AI正从“读得懂”走向“看得透”。
【 扫描文末二维码加入星球获取论文,源码 】
摘要
IPO Finance Agent是一个新的基准测试,旨在评估大型语言模型(LLM)在首次公开募股(IPO)尽职调查任务上的表现。与专注于上市公司定期报告(如10-K和10-Q文件)的现有基准 Finance Agent v2 不同,IPO Finance Agent 专门针对 IPO 注册声明(S-1文件)的独特挑战而设计。
作者指出,S-1文件的长度远超定期报告,且包含复杂的财务报表重述(如共同控制实体会计处理)、公司治理结构、资本形成叙事以及承销相关的风险披露。原始的 Finance Agent v2 框架在处理 SpaceX 的 S-1 文件时因文档过长而无法输出结果。因此,本文在任务领域和检索架构两个维度上对 Finance Agent v2 进行了扩展:
任务领域扩展:专注于 IPO 尽职调查,并创建了一个包含 1,000 个问题的数据集,其中 70 个关于 SpaceX S-1 的问题已公开发布,其余部分用于防止基准污染。
检索架构改进:采用 上下文检索(Contextual Retrieval) 替代了 Finance Agent v2 的朴素分块检索,以更好地处理长文档和交叉引用。
此外,本文还引入了一个 评估-优化器流水线(Evaluator-Optimizer Pipeline),用于自动生成评分标准。该流程从模型答案中提取事实,整合成草稿标准,然后通过 LLM 反馈进行迭代修复、定向扩充和去重,最后由人类专家进行最终审核。
主要结果显示,在公开的 70 个问题上,性能最好的模型是阿里巴巴的 Qwen 3.7 Max,达到了 79.4% 的准确率,单次查询成本为 0.30 美元。成本效率最优的模型是小米的 MiMo-2.5 Pro,准确率为 76.8%,成本仅为 0.05 美元/查询。这两个结果均显著超过了 Finance Agent v2 的当前最高分——Google Gemini 3.5 Flash 的 57.9%(成本 2.51 美元/查询),并且在成本效益上也优于 FABv2 最便宜的参赛者 MiniMax M3(48.3% 准确率,0.32 美元/查询)。
简介
背景与动机
大语言模型正被部署为金融研究助理,但基准测试结果不仅取决于模型能力,还受检索架构、工具接口和评估方法影响。Finance Agent v2 是评估 LLM 在 SEC 文件(10-K/10-Q)上表现的主流基准,但它仅覆盖了已上市公司的定期报告。
IPO 尽职调查的独特挑战
IPO 尽职调查(尤其是S-1文件分析)是一项不同的任务。S-1文件内容更为复杂,包括预估披露、关联交易、治理结构、承销风险因素等,且缺乏过往财报、市场共识或披露历史的锚定。其长度也远超典型的 10-K 或 10-Q 文件,导致简单的文本分块检索(如 Finance Agent v2 所用)难以提取到分散在文档各处的相关证据。作者团队在实验中发现,原始的 Finance Agent v2 框架甚至无法完成对 SpaceX S-1 完整文件的评估。
主要贡献
IPO 尽职调查基准: 一个包含 1,000 个问题的数据集,涵盖 六个领域(细分市场经济学、KPI质量、治理结构、会计机制、执行风险、估值与承销),并按 六种专业工作流(投行、公开市场投资、风投、信用分析、证券法律、会计咨询)进行标注。其中 70 个关于 SpaceX S-1 的问题公开发布。
上下文检索架构: 用上下文检索替换 Finance Agent v2 的朴素检索,解决长文档和交叉引用问题。
自动化评分标准生成流水线: 一个迭代的评估-优化器循环,通过从多模型答案中提取、整合、评估事实,自动生成并审核评分标准,减少了对人工标注的依赖。
相关工作
金融 QA 与 LLM 基准
回顾了从早期单回合、单文档的金融 NLP 基准(如 FinQA, TAT-QA, ConvFinQA)到更全面基准(FinBench, MultiFinBen)的发展。IPO Finance Agent 区别于这些工作的核心在于其对 IPO 尽职调查和 S-1 文件的关注。
Finance Agent 基准
重点介绍了 Finance Agent 及其 v2 版本。FABv2 代表了向智能体(Agent)评估的转变,要求模型使用工具自主搜索、检索和综合信息,并通过专家编写的评分标准进行打分。它已成为事实上的行业标准,被 OpenAI(GPT-5.5 得分为 60.0%)和 Anthropic(Claude Opus 4.8 得分为 53.9%)等前沿模型开发商所引用。IPO Finance Agent 采纳了 FABv2 的评估哲学,但应用于其未覆盖的首次注册声明领域。
风险投资与初创企业评估
提及了评估早期公司阶段的基准(如 VCBench, YC Bench),而 IPO Finance Agent 专注于从私有到公开市场的过渡阶段。
智能体基准与整体评估
将本文置于 HELM、AgentBench、SWE-bench、GAIA 等更广泛的智能体评估工作背景下,表明其评估的是专业金融尽职调查任务。
IPO 与 S-1 特定分析
引用了会计和金融文献,指出 IPO 招股说明书分析因其预估报告、共同控制交易等特点,是不同于定期报告分析的独立学科。本文是首个针对 S-1 尽职调查任务构建的智能体基准。
长金融文档检索
讨论了朴素分块检索的局限性,并指出 Anthropic 的 上下文检索 方法(为每个分块添加文档级上下文进行索引,如公式 chunk_context = LLM(query: "Provide context for this chunk"))是应对 S-1 这类长且结构化文档的有效解决方案。
自动化评分标准构建
采用了 Anthropic 提出的评估器-优化器模式。该模式通过一个模型生成候选答案,另一个模型根据标准进行评估,并将反馈作为下一轮生成的输入,迭代直至收敛。本文将此模式应用于评分标准构建本身,通过事实提取、整合、评估、修复和扩充来自动化生成标准。
数据集构建
案例研究选择(SpaceX S-1)
选择 SpaceX S-1 作为公开发布部分的案例,原因有三:1)其业务结构复杂(发射服务、星链、xAI相关),需要跨细分市场推理;2)包含共同控制实体财务重述,这是 IPO 会计中的典型挑战;3)其估值问题需结合二级市场数据(Forge Global, 纳斯达克私人市场)和同行对比,而非公开交易历史。
问题分类法
涵盖了 IPO 尽职调查的 六个领域:
细分市场经济和运营绩效
KPI 质量和变现能力
治理和控制结构
会计和共同控制重述机制
执行风险和资本需求
估值和承销分析
专业工作流程标注
每个问题还按 六种专业工作流 进行标注,以支持按受众群体细分结果。
公开/私有划分
为控制基准污染,仅公开 70 个关于 SpaceX 的问题,其余 930 个问题私有保存。
方法论
智能体框架与上下文检索
采用与 Finance Agent v2 类似的工具使用框架(网页搜索、EDGAR访问)。关键创新是使用 上下文检索 替代朴素分块检索。该方法为每个分块嵌入一个简短的、基于文档内容的描述,使其在隔离状态下也能被正确检索和解释,有效解决了长 S-1 文件中的检索失败问题。
自动化评估流水线
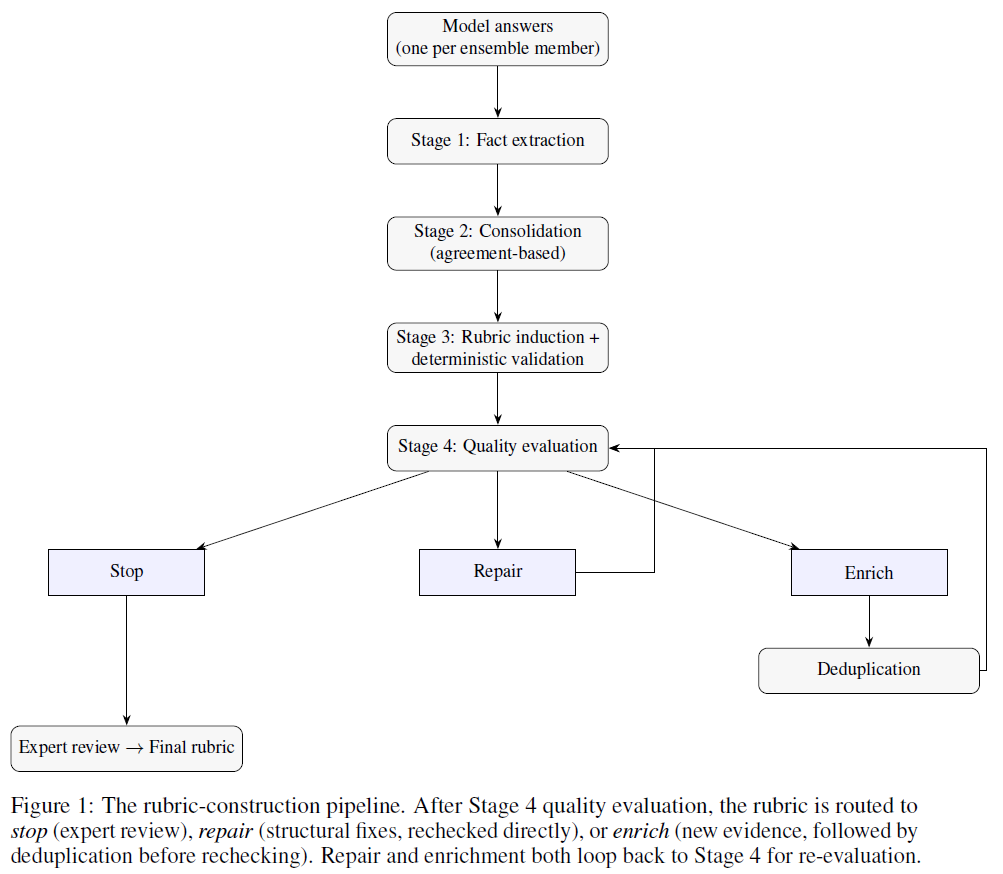
阶段 1 - 事实提取: 从 GLM 5.1, Qwen 3.7 Max, Kimi K2.6 和 MiMo 2.5 Pro 四个模型的答案中提取原子事实。NVIDIA Nemotron 3 Ultra 因失败过多被排除。
阶段 2 - 事实整合与规范化: 通过确定性方法和增量 LLM 方法合并和规范化跨模型的事实。只保留满足最低一致性阈值(本文设为 2 个模型)的事实。
阶段 3 - 评分标准归纳: 基于整合后的事实,归纳出包含层次语义(区分必备标准和补充标准)的评分标准草案。之后进行确定性验证和修复,确保格式和结构正确。
阶段 4 - 质量评估: 使用 GLM-5.1 对初步评分标准在特异性、原子性、层级正确性和覆盖度四个维度上进行评分,并推荐下一步行动:
结构修复(Repair): 针对可通过重新组织现有内容修复的缺陷。
定向扩充(Enrich): 针对需要新证据的覆盖缺口。评估器会生成缺口规范,并从原始模型答案中重新提取相关事实。
停止(Stop): 当质量标准达标时。
防幻觉机制: 在结构修复步骤中,任何引入新数值或货币值的修改都会被标记和丢弃。
去重: 针对扩充步骤后引入的近似重复标准进行处理。
人类专家审查: 最终通过的评分标准在部署前需经人类专家对照源文件审查,以捕捉自动化流程可能存在的系统性偏差。
实验结果
整体表现
在 70 个公开发布的 SpaceX 问题上,对五个模型进行了测试,以平均每问题得分(0-1)为指标。
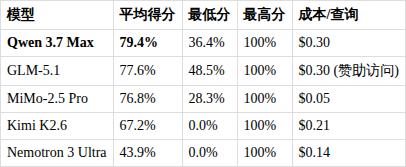
前三名模型的得分非常接近(76.8%-79.4%),表明在强大的智能体框架下,前沿模型的能力趋于收敛。
与 Finance Agent v2 比较
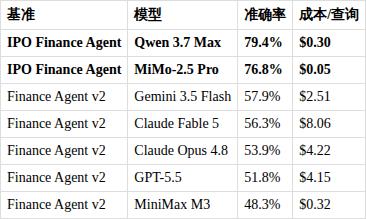
IPO Finance Agent 的表现全面超越了 FABv2 的当前记录。Qwen 3.7 Max 比 FABv2 最高分模型 Gemini 3.5 Flash 高出 21.5 个百分点,而 MiMo-2.5 Pro 在提供更高准确率的同时,成本仅为 FABv2 最便宜模型 MiniMax M3 的约六分之一。作者也提供了重要提醒:两个基准的评分指标不完全相同,FABv2 有“交易破坏者”门控机制,因此直接比较需谨慎。
成本-准确性权衡(帕累托分析)
在已知成本的模型中,MiMo-2.5 Pro(76.8%, $0.05)和 Qwen 3.7 Max(79.4%, $0.30)构成了高准确性-低成本的前沿。Kimi K2.6 和 Nemotron 3 Ultra 均被这两个点所支配。
按领域和工作流程细分
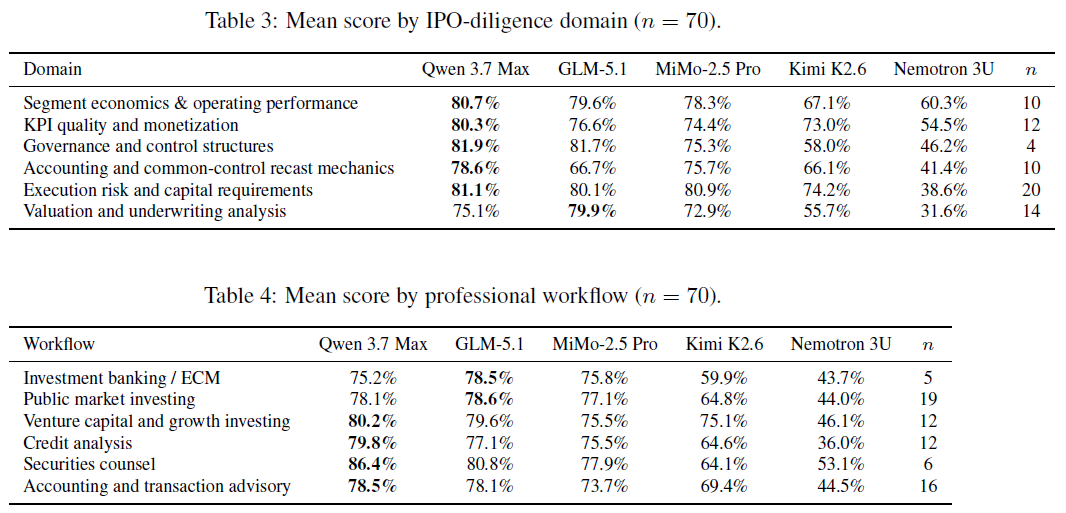
Qwen 3.7 Max 在六个领域中领先五个,但 GLM-5.1 在“估值和承销分析”领域表现最好(79.9% vs 75.1%)。按工作流程看,Qwen 3.7 Max 在“证券法律”工作流上优势最大(86.4%),而 GLM-5.1 在“投资银行”和“公开市场投资”上排名第一。
讨论
框架质量 vs. 问题难度: 本文的核心论点之一是,IPO 尽职调查推理(涉及治理、会计重述等)的难度不亚于 Finance Agent v2 中公认的难题(如金融建模),但 IPO Finance Agent 的测试模型却取得了远高于 FABv2 上限的结果。作者认为,这更可能是一个框架质量的解释,而非问题更简单:三个独立的模型家族得分非常接近(77-79%),这表明一个强大的检索框架可靠地找出了正确的证据,使得多个有能力的模型都能正确地基于此进行推理。尽管如此,作者承认并未进行严格的消融实验来量化上下文检索的独立贡献。
总结
本文成功地将 Finance Agent 基准从定期报告分析扩展到了 IPO 尽职调查。通过采用上下文检索的智能体框架和自动化评分标准生成流水线,验证了多个前沿模型在 S-1 文件分析任务上的性能,结果显著优于 Finance Agent v2。
未来工作:
1)报告多次运行结果的方差;
2)分析工具调用模式;
3)通过消融实验隔离上下文检索的贡献;
4)将 S-1 分析定位为评估 LLM 作为工作流感知型金融研究智能体的宝贵、目前尚欠标准化的测试平台。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
