让GPT-5.4直呼内行!蚂蚁开源Ling‑2.6和Ring-2.6模型,把Agent玩出了花
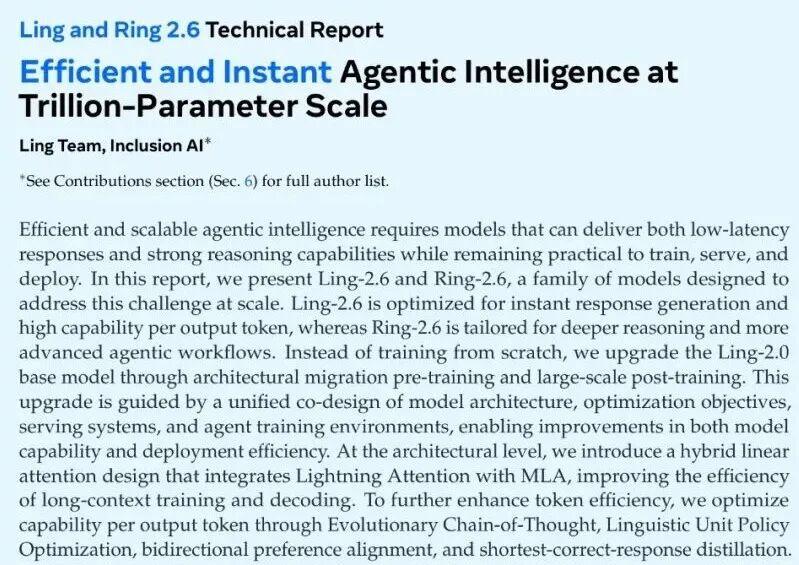
你敢信?一个万亿参数模型,输出 token 仅用了 1600 万,就在多个基准上正面硬刚 GPT‑5.4,甚至智能体任务一把夺冠——而它居然还敢开源权重,带着所有训练黑科技全盘托出。这就是 Ling‑2.6 和 Ring‑2.6 系列,专为“既要即时响应,又要深度推理,还要稳稳跑通复杂 Agent 工作流”而生的万亿参数实用智能体。
🔥 开源代码与权重已放出:
- • GitHub:https://github.com/inclusionAI/Ling-V2.5[1]
- • 即时模型:https://huggingface.co/collections/inclusionAI/ling-26[2]
- • 思考模型:https://huggingface.co/collections/inclusionAI/ring-26[3]
核心痛点:为什么“快”和“强”总是死对头?
大语言模型正从聊天界面冲向真实的 Agent 世界——它要能看懂代码库、调用工具、多轮搜索、规划长工作流。但一个残酷的现实摆在面前:更深的推理意味着更长的生成、更高的延迟、更贵的 token 成本;而追求响应速度的模型,往往一遇到复杂 Agent 场景就掉链子。
更致命的是,长上下文虽然扩展了记忆,却把传统注意力机制推向了计算灾难。当上下文超过 32K token,基于 GQA 的模型里注意力计算能吃掉 60% 以上的总 FLOPs,KV 缓存也像滚雪球一样吃掉显存。
于是几乎所有团队都在被迫做权衡。但有没有一种可能?模型既能在“低成本、低延迟”象限中占据顶端,又能在十几个权威基准上同时打败一众 SOTA?
Ling‑2.6‑1T 给出了答案。
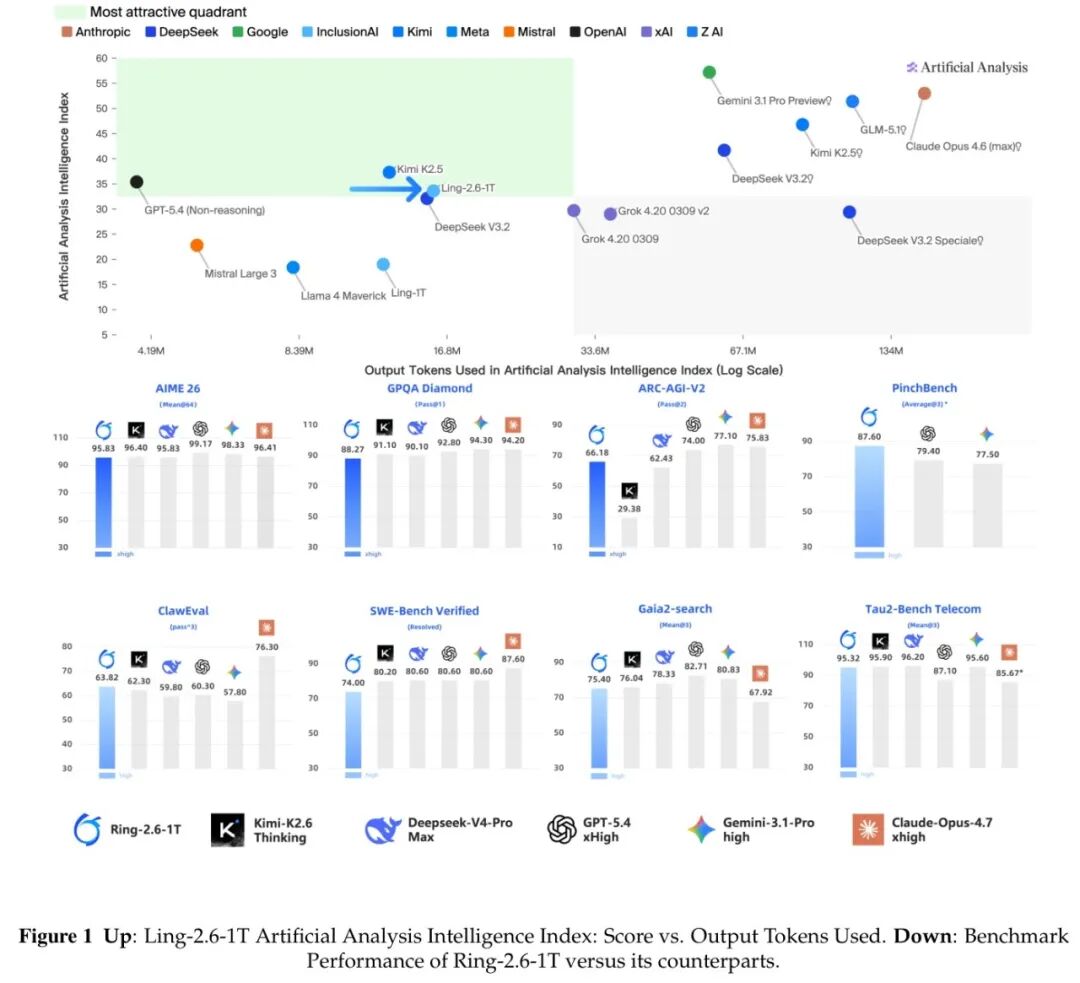
从散点图中能清楚看到:Ling‑2.6‑1T 仅用约 1600 万输出 token 就拿到了 34 分的智能指数,与非推理设置的 GPT‑5.4 处于同一水平,却大幅拉低了推理成本。而下方的 8 组柱状图更进一步——AIME 26、GPQA Diamond、SWE‑Bench Verified、Gaia2‑Search 等一系列硬核榜单上,它要么持平、要么碾压 Kimi‑K2.6、DeepSeek‑V4‑Pro、Gemini‑3.1‑Pro 等对手。
这还不是全部。它的“思考”兄弟 Ring‑2.6‑1T 同样在 OpenClaw、Agentic Search、函数调用等真实 Agent 测试中杀到了第一梯队。秘密究竟藏在哪里?答案就是:一套被推到极致的架构-训练-系统协同设计。
🚀 原理拆解:万亿 Agent 的三大杀招
Ling‑2.6 和 Ring‑2.6 不是凭空造出的。它们是站在 Ling‑2.0 巨人的肩膀上,通过混合注意力改造、大规模持续预训练,以及一整套 Agent 原生后训练范式,把“效率”和“智能”同时推上了新台阶。下面,我们硬核拆开它的内核。
💡 混合注意力架构
先上总览。下面是 Ling‑2.6‑1T‑base 的完整结构图,一图胜千言。
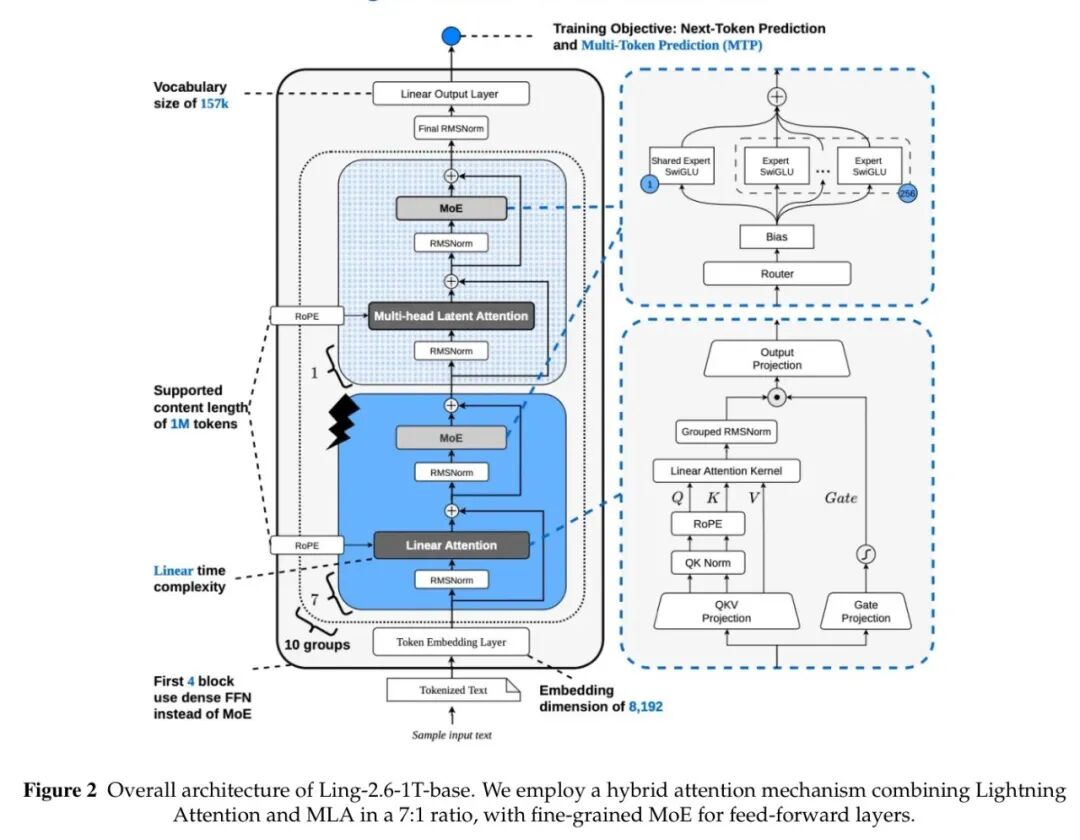
你看,前 4 个 Transformer 块老老实实用了稠密 FFN,从第 5 层开始画风突变:以 7:1 的比例堆叠 Linear Attention 层和 MLA 层,并且 MoE(混合专家)大放异彩。右侧的细节图透出了注意力内部和 MoE 路由的设计,而最顶上的训练目标赫然写着 Next‑Token Prediction 和 Multi‑Token Prediction(MTP)——这已经在为推理加速埋下伏笔。
为什么是 7:1?为什么不是 1:1 或 15:1?这就得看关键的比例消融实验了。让我们先领会一下混合注意力的核心思想。
传统的 Softmax 注意力复杂度是 ,序列一长就玩不转。线性注意力则把复杂度降到 ,再配合 MLA 把 KV 缓存压缩到低秩潜在空间,显存压力骤减。但把线性注意力和 MLA 粗暴地混在一起,模型会不会直接学崩?作者没有拍脑袋,而是用 Scaling Law 把最优比例给跑了出来。
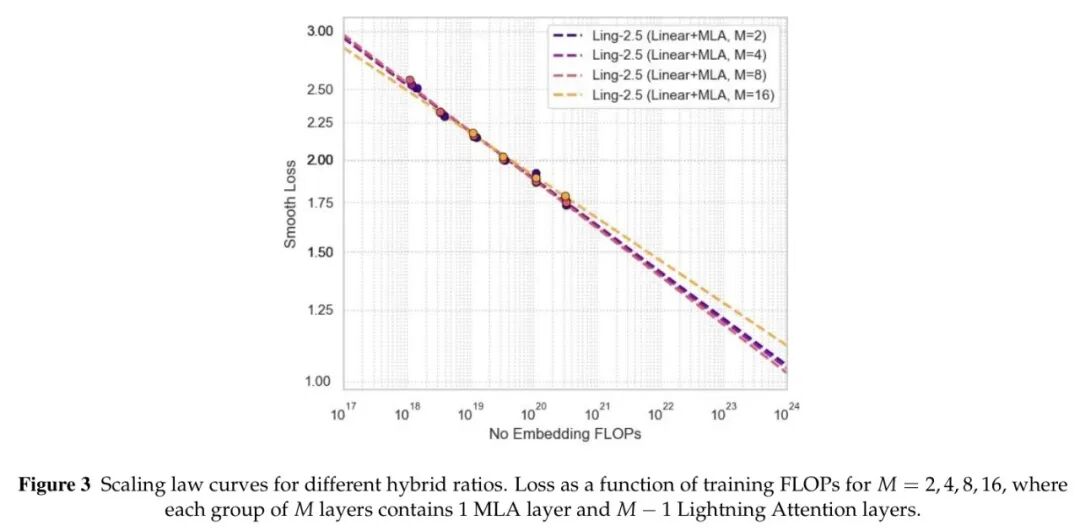
图中四条曲线分别对应 M=2,4,8,16,也就是每组包含 1 个 MLA 层和 M‑1 个线性注意力层。随着训练 FLOPs 增加,所有配置的损失都在下降,但如果仔细看高 FLOPs 区域,M=8(7:1)的曲线不光没有崩,还稳稳压过了比例更极端的 M=16。
这份 Scaling Law 为整体架构拍板:7:1 混合比例,在性能与推理成本之间拿到了黄金平衡点。
从表 1 可以看到,Ling‑2.6‑1T 的配置表里,层数 80、注意力头 64、隐藏维度 8192,同样是 MoE 结构,256 专家、每 token 激活 8 个专家、1 个共享专家,但相比 flash 版本,容量直接拉满。
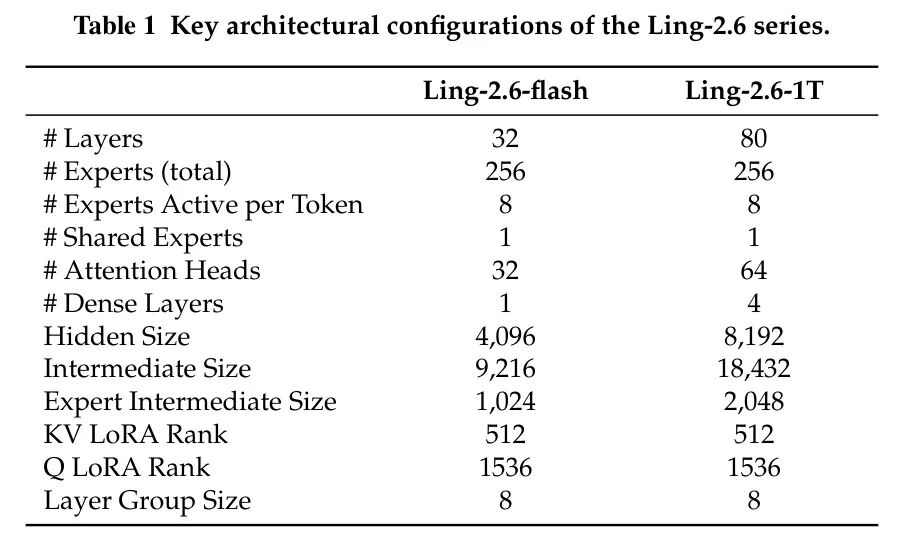
这样的设计意味着,flash 版本主打轻快,而 1T 版本在相同专家拓扑下用更多层和更大维度去学习更深层次的特征。
💡 平滑架构迁移:10 万亿 token 的华丽转身
你可能会问:把一个 20T token 预训练好的 Ling‑2.0‑1T 权重重构成全新的混合注意力架构,不就等于让一个油车发动机直接烧氢气?这中间的设计甚至比重新训练还要精妙。
作者设计了一条“四阶段迁移训练”管线,总共继续预训练约 9.6T token,稳扎稳打地完成了架构基因的重写。
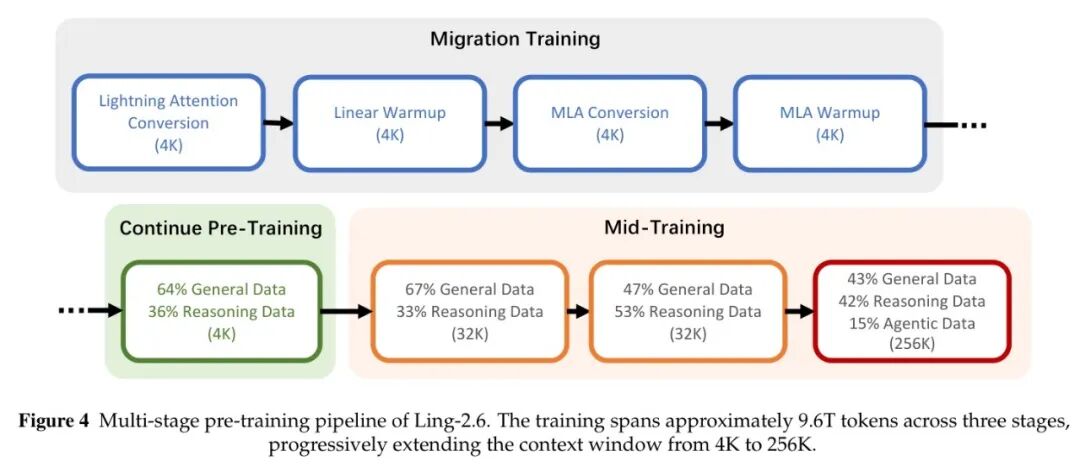
第一阶段的上半部分,模型先温和地将 Lightning Attention 替换进来,搭配线性预热;随后再进行 MLA 转换和 MLA 预热。等架构彻底稳定后,左下角的持续预训练阶段用 64% 通用数据 + 36% 推理数据,在 4K 上下文下继续吸收知识。最后到了右下角的中训练阶段,动态调整数据配比,并把上下文窗口一口气推到 256K。
这种“不改结构直接上长上下文”的粗暴做法,往往会在训练中产生剧烈的路由不均衡甚至 OOM。为此,团队在预训练阶段激进地压榨 GPU 显存以提升 FLOPs 利用率,而在长上下文后训练阶段切换为保守内存策略,吸收波动、优先稳定。他们甚至发现某些 MoE 算子因为 token 数量超过 32 位整数的上限而崩溃,于是把关键路径全部改为 int64 索引。这些隐形的工程细节,才是万亿模型能平稳落地的真正护城河。
💡 后训练:把每个 token 榨出最大智能
光有一个好底子还不够。Ling‑2.6 的设计目标里有一条近乎偏执的追求:不降低回答质量的前提下,把输出 token 数压缩到极致。这就引出了一整套围绕“Token 效率”的后训练组合拳。
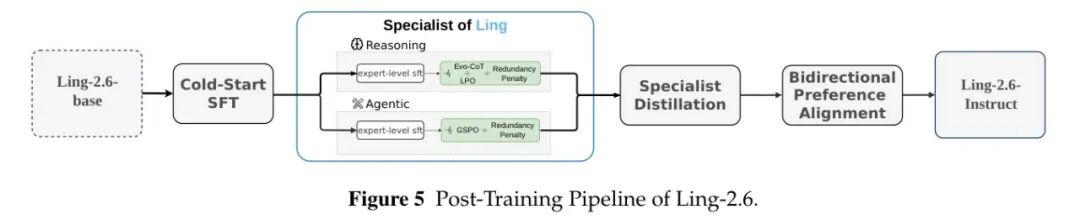
整个流程分为四步:Cold‑Start SFT 先打基础,然后进入核心的“专家分化”阶段,推理分支和智能体分支并行训练——推理侧用 Evo‑CoT(进化思维链)自动修剪冗余推理步骤,再结合 LPO(语言单元策略优化),把优化粒度从单个 token 提升到语义连贯的语言单元,防止模型为了凑分而刷 token 重复。
另一条智能体分支则通过 expert‑level SFT 和 GSPO,让模型在工具调用、工作流执行等真实环境中逐渐变强,并且两路专家最后通过蒸馏和双向偏好对齐融合:Reward 信息丰富且满足约束的输出,惩罚逻辑错误和公式化冗长。
这种“最短正确响应蒸馏”的思路,最终让 Ling‑2.6 在推理负载上实现了比 2.0 代约 4 倍的 token 效率提升。换句话说,同样一个问题,它用更短的回复就能给出同等甚至更优的答案,这直接意味着更低的 API 费用和更流畅的用户体验。
💡 原生 Agent 训练:KPop 与异步 RL 的化学魔法
如果说 Ling‑2.6 是极致高效的即时响应者,那 Ring‑2.6 就是深思熟虑的 Agent 大脑。它的后训练流程更强调“可控深度推理”。
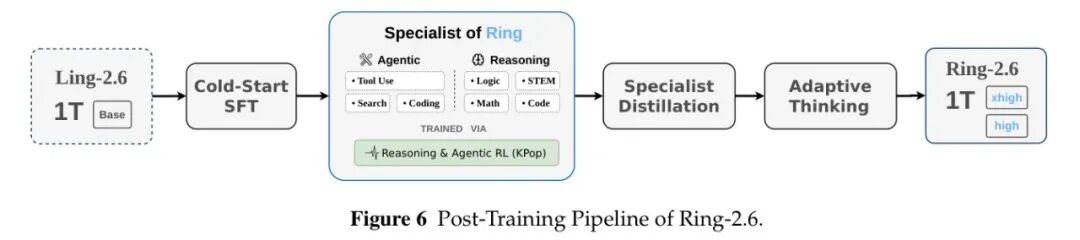
这里最亮眼的是 KPop——一种新型的强化学习算法。以往 Agent RL 面临两大噩梦:长轨迹导致 GPU 空转等待环境反馈,以及策略更新过程中的不稳定。KPop 用二进制 KL 散度替代了固定比率约束,稳住了训练;同时,作者把轨迹收集和参数更新完全解耦,形成了异步 RL 流水线。
配合这个异步框架,一个叫 ARouter 的全局路由系统登场了。
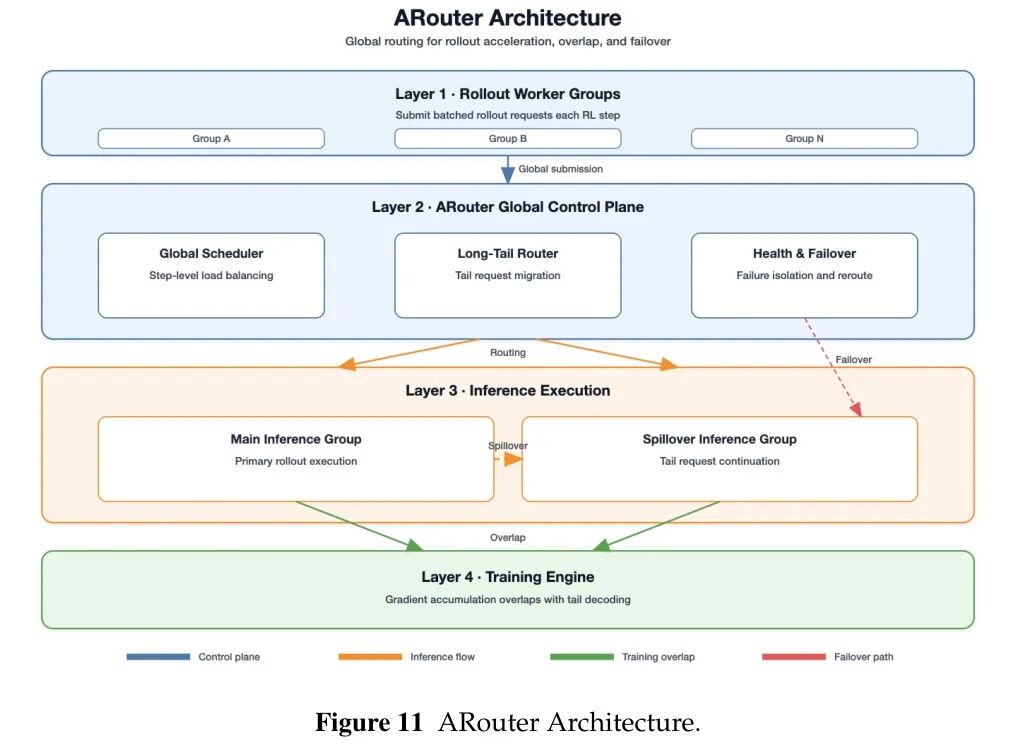
ARouter 会追踪每一个推理实例的负载和生成进度,一旦发现个别“拖后腿”的长尾请求,立刻把它们从拥挤的实例迁移到空闲实例。更重要的是,它的“溢出机制”允许主推理组在迁移长尾请求后,立刻释放算力去进行训练侧的梯度累积,完成后再合并尾部结果——这套“训练-推理重叠”直接把端到端性能提升了 80% 以上,彻底告别“一个请求卡全组”的灾难。
Agent 编程任务还需要可靠的环境。为此,团队用 Claude Code 结合 MCP 工具,自动为每一个代码任务生成 Docker 镜像与测试脚本,并通过验证闭环确保环境可用。
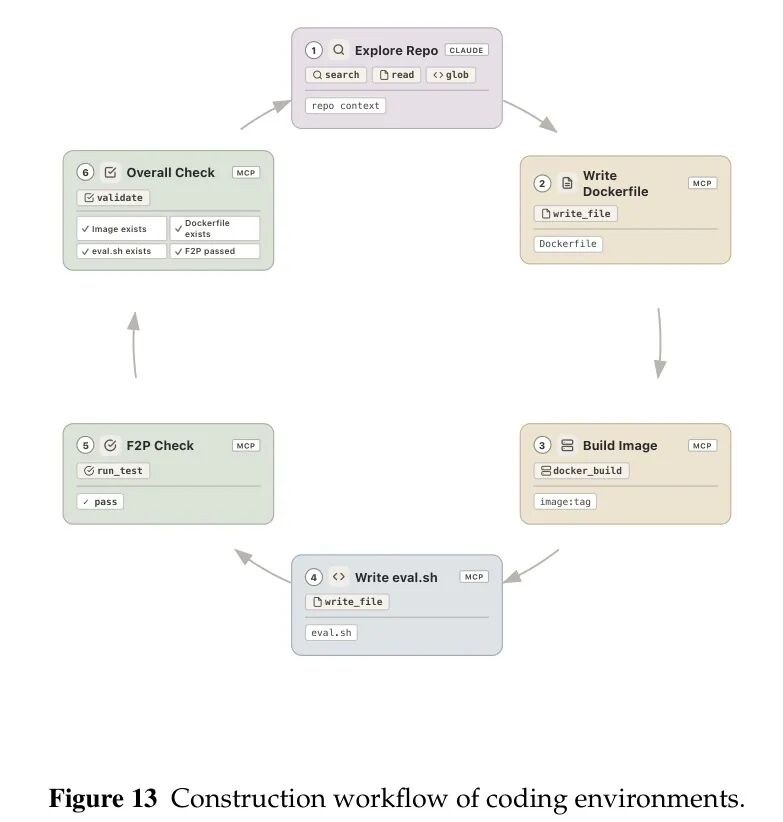
这个自动化产线在短时间内生成了约 22 万个可靠 Docker 镜像,从源头保障了 Agent RL 的 rollout 可复现性。
💡 推理加速:算子融合 + MTP,让生成飞起来
万亿模型光训得好不够,还得跑得快。Ling‑2.6 在推理侧下了一盘协同设计的大棋:算子融合和多 Token 预测(MTP)。
linghe 推理框架把注意力模块和 MoE 模块里散落的小算子熔合成大 Kernel,大幅减少了 Kernel launch 和显存访问开销。
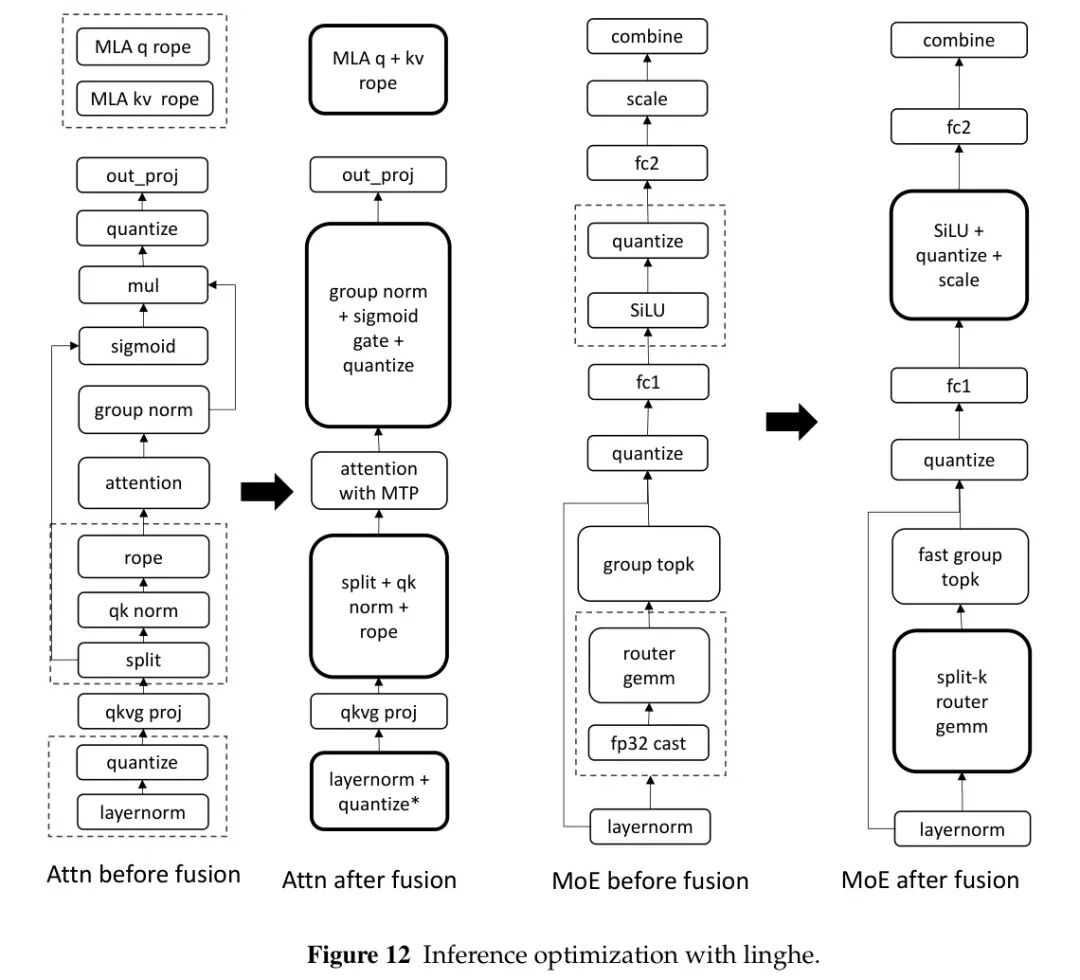
图:注意力与 MoE 模块融合前后对比——将 layernorm、量化、RoPE、门控等算子合并,降低推理延迟。
配合 MTP 进行推测解码,效果有多猛?看看吞吐量表:
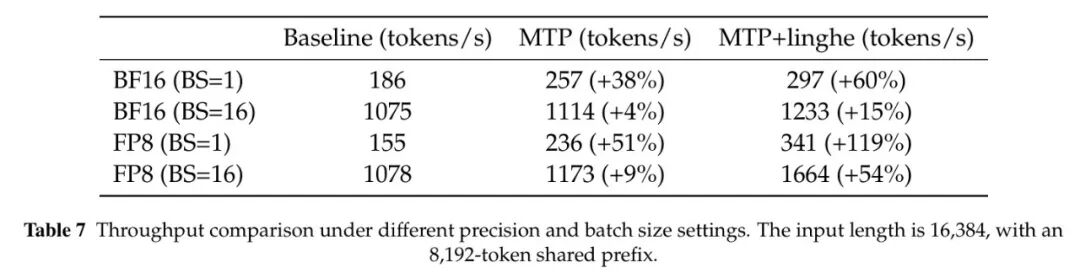
在 FP8 精度、batch size=1 的场景下,MTP+linghe 的组合相对于基线直接提升了 119% 的吞吐量。这意味着实际用户能感受到更低的延迟、更流畅的输出。
不仅如此,针对线性注意力在长上下文分布式训练中的顺序依赖问题,团队设计了一套基于 AllGather 的上下文并行优化,把通信与计算完美重叠,256K 上下文下端到端加速 68%。
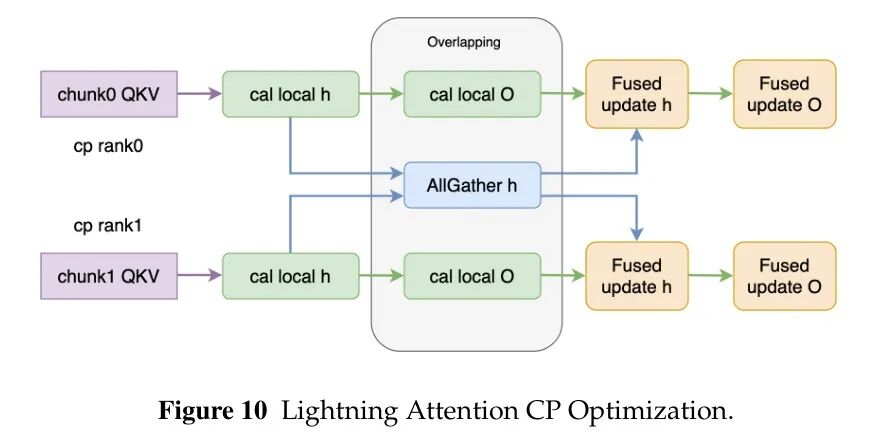
这些优化叠加起来,最终在基准吞吐量测试中展现了极强的长序列扩展能力:
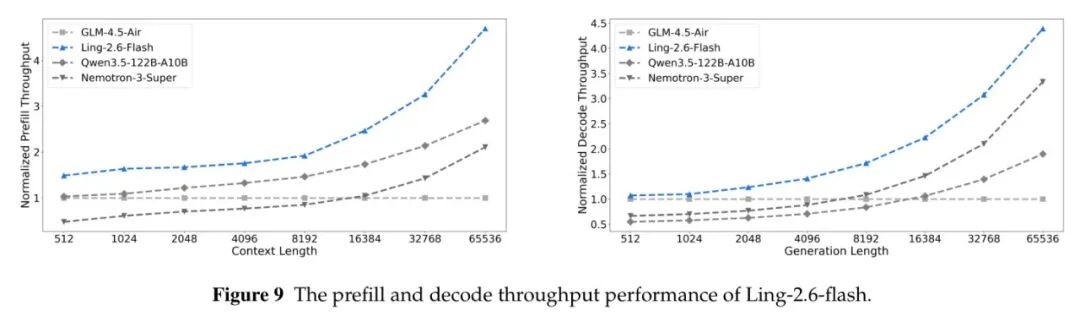
从 512 token 到 65536 token,Ling‑2.6‑Flash 的归一化吞吐量保持稳定高位,而部分竞品在长序列下明显掉速。
📊 实验验证:数据说话,Ling 和 Ring 到底有多能打?
原理论述再漂亮,也得用硬指标验证。2.6 系列在知识、推理、代码、数学、长文本和 Agent 能力等多个维度进行了地毯式轰炸。
🏆 SOTA 全面对比
先看基础模型的能力跃迁。下表展示了从 Ling‑2.0 到 Ling‑2.6 的底座进化。
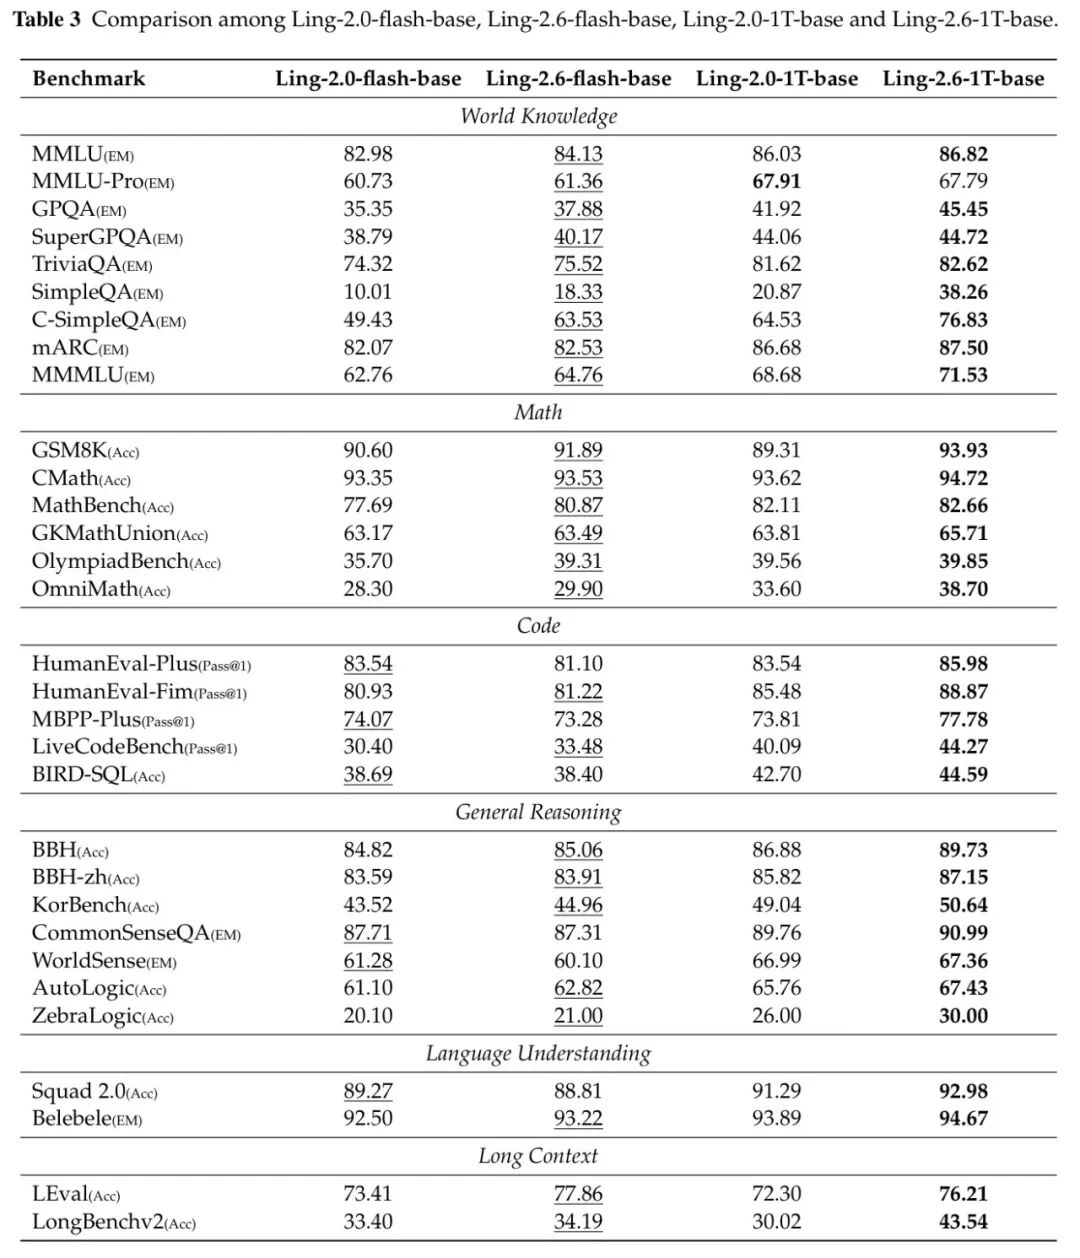
Ling‑2.6‑1T‑base 在 MMLU 上达到 81.0,SimpleQA 飙到 67.2,OmniMath 更是超过 70,相比 Ling‑2.0 提升显著。这说明架构迁移和额外 9.6T 的预训练不是修修补补,而是全面强化。
接下来看 flash 版本与当前主流非推理模型的搏杀。
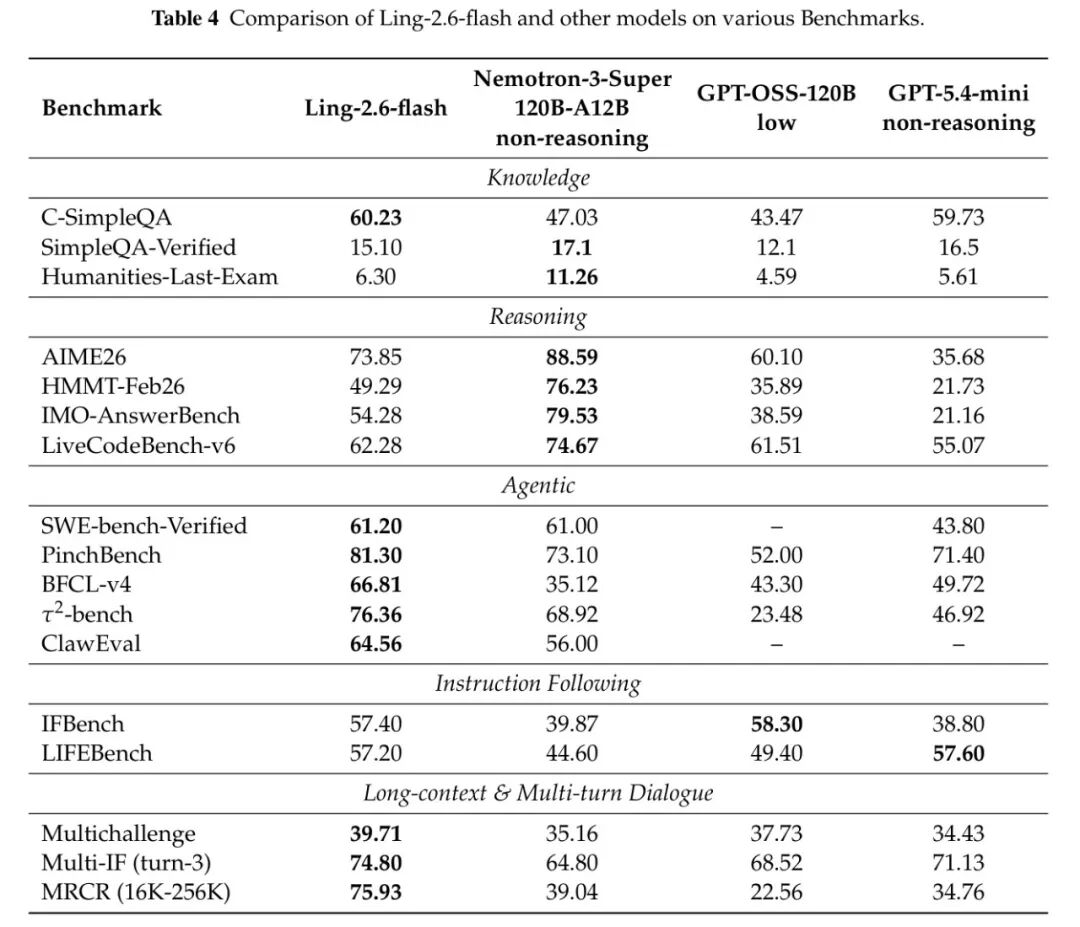
尽管参数规模更小,Ling‑2.6‑flash 在 Agentic 任务上 5 项全部登顶,长上下文与多轮对话 3 项全优,C‑SimpleQA 也拿下第一。它在真实工具使用和长文档理解上的统治力,来自前面提到的 Agent 原生训练策略。唯一的短板在极难数学推理(AIME26 等),这恰好是深度思考模型的用武之地。
那么 1T 参数的完全体又会怎样?
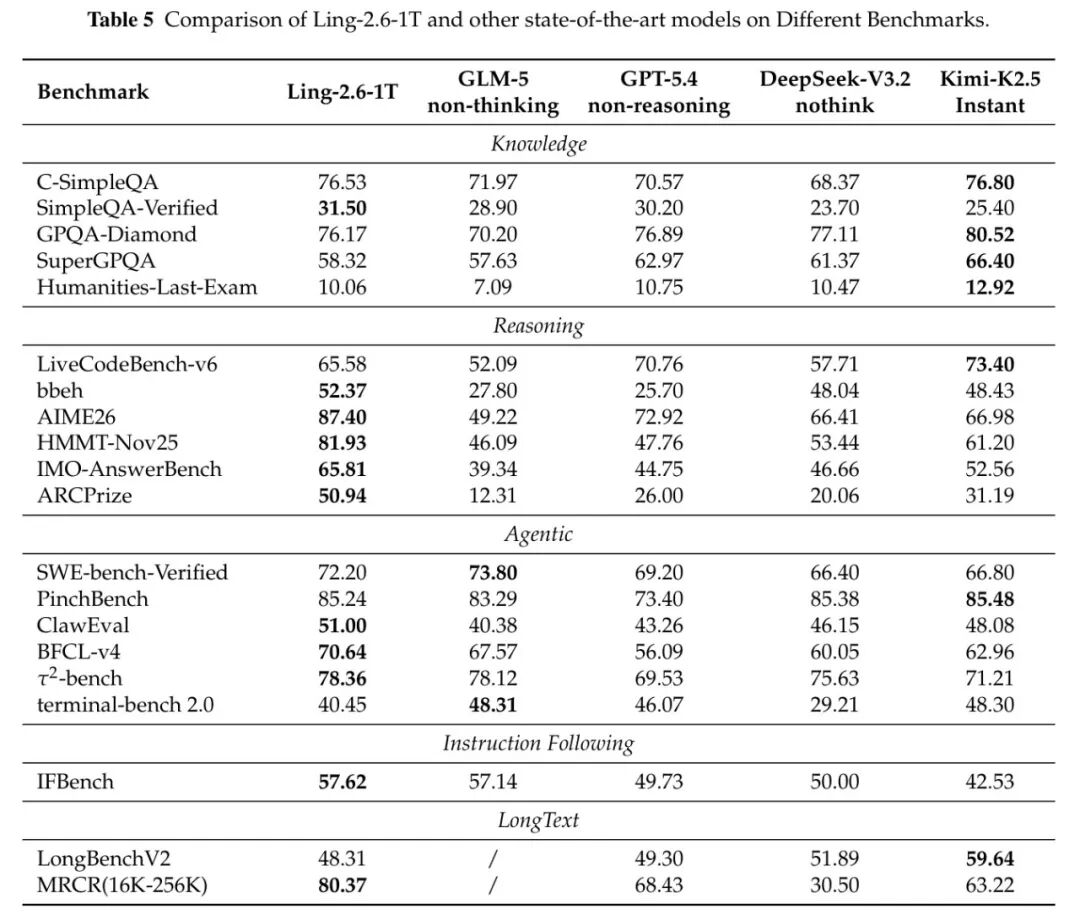
Ling‑2.6‑1T 在 SimpleQA‑Verified、AIME26、HMMT‑Nov25、ARCPrize、PinchBench、BFCL‑v4、τ²‑bench 等多项关键指标上拿到最优成绩,综合实力与 GPT‑5.4 non‑reasoning 平起平坐甚至略有超越。这表明,万亿参数如果架构造得好、训练策略对头,即使不用长链思维,也能与顶级模型掰手腕。
最后,思考模型 Ring‑2.6‑1T 亮剑。
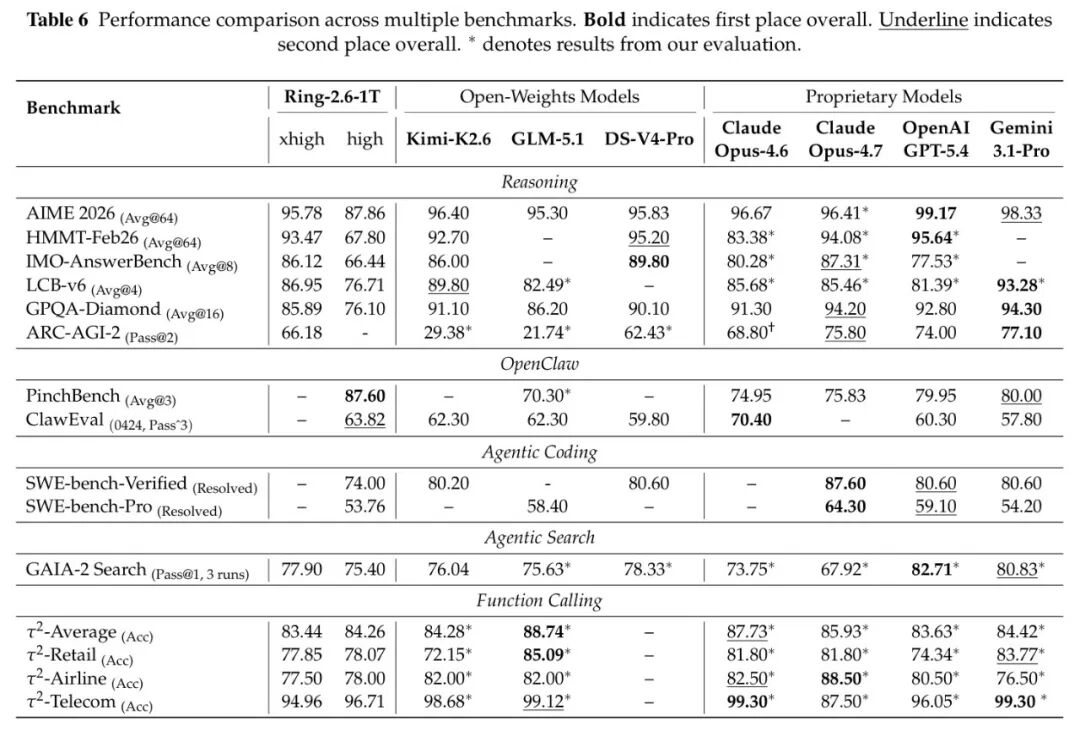
在 OpenClaw 标志性测试 PinchBench 上,Ring‑2.6‑1T (high) 以 87.60% 的得分全部碾压,超过 GPT‑5.4 的 79.95% 达 7.65 个百分点,登顶第一。ClawEval 上同样在开源权重模型中领先。在 τ²‑bench 函数调用中,Telecom 子项高达 96.71%,平均分与 Kimi‑K2.6、Gemini‑3.1‑Pro 拉不开差距。虽然在 SWE‑bench Verified 上略低于 Kimi‑K2.6 和 DeepSeek‑V4‑Pro,但 74% 的解决率已经坐稳第二梯队头排。
🔬 消融实验与训练动态
架构设计中的几个关键决策,都有严密的消融支撑。
首先是混合比例的抉择。在等 FLOPs 条件下,直接的推理成本与性能对比如下:
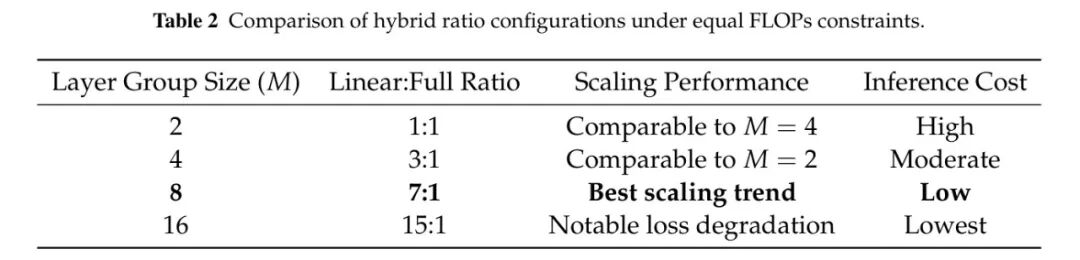
M=16 虽然推理成本最低,但性能退化显著;M=2 与 M=4 性能接近但推理成本高。M=8 用适中的层组和较高的线性比例,换来了最佳性能和低推理成本的双赢。
在推测解码部分,MTP 架构的打磨也颇为精彩:
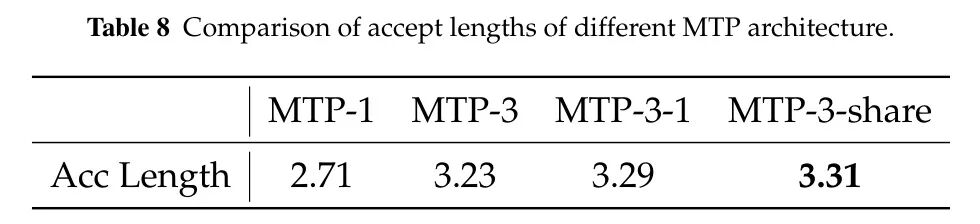
让多个 MTP 层共享参数并隔离梯度,接受长度从 2.71 提升到 3.31,意味着推测解码能平均多接受 0.6 个 token,加速效果更明显。
最后,回头看看 KPop 在 Agent RL 训练中的表现。下面四张子图记录了训练过程中 Reward、掩码比例、策略差异等关键指标的演变。
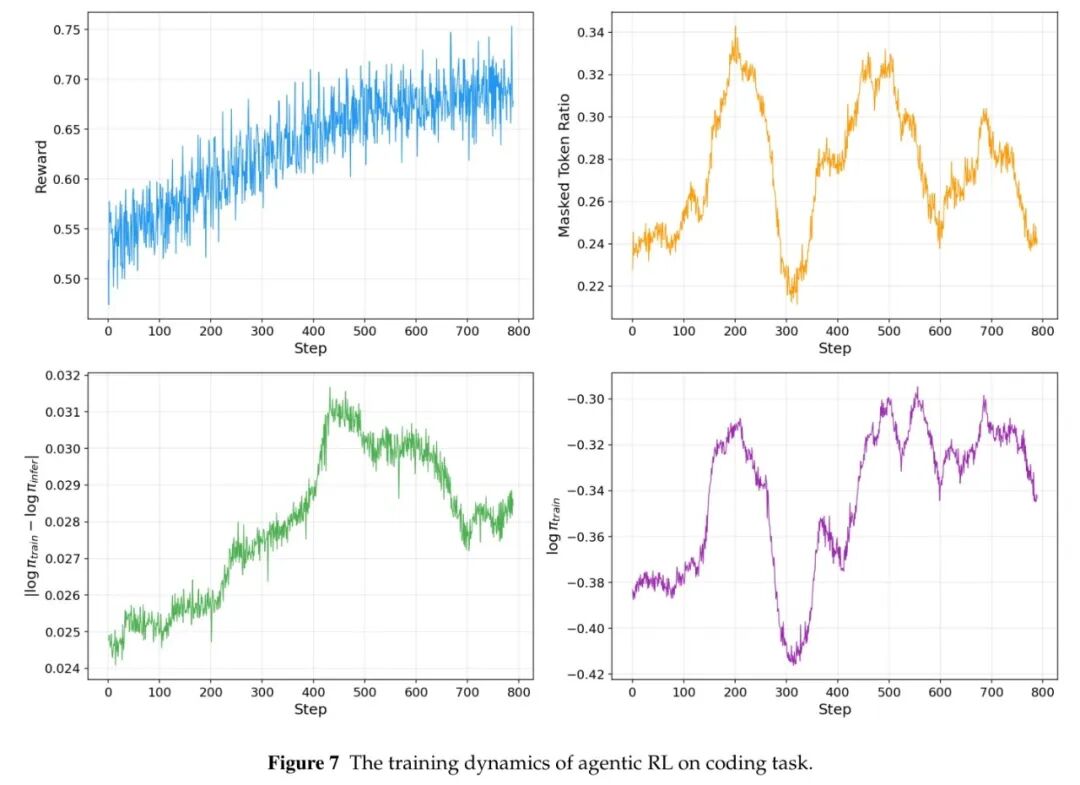
左上角的 Reward 曲线从 0.54 稳定攀升到 0.68,尽管存在高频噪声,整体上升趋势毋庸置疑。同时右侧的子图展示了策略分布的周期性,说明模型在不断探索且没有发散。
SWE‑bench Verified 上的 RL 计算量扩展实验更是验证了算力的威力。
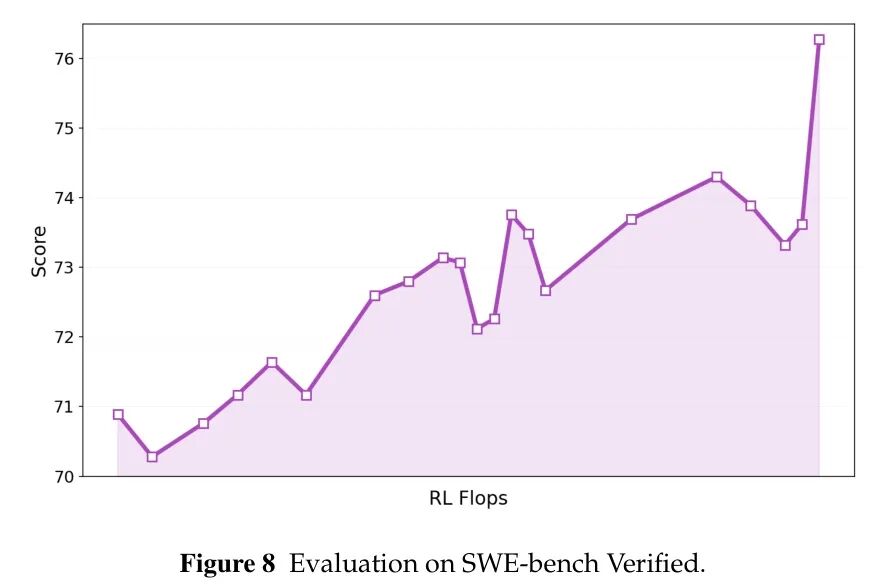
随着 RL 计算量从 512 单位增加到 32768,得分震荡上升,并在最大算力处出现跳变。这告诉你,对于复杂的 Agent 编程任务,RL 算力还未见顶,继续投入还有红利。
⚖️ 客观评价:乌云背后的金线
尽管 Ling‑2.6 和 Ring‑2.6 的成绩单足够亮眼,作者也坦率指出了五大局限性:
- • 推理深度天花板:flash 版本受限于思考预算,在极复杂推理、指令组合和工具可靠性上明显不如大版本。
- • Token 效率指标仍粗糙:压缩程序性推理很有效,但在知识密集型输出中,有时候难以分辨低价值重复与必要的事实阐述。
- • 长程自主鲁棒性不足:短期决策强,但在超长工作流、多变工具状态和异构环境下,可靠性会逐渐衰减。
- • 对齐漂移:在强约束 Prompt 下,模型可能在不同语言间出现行为漂移。
- • 评估缺口:现有公开基准还难以测出持久性、恢复行为、成本感知规划和部署鲁棒性。
这些实质性的反思,正是通往下一阶段“原生多模态 Agent”的必修课。
🌟 从魔法到工程,这才是万亿 Agent 的正确答案
回顾整篇报告,Ling‑2.6 和 Ring‑2.6 的价值远不止是一组新权重,它展示了 “架构‑训练‑系统协同设计” 所能达到的上限:混合线性注意力解决了长上下文效率,token 效率后训练节省了每次调用的成本,KPop + 异步 RL 让 Agent 能力不再是一件易碎的漂亮外衣。
对于开发者来说,至少有三个可以直接带走的启发:
- • Attention 不是越重越好,7:1 的线性/MLA 混合已在 Scaling Law 上被证明是黄金比例。
- • Token 效率是系统工程,Evo‑CoT、LPO 和最短正确响应蒸馏的组合拳,比单纯砍长度更可持续。
- • Agent 训练必须原生融入 RL 循环,而不是在 SFT 阶段刷高分数就结束——真实环境的异步交互和算力扩展性,才是稳健 Agent 的土壤。
🤔 深度思考:你认为万亿参数 Agent 最先颠覆的会是客服软件、自动化编程还是搜索引擎?欢迎在评论区留下你的预测,我们一起碰撞。
💝 支持原创:如果本文帮你拆清了万亿 Agent 的技术路线,请用**“点赞+在看”给作者续命,也分享**给你的技术伙伴,让更多同行看到硬核解读。
🔔 关注提醒:设为星标,不错过每一篇深度技术长文。下一个拆解,你想看哪个开源巨模?留言告诉我。
#AI技术 #深度学习 #大语言模型 #Agent智能体 #万亿参数 #论文解读
参考
Efficient and Instant Agentic Intelligence at Trillion-Parameter Scale
引用链接
[1]: https://github.com/inclusionAI/Ling-V2.5[2]: https://huggingface.co/collections/inclusionAI/ling-26[3]: https://huggingface.co/collections/inclusionAI/ring-26