MetaPS:让AI学会“择时”而非“算命”——仿真驱动的程序化策略选择框架
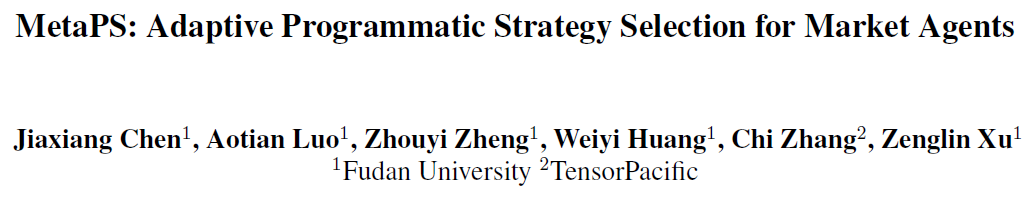
“MetaPS: Adaptive Programmatic Strategy Selection for Market Agents”
金融市场中,没有一种策略能永远获胜:动量策略在趋势中如鱼得水,却在反转时跌入深渊;均值回归策略在恐慌中精准抄底,却可能在持续冲击中持续亏损。真正的交易智慧,不是精通一种策略,而是知道何时使用哪种策略。
MetaPS(元程序化选择器)提出了一种全新的AI决策范式:与其让大语言模型直接“编造”交易指令,不如让它学会从一组可执行的程序化策略库中选出最合适的那一个。这个“指挥官”角色通过市场模拟器进行反事实推演——在历史数据的沙盘中反复测试每种策略的未来表现,从而学习“何种市场状态下该调用何种策略”的元知识。
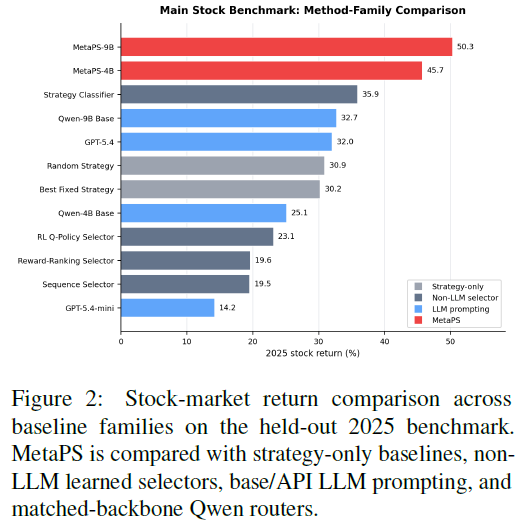
在2025年股票交易测试中,仅90亿参数的MetaPS模型取得了50.3%的年度回报,远超GPT-5.4(32.0%)和同样架构的基模(32.7%),证明了仿真引导的策略选择比通用提示更有效、更可靠。
【 扫描文末二维码加入星球获取论文 】
摘要
金融市场中,没有单一策略能始终保持优势。动量、均值回归、风险控制和事件驱动等策略在市场条件变化时,成功率各不相同。
MetaPS 是一个仿真引导的自适应程序化策略选择框架。它通过在模拟或回测市场中“展开”(roll out)候选策略,识别出在特定状态下能带来更好未来结果的策略,并将这些“状态-策略”对转化为监督微调(SFT)数据。在推理阶段,MetaPS 仅观察当前市场状态和候选策略上下文,选择最合适的策略程序,并由该程序生成最终的执行动作。
在多种股票交易和一个受控的商品交换沙盒环境中进行了实验。结果显示,MetaPS 在 0.8B 到 9B 参数的模型规模上均有一致性的提升,其表现优于固定策略基线、直接决策智能体以及基于 API 提示的 LLM 智能体。
简介
金融市场中,没有单一策略总是有效的。例如,动量策略在趋势延续时表现良好,但在市场反转时会失败;均值回归策略能从过度反应中获益,但会在持续的新闻冲击下失效。因此,市场决策不仅是设计强大的策略,更是决定何时使用哪种策略。
现有基于学习的交易系统通常将问题建模为直接动作预测,而 LLM 则允许结合文本和数值上下文进行决策。然而,这种方式将“选择市场逻辑”和“执行具体动作”这两个可分离的决策纠缠在一起,导致决策难以审计、约束和复现。
MetaPS 提出了一种更可执行的范式:自适应地选择程序化策略。智能体拥有一个策略库,每个策略都是可执行的代码模块。LLM 的角色从一个直接创造交易的引擎,转变为一个元级选择器,只需决定哪个程序来控制下一个决策,具体的动作执行则由确定性运行时环境(含可行性、规模、风险检查)完成。
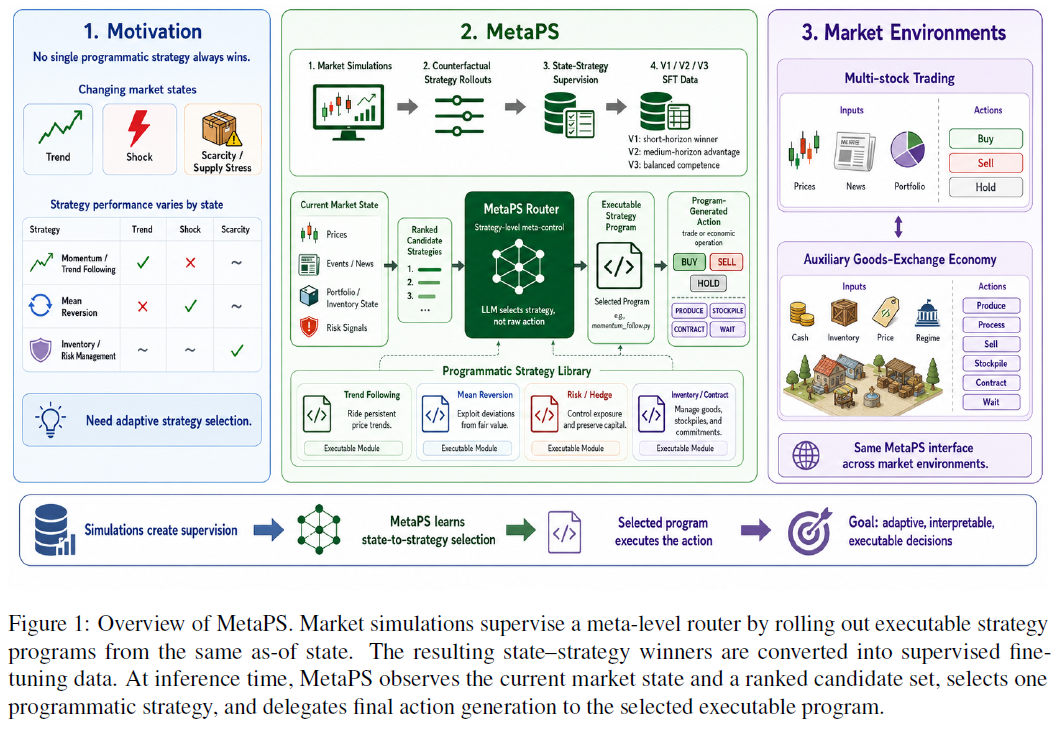
核心挑战在于监督信号。历史市场数据并未标注每个状态下的最优策略,答案可能取决于未来的结果。MetaPS 通过使用市场模拟和回测来产生有针对性的监督。它对每个“截止”状态,展开候选策略,估计未来收益,挖掘有效的“状态-策略”对,并将其转化为监督微调数据。未来结果仅用于构造训练目标,推理时模型是看不到的。
论文的主要贡献有三点:
将金融市场决策问题形式化为对可执行程序化策略的自适应选择,将策略选择与动作执行分离。
提出 MetaPS 框架,该框架通过市场模拟中的候选策略展开,导出监督微调数据。
在股票交易和商品交易环境中验证 MetaPS,结果显示其在不同规模的模型上均取得了一致的性能提升。
方法
问题定义
论文研究一个拥有可执行程序化策略库 S={s_1,......,s_N} 的市场决策问题。在时间步 t,环境提供一个“截止”观察 o_t。MetaPS 学习一个路由器(router),该路由器从一个排名后的候选策略子集 C_t ⊆ S 中进行选择。路由器预测:
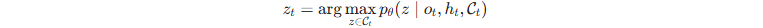
选中的程序随后产生最终动作:a_t = s_{z_t}(o_t)。这种解耦使得决策过程比直接动作生成更可解释、可执行和可审计。
程序化策略库
策略库定义了可用的执行决策原语。每个程序遵循一个共享接口:输入市场状态,输出结构化动作字段(如方向、目标资产、置信度、风险说明和大致仓位)。一个确定的执行层负责应用可行性、规模、成本和领域特定的约束。
在多股票交易环境中,策略库包含趋势跟踪、反转、新闻驱动、对冲、风险控制和突破等策略。在商品交换沙盒中,策略库包括生产者、加工者、承包商、商人、囤积者和平衡策略。
仿真引导的监督
这是 MetaPS 的核心。关键挑战在于“状态-策略”标签无法直接获得。MetaPS 通过在一个市场模拟器或历史回测器 M 中进行反事实策略展开来构造标签。
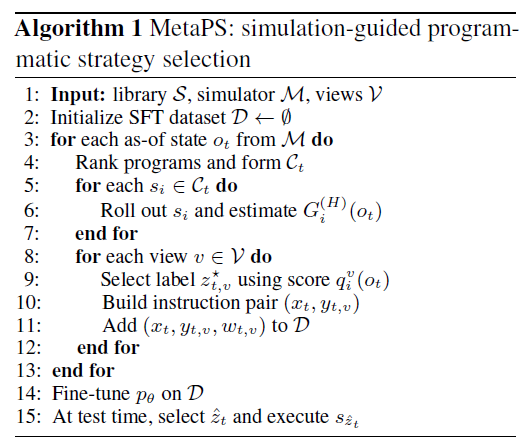
对于每个截止状态 o_t,M 从同一个状态快照展开每个候选程序 s_i ∈ C_t。使用贴现因子 γ 和展开视界 H,其展开回报为:
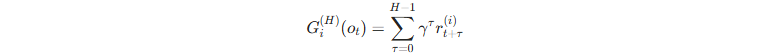
其中 r_{t+τ}^i 是在该反事实展开中由 s_i$ 生成的行动所获得的奖励。一个训练视图 v 定义了基于这些展开结果的特定视图评分 q_i^v(o_t),对应的目标策略为:
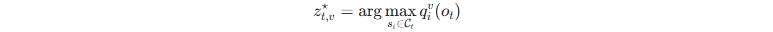
候选策略上下文:MetaPS 并非从无结构的完整库中选择。首先使用一个轻量级相关性评分 ρ(s_i, o_t) 和候选预算 B 来构建排名后的候选集:
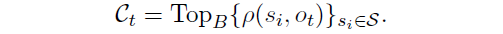
训练视图 (V1, V2, V3):论文构建了三个基于仿真的训练视图。
V1 (短视距赢家):选择短视距的赢家策略。
V2 (中视距优势):偏向于中视距有优势的策略,并考虑了交易成本、风险和换手率惩罚。
V3 (平衡能力):平衡回报、风险和策略选择分布,旨在生成更健康的训练数据分布。它们并非单调的课程学习,而是让 MetaPS 接触不同的策略选择偏差。
MetaPS 的学习与推理
仿真导出的标签被转化为指令微调样本。对于状态 t 和训练视图 v,模型输入 x_t 和目标文本 y_{t,v} 被构建出来。MetaPS 使用一个加权的语言模型目标函数进行训练:
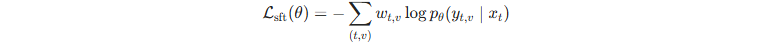
其中 w_{t,v} 是根据展开质量导出的可选置信度权重。
在推理时,模拟器和展开回报不再出现。MetaPS 仅接收可观察的输入 x_t = (o_t, h_t, C_t),预测策略标识符 z^_t,然后调用选定的可执行程序 s_z^_t 来生成最终动作 a_t。
实验
实验设置
环境:
多股票交易:主要基准。训练于2022-2024年,测试于2025年。初始资金100万美元,考虑了交易成本、滑点和持仓约束。
商品交换沙盒:辅助环境,包含现金、库存、价格和六种经济体制,用于验证策略选择接口的可迁移性。
程序化策略库:股票库包含10种策略(如新闻冲动、动量跟随、均值回归、风险重置、宏观轮动等);沙盒库包含6种经济策略(如生产者、加工者、承包商等)。
比较系统:包括策略基线、非LLM学习选择器(如分类器、序列模型、奖励排序等)、LLM提示基线以及MetaPS微调路由器。
股票交易主要结果
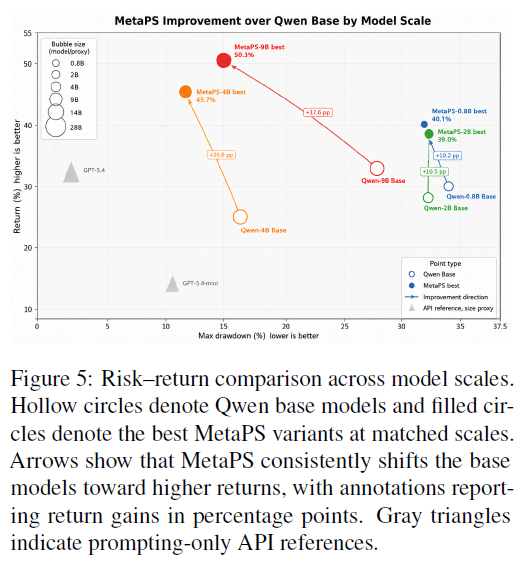
性能对比:在2025年股票基准上,MetaPS-9B 实现了最高的50.3%的回报率,远超其他基线。MetaPS-4B(45.7%)也超越了包括GPT-5.4(32.0%)、Qwen-9B Base(32.7%)、Best Fixed Strategy(30.2%)和所有非LLM选择器在内的基线。
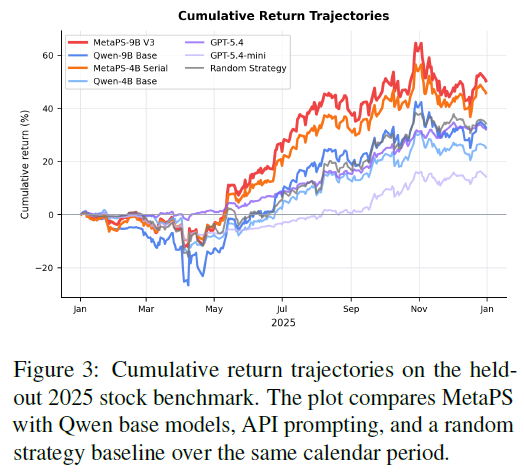
优势来源:MetaPS 的优势并非来自最终日的偶然收益,而是在整个测试年度的大部分时间里都保持了更强的累计收益轨迹。这表明监督元策略学习确实改善了策略切换,而非仅仅改变了可执行的策略空间。
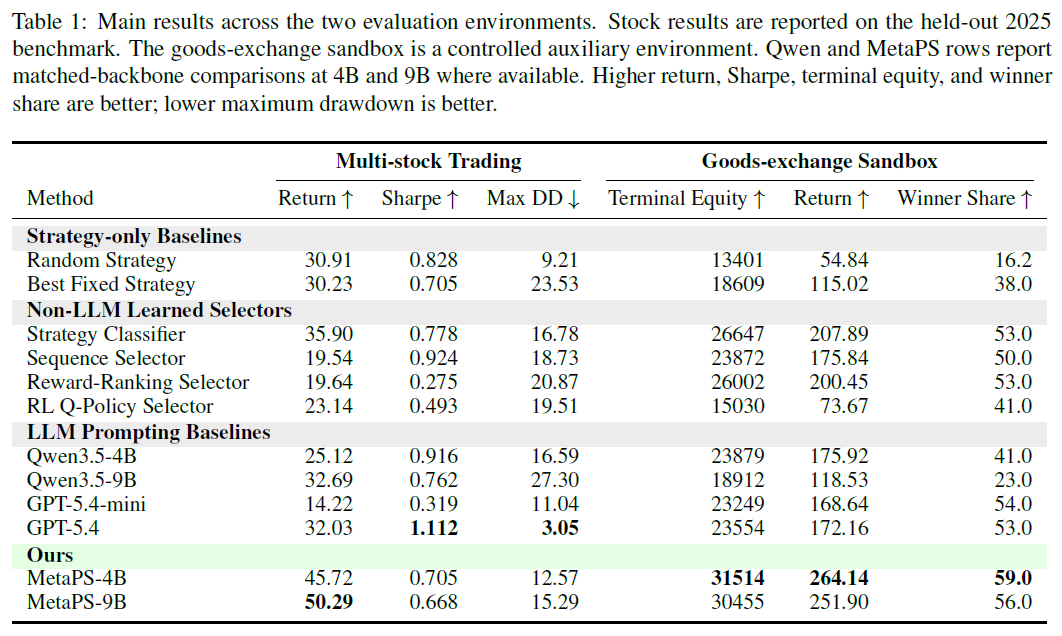
关键数据:MetaPS-9B在2025年获得50.29% 的回报,夏普比率0.668,最大回撤15.29%。相比之下,GPT-5.4虽然夏普比率最高(1.112)且回撤最低(3.05%),但其回报率(32.03%)远低于MetaPS。
商品交换沙盒中的表现
在沙盒环境中,MetaPS同样优于所有基线。例如,MetaPS-4B 的最终权益达到 31514,回报率为 264.14%,而 Qwen-4B Base 的最终权益为 23879,回报率为 175.92%。这表明 MetaPS 并不局限于特定的股票回测器或Ticker级的动作空间。
策略行为分析
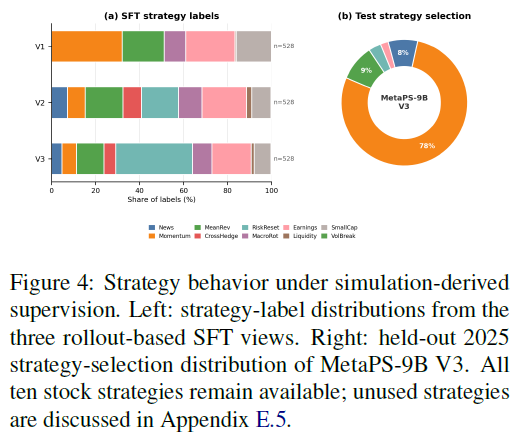
图4显示了SFT数据标签(V1, V2, V3)和最佳测试路由器(2025年)的策略分布。MetaPS-9B V3 的测试行为集中在动量跟随策略(约占78%),同时保留新闻冲动、均值回归和风险重置作为次要策略。这表明仿真引导塑造了一个选择性的元控制器,而非产生一个无约束的动作生成器。
策略上下文的影响
实验隔离了策略上下文的作用:
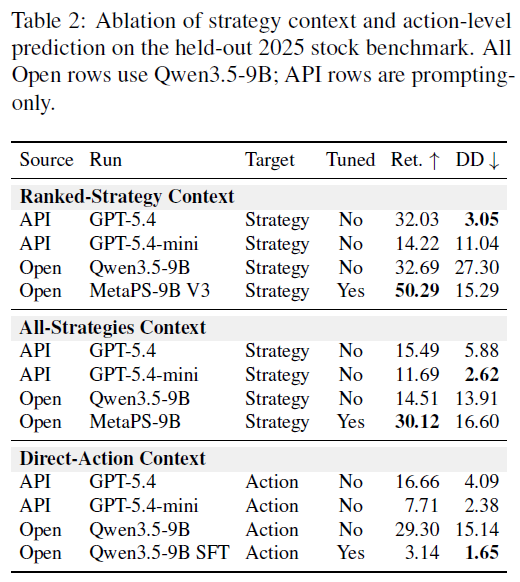
排名策略上下文 (Ranked-Strategy Context) 是最强的,MetaPS-9B V3 获得 50.29% 的回报。
全策略上下文 (All-Strategies Context) 下,MetaPS-9B 的回报降至 30.12%。
直接动作上下文 (Direct-Action Context) 效果最差,同参数量的SFT模型回报仅为 3.14%,而基模为 29.30%。这有力支持了MetaPS的设计核心:仿真监督在策略级路由上更有效,而低级执行则交由确定的程序处理。
模型规模与目标函数分析
规模效应:在所有测试的Qwen规模(0.8B、2B、4B、9B)中,最佳MetaPS变体均优于相应的基模。例如,4B模型收益提升20.60个百分点,9B模型提升17.60个百分点。
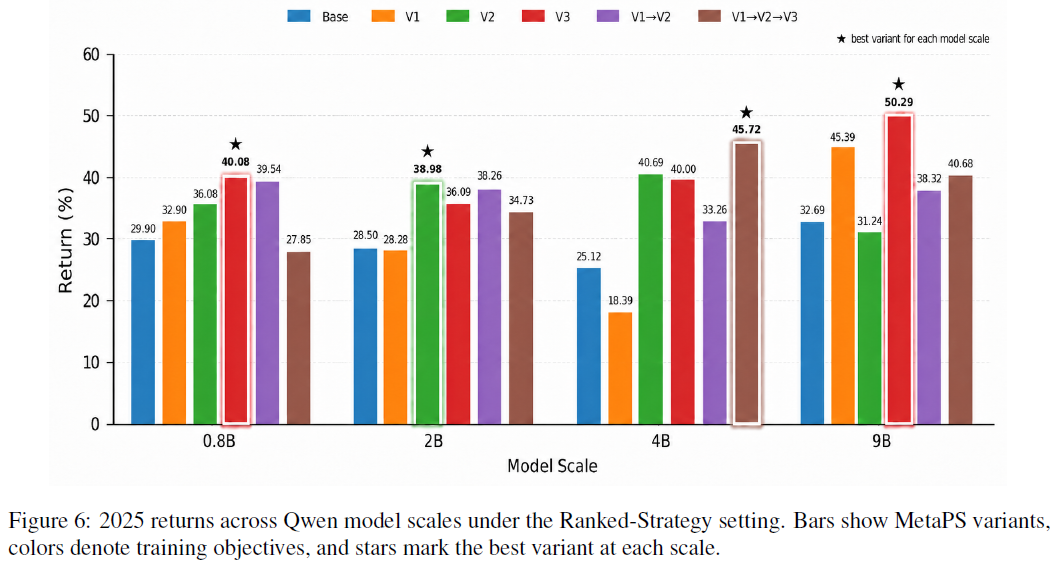
目标函数选择:最佳训练目标并非一成不变。V3 对 0.8B 和 9B 模型最强,V2 对 2B 最强,而V1→V2→V3 的串行课程对 4B 最强。这说明V1、V2、V3编码了不同的路由行为,而非形成一个单调的进步阶梯。
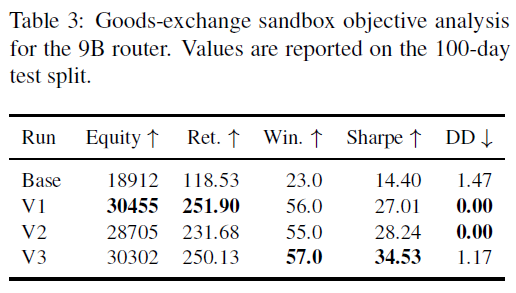
沙盒中的验证:在沙盒中,V1在最终权益和回报上最佳,V3在胜率和夏普比率上最优,V2则提供了一个中间点,再次证明了不同目标编码了不同的路由偏差。
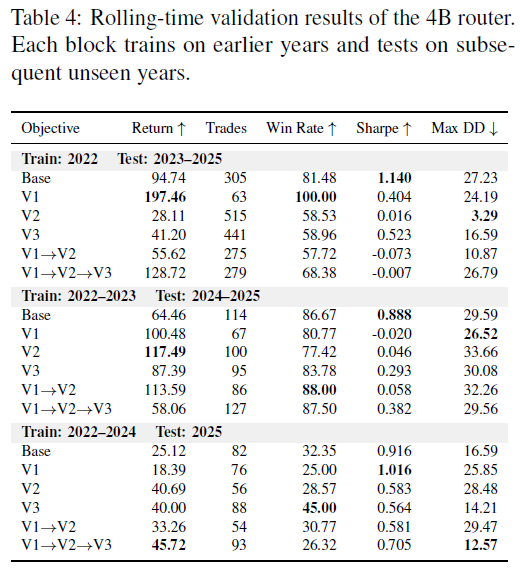
滚动时间验证
为了测试时间鲁棒性,增加了滚动窗口验证(使用4B模型)。
训练2022,测试2023-2025:V1 表现最好,回报197.46%,表明短视距赢家模仿能识别出少数高确信度机会。
训练2022-2023,测试2024-2025:V2 成为最强,回报117.49%。
训练2022-2024,测试2025:完整的串行课程 V1→V2→V3 最强,回报45.72%。这个结果细化了对单一2025年基准的结论,说明不同的V1、V2、V3视图在不同的市场体制和训练窗口下各有价值。
局限性
MetaPS 是用于策略选择的研究框架,非投资建议或可部署的交易系统。结果基于历史回测,可能无法完全捕捉流动性冲击、延迟、市场影响或分布偏移等真实市场风险。商品交换沙盒是合成的。MetaPS 也依赖于其策略库的覆盖范围和模拟器的保真度。未来的工作需要包括更强的压力测试、置信区间和实盘鲁棒性检验,任何实际应用都需要人工监督、保守的风险限制和审计日志。
总结
MetaPS 是一个学习在可解释的程序化策略间切换的框架。通过将学习从低级的市场动作提升到策略级的元控制,MetaPS 能够复用可执行策略并适应变化的市场条件。结果表明:策略路由有效且监督选择至关重要;排名的策略上下文优于非排名或无策略提示;监督路由在各模型规模上均优于基模;滚动时间验证表明V1、V2、V3编码了不同的行为偏差。这些发现支持了仿真引导的策略选择作为通向更可执行、可解释和自适应的基于LLM的市场智能体的实用路径。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
