OKF——要做AI时代的“知识图谱通用语”—继MCP之后,Google又扔出一张Agent王牌
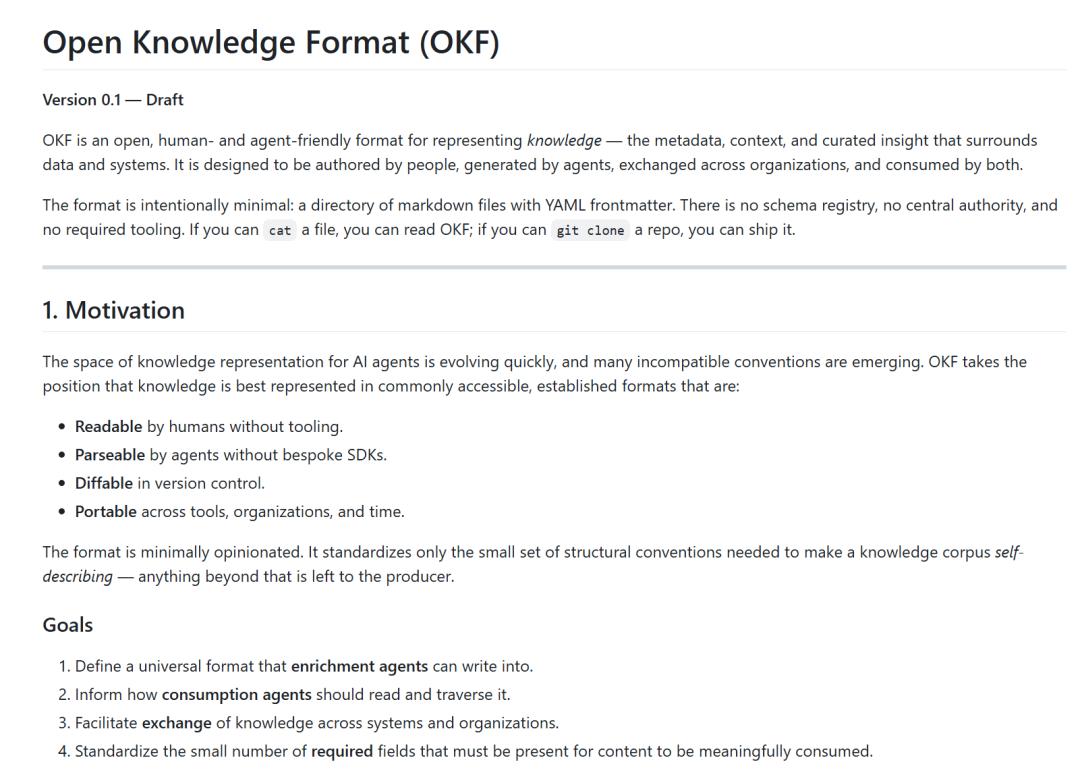
Open Knowledge Format (OKF): Google's Standard for AI Agent Memory
01摘要
2026年6月12日,谷歌云发布了Open Knowledge Format(OKF)v0.1:一个用带YAML前置元数据的Markdown文件夹来表示知识的开放规范。没有新的运行时,没有专有SDK,只需能用git克隆的文件目录,人和AI智能体都能读写。它要解决的问题是:在AI智能体时代,散落于各系统的企业知识,如何以一种标准形状被高效地喂给模型。文末阅读原文或https://t.zsxq.com/4qepr获取中英文资料
02一个"低调"的发布,一个高密度的问题
6月12日的发布没有发布会,没有大型演示。谷歌云悄悄在官方博客发了一篇文章,同时在GitHub上开了一个仓库,然后就等社区自己去发现。主导这个项目的是谷歌云Data Analytics技术负责人Sam McVeety和BigQuery技术负责人Amir Hormati。两人的官方定义是这样的: "OKF是一个厂商中立、AI智能体与人类皆友好的标准,用于表示现代AI系统所需的元数据、上下文和经过精炼的知识。"听起来很学术。但实际要解决的问题,任何一个认真做过企业AI落地的人都会立刻认出来——那个让每个AI项目组单独头疼、反复被解决又从未被统一解决过的问题。当你让一个AI智能体去回答"我们产品的周活跃用户是怎么计算的",它需要的答案不在某一个地方,而是散落在:数据目录里的表结构定义、Wiki或Confluence里某个三年前写的业务指标文档、某个人脑子里的"连接路径只有老王知道"、GitHub仓库里某条注释、某个Runbook里的故障排查步骤……每个AI项目团队都在重新组装这套上下文。每家数据目录厂商都在重新发明自己的元数据格式。知识被锁在创造它的那个系统里,出不来,也流不动。谷歌的判断是:缺的不是另一个平台,缺的是一个格式。
03格式本身:极度克制的设计
OKF的全称是Open Knowledge Format(开放知识格式),核心设计用一句话就能说完:一个带有YAML前置元数据的Markdown文件目录。一个OKF知识包(Bundle)就是一个普通文件夹。文件夹里的每个.md文件代表一个"概念"(Concept)——可以是一张数据库表、一个API端点、一个业务指标、一个运维手册、一条业务流程,或者任何你认为值得记录的知识单元。每个概念文件分两部分:上面是YAML格式的元数据头(frontmatter),下面是自由书写的Markdown正文。整个规范里,唯一的强制字段只有一个:type(类型)。其他的title(标题)、description(描述)、resource(资源URI)、tags(标签)、timestamp(时间戳)都是推荐但可选的。这种克制是刻意的。规范的制定者明确说,OKF定义的是互操作性所需的最小公约数,而不是内容模型。你用什么类型值,你的正文怎么组织,完全由生产者决定。文件夹结构的样子大约是这样:
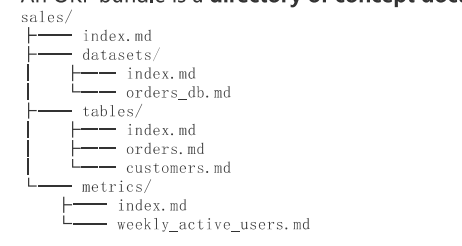 在这个结构里,有两个文件名被保留了特殊含义:index.md是目录索引,用于让智能体在进入一个陌生的知识包时先做"渐进式探索";log.md是变更历史,记录这个目录下发生过什么更新。其他所有.md文件都是概念文档。Markdown文件之间可以用标准Markdown链接互相引用,整个文件夹就自然而然地成了一个知识图谱。文件路径就是概念的身份——tables/orders.md这个文件,它的概念ID就是tables/orders,不需要额外的ID系统。规范对消费者也做了明确要求:必须容忍未知的type值、缺失的可选字段和断裂的跨文件链接。一个文件不合规,不影响整个知识包里其他文件的可用性。
04它在解决一个被反复重新发明的问题
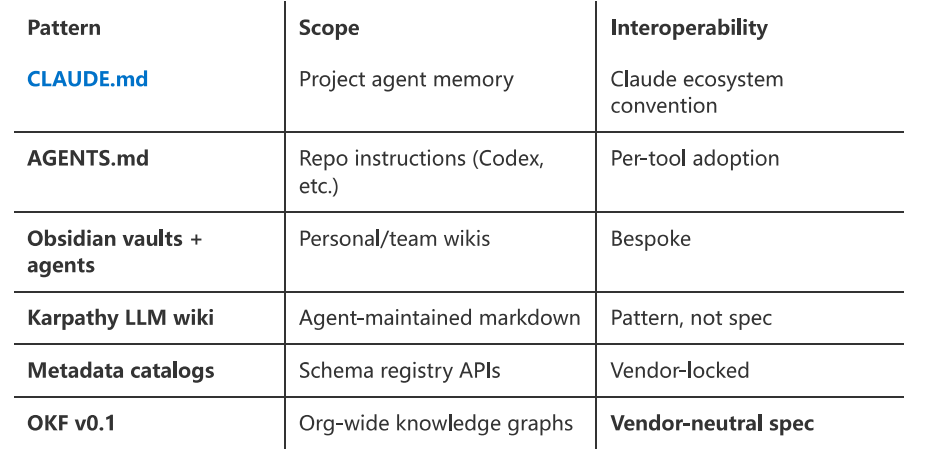
要真正理解OKF的定位,需要先知道一个背景:在过去一两年里,一种叫做"LLM Wiki"的实践模式在AI开发者社区里悄然流行起来。这个概念的原型来自Andrej Karpathy——特斯拉前AI负责人,OpenAI联合创始人。他在一篇GitHub Gist里描述了这样一种模式:用Markdown文件维护一个AI可读、可更新、可自我维护的知识库,让语言模型充当这个知识库的维护者,而不只是它的消费者。这篇Gist收获了超过5000颗星。随后,开发者社区开始各自实现这个想法:AGENTS.md(为AI智能体写的任务指令文件)、CLAUDE.md(Anthropic工具的项目记忆文件)、Obsidian vaults结合编程智能体、各种以index.md加log.md为骨架的文件夹……每种实现都不兼容彼此。每个团队都在重复造轮子。你的"LLM Wiki"和我的"LLM Wiki"之间没有任何互操作性可言。OKF想做的事情,用社区里一位评论者的话说得很准确:"当谷歌把你已经在赌的方向标准化了,这值得注意。"它不是要发明一种新事物,而是要给那个已经被无数团队独立发现、却始终碎片化的实践,赋予一个标准的形状。
05它在AI知识体系里的位置
OKF并不是孤立出现的。在AI与Web的交叉地带,过去一年里陆续出现了几个相互补充的规范和约定:
06谷歌同时交付了什么
规范是骨架,谷歌同时发布了三个参考实现,降低了上手门槛。
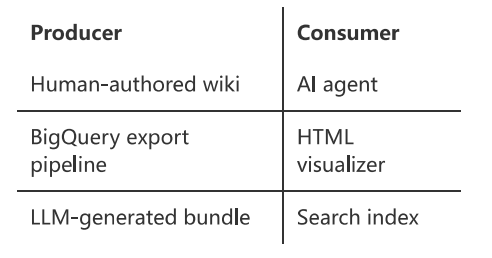
Enrichment Agent(增强智能体)这是一个参考生产者实现:自动遍历一个BigQuery数据集,为每张表和每个视图生成一个OKF概念文档,然后再用第二轮大模型调用来补充Schema(字段说明)、引用来源和关联路径。也就是说,你有一个数据仓库,它可以帮你自动生成一个OKF格式的知识包。
静态HTML可视化器这是一个参考消费者实现:把任何一个OKF Bundle转换成一个交互式知识图谱页面。整个输出是一个单独的自包含HTML文件,不需要任何后端服务,不需要数据离开本地。这个工具本身也有一定的审计价值——它能让你直观看到自己的内容在智能体眼里是什么样的结构,知识之间的连接关系是否完整。
三套示例BundleGA4电商数据(Google Analytics的电商分析表和指标)、Stack Overflow公开数据集(问答内容的概念化整理)、Bitcoin公开区块链数据集。这三套示例不只是演示,也是参考范本,告诉你一个真实的OKF Bundle应该长什么样。
 07规范的技术细节:只需知道这几件事
规范全文相当短,真正需要理解的核心要点可以用几段话说清楚。
关于合规性一个Bundle满足OKF v0.1合规要求只需三点:目录下所有非保留名称的.md文件都包含可解析的YAML前置元数据;每个前置元数据都包含非空的type字段;index.md和log.md如果存在,则遵循规定的结构。就这些。
关于版本控制规范建议用git仓库分发Bundle,理由是git提供了历史记录、归属追溯和差异比对。这三件事对于一个随时间演化的知识库来说都很重要——不只是为了人类,也是为了让智能体能追踪"这个概念上周被改了什么"。
关于引用机制当一个概念文档的内容来源于外部资料,规范约定在文档底部用标准数字编号引用的方式列出来源。这不是强制要求,但对于需要追溯知识来源可信度的场景非常有价值。
关于扩展性规范对于未知字段、未知type值的态度是容错而非拒绝。这是一个务实的选择:知识是活的,格式需要能随着知识生长。生产者可以在frontmatter里加入任意自定义键值对,消费者在轮转时应当保留而不是丢弃这些未知字段。
关于版本路线图小版本号升级意味着向后兼容的新增(比如新的可选字段、新的约定章节名称);大版本号升级意味着可能出现破坏性变更。Bundle可以在根目录的index.md里声明自己对应的OKF版本号。
 08社区在说什么:一场有意思的分歧
这个规范发布后,在Hacker News上引发了一次颇具代表性的讨论,赞同与质疑的声音都很尖锐。赞同方的核心论点是:Markdown是人类与AI模型互操作的最低公约数。它不是最强大的知识表示格式,但它赢在门槛极低——任何人都能写,任何工具都能读,git可以管理它,GitHub可以渲染它,AI模型从训练数据里见过无数的Markdown,直接就能处理。而"带YAML frontmatter的Markdown"这个模式,已经被无数工具和团队独立发现并使用了。OKF的贡献在于把这个事实状态变成一个有名字的标准。质疑方的核心问题是:这不就是普通的Markdown加YAML吗?这有什么实质意义?一个15KB的规范文档,最后讲的不过是"用Markdown文件夹存知识",谷歌专门发这个是不是有点大题小做?还有人搬出了语义网(Semantic Web)的历史——RDF、OWL这些格式每隔十年就被翻出来讨论一次,结果都是曲高和寡、落地惨败。但这两类质疑都有一个共同的视角盲点:它们用的是"完美知识表达"的标准,在评判一个v0.1的实用主义规范。OKF的目标从来不是替代知识图谱,也不是成为语义网的答案。它的目标就是让"把知识喂给AI智能体"这件事有一个标准的形状,这样这件事就不需要在每个项目里从零开始设计。这是一个基础设施级别的贡献,而不是一个产品级别的创新。当然,也有更深层的技术问题被提出:并非所有知识都能用"纯Markdown"表达——空间布局、颜色语义、电子表格里的复杂计算关系,目前还没有好的对应方式。但这是任何文本格式共同面对的边界,不是OKF独有的缺陷。
09悬而未决的问题谷歌自己把v0.1称为一个起点,而不是一个终点。规范里有几个明显的空白,将由社区反馈来填补。
对于数据团队,OKF提供了一条路径,可以把数据目录里的知识转化为AI智能体能直接消费的格式,而不是每次都要从头组装上下文。对于做企业AI落地的技术团队,OKF给了一个"知识管理"问题的标准答案形状,团队可以从这个形状出发设计自己的知识工程流程,而不是自己发明一套。对于平台型工具的开发者,支持OKF的读写意味着你的工具能和其他支持OKF的工具自然互通,不需要写定制化的集成代码。对于正在构建多智能体系统的团队,OKF提供了一个跨系统共享知识的标准层——一个智能体生产的知识,另一个智能体可以直接消费,不需要中间翻译层。对于投资人,这件事的信号意义在于:谷歌选择在这个时间点,用开源规范而不是闭源产品的方式,来解决AI智能体的知识访问问题。这说明谷歌的判断是:这个问题的解决方案,其价值来自广泛采用而不是垄断,来自生态而不是锁定。当一家科技巨头以这种方式押注一个基础格式,它通常是在为某个即将爆发的规模化应用场景铺路。
2026年6月12日,谷歌云发布了Open Knowledge Format(OKF)v0.1:一个用带YAML前置元数据的Markdown文件夹来表示知识的开放规范。没有新的运行时,没有专有SDK,只需能用git克隆的文件目录,人和AI智能体都能读写。它要解决的问题是:在AI智能体时代,散落于各系统的企业知识,如何以一种标准形状被高效地喂给模型。文末阅读原文或https://t.zsxq.com/4qepr获取中英文资料
02一个"低调"的发布,一个高密度的问题
6月12日的发布没有发布会,没有大型演示。谷歌云悄悄在官方博客发了一篇文章,同时在GitHub上开了一个仓库,然后就等社区自己去发现。主导这个项目的是谷歌云Data Analytics技术负责人Sam McVeety和BigQuery技术负责人Amir Hormati。两人的官方定义是这样的:
"OKF是一个厂商中立、AI智能体与人类皆友好的标准,用于表示现代AI系统所需的元数据、上下文和经过精炼的知识。"听起来很学术。但实际要解决的问题,任何一个认真做过企业AI落地的人都会立刻认出来——那个让每个AI项目组单独头疼、反复被解决又从未被统一解决过的问题。当你让一个AI智能体去回答"我们产品的周活跃用户是怎么计算的",它需要的答案不在某一个地方,而是散落在:数据目录里的表结构定义、Wiki或Confluence里某个三年前写的业务指标文档、某个人脑子里的"连接路径只有老王知道"、GitHub仓库里某条注释、某个Runbook里的故障排查步骤……每个AI项目团队都在重新组装这套上下文。每家数据目录厂商都在重新发明自己的元数据格式。知识被锁在创造它的那个系统里,出不来,也流不动。谷歌的判断是:缺的不是另一个平台,缺的是一个格式。03格式本身:极度克制的设计
OKF的全称是Open Knowledge Format(开放知识格式),核心设计用一句话就能说完:一个带有YAML前置元数据的Markdown文件目录。一个OKF知识包(Bundle)就是一个普通文件夹。文件夹里的每个.md文件代表一个"概念"(Concept)——可以是一张数据库表、一个API端点、一个业务指标、一个运维手册、一条业务流程,或者任何你认为值得记录的知识单元。每个概念文件分两部分:上面是YAML格式的元数据头(frontmatter),下面是自由书写的Markdown正文。整个规范里,唯一的强制字段只有一个:type(类型)。其他的title(标题)、description(描述)、resource(资源URI)、tags(标签)、timestamp(时间戳)都是推荐但可选的。这种克制是刻意的。规范的制定者明确说,OKF定义的是互操作性所需的最小公约数,而不是内容模型。你用什么类型值,你的正文怎么组织,完全由生产者决定。文件夹结构的样子大约是这样:
在这个结构里,有两个文件名被保留了特殊含义:index.md是目录索引,用于让智能体在进入一个陌生的知识包时先做"渐进式探索";log.md是变更历史,记录这个目录下发生过什么更新。其他所有.md文件都是概念文档。Markdown文件之间可以用标准Markdown链接互相引用,整个文件夹就自然而然地成了一个知识图谱。文件路径就是概念的身份——tables/orders.md这个文件,它的概念ID就是tables/orders,不需要额外的ID系统。规范对消费者也做了明确要求:必须容忍未知的type值、缺失的可选字段和断裂的跨文件链接。一个文件不合规,不影响整个知识包里其他文件的可用性。04它在解决一个被反复重新发明的问题
要真正理解OKF的定位,需要先知道一个背景:在过去一两年里,一种叫做"LLM Wiki"的实践模式在AI开发者社区里悄然流行起来。这个概念的原型来自Andrej Karpathy——特斯拉前AI负责人,OpenAI联合创始人。他在一篇GitHub Gist里描述了这样一种模式:用Markdown文件维护一个AI可读、可更新、可自我维护的知识库,让语言模型充当这个知识库的维护者,而不只是它的消费者。这篇Gist收获了超过5000颗星。随后,开发者社区开始各自实现这个想法:AGENTS.md(为AI智能体写的任务指令文件)、CLAUDE.md(Anthropic工具的项目记忆文件)、Obsidian vaults结合编程智能体、各种以index.md加log.md为骨架的文件夹……每种实现都不兼容彼此。每个团队都在重复造轮子。你的"LLM Wiki"和我的"LLM Wiki"之间没有任何互操作性可言。OKF想做的事情,用社区里一位评论者的话说得很准确:
"当谷歌把你已经在赌的方向标准化了,这值得注意。"它不是要发明一种新事物,而是要给那个已经被无数团队独立发现、却始终碎片化的实践,赋予一个标准的形状。05它在AI知识体系里的位置
OKF并不是孤立出现的。在AI与Web的交叉地带,过去一年里陆续出现了几个相互补充的规范和约定:
- llms.txt是入口层。它告诉AI智能体,这个网站或系统里最值得读的内容在哪几页,是路标。
- EntityMap是声明层。它声明你拥有哪些实体以及它们之间的关系,是人物关系图。
- OKF是内容层。它把知识本身交给智能体,每个页面都是干净的概念,通过交叉链接形成图谱,是图书馆本身。
06谷歌同时交付了什么
规范是骨架,谷歌同时发布了三个参考实现,降低了上手门槛。
Enrichment Agent(增强智能体)这是一个参考生产者实现:自动遍历一个BigQuery数据集,为每张表和每个视图生成一个OKF概念文档,然后再用第二轮大模型调用来补充Schema(字段说明)、引用来源和关联路径。也就是说,你有一个数据仓库,它可以帮你自动生成一个OKF格式的知识包。
静态HTML可视化器这是一个参考消费者实现:把任何一个OKF Bundle转换成一个交互式知识图谱页面。整个输出是一个单独的自包含HTML文件,不需要任何后端服务,不需要数据离开本地。这个工具本身也有一定的审计价值——它能让你直观看到自己的内容在智能体眼里是什么样的结构,知识之间的连接关系是否完整。
三套示例BundleGA4电商数据(Google Analytics的电商分析表和指标)、Stack Overflow公开数据集(问答内容的概念化整理)、Bitcoin公开区块链数据集。这三套示例不只是演示,也是参考范本,告诉你一个真实的OKF Bundle应该长什么样。
07规范的技术细节:只需知道这几件事规范全文相当短,真正需要理解的核心要点可以用几段话说清楚。
关于合规性一个Bundle满足OKF v0.1合规要求只需三点:目录下所有非保留名称的.md文件都包含可解析的YAML前置元数据;每个前置元数据都包含非空的type字段;index.md和log.md如果存在,则遵循规定的结构。就这些。
关于版本控制规范建议用git仓库分发Bundle,理由是git提供了历史记录、归属追溯和差异比对。这三件事对于一个随时间演化的知识库来说都很重要——不只是为了人类,也是为了让智能体能追踪"这个概念上周被改了什么"。
关于引用机制当一个概念文档的内容来源于外部资料,规范约定在文档底部用标准数字编号引用的方式列出来源。这不是强制要求,但对于需要追溯知识来源可信度的场景非常有价值。
关于扩展性规范对于未知字段、未知type值的态度是容错而非拒绝。这是一个务实的选择:知识是活的,格式需要能随着知识生长。生产者可以在frontmatter里加入任意自定义键值对,消费者在轮转时应当保留而不是丢弃这些未知字段。
关于版本路线图小版本号升级意味着向后兼容的新增(比如新的可选字段、新的约定章节名称);大版本号升级意味着可能出现破坏性变更。Bundle可以在根目录的index.md里声明自己对应的OKF版本号。
08社区在说什么:一场有意思的分歧这个规范发布后,在Hacker News上引发了一次颇具代表性的讨论,赞同与质疑的声音都很尖锐。赞同方的核心论点是:Markdown是人类与AI模型互操作的最低公约数。它不是最强大的知识表示格式,但它赢在门槛极低——任何人都能写,任何工具都能读,git可以管理它,GitHub可以渲染它,AI模型从训练数据里见过无数的Markdown,直接就能处理。而"带YAML frontmatter的Markdown"这个模式,已经被无数工具和团队独立发现并使用了。OKF的贡献在于把这个事实状态变成一个有名字的标准。质疑方的核心问题是:这不就是普通的Markdown加YAML吗?这有什么实质意义?一个15KB的规范文档,最后讲的不过是"用Markdown文件夹存知识",谷歌专门发这个是不是有点大题小做?还有人搬出了语义网(Semantic Web)的历史——RDF、OWL这些格式每隔十年就被翻出来讨论一次,结果都是曲高和寡、落地惨败。但这两类质疑都有一个共同的视角盲点:它们用的是"完美知识表达"的标准,在评判一个v0.1的实用主义规范。OKF的目标从来不是替代知识图谱,也不是成为语义网的答案。它的目标就是让"把知识喂给AI智能体"这件事有一个标准的形状,这样这件事就不需要在每个项目里从零开始设计。这是一个基础设施级别的贡献,而不是一个产品级别的创新。当然,也有更深层的技术问题被提出:并非所有知识都能用"纯Markdown"表达——空间布局、颜色语义、电子表格里的复杂计算关系,目前还没有好的对应方式。但这是任何文本格式共同面对的边界,不是OKF独有的缺陷。
09悬而未决的问题谷歌自己把v0.1称为一个起点,而不是一个终点。规范里有几个明显的空白,将由社区反馈来填补。
- 矛盾处理。当同一个Bundle里的两个概念文档对同一个事实有不同表述时,目前没有任何合并语义或冲突解决机制。这在知识由多方维护的场景下会是一个实际问题。
- 实效性问题。OKF是基于文件的静态知识,文件内容的新鲜度完全依赖维护流程。谁来负责更新,更新频率是多少,规范本身没有回答。
- 命名冲突。确实存在另一个叫"OKF"的开源项目(OKF-SCIS,一个供应链信息系统的格式),两者的名字重叠,在搜索层面可能造成混淆。谷歌的OKF指的是数据/分析/智能体知识领域的这个规范。
- 类型系统的边界。type字段目前完全由生产者自由定义,没有任何中央注册机制。在单一组织内部这不是问题,但如果多个组织的知识包要互操作,type值的不统一会造成理解障碍。这个问题如何处理,v0.2版本或许会给出方向。
对于数据团队,OKF提供了一条路径,可以把数据目录里的知识转化为AI智能体能直接消费的格式,而不是每次都要从头组装上下文。对于做企业AI落地的技术团队,OKF给了一个"知识管理"问题的标准答案形状,团队可以从这个形状出发设计自己的知识工程流程,而不是自己发明一套。对于平台型工具的开发者,支持OKF的读写意味着你的工具能和其他支持OKF的工具自然互通,不需要写定制化的集成代码。对于正在构建多智能体系统的团队,OKF提供了一个跨系统共享知识的标准层——一个智能体生产的知识,另一个智能体可以直接消费,不需要中间翻译层。对于投资人,这件事的信号意义在于:谷歌选择在这个时间点,用开源规范而不是闭源产品的方式,来解决AI智能体的知识访问问题。这说明谷歌的判断是:这个问题的解决方案,其价值来自广泛采用而不是垄断,来自生态而不是锁定。当一家科技巨头以这种方式押注一个基础格式,它通常是在为某个即将爆发的规模化应用场景铺路。
举报/反馈
对本文内容有合作意向?
我们将在 1 个工作日内与您联系