KTD-FIN:剥开记忆的外衣,用数据匿名化与Barra归因拆解LLM交易智能体的“真金”与“假银”
“From Knowing to Doing: A Memory-Controlled Benchmark for LLM Trading Agents on Stock Markets”
【 扫描文末二维码加入星球获取论文 】
摘要
评估大型语言模型(LLM)智能体是否能在资本市场盈利,通常采用端到端交易的回测方法。然而,这种方法存在两个关键缺陷。第一,长期回测的日期常常与顶尖LLM的知识截止日期重叠,导致模型可能依赖记忆中的股票代码、日期、价格和市场叙事,而非基于当前提供的推理。第二,原始收益率是选股能力的噪声指标,正收益可能源于市场贝塔值、风格暴露或有利的市场环境,而非真正的阿尔法(Alpha)收益。
为了解决这些问题,论文提出了KTD-FIN(Knowing-To-Doing Financial Benchmark,知行金融基准)。该基准通过数据层面的匿名化协议,对关键标识符和日历信息进行一致性的屏蔽,将历史市场记忆与投资决策分离开来。同时,它引入了一个Barra风格的表现归因框架,将投资组合的收益分解为市场、风格和选股阿尔法三个部分。
在对2024年至2026年交易窗口内中国A股沪深300指数上评估的十个前沿LLM智能体进行测试后,研究发现:匿名化显著改变了智能体的推理过程,使其从依赖公司特定叙事转向基于匿名化因子的分析。归因分析进一步表明,在控制了知识泄漏的条件下,LLM智能体的累积收益大部分可以由被动的市场和风格暴露来解释,而持续的选股阿尔法证据有限。研究得出结论,金融LLM基准测试不仅应评估智能体是否赚钱,还应评估收益来源是否反映了可迁移的投资技能。
简介
近年来,越来越多的系统将LLM视为一个“交易智能体”:它能观察市场、决定下一步行动并投入资本。围绕这一转变构建的基准测试分为两类:一类让模型在外部测试其阅读文件、回答问题或提取结构化信息的能力;另一类则将模型置于历史模拟器中,让其交易并报告投资组合收益。
当端到端框架成为评估LLM能否在资本市场“盈利”的标准方法时,两个评估缺陷变得突出:
知识泄漏:长期回测的日期范围常与前沿模型的知识截止日期重叠。因此,模型可以调用记忆中的股票代码、价格、日期和宏观叙事,而非真正分析当前数据。论文举了一个例子:在仅提供OHLCV衍生数据的评估环境中,当一个代表性模型能看到真实股票代码(如“SH601857”)时,它会写出“防御性蓝筹股,具有强大的下行保护,增加仓位”的决策理由;但当这些代码被匿名化后,即使输入相同的数字,该模型在25个测试单元中全部选择不交易。这表明驱动其行为的不是数据,而是股票代码。现有的修复方案要么会随着模型更新而缩小评估窗口,要么在静态预测中证明提示词级别的限制无效,从而需要在数据层面进行缓解。
收益与技能的混淆:即使控制了知识泄漏,累积收益也是一个有噪声的选股技能指标。正收益可能仅仅反映了市场贝塔值、持续的风格暴露或有利的市场环境,而非智能体的决策能力。为了解决这个问题,实证资产定价通过将收益分解为市场、风格和股票特定残差来处理;没有这种分解,金融LLM基准就无法区分“智能体赚钱了”和“智能体搭上了任何同类暴露组合都会有的因子便车”。
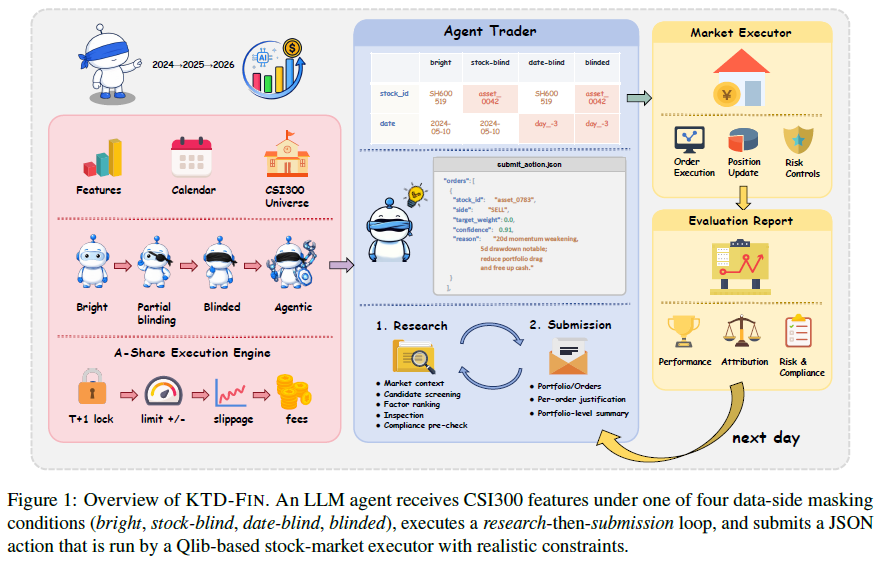
KTD-FIN基准正是为了解决这两个问题而设计的。在泄漏控制方面,它采用了一个四级数据匿名化协议(明亮、股票盲、日期盲、全盲),协调地匿名化股票代码、日历日期和工具返回的时间戳。在收益与技能混淆方面,它报告了一个Barra风格的每日截面归因结果,将每个智能体的可实现收益分解为市场、风格和选股阿尔法三个部分。论文使用三种决策模式来改变记忆暴露和信息访问。
在2024-01-01至2026-04-10的完整窗口上,对十个前沿LLM的评估结果清晰地映射到了这两个缺陷上:
i) 匿名化改变了交易行为:在“明亮”模式下,智能体的推理是品牌驱动的;在“全盲”模式下,则转向基于匿名化ID的因子排序推理。
ii) 累积收益不等同于选股技能:Barra归因显示,LLM智能体的名义收益大部分可由被动的市场和风格因子暴露解释,仅有一个模型的选股阿尔法接近零,其余均为明显的负值。
相关工作
金融领域LLM基准测试的演变,从文档理解框架(如FinanceBench、PIXIU/FLARE、FinQA等)发展到交易智能体评估(如FinMem、FinAgent、TradingGPT等)。这些基准共享对金融知识和交易决策的关注,但通常会将真实的股票代码和交易日历传递给模型,这混淆了模型的推理能力与其在预训练中学到的先验知识。
在污染感知基准测试方面,通用领域的工作包括LiveCodeBench(滚动收集截止日期后的问题)和Min-K% Prob(对预训练数据进行成员推理)。在金融领域,DeepFund仅在每个模型自己的训练截止日期之后对其进行评估,而OracleProto在静态预测的数据层控制暴露。KTD-FIN是第一个在协议内部控制预训练记忆暴露的序列决策金融基准,其匿名化由独立的十攻击者去匿名化探测认证。
KTD-FIN
KTD-FIN在严格控制预训练记忆暴露的条件下,将LLM作为股票市场交易智能体进行评估。它由四个相互关联的组件组成。
执行引擎
任务是每日在沪深300成分股范围内构建投资组合。在每个交易步骤中,智能体观察账户状态、当前持仓、上一步执行结果、相对基准表现和约束摘要,并最终发出一个JSON格式的操作。观察数据仅为价格信息(OHLCV历史和技术指标),不包含任何新闻、分析师报告或基本面数据。任何提及品牌、行业或基本面的推理,必然是预训练先验,而非基于当前观察。
执行引擎模拟A股交易的真实细节:仅做多,起始资金100万人民币,T+1规则,每笔订单最低费用5元,买入费用5个基点,卖出费用15个基点。订单在第二天开盘价执行。每日涨跌幅限制会过滤掉涨停的买入候选和跌停的卖出候选。
三种决策模式
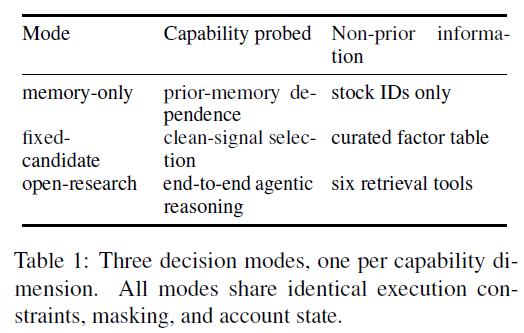
KTD-FIN将LLM的交易能力沿三个正交的能力维度进行分解:
仅记忆模式(memory-only):探测量化智能体依赖其预训练先验的程度,只提供股票ID和账户状态。
固定候选模式(fixed-candidate):探测量化智能体在干净信号中进行选择的能力,提供一个策展过的OHLCV+因子表格。
开放研究模式(open-research):探测量化智能体端到端智能体推理能力,提供一个包含六个检索工具的接口,供智能体自由调用。
四级匿名化协议
这是控制预训练记忆暴露的关键机制。它分为四个级别:
明亮(bright):真实股票代码,真实日期。
股票盲(stock-blind):匿名化股票代码,真实日期。
日期盲(date-blind):真实股票代码,相对日期索引。
全盲(blinded):股票代码和日期均匿名化。
匿名化别名在一个交易回合内是稳定的,但在不同回合之间会重新随机分配,以防止进行身份重建。所有数字特征(收益率、波动率、回撤)都基于原始时间序列计算,仅更改了标识符。
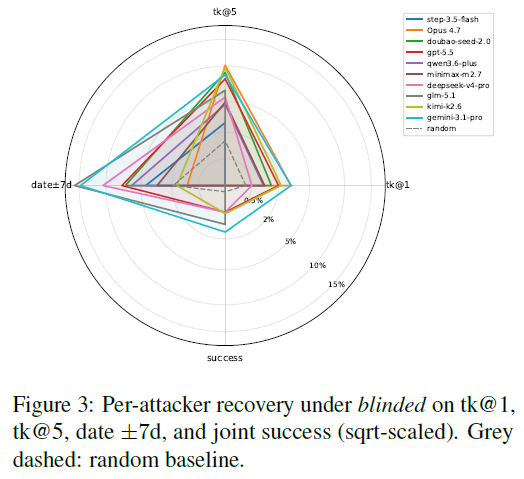
匿名化有效性:一个独立的十攻击者去匿名化探测(见4.3节)发现,联合恢复(股票代码+日期)的成功率最高仅为1.5%,证实了残差泄漏可以忽略不计。
工具中介的开放研究
“开放研究”模式作为一个ReAct风格的循环运行,包含两个严格的阶段:
研究阶段:模型可以调用六个只读工具(涵盖市场背景、候选筛选、个股快照、两两比较、投资组合状态和交易前风险检查)任意次数。初始提示仅包含账户状态和约束,模型必须主动通过工具检索市场信息。
提交阶段:模型被强制调用 submit_action 并发出JSON格式的订单列表。如果模式或约束违反,最多允许三次重试,之后默认为不交易。
行动模式
最终动作是一个JSON对象,包含 orders 列表和 overall_reason 字符串。每个订单包含 stock_id、side(买入/卖出)、confidence(置信度,0到1之间)、简短理由以及 target_weight 或 shares。
十维指标面板
KTD-FIN的核心论点是,LLM交易智能体不仅要根据其赚了多少钱来判断,还要根据如何赚钱来判断。报告分为三组:
收益与风险:总收益、夏普比率、最大回撤、信息比率。
行为:年化换手率、赫芬达尔-赫希曼指数(HHI)、现金比例、弃权率。
可靠性与校准:解析失败率、预期校准误差(ECE)。
实验
实验设置
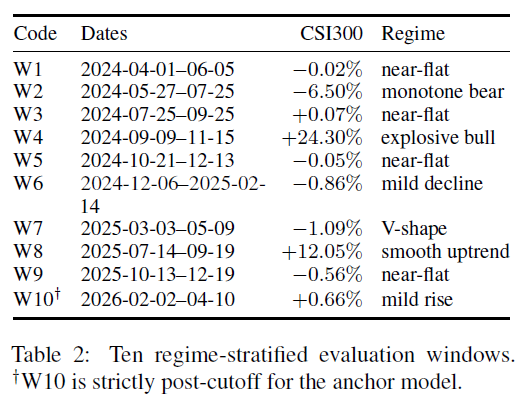
评估窗口:10个按市场状态分层的约43个交易日的短窗口(W1-W10),加上一个从2024-01-01至2026-04-10的连续长窗口(548个交易日)。
模型:主模型Step-3.5-Flash用于完整的“匿名化×模式×窗口”网格扫描。然后,10个前沿LLM在“全盲×开放研究”条件下运行长窗口进行主要对比。
基线:18个使用Alpha9特征训练的Qlib因子模型和沪深300买入并持有策略。
主模型深度扫描
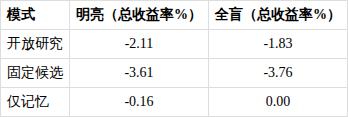
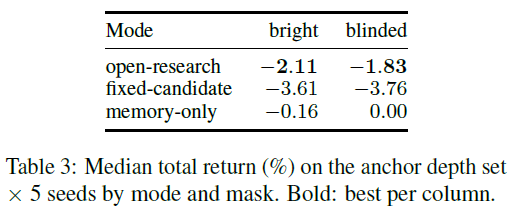
在主模型Step-3.5-Flash上,研究者扫描了四种匿名化级别和三种决策模式的组合。结果发现,仅凭预训练对真实股票代码的记忆,即使在没有观察通道的情况下也足以驱动活跃交易。例如,在“仅记忆”模式下,“明亮”模式产生了非零的交易,而“全盲”模式下现金持有率恰好为0.00%。此外,授予智能体工具访问权限(开放研究)持续提升了其能力。
去匿名化探测
为了独立认证匿名化协议,研究将“全盲”模式下智能体看到的精确匿名化负载喂给10个前沿LLM,让它们扮演攻击者,尝试恢复原始股票代码(前5名列表)、日期、行业和板块。结果显示,最强的攻击者只能恢复10.2%的股票代码(前5名),而联合恢复成功率(股票代码前5名+日期在±7个交易日内)最高仅为1.5%,与随机基线接近,证实了“全盲”模式有效地切断了模型与预训练记忆的联系。
跨模型排行榜
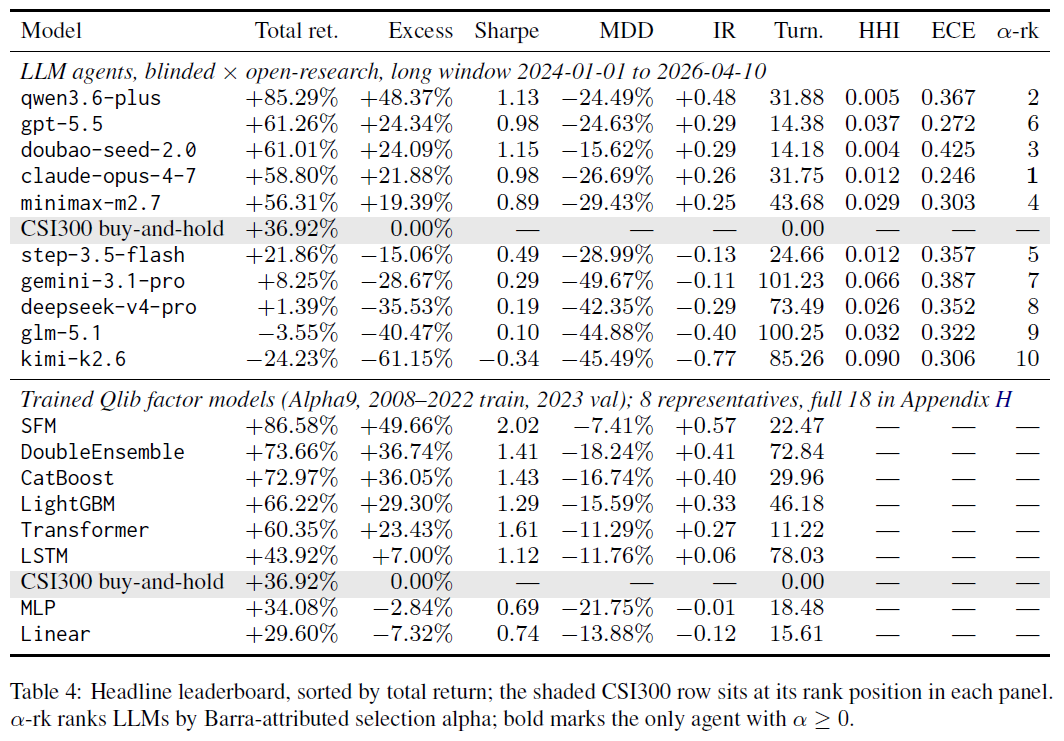
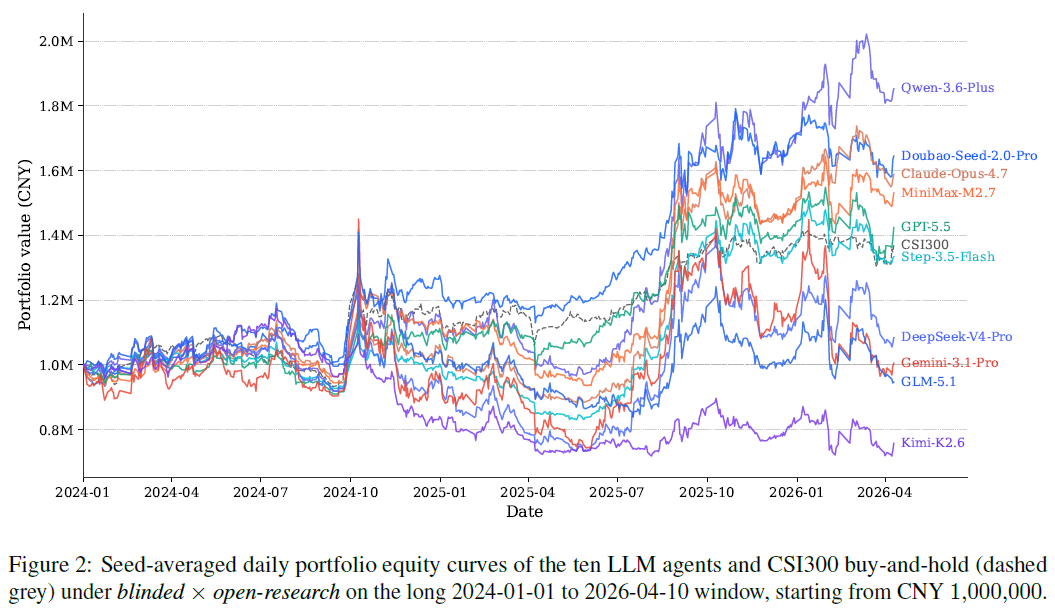
在“全盲×开放研究”条件下,论文展示了10个LLM智能体与沪深300指数的日均权益曲线。排名显示,像Qwen3.6-Plus、GPT-5.5等模型在总收益上表现优异,但18个Qlib因子模型(如SFM、DoubleEnsemble、CatBoost等)在夏普比率、最大回撤等风险调整后指标上表现更优,与平均表现较好的LLM相比毫不逊色。
Barra风格收益归因
论文通过Barra风格归因来区分收益来源。每日进行加权最小二乘法截面回归:
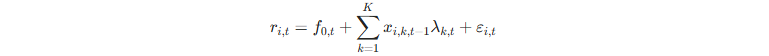
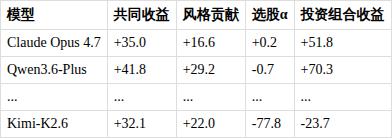
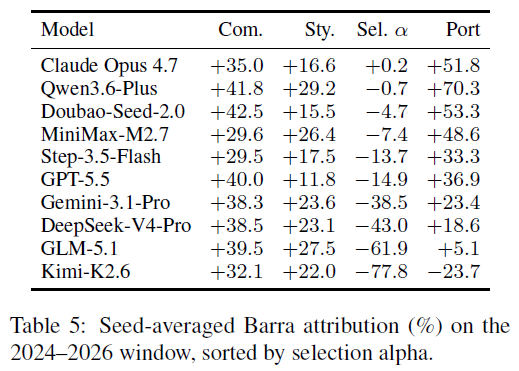
结果显示,几乎所有模型的收益都被市场和风格因子贡献所主导,而选股阿尔法部分则普遍为负。例如,总收益排名靠前的Claude Opus 4.7,其选股阿尔法仅为+0.2%,而其他模型大多为显著的负值。
讨论
匿名化减少了记忆泄漏
主模型在“明亮”模式下的订单理由会提及品牌身份、行业分类,甚至是无法从纯价格通道(如“10月18日涨停”)中恢复的特定历史交易日。而在“全盲”模式下,相同的模型收到相同的数字(仅代码被匿名化),其理由则简化为纯因子排名(如“20日收益率+27.4%,低波动率0.0255”)。这种质的转变伴随着可测量的交易行为变化,例如在“仅记忆”模式下,所有交易在代码被匿名化后消失。数据层面的匿名化做到了提示词级别限制无法做到的事。
累积收益夸大了技能
Barra归因分析将几乎所有模型间的收益方差都集中到了因子调整后的选股阿尔法上。市场和风格贡献的范围远小于选股阿尔法的范围(+0.2%至-77.8%)。因此,总收益排名与选股阿尔法排名大相径庭。例如,总收益排名第一的Qwen3.6-Plus,其选股阿尔法为-0.7%。这个发现意味着,如果基准仅使用累积收益作为唯一标准,系统性地高估了那些成功押注了当期流行因子的智能体,而低估了真正的选股能力。
因子暴露偏好
无论是机器学习模型还是LLM智能体,都表现出对长期动量、52周高点和避免低流动性股票的一致偏好。然而,它们在处理波动率、日内动量等因子上存在显著差异:机器学习模型倾向于持有安静、趋势向好的大盘股,而LLM智能体则倾向于波动率大、近期有交易热点的股票。
局限性与未来工作
当前实现专注于沪深300 A股市场,使用纯价格观察通道(OHLCV及技术因子)。它不涵盖美股、港股,也不支持多模态输入(如新闻、财报)。完整的“匿名化×模式×窗口”网格仅在主模型上运行,其他模型仅在核心的“全盲×开放研究”条件下评估,这在计算上受到限制。未来计划扩展市场覆盖范围并增加基于时间戳的对齐多模态数据。
总结
KTD-FIN通过一个四级匿名化协议和Barra风格归因,有效地解决了评估LLM交易智能体时存在的两个主要问题。总结发现,在控制了知识泄漏后,LLM智能体取得的收益主要源于被动的市场与风格因子暴露,而非持续的选股阿尔法。通过数据层面的匿名化关闭“记忆通道”并结合归因框架,可以广泛适用于基于新闻和基本面的LLM评估。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
