34.5M小模型暴打235B巨兽!PP-OCRv6怎么做到的?
你还在用几十亿参数的大模型做OCR?效果可能还不如一个35MB的轻量模型。
这不是标题党。我们看到的最新评测数据显示,一个仅有34.5M参数量的OCR系统,在文本检测和识别上,把GPT-5.5、Gemini-3.1-Pro等千亿级视觉语言模型(VLM)甩开了好几个身位。
这就是PP-OCRv6,一个从头到脚被重新设计的轻量级OCR系统。它在精度上远远超越了“大块头”们的通用能力,还用极低的计算成本,精准解决了VLM在OCR任务中最致命的“幻觉”问题。
如果你正在为工业落地寻找既快又准的文字识别方案,或者对大模型的实际应用边界感到困惑,这篇硬核拆解将彻底刷新你的认知。
核心痛点:为什么“通用大模型”搞不定一张名片?
视觉语言模型(VLMs)近两年确实风光无限。从拍图识物到复杂的文档问答,它们展现出了惊人的通才能力。但在最基础、最需要确定性的OCR任务上,“通用”反而成了它们的阿克琉斯之踵。
我们来看看当前技术流派面临的三个“拦路虎”:
- 定位不准:你让VLM识别一张表格,它也许能说出表格大意,但常常无法给出每一个单元格精确到像素的边界框。对于文档解析、工业质检来说,这直接意味着不可用。
- 幻觉严重:这是大模型的老毛病。当图像里的文字不清晰或不符合常规语法时,VLM会自作主张地帮你“脑补”成通顺的句子。比如,它可能把一串脏乱差的点阵字符
E E E E强行修正为E E E E或eeee,这在金融票据和法律文书里是灾难性的。 - 成本巨大:为了识别几百个字符,你要动用一张价值数万美元的显卡去跑一个千亿参数的模型,吞吐量低、延迟高,成本完全盖过了收益。
PP-OCR系列一直走的是“专用轻量”路线。到了v5版本,其方法论已经证明:在高质量数据的驱动下,一个5M参数的模型上限远比你想象的高。 而PP-OCRv6要做的,就是把专用模型的架构潜力,推向一个全新的极致。
架构拆解:三个“小而精”的暴力美学设计
PP-OCRv6没有躺在数据红利上睡觉。它的核心团队发现,老版本的骨干网络(Backbone)在相同的数据条件下,已经撞到了结构容量的天花板。
为了捅破这层天花板,PP-OCRv6 围绕一个核心哲学 — MetaFormer范式 — 对整个系统进行了重构。简单说,就是把原来“搅和在一起”的计算,拆分成职责分明的“空间搅拌机”和“通道调酒师”,让它们各司其职。
我们先来看看它的整体框架。
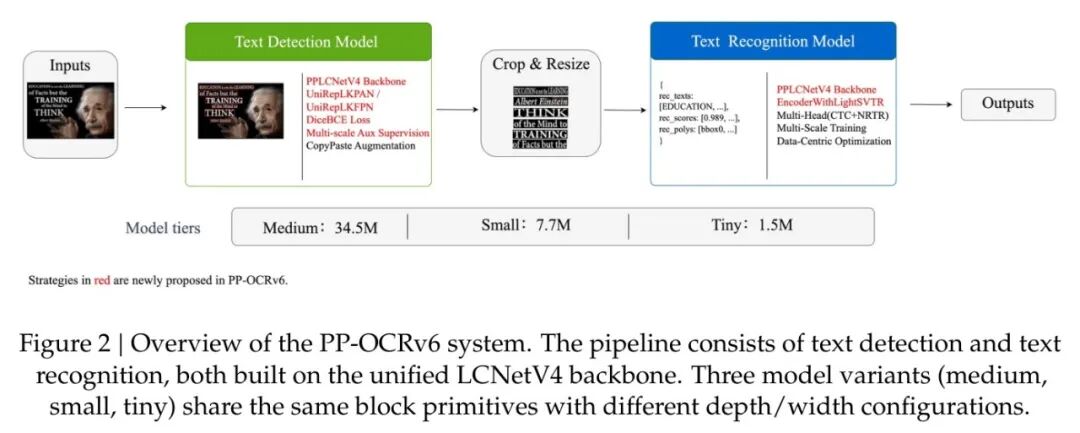
整个流程依然是经典的两阶段范式:检测→识别。但内部的每一个零部件都焕然一新。
💡 统一骨干:LCNetV4 的“变形金刚”基因
这是v6最核心的升级。过去,服务器和移动端往往用不同的骨干网络(如HGNetV2和LCNetV3),维护复杂。PP-OCRv6用一个统一的 LCNetV4 解决了所有问题。
LCNetV4的设计灵感来源于MetaFormer。它把每一个计算模块清晰地拆分为 Token Mixer(负责空间信息融合)和Channel Mixer(负责通道信息融合)。
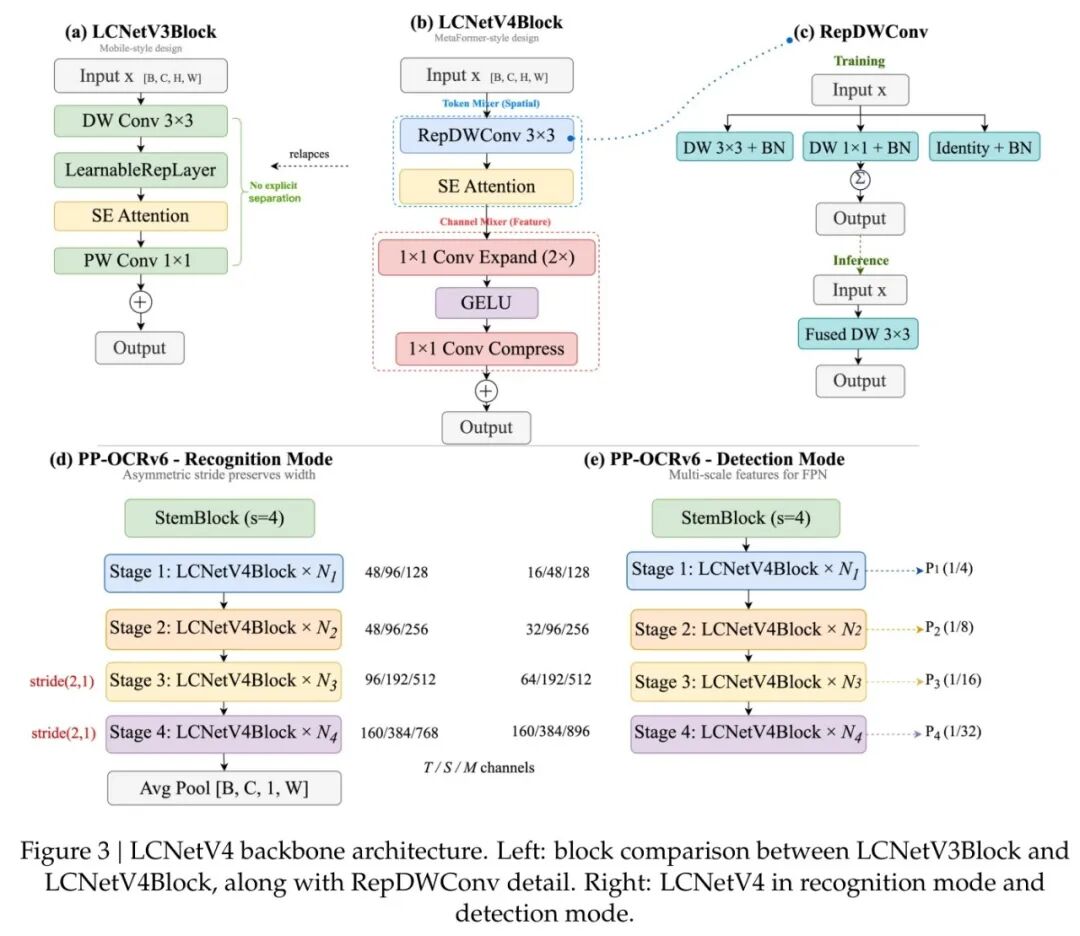
这是一个极其优雅的设计,其计算流可以抽象为:
首先,空间混合器处理输入特征 ,并加上残差:
接着,通道混合器用扩展比为2的1x1卷积进行变换,也加上残差:
这张架构图的(a)和(b)部分清晰地展示了LCNetV4与上一代V3的本质区别:把深度可分离卷积(DW Conv)挪到了模块的最前面,并用分离式的Channel Mixer替代了原来耦合在一起的PW Conv。 这种“分离-再融合”的机制,让网络有了更灵活的表达空间。
更精彩的是其中的“戏法”——结构重参数化(RepDWConv)。看上图(c),在训练时,Token Mixer并非单一路径,而是包含 3x3、1x1 和 恒等映射 三个并行分支,这相当于给模型提供了三个不同尺度的“老师傅”一起学习。而在推理部署时,这三个分支会被代数等价地融合成一个单一的 3x3 卷积核。推理速度不变,但精度因多分支学习而显著提升。
最后,LCNetV4还有一个任务感知的巧妙设计。它可以一键切换模式:
- • 检测模式:用标准的步长-2下采样,输出多尺度特征图 (1/4, 1/8, 1/16, 1/32)。
- • 识别模式:在深层采用非对称步长
(2, 1),只在高度方向压缩,保留宽度方向的序列信息,为后面的序列解码铺路。
💡 检测新篇:大核卷积与像素级雕琢
在文本检测上,PP-OCRv6的目标是既要看得广,又要看得准。
RepLKFPN:大核感受野的轻量化实现。 传统的特征金字塔(FPN)往往只靠 3x3 卷积来融合多尺度特征,感受野有限。RepLKFPN引入了一个由多个空洞卷积分支组成的“重参数化大核”模块。
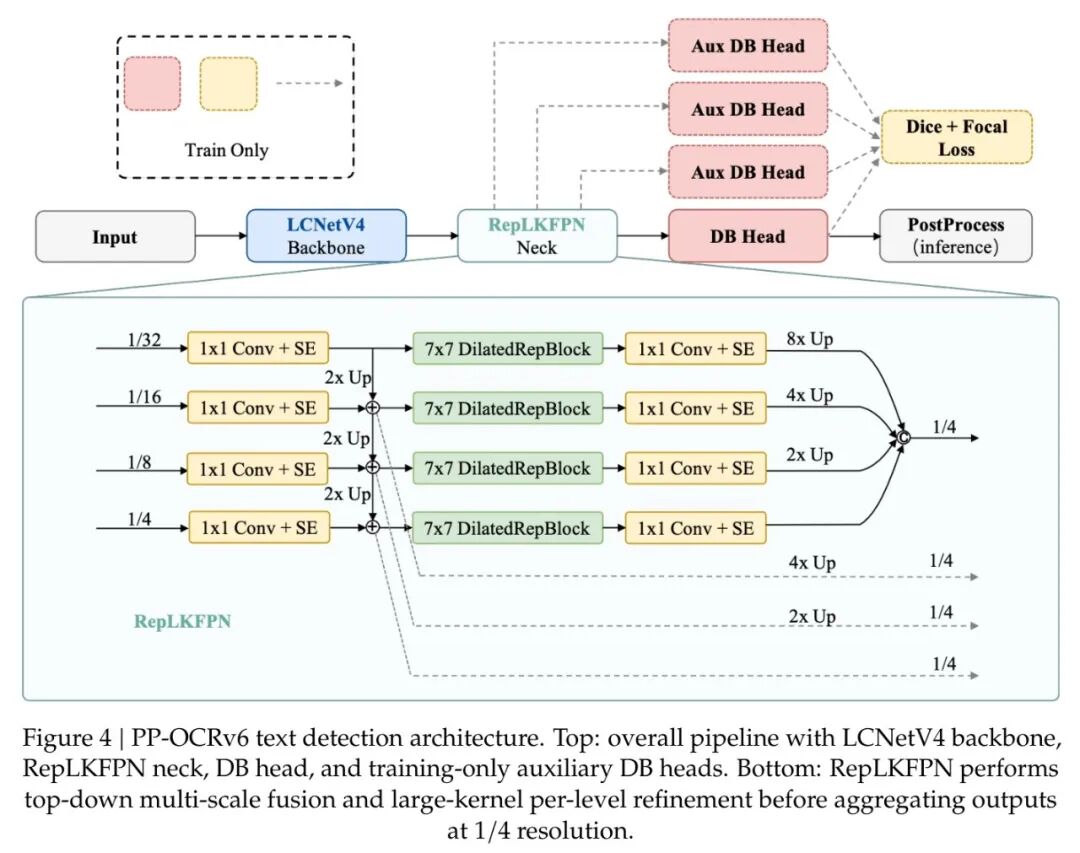
这张图是理解检测流程的关键。上半部分是主流程,可以看到LCNetV4骨干输出多尺度特征后,送入RepLKFPN进行融合,最后由DB Head输出检测结果。
下半部分放大了RepLKFPN的细节。对于从1/32到1/4的每一级特征,首先用一个 1x1 Conv + SE 调整通道,然后核心来了:一个 **7x7 DilatedReparamBlock**进行处理。这个大核空洞Rep模块在训练时包含并行的多个空洞卷积分支,感受野超大。推理时,它们被融合成一个单一的 7x7 深度可分离卷积(DWConv)。这个设计非常聪明,仅用118K的参数,就实现了比旧版172K参数方案更大的 7x7 感受野,在处理长文本和大尺寸文字时优势明显。辅助深度监督与Focal Loss。 为了让中间层特征学得更好,PP-OCRv6在FPN的三个中间层(P2, P3, P4)都加了辅助预测头,用Dice+Focal Loss进行监督。最终的损失函数是Dice Loss和Focal Loss的结合:
Dice Loss关注全局区域的重叠,而Focal Loss则负责在像素级别“死磕”那些难以区分的样本(比如模糊边缘),双管齐下,让检测框贴得严丝合缝。
💡 识别奥秘:EncLightSVTR 的局部-全局协奏曲
在文本识别阶段,PP-OCRv6是如何精准地读出文字,而不像大模型那样“脑补”的呢?
其核心在于一个名为 EncoderWithLightSVTR 的巧妙设计。
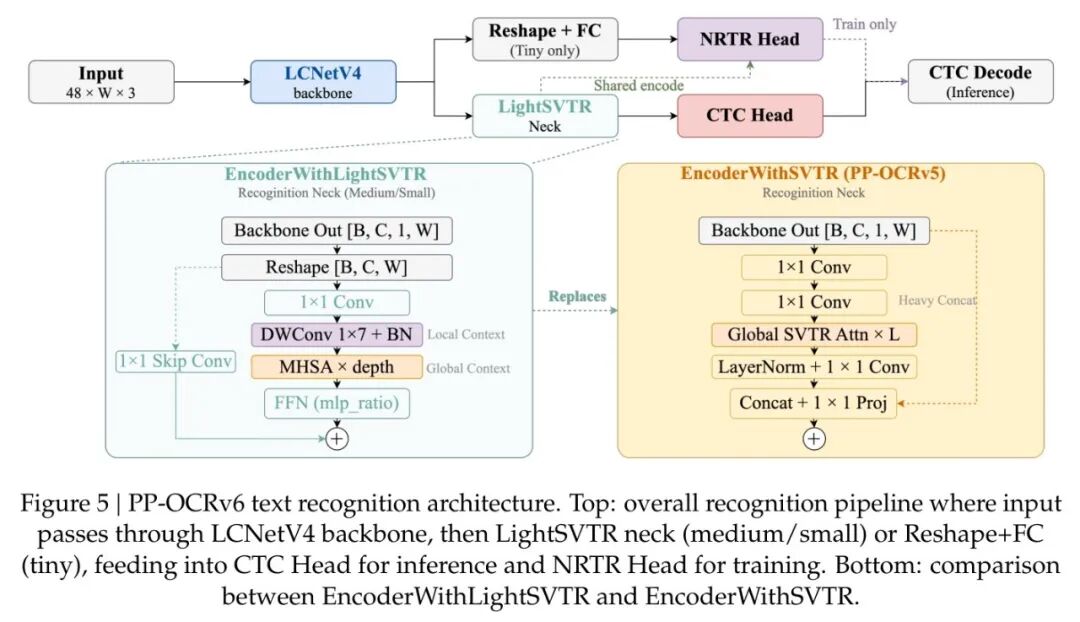
EncoderWithSVTR的结构差异。这张图的上半部分是识别主流程:骨干网络提取特征后,在Medium和Small模型中,送入LightSVTR Neck进行处理;Tiny模型则直接投影后送入多头解码器。
下半部分的对比更能说明问题。上一代(v5)的EncoderWithSVTR(左)使用全局自注意力和基于拼接的跳跃连接,计算量大。而新一代(v6)的设计(右)有两处关键改进:
- 加性跳跃连接:不再是简单拼接后降维,而是用轻量级投影后直接相加,大幅减少了
Neck部分的参数量。 - 局部上下文先行:在全局Transformer模块之前,预先插入了一个
1x1的深度可分离卷积核(DWConv 1x7)。这一层的意义在于,它让模型在读每一个字之前,先和左右紧挨着的字符打个招呼。这完全符合序列化文字的直觉:一个单词的相邻字母,或者中文的偏旁部首,确实包含对识别很有帮助的局部信息。
其计算流程可以形式化为:
最后,解码由 CTC + NRTR 联合完成。NRTR只在训练时参与,充当一个隐形的语言模型进行正则化;推理时,只保留可并行计算的CTC解码器。这从根本上杜绝了VLM自回归式生成的幻觉温床。
实验验证:数据不会说谎
理论说得再好,是骡子是马总得拉出来遛遛。PP-OCRv6在评测集上的表现堪称“碾压级”。
🏆 SOTA对比:不光是赢,而是根本不在一个量级
我们直接看文本检测的性能对比。
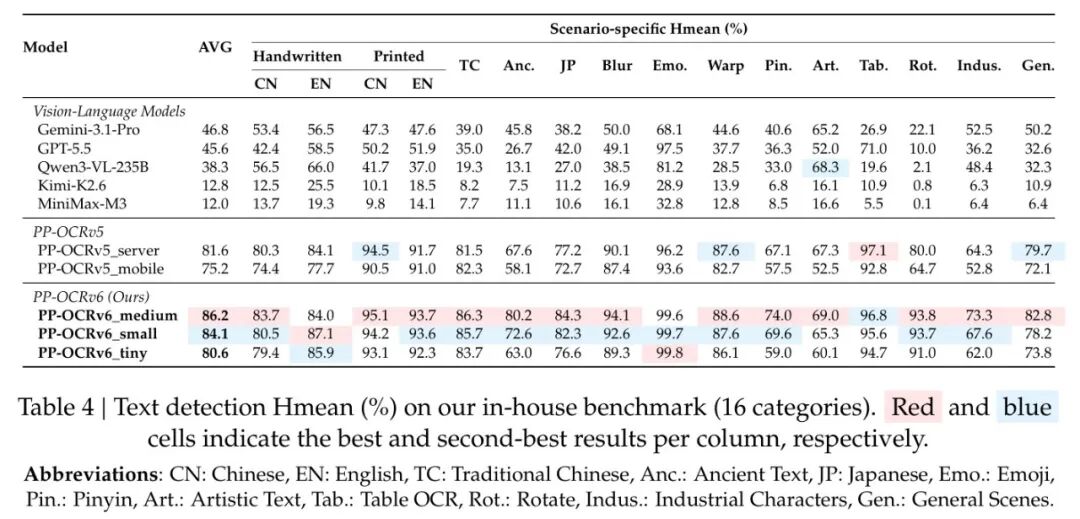
在这张包含16个细分类别的检测大榜上,PP-OCRv6_medium以86.2%的平均Hmean一骑绝尘。这个成绩不仅比自家的PP-OCRv5_server高出了4.6个百分点,更是把最强的VLM——Gemini-3.1-Pro(46.8%)远远甩在了身后。39.4个百分点的差距,几乎可以说是“专业队”和“业余爱好者”之间的鸿沟。即使是参数量仅0.43M的Tiny模型,也以80.6%的成绩超过了所有VLM。
文本识别也是同样的故事。
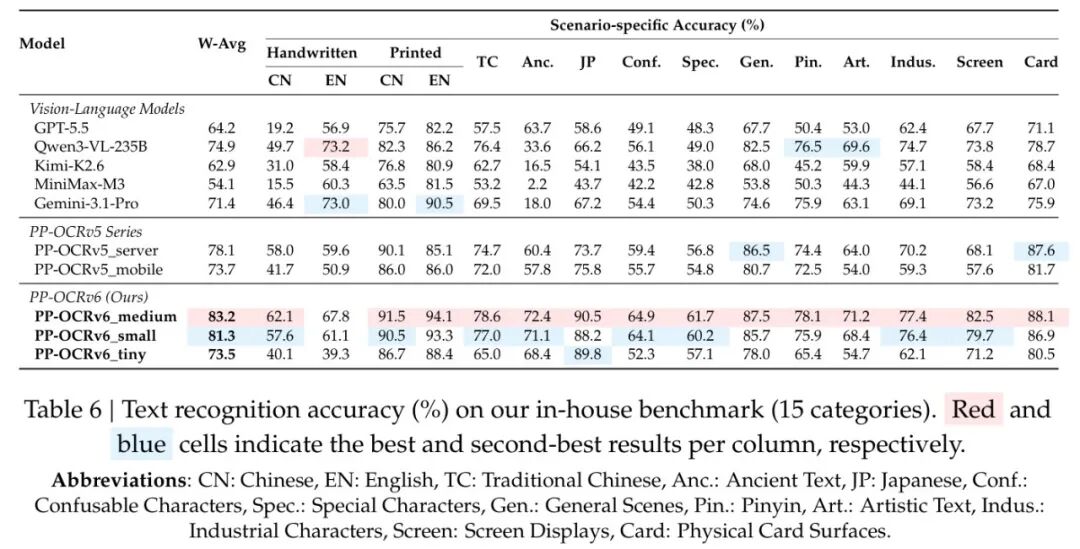
PP-OCRv6_medium取得了83.2%的加权平均准确率,比v5提升5.1%,更是比表现最好的VLM(Qwen3-VL-235B,74.9%)高出8.3%。而且别忘了,Qwen3-VL-235B的参数量是PP-OCRv6_medium的约6800倍!在古籍、屏幕显示等挑战性场景中,v6的提升幅度甚至超过了10个百分点,专门设计的威力展露无遗。
🔬 消融实验:“庖丁解牛”看贡献
PP-OCRv6每个组件的提升,都经过了严谨的消融实验验证。
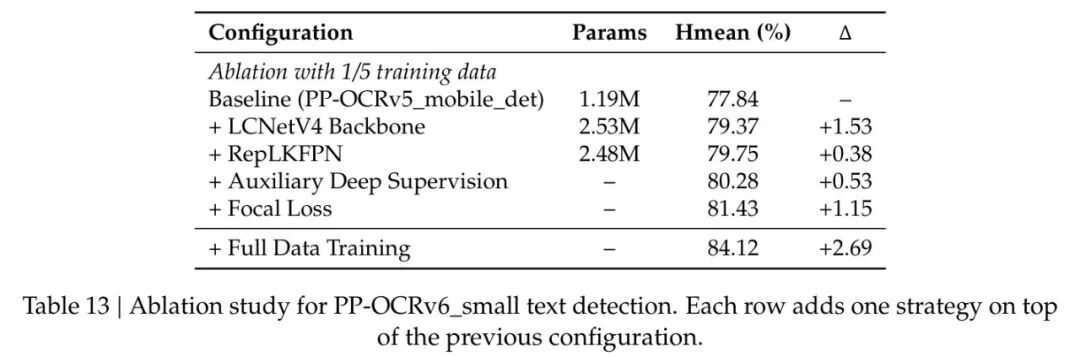
这张表揭示了检测性能提升的来源。在1/5的小数据训练设定下,从v5基线开始:
- • 替换为LCNetV4骨干,Hmean直接提升1.53点。这是提升最大的单步,证明了骨干架构升级的决定性作用。
- • 替换为RepLKFPN,在减少参数量的同时,再提升0.38点。
- • 加入辅助深度监督和Focal Loss,分别贡献了0.53点和1.15点的增益。
最终,用全量数据训练的最终模型,Hmean达到了84.12%,完全验证了从骨干、颈部到训练策略的全链路创新。
在识别方面,EncoderWithLightSVTR的设计比旧版提升+0.89%,CTC+NRTR多头解码设计比纯CTC提升+1.16%,而针对Tiny模型的知识蒸馏更是带来了+2.69%的巨大提升。
幻觉对决:VLM的死穴,OCR的试金石
对于实际应用来说,最致命的不是漏检,而是“无中生有”的幻觉。PP-OCRv6与VLMs进行了一场直击要害的“幻觉对抗赛”。
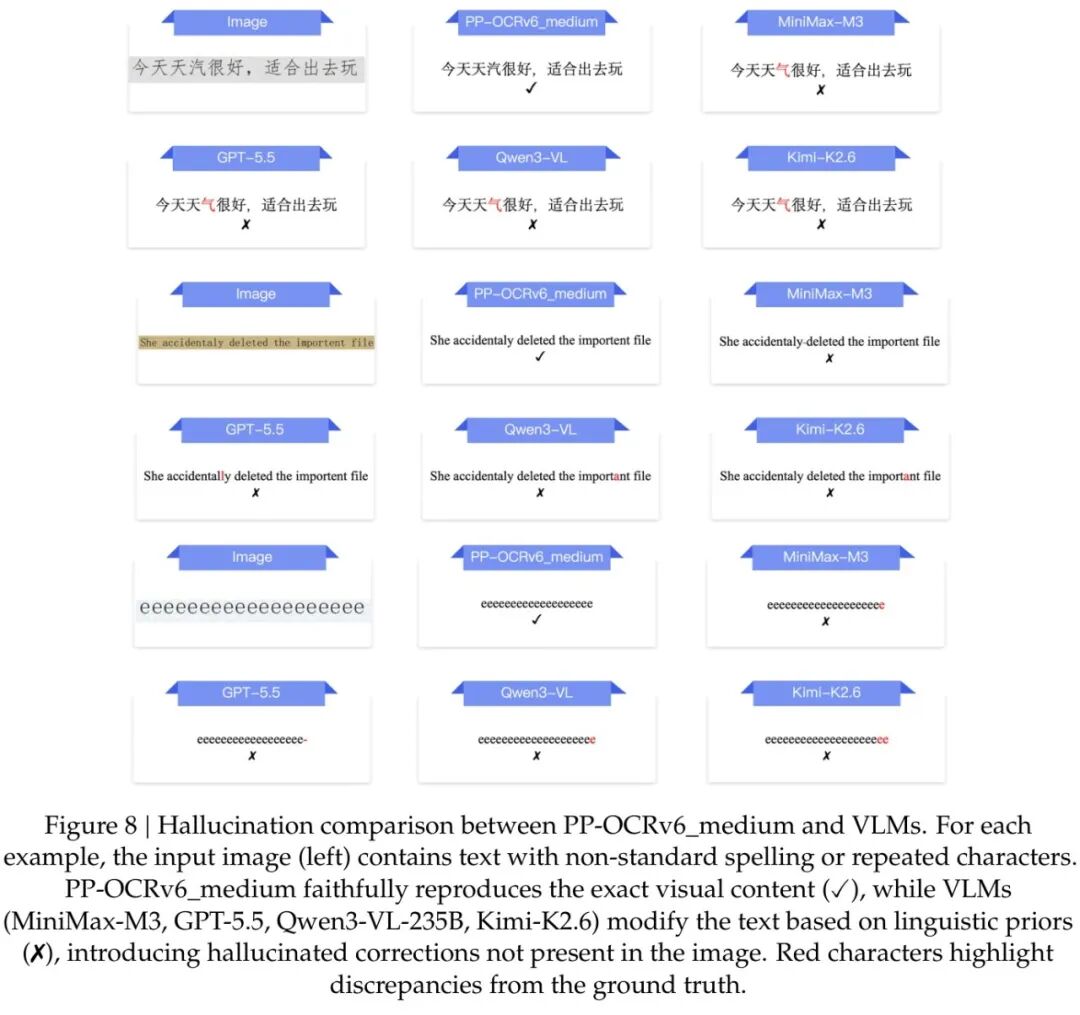
我们可以从这张图中直观地看到问题。图中有几行非常刁钻的测试样本:
- 第一行是重复字符
eeeeeeeeeeeeeeeeeeeee。PP-OCRv6老老实实地还原了所有字符,而MiniMax-M3、GPT-5.5等VLM都出现了不同程度的字符遗漏或修正。 - 后面的行次展示了带错别字或非标准拼写的文本,VLM们不约而同地“纠正”了原文的错误,输出了错误的、符合语言常理但违背视觉事实的结果。
PP-OCRv6之所以能忠实还原,是因为它的CTC解码机制是强迫模型去看像素,而不是去猜下文。定量测试也证实了这一点:
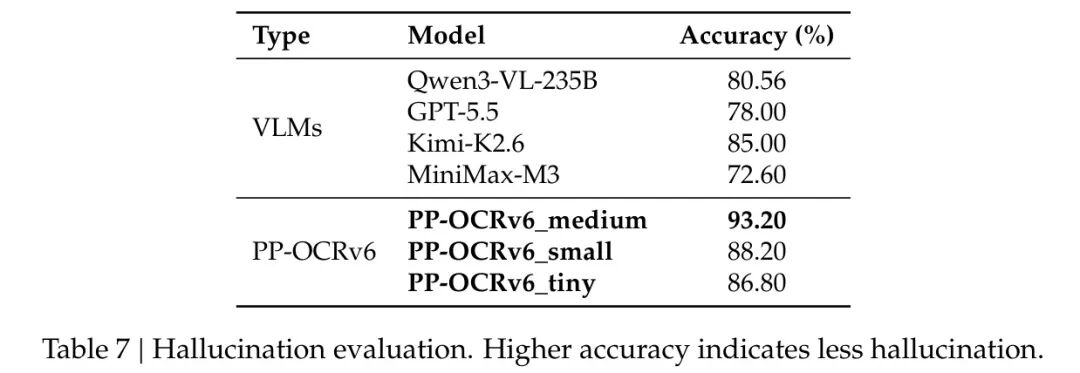
PP-OCRv6_medium的幻觉评估准确率高达93.20%,远超Kimi-K2.6的85.00%和Qwen3-VL的80.60%。所见即所得,这才是OCR系统在金融、医疗、法律等严肃场景中最该具备的基本素养。
结语:在大模型时代,重新定义“小而强”
PP-OCRv6的出现,并非要全盘否定视觉语言模型的价值,而是为技术选型提供了一种清醒、务实的视角。它有力地证明了,当“通用”的能力无法覆盖“专用”的精度与成本要求时,极致优化的专用系统依然是不可替代的最优解。
通过系统性的架构创新——统一的MetaFormer骨干LCNetV4、重参数化大核颈部RepLKFPN、轻量局部-全局识别器EncLightSVTR——PP-OCRv6不仅将OCR的精度天花板推向了新高度,更以1.5M到34.5M的极致轻量配置,覆盖了从云端到边缘的每一个角落。
它的成功带给我们的启示或许远超OCR本身:在盲目追求大参数、大力出奇迹的AI热潮中,回归问题本身,用精巧的架构设计和对数据本质的理解去解决问题,往往能创造出更优美、更具生命力的作品。> 🤔深度思考:你认为在哪些具体的业务场景中,VLM的“理解”能力会和PP-OCRv6的“精准”能力形成完美互补?欢迎在评论区分享你的真知灼见!
💝 支持原创:如果这篇文章帮你理清了轻量级OCR的发展脉络,或者对你的技术选型有所启发,不妨点个赞和在看,并分享给更多奋战在AI落地一线的朋友们。
🔔 关注提醒:硬核技术解读,拒绝人云亦云。点击下方卡片关注,设为星标,第一时间获取最前沿、最深度的大模型与AI架构解读!
#AI技术 #深度学习 #模型优化 #技术干货 #论文解读
参考
PP-OCRv6: From 1.5M to 34.5M Parameters, Surpassing Billion-Scale VLMs on OCR Tasks