ActiveSAM的“偷懒”哲学让SAM3推理快5.5倍、精度实现飙升
你是否想过,让AI看懂任意词汇描述的图像,却只需要一张消费级显卡就能跑出比现有最强方案还快5倍的速度?这在以前听起来像是"既要又要"的奢望——开集语义分割(OVSS)领域,但凡追求精度就得堆计算量,而速度快的方法往往牺牲边界质量。今天解读的ActiveSAM,恰好打破了这个魔咒。
核心痛点:为什么值得你读完?
做开放词汇分割的同行都踩过同一个坑:词汇表动不动就膨胀到上百个类别,但单张图像里真正出现的只有寥寥几个。比如一张街景照片,无非是"道路""汽车""行人""建筑""天空",剩下90%的词汇全是冗余计算。现有方法硬着头皮跑全量词汇解码,结果FPS掉到个位数,工程师们只能叹气。
更扎心的是,当前最强的免训练分割方案SegEarth-OV3,虽然精度不错,但因为老老实实处理每个Prompt,在大词汇基准上推理慢得像在爬。你能想象自动驾驶系统每帧都要花几秒钟去做语义分割吗?这根本不现实。
ActiveSAM的核心思路正好戳中这个痛点——先快速筛查哪些类别值得认真看,再针对性地做精细解码。就这一个简单的"先粗后精"策略,直接把推理速度提了5.5倍,精度不降反升1.4个mIoU。怎么做到的?我们一层层拆开看。
原理拆解:四阶段流水线如何让冻结SAM 3"主动"起来
ActiveSAM的本质是在冻结SAM 3上建了一个"智能调度层",用四阶段流水线把零散的文字Prompt变成精准的像素级语义地图。先看整体架构,心里有个全局概念。
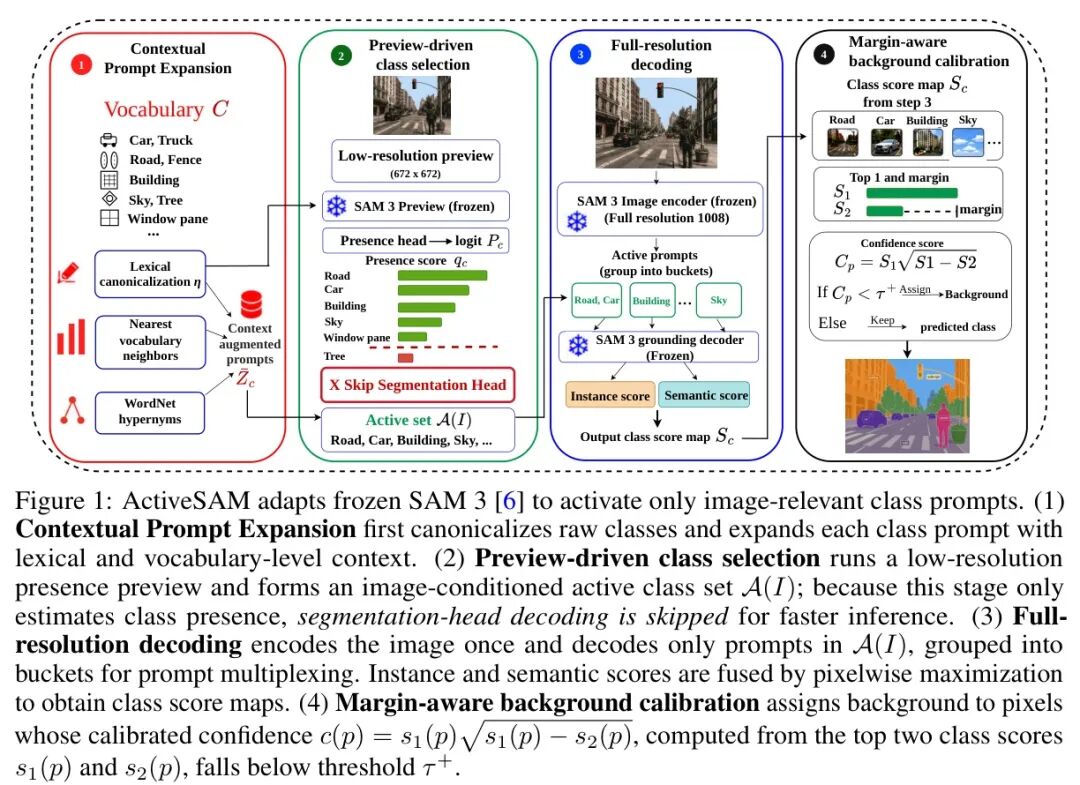
这个流水线的美妙之处在于:冻结的SAM 3权重全程一动不动,ActiveSAM只是在外围做Prompt的调度和融合。接下来按阶段逐一深扒。
💡 上下文提示扩展
单纯把一个类别名词扔给SAM 3,模型有时候会懵:"windowpane"是什么东西?数据集标签拼在一起的长词,文本编码器没见过,那自然就成了噪声。ActiveSAM的第一步就专门解决这个问题。
词汇规范化器η登场。 这是一个固定规则引擎,包含47条确定性修复:28个复合词拆分(如windowpane→window pane)、12个词序修复(如wallbrick→brick wall)、7个模糊标签替换(如tie→necktie)。它不是训练出来的MLP,就是硬编码的字符串操作——零额外参数、零推理延时。
规范化之后还不够,作者又加了两个语义扩展分支来增强每个类别Prompt的表征能力:
- • 最近邻检索:在预定义的词汇嵌入空间中,找与当前类别最相近的若干邻居词,将其文本嵌入作为补充上下文。
- • WordNet上位词:查询规范化类名的名词同义词集,提取前两个直接上位词。比如"狗"的上位词可能是"犬科动物""哺乳动物",让模型更理解这个词的语义层级。
这三个来源的嵌入(规范化词本身、最近邻、上位词)在Token轴拼接,得到增强后的类别Prompt 。作者的处理很聪明:每个数据集的增强Prompt只计算一次并缓存,实际推理时直接读取,额外开销几乎为零。后续消融实验会证明,这步贡献了方法中最大的精度增益——平均+1.0 mIoU。
💡 预览驱动类别选择
这是ActiveSAM效率爆炸的秘密所在。传统的全面解码对所有类别一视同仁地跑全分辨率,但ActiveSAM先问一个更廉价的问题:这些类别在图像里存在吗?具体做法:输入图像先缩到672×672的小尺寸送入冻结SAM 3,调用存在性头输出每个类别的存在分数。注意,这时候分割头根本没启动,完全跳过了昂贵的Mask生成计算。存在性头只判断"类别出现与否",而不是"像素归属哪里",所以这个小尺寸版本跑起来飞快。
拿到分数后,取前20%(阈值)的高分类别,并设一个上限,形成最终活跃集。这张图像跟"斑马""沙发"没关系?对不起,后面的全分辨率解码压根不会碰你们。
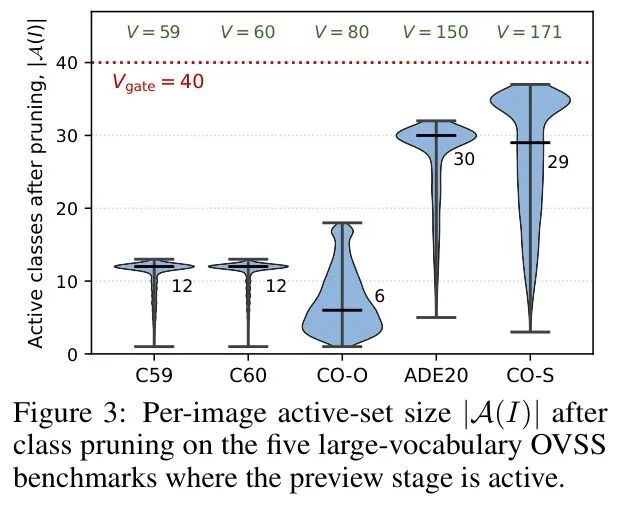
这个剪枝有多猛?看图3的小提琴分布。ADE20K总词汇量171,但剪枝后活跃类别中位数只有30;COCO-Object总词汇80,中位数降到6。红色虚线标出的几乎没被触发——真正需要深挖的类别少得可怜。
你在实际项目中是否也遇到过"全量处理浪费算力"的困境?这个剪枝策略是不是让你有了新想法?欢迎评论区聊聊你的场景~
💡 全分辨率解码与分桶复用
有了活跃集,接下来就是正经画Mask了。SAM 3的全分辨率编码器处理1008×1008的原图,生成图像特征X(只需算一次)。活跃集中的类别按数据集顺序分组,每32个一"桶",在Token轴拼接后打包送入冻结的接地解码器。
这里有个关键的细节:桶内共享解码器前向传播。传统的逐一解码需要连续调用解码器次,ActiveSAM的分桶策略把这个次数压缩到次。对于活跃集大小中位数6的COCO-Object,只剩1次解码。原来需要反复初始化的计算量瞬间被榨干。
解码后拿到两类分数:实例分数(来自实例头)和语义分数(来自语义头)。两者按通道取最大融合成。接着门控存在分数做进一步筛选——低于0.3置信阈值的Mask直接丢弃。
这步的直觉很好理解:预览阶段给的是"类别是否可能存在"的粗判断,全分辨率解码拿出精确的"每个像素应该是什么",两者加权后去掉了大量低质量噪点。
💡 边缘感知背景校准
最后的难点来了:开集分割经常会遇到"模型硬要给像素分个类,根本不考虑背景"。比如街景里远处的大楼,模型可能纠结是"建筑"还是"天空",但其实两者分数都低,更应该标成背景。
ActiveSAM的做法干净利落:取每个像素的Top-1分数和Top-2分数,计算置信度:
这里用衡量模型决策的"犹豫程度"。如果top-1和top-2分数很接近(比如0.42对0.41),说明网络自己对预测没啥信心,这个margin就很小,置信度也就低。再乘上本身的质量,双重过滤虚警。
当置信度低于阈值(),像素直接归为背景。这个指数放大机制让临界样本更容易被判为背景,对边界像素特别有效。
消融实验显示,MABC模块在三个含背景的数据集上贡献了平均+0.5 mIoU。尤其是在VOC21上,单这个背景校准就加了0.9个点。处理不同场景的分割任务时,你曾因为模型"硬分"而产生边界混淆吗?这个小技巧也许正是你需要的优雅解法。
整套流水线看完,ActiveSAM的精髓在哪?把"是否可能有"和"具体在哪"两个问题解耦。低分辨率预览只答前者,快;全分辨率解码只答后者,准。这个"解耦加速"的思路,在其他需要处理大规模候选集的视觉任务上可能同样奏效。
实验验证:精度和速度双重碾压
论文实验设计得相当扎实,八基准对比、损坏鲁棒性、组件消融,每个维度都经得起拷问。
🏆 SOTA对比:精度天花板再抬1.4个点
八基准(PASCAL VOC、Context、COCO-Object/Stuff、ADE20K、Cityscapes等)上的主结果对比,直接看表。
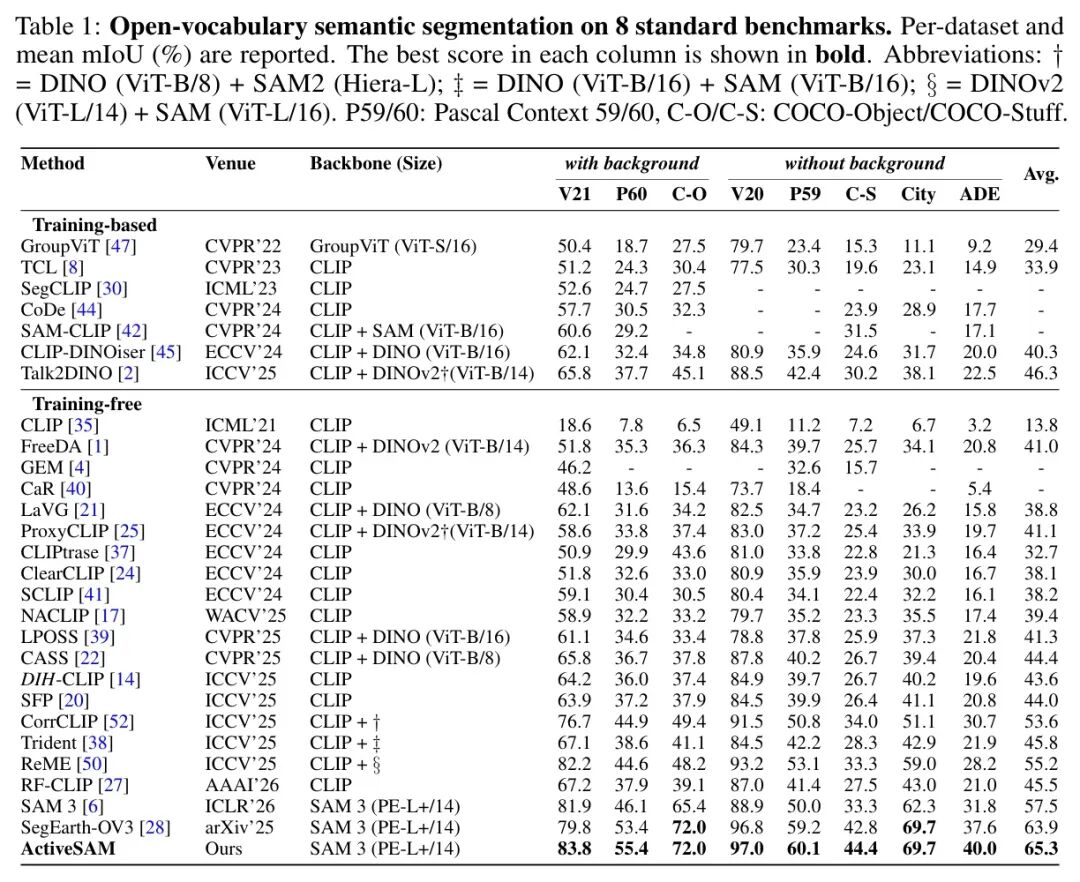
ActiveSAM的平均mIoU拉到65.3%,比SegEarth-OV3的63.9%高出1.4个百分点,比原始SAM 3的57.5%高出7.8个百分点。具体到单数据集:VOC21上ActiveSAM是72.8%对SegEarth-OV3的67.1%(+5.7),Context60上29.4%对29.0%(+0.4)。训练型方法如GroupViT在多个数据集上被ActiveSAM超越,尽管GroupViT是专门针对这些数据集训练的。
再看速度。
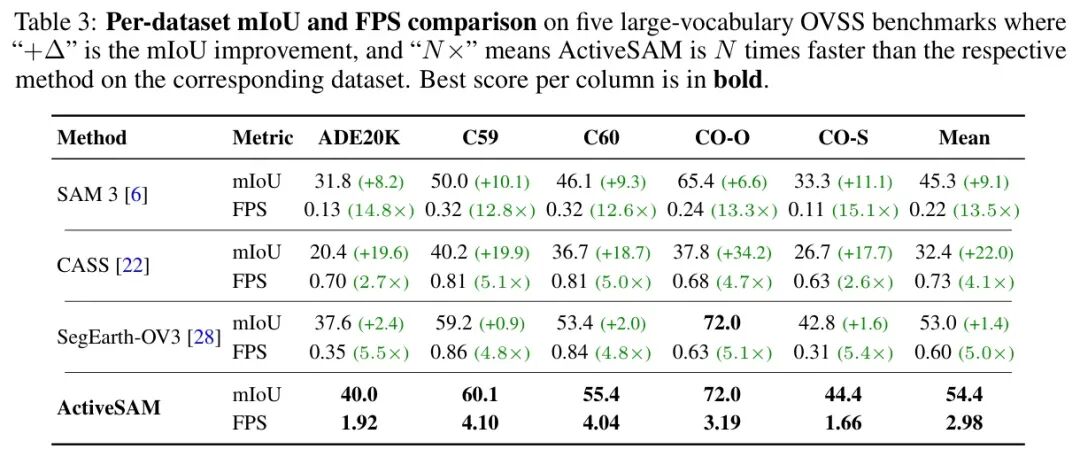
在五个大词汇基准上,ActiveSAM不仅mIoU均值最高(54.4),FPS平均也飙到2.98——SegEarth-OV3只有0.59(差了整整5倍),原始SAM 3更是0.22(慢13.5倍)。也就是说,ActiveSAM不仅跑得更快,还比慢悠悠跑完所有类别的模型更准,"快且好"拿到手。
精度-效率权衡的全局视角,散点图更直观。
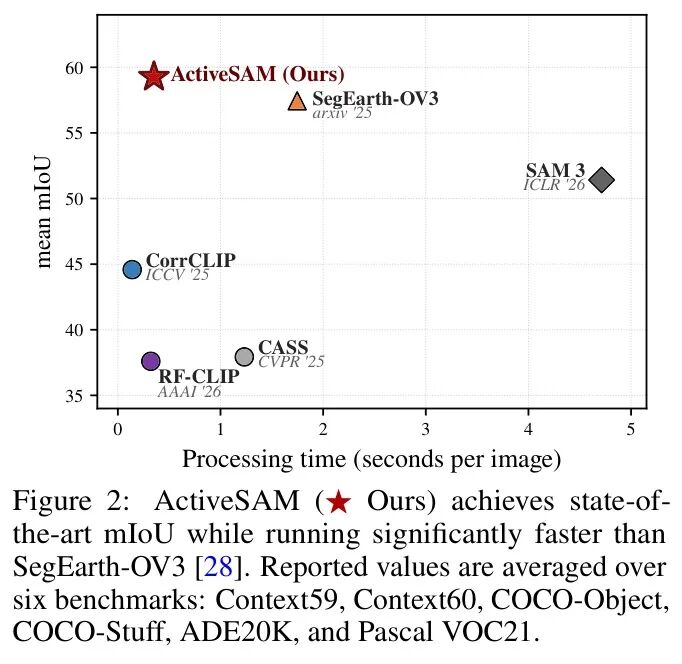
ActiveSAM和其他方法的散点分布一目了然:越靠左上角越好(高mIoU + 低处理时间)。ActiveSAM稳稳落在最左上,把SegEarth-OV3、SAM 3、CASS等全部甩在右下方。这幅图完美诠释了论文标题里的"Fast and Accurate"。
📸 可视化对比:边界更清晰,误检更少
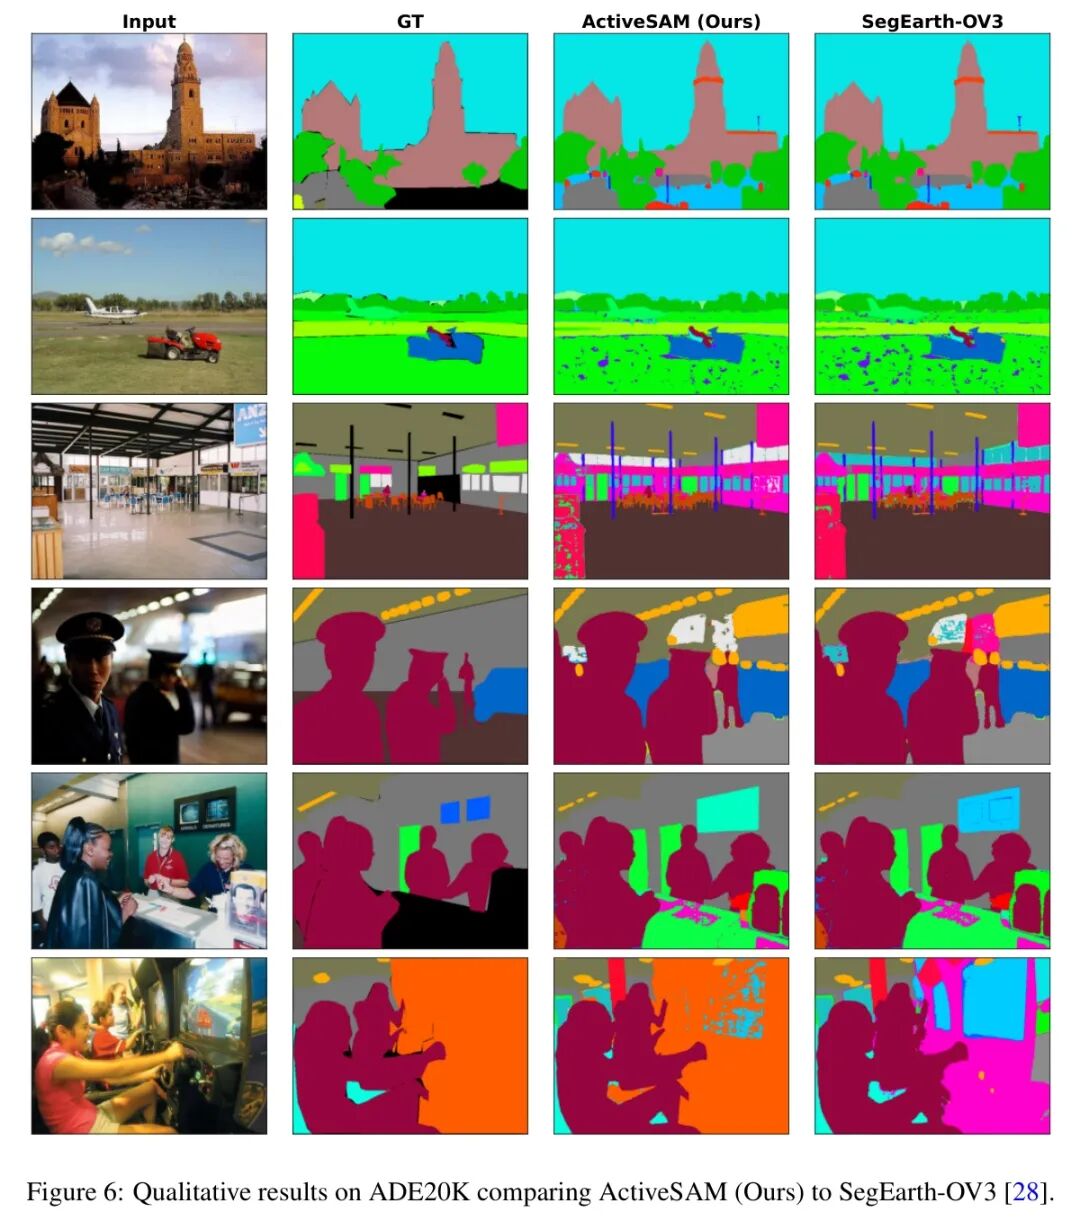
光看数字不够直观,定性对比直接上。多数据集的多组样例都展示了一致的优势。
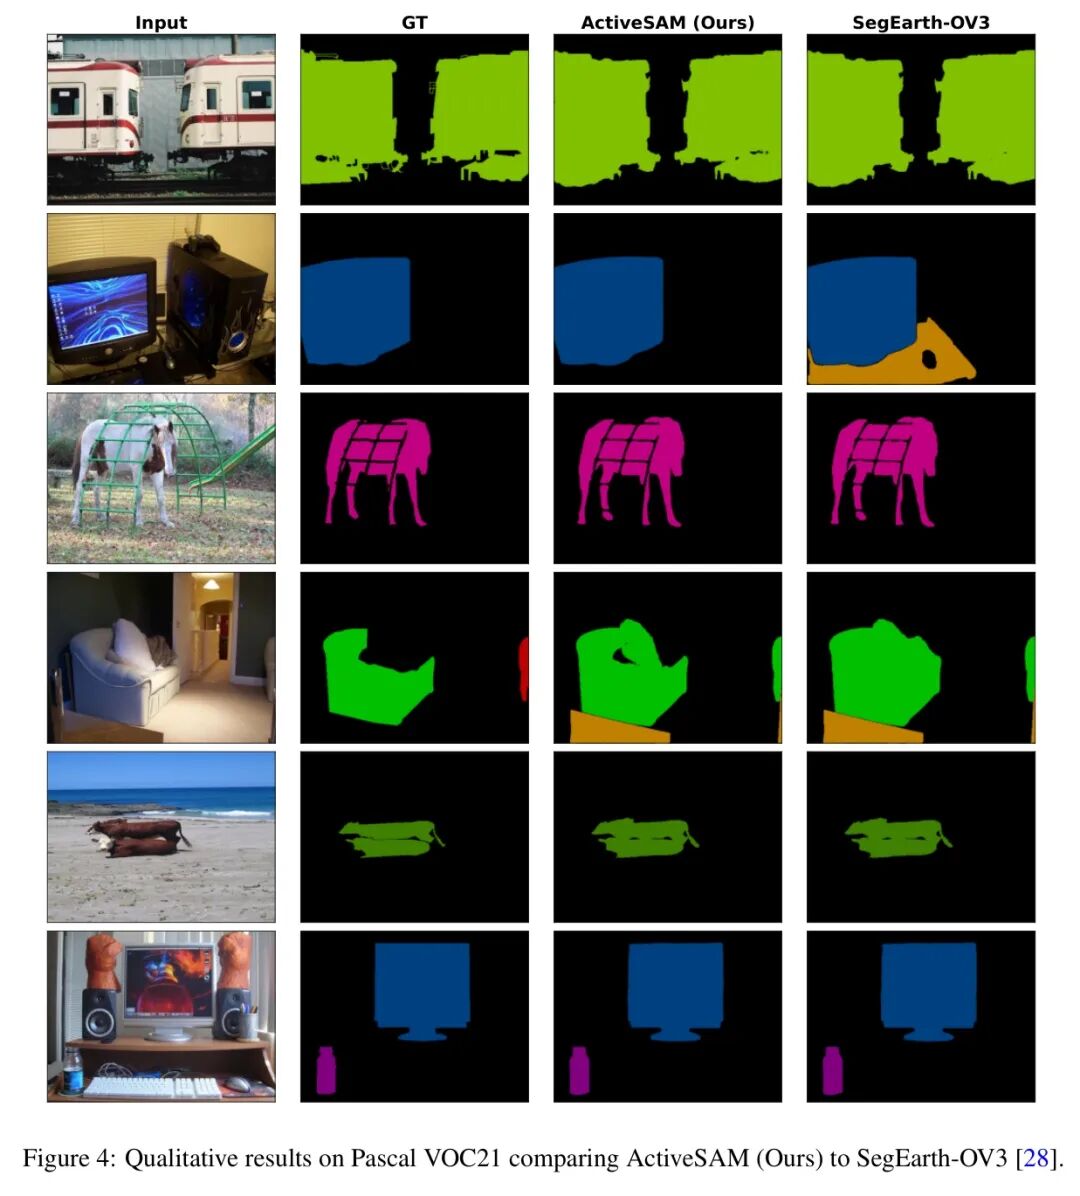
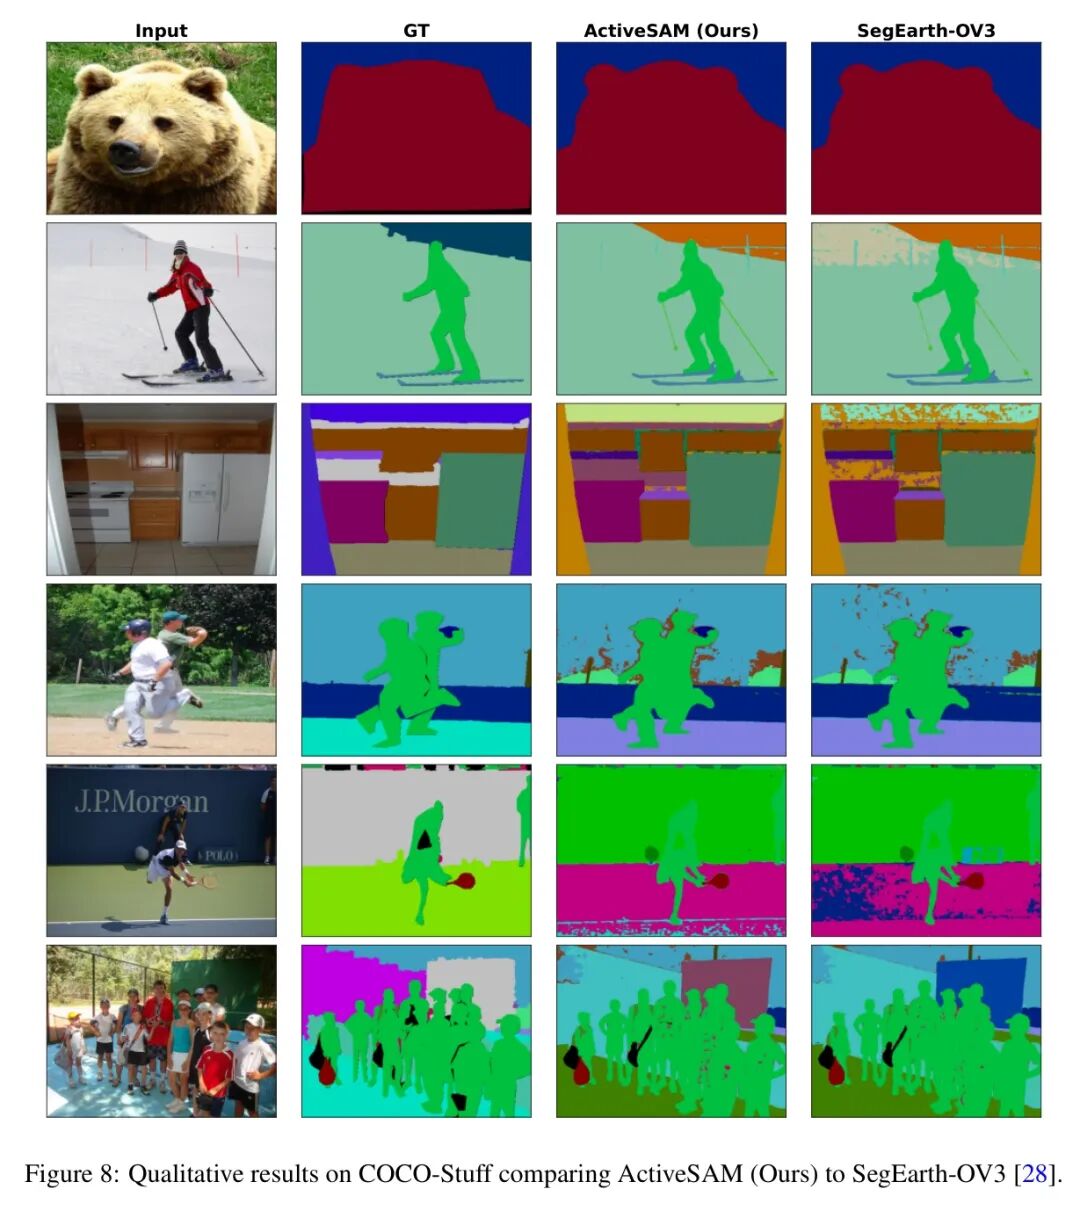
图4的VOC21上,ActiveSAM在显示器区域分割更完整,没出现SegEarth-OV3那种局部缺失;马匹的轮廓也更贴近真实。Cityscapes街景中同样如此(图5),车辆和行人的边界更锐利,交通灯小目标的漏检更少。再看ADE20K(图6),室内大厅、人物近景这些复杂场景下,ActiveSAM对建筑细节的捕捉和人物轮廓的高精度保持,明显优于基线。
COCO-Stuff的多样化场景(图8)也验证了区域完整性和细节处理的提升,熊、滑雪者、厨房用具的边界非常干净。
🔬 消融实验:每个模块的贡献明明白白
拆掉各个组件再看,才能放心。
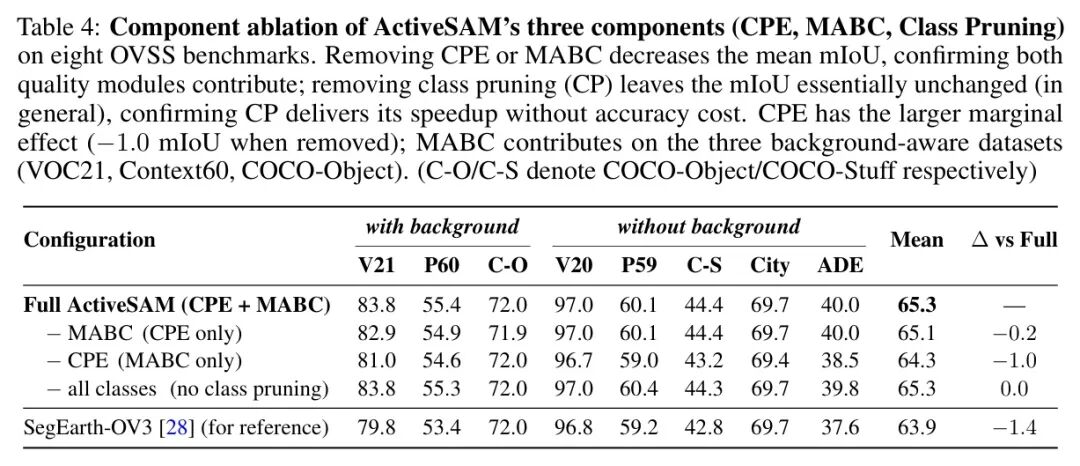
移除上下文提示扩展(CPE),平均mIoU立刻从65.3掉到64.3——1.0个点的差距,充分证明这47条规则的"花小钱办大事"。移除边缘感知背景校准(MABC),在含背景的三个数据集(VOC21、Context60、COCO-Object)上有损,VOC21上掉了0.9个mIoU。而最关键的反转:关闭类别剪枝后精度纹丝不动(∆=0 mIoU),说明剪枝省下的巨大计算量没有牺牲一丝精度。
🛡️ 鲁棒性验证:损坏图像下依然最强
真实世界没有干净图像,损坏鲁棒性测试必不可少。表2在四种损坏(高斯噪声、运动模糊、JPEG压缩、雾天)下,ActiveSAM全部胜出。
运动模糊下平均mIoU是SegEarth-OV3的1.2倍,雾天下也显著领先。这意味着自动驾驶系统跑在雨天、低光照场景,ActiveSAM依然稳得住。你觉得这项技术在真实噪声环境下最可能应用到哪个领域?欢迎在评论区留下你的判断~
客观评价:优势与局限并存
局限性同样值得诚实对待。首先,剪枝机制依赖低分辨率预览的存在性头,小目标或被遮挡物体在这个阶段可能直接漏掉——分数低于阈值就被永久剪除,全分辨率解码器根本没机会救。其次,上下文提示扩展的WordNet部分是纯英文词典,高度专业化的医学术语或工业术语并不在其中,跨领域泛化有限。计算开销反而不用担心。整体冻结SAM 3,预览阶段还禁用了分割头,额外引入的参数只有那47条规则和分桶调度的几个超参。单卡NVIDIA RTX 5090就能跑出2.98 FPS,对部署相当友好。
价值升华:这套范式能迁移到哪?
读完ActiveSAM,三点核心收获值得带走:
- • 解耦加速范式:把"是否存在"和"定位在哪"拆开,用廉价的前置模块做筛选,再让重计算模块聚焦候选子集。这个思路可以复用到任何"候选集远大于实际正样本"的感知任务中——比如多对象跟踪、开放词汇检测等。
- • 零额外训练的冻结适配:一个冻结基座模型+外围调度层,既能保留预训练知识的完整性,又能大幅提效。对于无法重训大模型的场景(移动端、实时系统、数据受限领域),这种范式比微调更可行。
- • 边界感知的置信度估计:用Top-1和Top-2分数的差值衡量模型"犹豫度",结合绝对分数做软背景过滤。这种非参数的后处理技巧,在任何需抑制虚警的分类/分割任务上可能都有奇效。
🤔 深度思考:ActiveSAM的"先预览后精修"范式,是否让你想起了两阶段检测器的"RPN+Detector"设计?这种古老而有效的哲学在VLM时代被重新激活,你觉得下一个会被类似思路重构的任务是什么?欢迎在评论区留下你的观点!
💝 支持原创:如果本文帮你理清了ActiveSAM的核心逻辑,点赞+在看就是最好的支持!转发给你做分割、多模态、自动驾驶的同事,让他们也感受到"不再为冗余计算买单"的快乐~
🔔 关注提醒:设为星标,第一时间获取深度技术解读!我们只拆解让你真正有收获的硬核论文。
#AI技术 #深度学习 #语义分割 #基础模型 #论文解读
参考
ActiveSAM: Image-Conditional Class Pruning for Fast and Accurate Open-Vocabulary Segmentation