ADIA Lab挑战赛复盘:因子投资如何从相关性走向因果驱动?
阿布扎比投资局(ADIA)旗下ADIA Lab曾经联合了2021年诺贝尔经济学奖得主Guido Imbens、哈佛因果推断大师Miguel Hernán、以及量化界公认的顶级大脑Marcos López de Prado,发起了一场全球因果发现挑战赛。奖金池10万美元,面向全球5000多名数据科学家和600多名博士。
核心问题只有一个:让机器从观测数据中自动发现"谁导致了谁",而不是"谁和谁一起变动"。
ADIA Lab是谁?
阿布扎比投资局(ADIA),全球最大的主权财富基金之一,管理资产规模超过万亿美元。ADIA Lab是其下属的数据与计算科学研究所,2022年成立,专门做前沿量化研究和AI应用。
主任Horst Simon来头不小——获得过计算机界的"诺贝尔奖",也就是Gordon Bell Prize。这个奖每年只颁给在高性能计算领域做出突破性贡献的团队。
但真正让这场竞赛分量倍增的,是它的顾问委员会。
Guido Imbens,2021年诺贝尔经济学奖得主。他获奖的原因就是解决了"如何从观测数据中推断因果关系"这个统计学难题。他和Joshua Angrist一起发明的工具变量方法,让经济学家不用做随机实验也能估计因果效应。在金融领域,这意味着你可以回答"如果我买入这个因子,收益会怎样",而不是"我观察到买入这个因子的基金收益怎样"。
Miguel Hernán,哈佛流行病学教授。你可能觉得流行病学和金融没关系,但Hernán是全球因果推断领域最权威的教科书作者之一。他的《Causal Inference: What If》被引用超过8000次,是因果推断领域的"圣经"。他从医学研究的角度发展出的因果推断方法,完全可以迁移到金融市场。
Marcos López de Prado,这个人量化圈应该无人不晓。ADIA全球量化研究主管、康奈尔大学教授、两次获得JPMorgan"年度量化研究员"奖。他的《Advances in Financial Machine Learning》几乎是量化ML领域的标准教材。近年来他一直在推动一个激进观点:因子投资需要从"相关性驱动"转向"因果驱动" ,否则整个行业都在建在沙地上。
Robert Engle,2003年诺贝尔经济学奖得主,ARCH模型发明人。波动率聚类、GARCH族模型,都是他的遗产。
还有图灵奖得主Shafi Goldwasser、前美国能源部长Steven Chu等人。
这是全球最顶尖的因果推断大脑,专门针对金融领域的因果发现问题设计的一次大规模实验。第一届竞赛(2023年)有超过5000次提交,通过CrunchDAO平台举办。第二届(2024年)聚焦因果发现,7月25日启动,10月24日结束。
因子投资的"相关性幻觉":一个被回避了十年的问题
López de Prado去年在JPM上发了一篇措辞相当激烈的文章,叫《Correcting the Factor Mirage》(修正因子幻觉)。里面有两句话让我印象极深:
“"The prevailing (associational) factor modeling paradigm leads to investment inefficiency."(当前主流的关联型因子建模范式导致了投资效率低下。)
“"The biases introduced by factor model misspecification can be so large as producing portfolios where investors buy what they should sell and vice versa."(因子模型设定错误带来的偏差可能大到让投资者买进了应该卖出的资产,卖出了应该买进的资产。)
大致的意思是,你用传统因子模型做出来的组合,可能方向完全搞反了。而且你回测的时候根本发现不了,因为相关性看起来是对的。
要明白这句话的具体含义,让我举三个例子:
案例1:价值因子的"伪回归"
价值因子(低PB) historically 跑赢市场,这是学术界公认的"事实"。Fama-French三因子模型把它列为风险溢价之一。
但因果方向到底是什么?
一种可能性是:低PB意味着"便宜"→买入→价格回归合理水平→赚钱。这是价值投资者喜欢讲的故事。
但另一种可能性同样说得通:经济衰退→企业盈利下滑→PB被动降低(因为分母E变小了)→你买入→经济继续衰退→E继续下滑→你继续亏。在这个版本里,低PB不是"便宜"的信号,而是"基本面在恶化"的信号。
相关性分析告诉你"低PB和高收益在历史上同时出现"。但它不告诉你因果箭头朝哪边。2008年金融危机期间,价值因子暴跌,就是因为第二种因果结构占了主导。
案例2:波动率因子的反向因果
低波动率异象(low-volatility anomaly)是量化圈的经典谜题。理论上,高风险高回报,低波动股票应该跑得慢。但实际上,低波动股票跑赢了高波动股票。
因果推断的视角告诉我们:可能不是"低波动导致高收益",而是"机构资金大量涌入某些防御性板块→推高了这些板块的价格(产生了超额收益)→同时压低了它们的波动率"。
在这个因果结构里,资金流入是原因,高收益和低波动都是结果。你以为自己在利用"低波动"这个因,实际上你只是在追逐"资金流入"这个因的影子。一旦资金开始流出(比如2020年3月),低波动因子就会瞬间失效。
案例3:动量因子的时变因果
动量因子在趋势市场有效,在反转市场无效。这是常识。
但为什么?
因果分析给出的答案是:趋势市场和反转市场的底层因果结构不同。在趋势市场中,机构资金的持续配置行为→驱动价格单向运动→产生了动量。在反转市场中,过度反应后的修正行为→驱动价格反向运动→动量变成了反转信号。
相关性分析只能告诉你"动量因子平均有效"。因果分析才能告诉你"什么时候动量是因,什么时候动量是果"。
McLean和Pontiff在2016年发了一篇很著名的文章,发现学术论文发表之后,被公开的因子溢价平均衰减32%。为什么?我的解释是:大家抄的都是相关性,不是因果性。相关性在样本内看起来漂亮,一旦市场结构变化、样本外分布漂移,相关性就崩了。因果关系虽然也难逃时变之苦,但至少方向不会搞反。
因果发现是什么?DAG、do-演算和结构方程
前面说了那么多"为什么因果性重要",接下来我们讲讲到底什么是因果性:
直觉:公鸡打鸣和日出
相关性:公鸡打鸣和日出高度相关,相关系数接近1。如果你不知道天文知识,可能会觉得"公鸡打鸣预测了日出"。
因果性:日出导致公鸡打鸣(光线刺激公鸡的生物钟),而不是反过来。知道这个因果方向,你就不会傻到去杀一群公鸡来阻止日出。
在金融中:动量和收益高度相关。但如果你不知道是"动量驱动收益"还是"收益产生了动量",你的策略就是在猜测。
技术工具1:有向无环图(DAG)
DAG是因果推断的核心表示方法。三个要素:
- 节点(Node):变量。比如"动量"、"波动率"、"成交量"、"宏观指标"、"收益"。
- 有向边(Directed Edge):因果关系。A → B 表示"A导致B"。
- 无环(Acyclic):不能出现循环。A→B→C→A 是不允许的。
DAG的好处是直观。你可以直接把一组变量之间的因果关系画成一张图。比如:
宏观环境 → 行业趋势 → 个股动量 → 未来收益
                ↓
            成交量 → 波动率
这张图告诉你:宏观环境影响行业趋势,行业趋势影响个股动量和成交量,个股动量影响未来收益,成交量影响波动率。
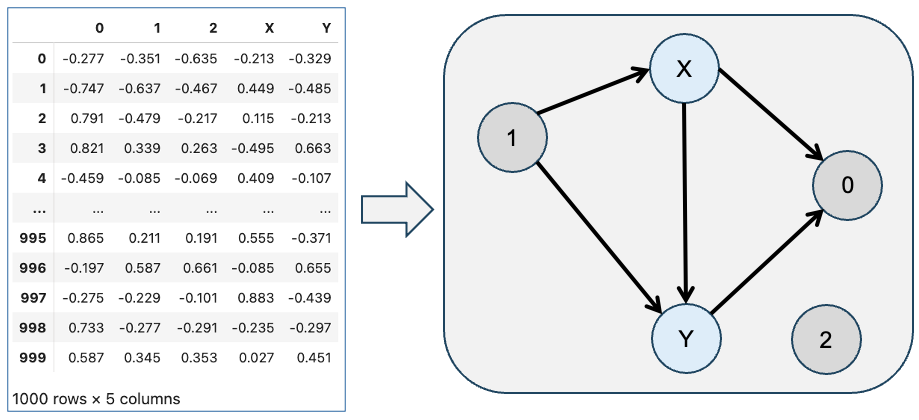
ADIA Lab竞赛的核心任务,就是给定一组变量的观测数据,让算法自动推断出正确的DAG结构。
技术工具2:d-分离和条件独立性
这是从数据推断因果结构的核心逻辑。直觉是:如果A和B在控制C之后变得不相关了,那C可能是A和B的共同原因。
比如:冰淇淋销量和溺水事故高度相关。但控制"气温"之后,两者变得独立了。说明真正的原因是气温→冰淇淋销量,气温→溺水事故。冰淇淋销量和溺水事故之间没有直接因果。
在金融中:假设你发现"成交量"和"收益"相关。但控制"宏观情绪"之后,两者变得独立了。那说明真正的原因是宏观情绪→成交量,宏观情绪→收益。成交量本身可能不直接驱动收益。
技术工具3:do-演算(Do-Calculus)
这是Judea Pearl(图灵奖得主)的发明,也是因果推断领域最重要的理论突破之一。
do-演算的核心思想是区分两种条件概率:
- P(收益 | 动量=高):我观察到动量高的股票,收益怎样?这叫关联性条件概率。
- P(收益 | do(动量=高)):我主动把动量推高,收益会怎样?这叫干预性条件概率。
这两者可能完全不同。比如:我观察到穿白大褂的人医术高明,不等于我穿上白大褂就变医生了。
在金融策略中,你真正想知道的是第二种:"如果我主动买入动量股(do(买入动量)=是),收益会怎样?"而不是"我观察到动量股涨得好,它们以后还会涨吗?"。
do-演算给了一套数学规则,让你从观测数据和DAG结构中计算出第二种概率。这才是因果推断的终极目标。
竞赛中用到的主流算法:
- PC算法(Peter-Spirtes):经典方法,基于条件独立性测试。优点是理论基础扎实,缺点是对高维数据不友好,而且假设没有隐藏混杂变量。
- GES(Greedy Equivalence Search):基于评分函数搜索最优DAG。比PC快,但可能陷入局部最优。
- NOTEARS:把DAG学习转化为连续优化问题,用梯度下降求解。这是2018年的突破性工作,让大规模因果发现成为可能。
- 深度学习方法:各种神经网络变体,试图用表示学习自动发现因果结构。
竞赛设置
ADIA Lab第二届因果发现挑战赛(2024年7月25日-10月24日)的具体设置如下。
竞赛任务:
- 主办方提供多组变量的观测数据(不同数据集)。
- 参赛队伍需要推断出每组数据中变量之间的因果DAG。
- 特别关注:在给定的X→Y因果关系中,准确识别所有中间节点(mediators)、混杂变量(confounders)和对撞变量(colliders)的角色。
数据特点:
- 包含模拟数据(真实因果结构已知,用于评估准确性)和可能的金融特征数据。
- 金融因果推断的特殊难点:
- 高维度:几百个因子,可能的DAG数量是超指数级的(比宇宙中的原子还多)。
- 非平稳性:牛市和熊市的因果结构完全不同。
- 隐藏混杂:总有你观测不到的变量在同时影响你的因子和收益。
- 反馈回路:A影响B,B又影响A,但DAG要求无环——这是个理论限制。
评估指标:
竞赛用多个指标综合评估参赛方法的质量:
- SHD(Structural Hamming Distance,结构汉明距离):推断的DAG和真实DAG之间,有多少条边不同(包括缺失、多余、方向错误)。越低越好。
- SID(Structural Intervention Distance,结构干预距离):关注的是"如果我干预某个变量,对其他变量的影响推断得对不对"。这比SHD更贴近实际投资决策的需求。
- 方向正确率:有向边的方向判断对了多少百分比。
- 节点角色识别率:在特定的X→Y因果路径中,是否正确识别了中间变量、混杂因子等角色。
这些指标的设计很有意思。SHD是"结构准确性"——你画的DAG和真实DAG有多像。SID是"决策有用性"——即使DAG不完全对,只要因果效应估计对了就行。对于实际投资来说,SID可能更重要。
竞赛结果论文即将发表
竞赛论文(López de Prado, Imbens, Hernán等,即将发表在Journal of Financial Data Science)披露了以下关键发现。
发现1:没有单一方法主导,金融数据的异质性决定了"银弹不存在"
在不同数据集上,最优方法完全不同。PC算法在某些数据集上表现最好,NOTEARS在另一些上领先,集成方法(ensemble)在第三类上胜出。
这和López de Prado在《Three Types of Backtests》里的结论一致:Walk-forward、Resampling、Monte Carlo三种回测各有盲区,没有一种能包打天下。因果发现也是一样。
对从业者的启示:不要迷信某个算法的"最先进"标签。多试几种方法,交叉验证结果的一致性。
发现2:约束和先验知识至关重要,纯数据驱动容易过拟合到噪声
竞赛中表现最好的方法,无一例外都利用了领域知识作为约束。比如:
- "宏观指标影响个股,但个股不影响宏观指标"——这是一个方向约束。
- "成交量不能直接影响基本面,只能通过价格间接影响"——这是一个路径约束。
- "某些变量之间不可能有直接因果关系"——这是一个稀疏性约束。
纯数据驱动的方法(不加任何先验)在训练集上表现不错,但在测试集上崩得厉害。这说明金融数据的信噪比太低,不加约束的算法很容易捕捉到虚假的关联。
这和量化投资中的经验完全一致:Domain Knowledge + ML 永远优于纯ML。
发现3:样本外稳定性是大问题,时变因果结构需要在线学习方法
在训练数据上表现好的方法,在测试数据上往往表现打折扣。原因很直接:金融数据的因果结构本身是时变的。
牛市中,资金流入→推高价格→产生动量。熊市中,资金流出→压低价格→动量变成反转。同一个"动量"变量,在不同regime下的因果角色完全不同。
静态DAG学习方法假设因果结构不变,这在金融中显然不成立。竞赛论文指出,"在线因果发现"(online causal discovery)和"时变DAG"(time-varying DAG)是未来研究的重要方向。
对从业者来说,这意味着:你的因果分析结果需要定期重跑,而不是一劳永逸。
发现4:可解释性和准确性之间存在权衡,但对投资来说可解释性更重要
复杂模型(深度神经网络变体)在结构准确性(SHD)上略胜一筹,但问题是——它们推断出来的DAG几乎无法解释。
简单模型(PC算法变体、带约束的评分方法)推断出来的DAG有清晰的经济学含义,你可以解释为什么A导致B。对于需要向投资委员会汇报、需要写进产品说明书的场景,这种可解释性是不可或缺的。
竞赛论文的建议是:用复杂模型做初步探索,用简单模型做最终决策。这和量化投资中"黑箱模型挖信号、白箱模型做组合"的实践不谋而合。
局限性与争议:因果投资不是万能药
因果推断在金融领域很有前景,但它不是魔法,也有自己的局限性。
局限1:因果发现需要大样本,金融数据天然不够
因果发现算法的理论保证通常要求"样本量远大于变量数"。比如你有100个因子,可能需要上万条观测才能保证DAG学习的准确性。
但金融数据的问题是什么?日度数据几十年也就几千条。相对几百个因子来说,样本量远远不够。
workaround:
- 用分钟级或tick级数据增加样本量(但噪声也更大)
- 降低变量维度,只保留最核心的几十个因子
- 用领域知识加约束,减少需要搜索的DAG空间
- 用模拟数据+迁移学习的方法
局限2:DAG可能过于简化真实金融系统
DAG要求"无环"——A不能通过一条路径回到A。但真实金融系统里到处都是反馈回路:
- 价格上涨→吸引更多买家→价格进一步上涨(正反馈)
- 波动率上升→风险平价基金减仓→波动率进一步上升(正反馈)
- 流动性下降→做市商扩大价差→流动性进一步下降(正反馈)
这些反馈回路是DAG无法表示的。解决方案是动态DAG或时变因果模型,但这些方法还在研究中,不够成熟。
局限3:计算复杂度是实际瓶颈
精确学习DAG是NP-hard问题。变量数n的增长会导致DAG搜索空间超指数级增长。100个变量的DAG空间,比宇宙中的原子还多。
近似算法(如NOTEARS)可以处理几百个变量,但牺牲了理论保证。在实际操作中,你需要在"变量丰富度"和"计算可行性"之间做权衡。
争议:因果性真的比相关性更稳定吗?
批评者的观点:即使因果结构正确,参数估计(因果效应的大小)仍然可能不稳定。牛市中"动量→收益"的因果效应是+2%,熊市中变成-1%。知道因果方向对了,但效应大小和符号都时变,对投资也没太大帮助。
López de Prado的回应:"Causal factor analysis is a necessary condition, not sufficient."(因果因子分析是必要条件,不是充分条件。)方向对了不能保证赚钱,但方向错了保证亏钱。
结语:因子投资的下一个十年
ADIA Lab这场竞赛,标志着一个重要的转折点。
全球最聪明的大脑——诺贝尔经济学奖得主、图灵奖得主、管理万亿美元的量化研究主管——开始认真对待一个被回避了很久的问题:因子投资到底在赚什么钱?是因果驱动的alpha,还是相关性驱动的illusion?
最后,送一句话给大家:
相关性让你回测漂亮,因果性让你实盘不慌。
附录
论文
- López de Prado, M., Lipton, A., & Zoonekynd, V. (2026). "Correcting the Factor Mirage: A Research Protocol for Causal Factor Investing." Journal of Portfolio Management, forthcoming.
- López de Prado, M., Lipton, A., & Zoonekynd, V. (2025). "Causal Factor Analysis Is a Necessary Condition for Investment Efficiency." JPM, 52(1), 7-19.
- Olivetti, E., Zoonekynd, V., Yam, P., López de Prado, M., Imbens, G., & Hernán, M. (2026). "Evidence from ADIA Lab's Causal Discovery Challenge." Journal of Financial Data Science, forthcoming.
- McLean, R.D., & Pontiff, J. (2016). "Does Academic Research Destroy Stock Return Predictability?" Journal of Finance, 71(1), 5-32.
书籍
- López de Prado, M. (2023). Causal Factor Investing: Can Factor Investing Become Scientific? Cambridge University Press.
- Pearl, J. (2009). Causality: Models, Reasoning, and Inference (2nd ed.). Cambridge University Press.
- Hernán, M.A., & Robins, J.M. (2020). Causal Inference: What If. Chapman & Hall/CRC.
关于QuantML
QuantML 是链接全球顶尖量化人才的高端社群,我们聚焦于机器学习在量化投资中的最前沿应用。
核心价值:
- 顶级圈层: 社区涵盖头部机构从业者、知名私募创始人、机构量化负责人,基金经理,券商金工分析师、GitHub千星作者及顶会学者构成。
- 每日高价值内容: 持续分享前沿论文、论文研报复现、模型代码、核心Alpha因子以及QuantML-Qlib框架等。
加入我们,与最强大脑同行,洞见量化未来。