字节发布Seed2.1,真实生产力场景里能扛活,更稳定交付
字节刚刚发布Seed2.1,面向真实生产力场景的全新智能体。
Seed2.1系列,分Pro和Turbo两款尺寸,主打生产力场景交付稳定性。
Seed2.1沿着通用Agent、代码工程、多模态基础能力三条线推进,每条线都对齐真实生产力场景。能在多步骤、跨工具、跨环境的任务里稳定交付可落地结果。
在教学、通用办公和专业研究等场景,Seed2.1能稳定输出教案PPT、完成复杂表格分析、生成行业报告。
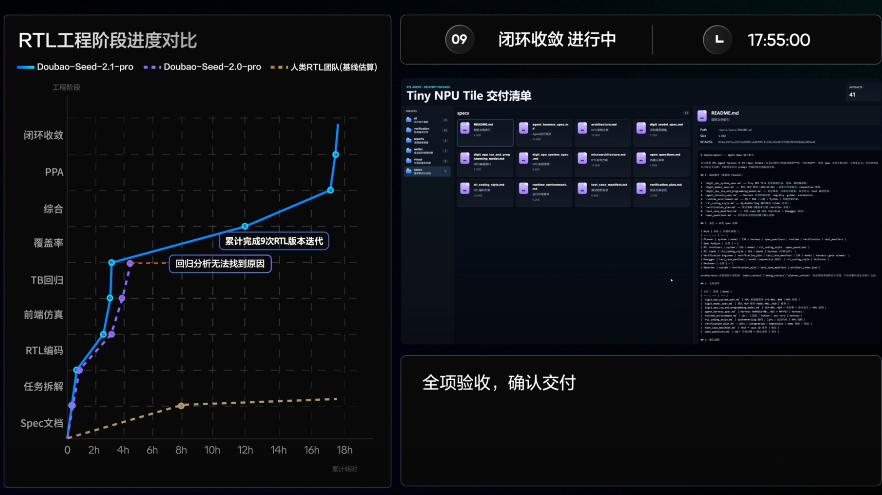
Seed2.1还能够在办公场景下,跨多工具、多环境与多种交互方式之间持续执行任务。
字节发布Seed2.1,真实生产力场景里能扛活,更稳定交付Agent更可靠了
模型进入生产力场景,用户更希望模型能够围绕目标持续推进任务,最后端出能用的东西。Seed2.1在通用Agent方向上的提升,就是冲着这个目标去的。
与Claude Opus 4.7,GPT-5.5和Gemini 3.1 Pro比较,Seed2.1 Pro在GDPval基准上拿到最高分。
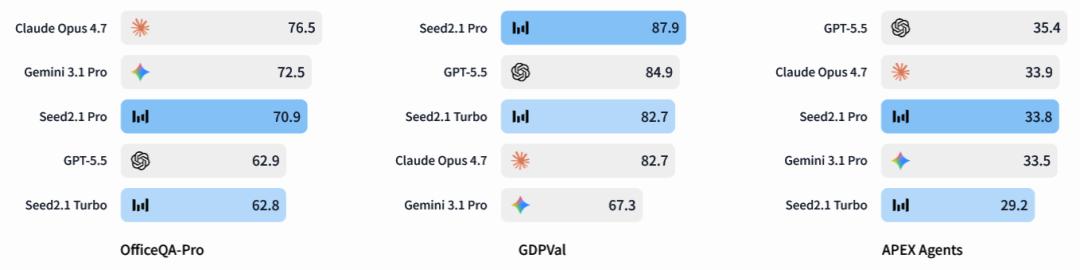
Seed2.1在各个Agents执行任务基准上表现稳定。
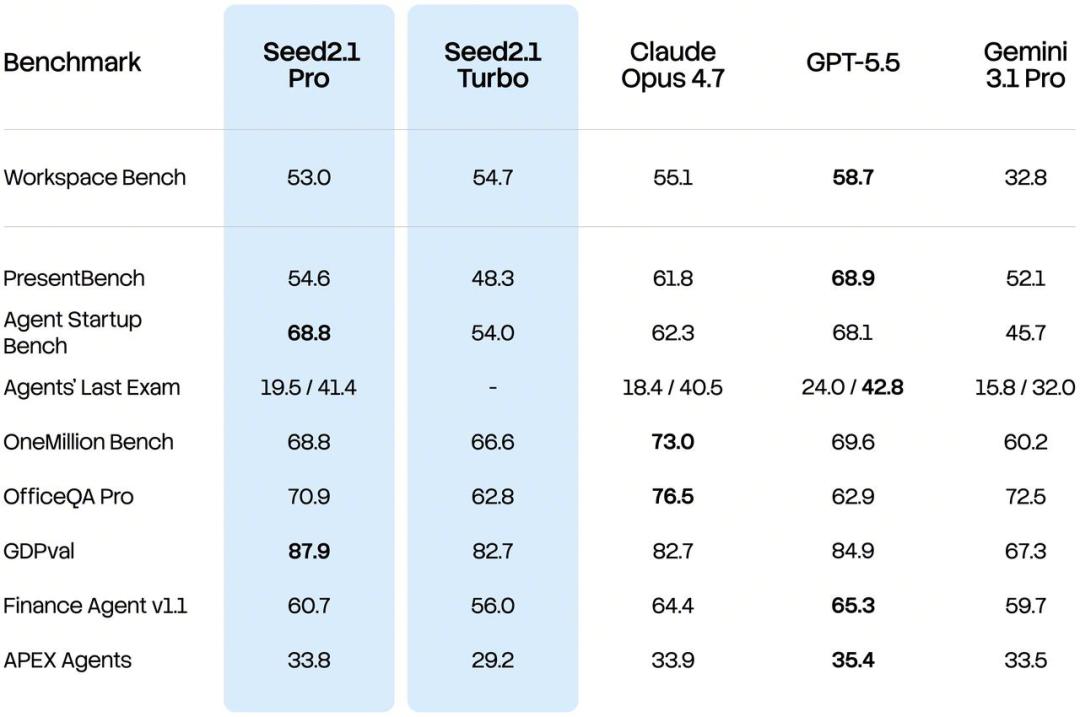
更高难度的专业任务上,Seed2.1 Pro在Agents' Last Exam(ALE)评测里站到了第一梯队。这个评测刚发布不久,各家模型还没来得及充分定向优化,所以更能反映模型面对新任务场景时的泛化能力。
Seed2.1在xDailyBench、Doubao Multi-Turn Bench上表现稳定,在Toolathlon、SeedClawBench上保持竞争力,意味着模型在日常生活、学习研究等30多个垂类场景里都能更好理解真实用户需求,结合用户偏好给出高质量建议,必要时还能调用不同工具、使用合适的Skill,产出可靠回复。
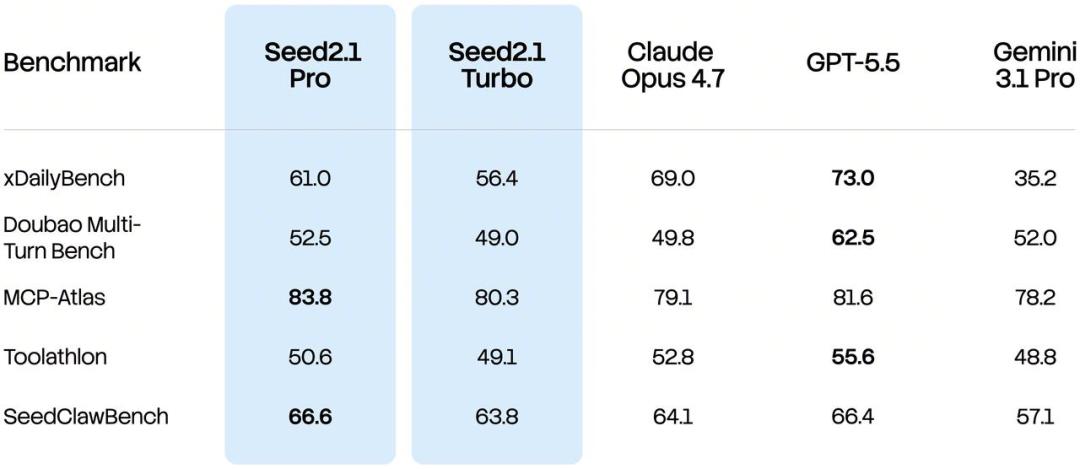
SeedClawBench是Seed自主开发的内部基准,评估在OpenClaw风格、面向用户场景里Agent提供实际辅助的能力。
在 Claw-Eval (MM) 等 Visual Agent 相关基准上,Seed2.1整体表现出较强的竞争力。
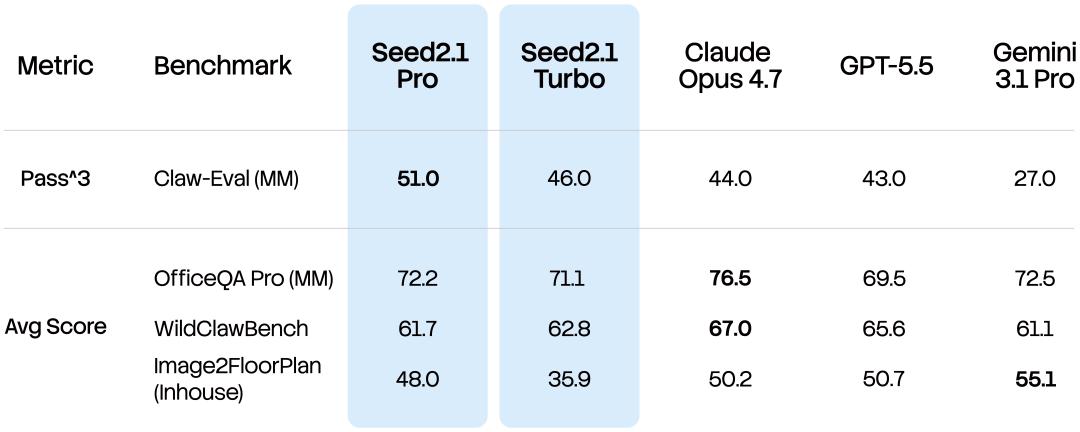
真实工作流很少发生在某一个固定界面里,往往要在聊天、搜索、浏览器、代码仓库、文件和外部工具之间频繁切换。
Seed2.1因此专门面向通用型Computer-Use Agent(CUA)方向做了优化,让模型在跨环境、跨工具和跨交互方式的任务里能持续推进。
手机GUI任务是其中一个典型场景。模型要理解屏幕内容、判断下一步操作,完成点击、输入、切换应用等连续动作。
Seed2.1在MobileWorld基准中拿到最高分。在OSWorld上,模型通过强化学习引导Agent在GUI和non-GUI动作空间里自然切换最优选择,把完成任务所需的平均步数减少16%,执行效率显著提升。
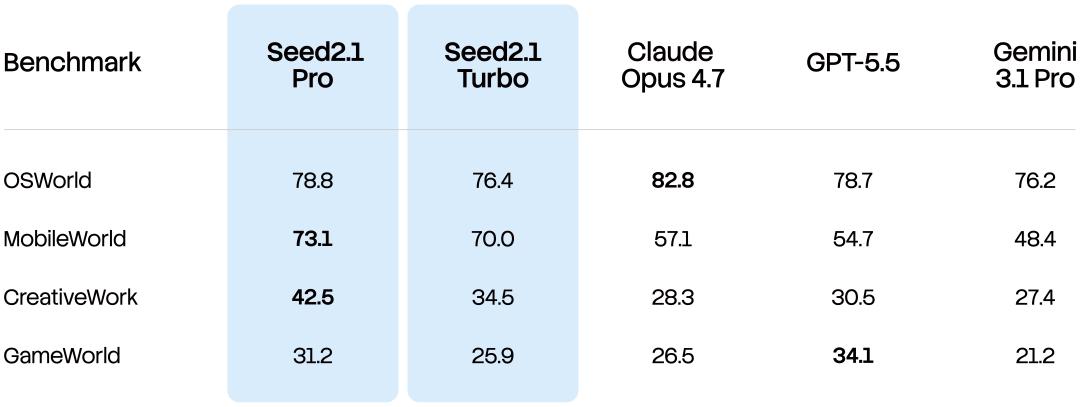
CreativeWork是Seed自研的基准,评估Agent在真实生产力场景中协同使用GUI与MCP工具的能力,覆盖Notion、Canva和Figma三类代表性环境,意味着模型在文档管理、视觉设计和界面编辑等多种任务里,都能理解复杂目标、分解执行步骤,在工具调用与GUI交互之间自主切换。
代码工程能交付了
Coding能力方面,Seed2.1结合公开基准、众测开发者反馈和内部评测三方面综合评估。
公开基准里,Seed2.1 Pro超越了Gemini 3.1 Pro,紧跟Claude Opus 4.7和GPT-5.5。
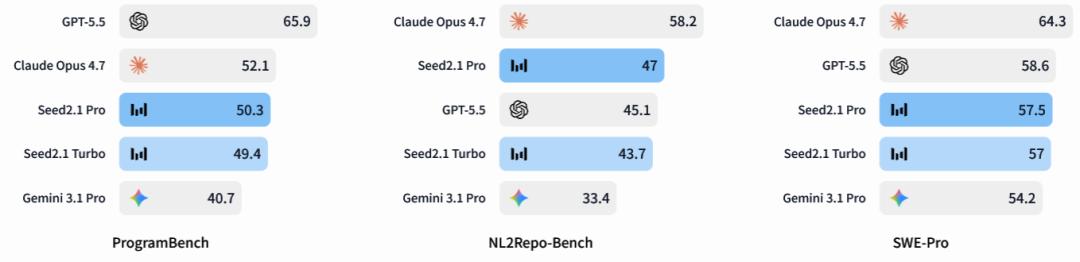
在NL2Repo-Bench上,Seed2.1 Pro表现甚至超过GPT-5.5。
Seed团队邀请开发者基于真实代码仓库提交工程任务,再对匿名模型输出做对比。
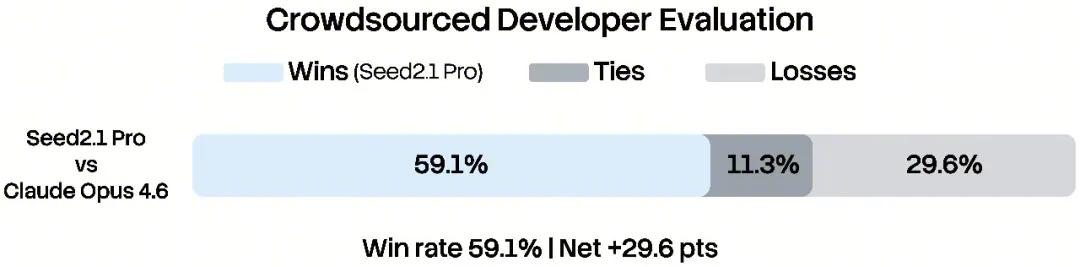
结果显示,在更贴近真实Coding流程的任务里,Seed2.1在最终完成质量上获得更高评价,其中Seed2.1 Pro相比Claude Opus 4.6获得59.1%胜率。
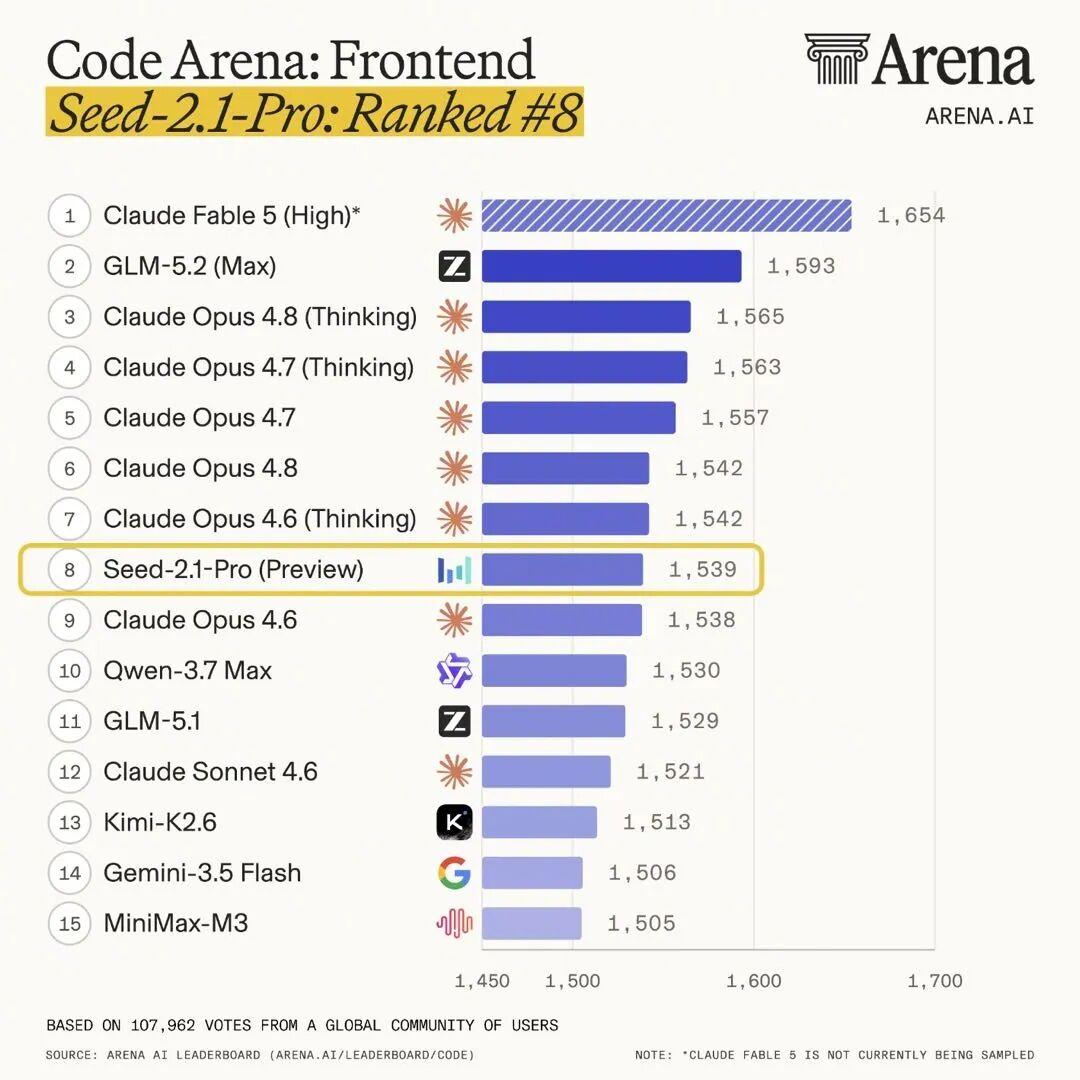
前端场景方面,Seed2.1 Preview版本近期参加了Code Arena: Frontend人类偏好评测,以1539分排名第8,国产模型仅次于刚发布的GLM-5.2(Max)。
看得更清想得更长
视觉感知、理解、推理,以及视频与运动感知相关基准上,Seed2.1整体表现出非常强的竞争力。
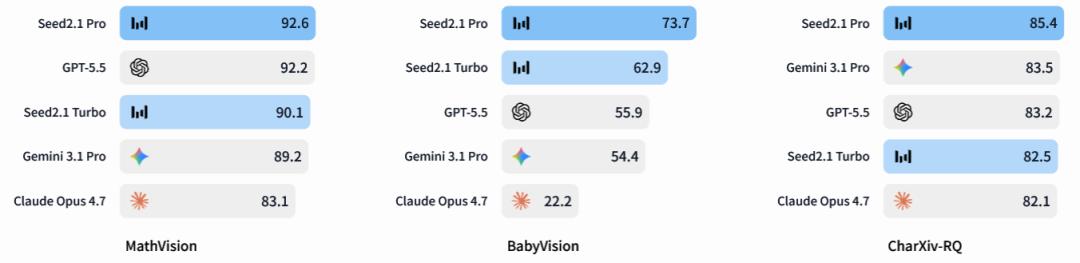
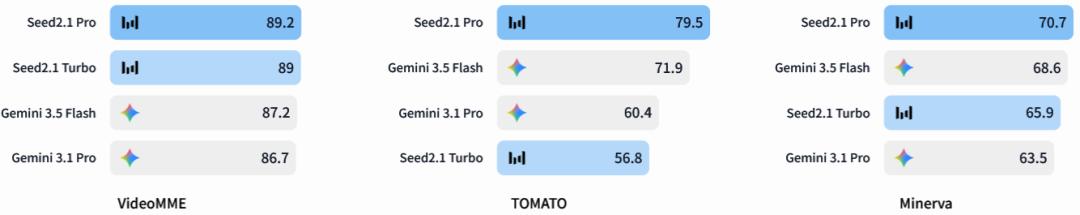
Seed2.1在视觉理解、视频理解、长上下文、多语言、科研推理等多条线都做了升级,多项评测集取得SOTA结果。
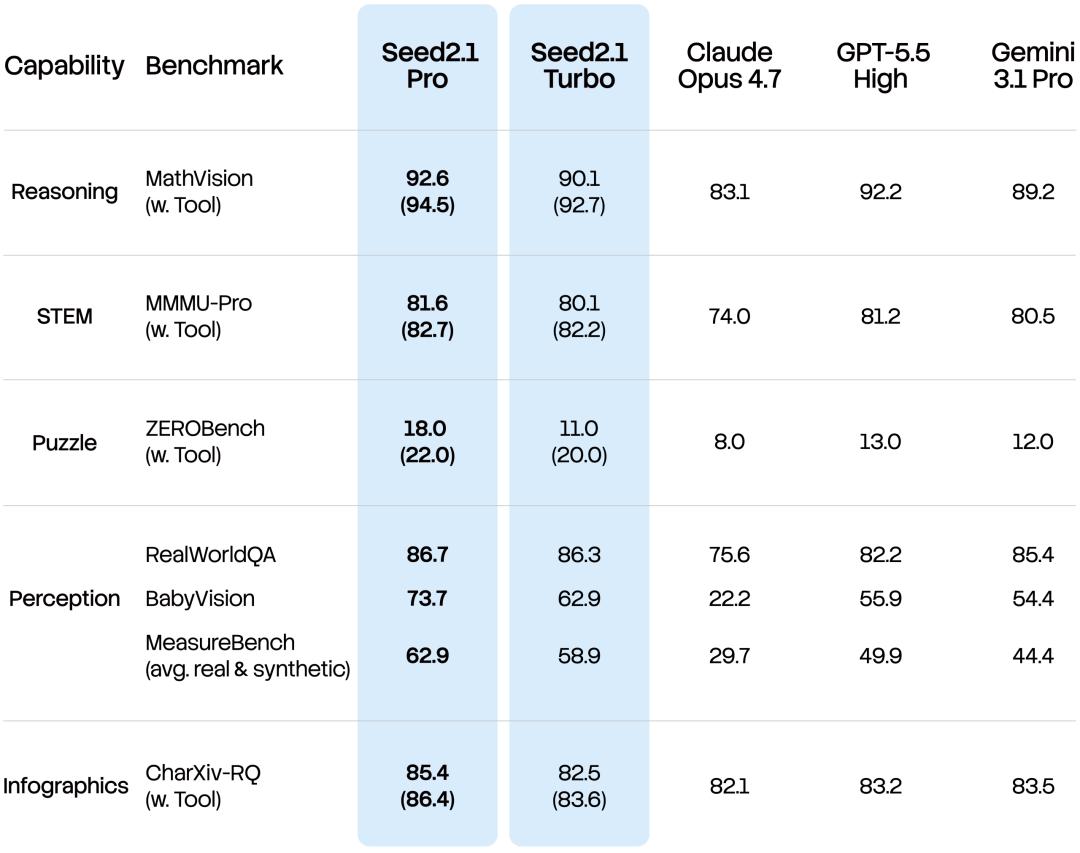
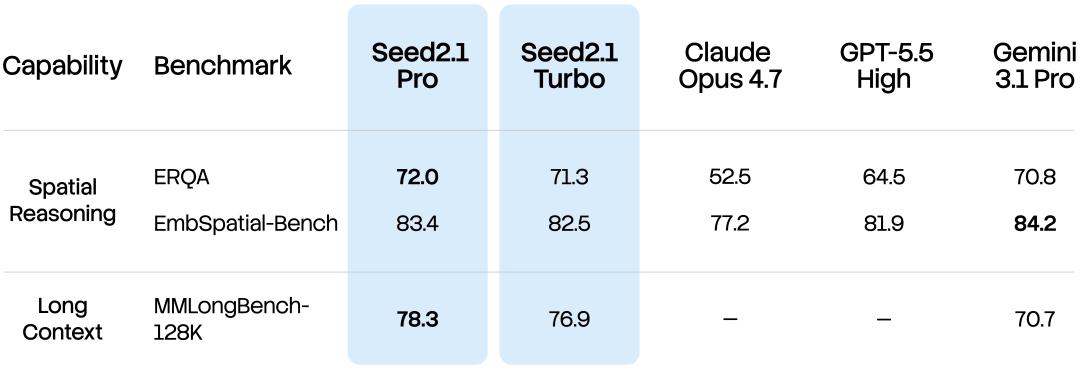
而ERQA基准上,Seed2.1取得最佳成绩,说明模型空间理解能力进一步增强,能更好支撑面向现实环境的Agent任务。在MMLongBench-128K长上下文基准上表现突出,意味着模型能处理长文档、多页材料和更长链路的任务信息,让Agent在更完整的上下文里稳定推进复杂任务。
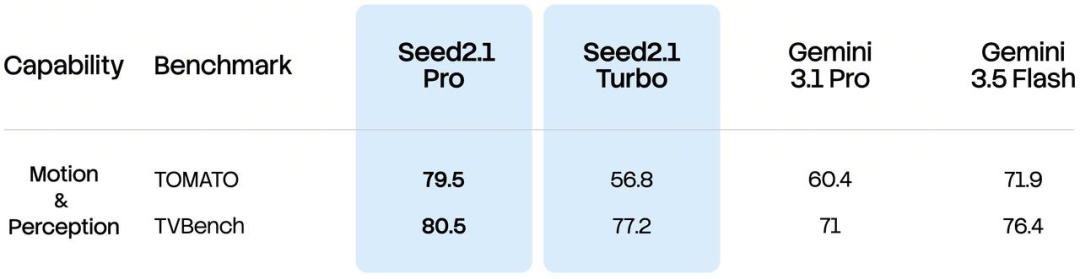
在TVBENCH、TOMATO基准上,Seed2.1 Pro取得业界高分,对时序变化、动作和物理运动的理解更准确。视频理解的难点在于时间维度上的连贯判断,模型不能只看单帧,要能捕捉动作前因后果,理解物体运动的物理逻辑,这一点对Agent介入视频相关场景至关重要。
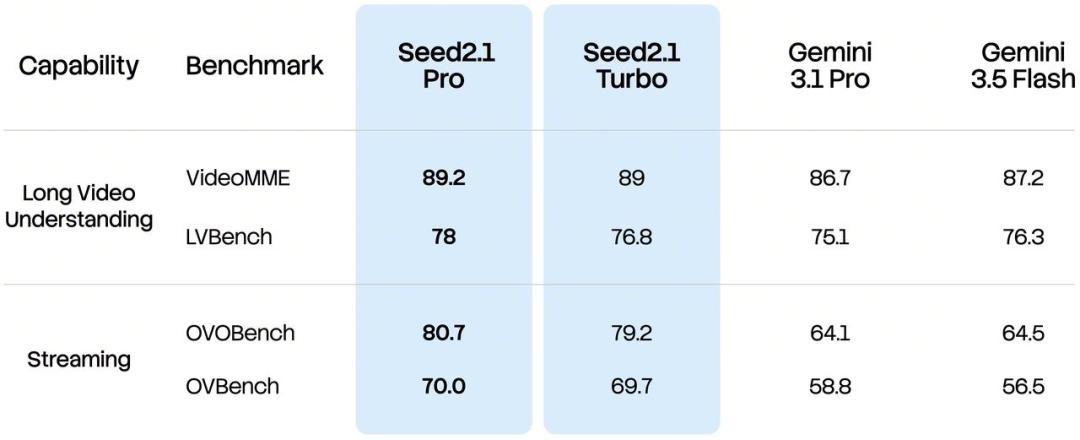
小时级别的长视频处理能力也在持续提升,识别与理解的准确性进一步提高,在VideoMME、LVBench等多个基准中取得高分,为长视频检索、影视剧剪辑等场景奠定基础。流式视频能力同步加强,在OVBench等基准中表现突出,能在实时视频通话、会议录屏回看、视频分析等场景里帮用户高效理解内容。
多模态之外,世界知识、推理和多语言能力也同步提升。SciCode和FrontierScience-Olympiad等基准上表现良好。
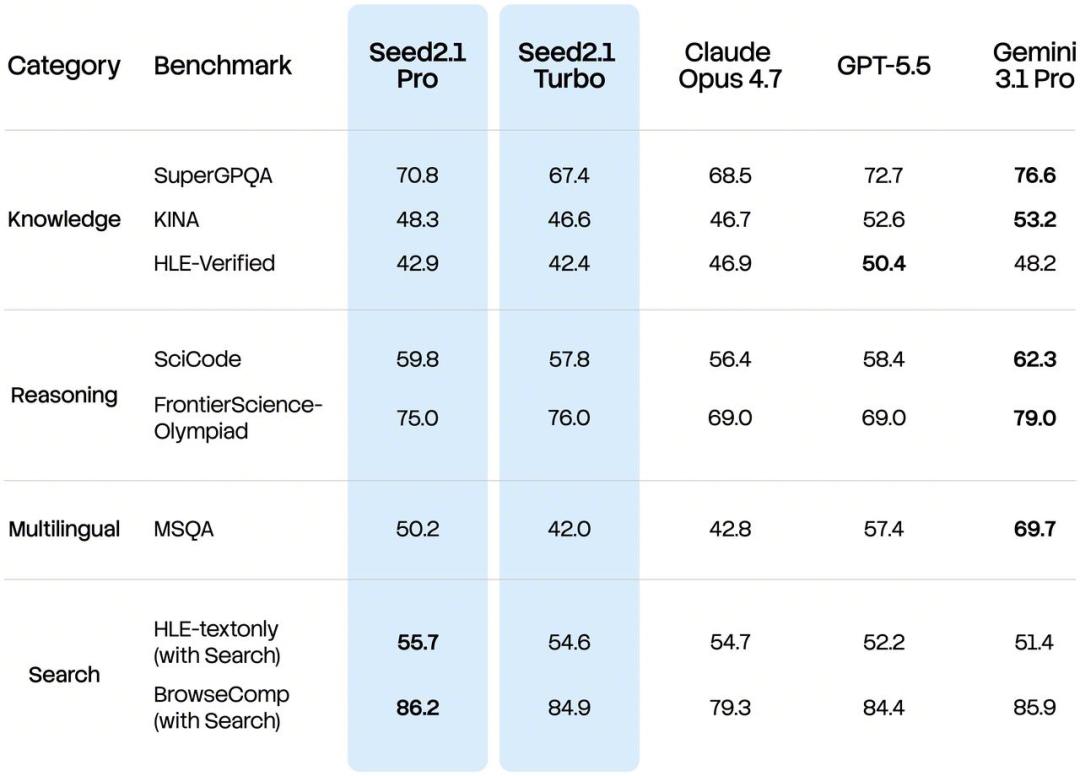
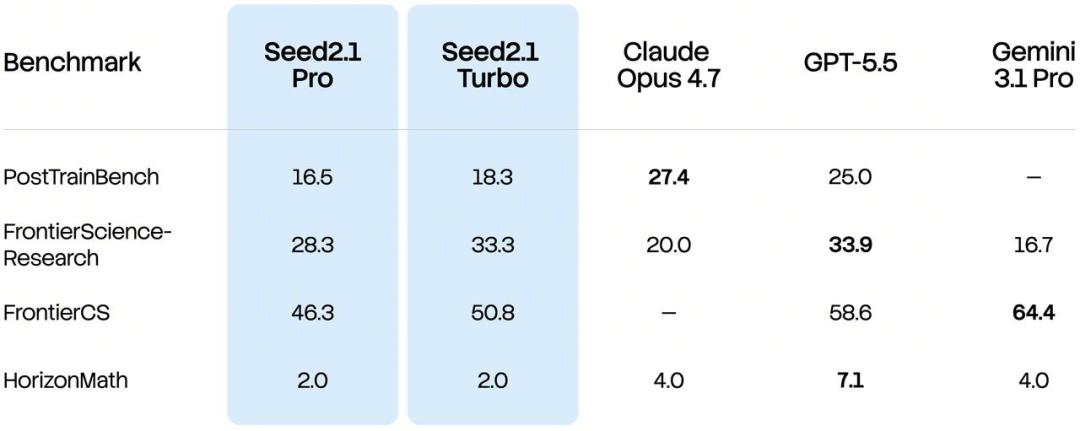
更前沿的开放研究场景,Seed2.1也在尝试。FrontierScience-Research等前沿研究基准上,追平了前沿闭源模型。
Seed加速Seed研究
随着Agent能力从对话走向真实工作流,模型研发场景本身也在变化。
模型不再只是被评测、被训练和被优化的对象,也开始参与模型研发流程本身。
Seed团队持续推进Seed for Seed研发方向,让Seed2.1不只服务外部研发与业务场景,也进一步进入评测、数据、训练、研究和Infra(基础设施)等关键环节,参与真实研发任务,在提升研发效率的过程中反哺模型能力迭代。
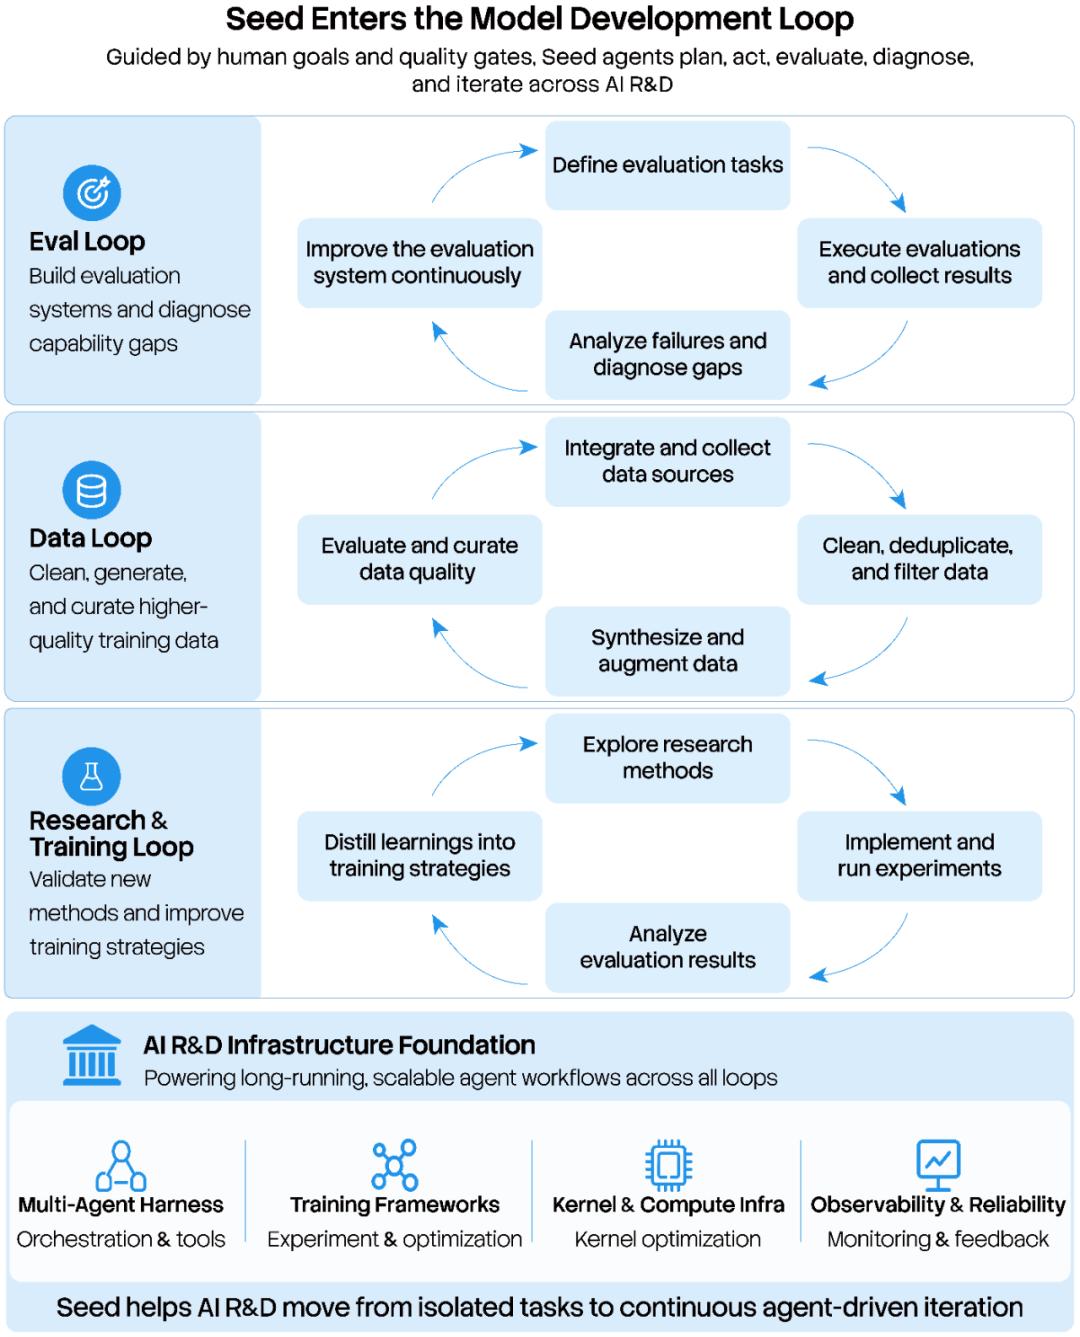
实际场景里,Seed2.1以Agent形式参与评测系统构建、能力诊断、SFT数据合成、RL训练框架优化,以及把最新研究论文里的关键方法落到代码和实验中验证。这些任务往往跨越数小时、十几小时甚至数十天。
面向真实场景的生产力价值,Seed2.1的Agent执行能力和Coding任务的交付稳定性都有较大提升。
团队也坦言,在最具挑战性的开放任务和前沿研究问题求解上,模型能力仍有提升空间。后续会继续深入调研专家用户的真实需求,提升专业工作流覆盖,持续优化Harness与模型的协同,让模型在复杂工作流里稳定发挥作用,同时通过让模型参与训练、进行自主研究加速迭代,并持续打磨模型的行为模式提升用户体验。
Seed2.1加持下的豆包,已经在向真实工作流里能扛活的方向扎实推进。
参考资料:
https://seed.bytedance.com/zh/seed2_1
https://seed.bytedance.com/zh/blog/seed2-1-officially-released-advancing-ai-productivity